FP8 P-Cast Precision in Attention: Sink-Induced Collapse and the Optimality of S=2^8
A quantitative analysis of FP8 E4M3 attention P-casting revealing P-collapse under attention sink and characterizing S=256 as the optimal static scaling factor
FP8 P-Cast Precision in Attention: Sink-Induced Collapse and the Optimality of S=2^8
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FP8 P-Cast Precision in Attention: Sink-Induced Collapse and the Optimality of S=2^8 |
| 作者 | Reed Lau (单作者) |
| 机构 | (独立研究者) |
| 论文 | https://arxiv.org/abs/2606.06521 |
| 发布 | 2026-06-02 (v1) |
| 许可 | CC BY 4.0 |
| 篇幅 | 8 页, 3 图, 3 表, 1 算法 |
| ** subjects** | Hardware Architecture (cs.AR); AI (cs.AI); Distributed Computing (cs.DC); ML (cs.LG); Performance (cs.PF) |
二、核心思想
问题定义
FP8(E4M3)加速注意力计算可带来显著的吞吐增益,但 3-bit 尾数 在 softmax 概率矩阵 P 被 cast 到 FP8 后进行 P.V 矩阵乘法时引入精度挑战。
具体而言,Attention Sink 现象 与 FP8 量化产生破坏性交互:在前向迭代中,sink 的高 logit 分数膨胀了 running softmax 最大值,迫使所有后续 P 值低于 E4M3 的可表示范围,导致 P-collapse——大量概率值下溢为零。
解决方案概述
本文对 FP8 注意力中的两个关键实现选择进行了定量分析:
- KV block 迭代顺序(前向 0→N vs 反向 N→0)
- P 的静态缩放因子 S(cast 到 E4M3 前乘以 P 的常数)
核心贡献:
- 推导了 P-collapse 的闭式表达:下溢分数 F(Delta,S) = Phi(Delta + delta_k - 6.93 - ln S)
- 证明了反向迭代 + S=256 的零下溢保证(Pr[underflow] < 10^{-12})
- 通过 dp(S) 锯齿函数 刻画了 S=256=2^8 的最优性
- 内核忠实仿真显示 3-10× MSE 改进
值得注意的是,两项优化已部署在 FlashAttention-3/4 中(工程考量),本文首次提供了定量的理论解释。
三、技术架构
FP8 E4M3 精度瓶颈
E4M3 格式的 3-bit 尾数每个 binade 仅有 8 个可表示值(相对精度 12.5%),比 BF16 差约 16 倍。
P-underflow 条件:P 值 p 在缩放因子 S 下下溢为零 iff:
对于 ,当下溢发生时:
其中 是 sink token 的 logit 分数偏移, 是 k_sink 个标准高斯的期望最大值。
P-Collapse 闭式表达
Proposition 1(P 下溢条件):
其中 是标准正态 CDF。
关键参数:
- (k_sink=4 时),而非渐近值 (小 k_sink 时渐近值高估)
- running maximum
量化步骤锯齿函数 dp(S)
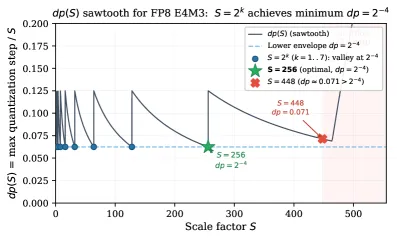
Theorem 6(dp(S) 下界):所有 (k ∈ {0,…,8})均达到 (E4M3 数线上的下包络)。非 2 的幂次的 S 有 。
S=256 的三个最优性条件:
| 条件 | 说明 |
|---|---|
| 1. Bit-Exact Scaling | S=2^k 时,x·S 和 x·(1/S) 在 IEEE 754 FP32 中均精确,无舍入误差 |
| 2. dp(S) 下包络 | 所有 S=2^k 达到 dp=2^{-4}(最小最坏情况量化步长) |
| 3. 最大正态范围覆盖 | S=256 是满足 bit-exact 的最大 2 的幂次 |
注:S=448 虽 attain 稍高的覆盖,但破坏了 bit-exactness。
反向迭代的零下溢保证
Theorem 4(Reverse + S=256 的零下溢保证):
反向迭代将 sink block 推迟到最后一次迭代, preceding 迭代中仅非 sink token 贡献 running maximum,保持 P 值远高于 E4M3 的 round-to-zero 边界。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| P-collapse 定量刻画 | 首次给出闭式下溢分数表达式 | F(Delta,S) = Phi(Delta + delta_k - 6.93 - ln S) |
| 反向迭代充分性证明 | 证明 reverse + S=256 的下溢概率 < 10^{-12} | Theorem 4,N <= 10^6 |
| dp(S) 锯齿函数 | 通过量化步长函数刻画 S=256 最优性 | 三个条件同时满足 |
| 内核忠实仿真 | Q,K,V 保持 FP32 隔离 P-cast 效应 | 3-10× MSE 改进验证 |
| 生产内核审计 | 识别 TensorRT-LLM XQA 和 SageAttention2 次优 | S=448 vs S=256 |
五、实验结果
P-Collapse 分析(Delta 扫描)
表 I: N=4096, k_sink=4, block size=64
| Delta | 下溢分数 (S=1) | 下溢分数 (S=256) | 非 sink 质量 | 有效信息损失 (S=1) |
|---|---|---|---|---|
| 5 | 22.3% | 0% | 88.0% | 19.6% |
| 6 | 51.6% | 0% | 74.0% | 38.2% |
| 7 | 82.0% | 0% | 51.7% | 42.4% |
| 8 | 94.8% | 0.3% | 32.2% | 30.5% |
| 9 | 99.5% | 2.3% | 13.9% | 13.9% |
| 10 | ~100% | 11.7% | 5.8% | 5.8% |
关键发现:有效信息损失在 Delta ~ 6-7 时达峰(~40%),此时携带约一半到四分之三概率质量的位置有大量 P 值被置零。
MSE 对比(不同配置)
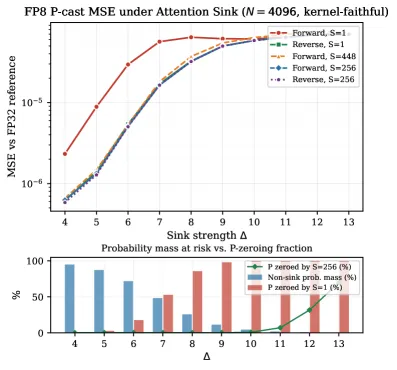
MSE × 10^{-5} 对比表:
| 配置 | N=4096 | N=8192 | N=16384 |
|---|---|---|---|
| Forward, S=1 | 5.65 | 4.40 | 2.94 |
| Reverse, S=1 | 1.70 | 0.83 | 0.32 |
| Forward, S=448 | 1.81 | 0.90 | 0.32 |
| Forward, S=256 | 1.64 | 0.80 | 0.28 |
| Reverse, S=256 | 1.64 | 0.81 | 0.28 |
| 加速比 (FwdS=1/best) | 3.4× | 5.5× | 10.5× |
关键发现:
- Forward+S=1 在 Delta=7 时比最佳配置差 3.4×
- 仅 reverse(任意 S)或仅 S=256(任意方向)各自独立修复问题
- S=256 比 S=448 低约 10-15% MSE
- 在 Delta >= 11 时,所有配置收敛(非 sink 质量 < 2%)
序列长度扩展
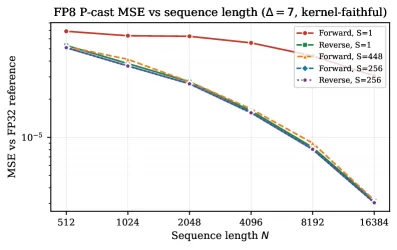
MSE 改进随序列长度增长:N=512 时 1.3×,N=16384 时达 10×。
生产内核设计选择审计
表 III: 主流 FP8 注意力内核设计对比
| 内核 | 迭代方向 | 缩放因子 S | 评价 |
|---|---|---|---|
| FlashAttention-3/4 | Reverse | 256 | 最优 |
| hpc-ops (updated) | Forward | 256 | 最优 |
| hpc-ops (prior) | Forward | 1 | 基准(次优) |
| FlashInfer | Reverse | 448 | 近优(可改进 10-15%) |
| TensorRT-LLM XQA | Forward | 448 | 次优缩放 |
| SageAttention2 | Forward | 448 | 次优缩放 |
六、讨论
饱和性:相同机制,相同下界
两种优化解决的是同一故障模式,任一单独使用即足够。Forward+S=256 和 Reverse+S=256 在 Delta <= 9 时统计上不可区分。
S=2^k 的几何解释
所有 E4M3 正态 binade 包含 8 个等距点;在 S=2^k 时,分子和分母同时翻倍,锁定比率为 2^{-4}。
实际建议
- 前向迭代内核(如 TRT-LLM XQA):添加 S=256 P-scaling
- 使用 S=448 的内核(如 FlashInfer, SageAttention2):切换到 S=256 可获得 10-15% MSE 降低
- 使用 Reverse+S=256 的内核(如 FA3/4):无需更改
局限性
- 最坏情况 vs 平均情况分析
- 未建模 QKV 量化交互(实验中隔离)
- 未报告端到端 perplexity/task-accuracy 指标
- dp(S) 分析假设有界范围 [0,1]、单一静态缩放、bit-exactness 要求
- 多 sink 模式将泛化分析
七、总结
核心贡献
- P-collapse 定量理论:闭式下溢分数表达式,阈值 Delta_c = 6.93 + ln S - delta_k
- 反向迭代零下溢保证:reverse + S=256 下溢概率 < 10^{-12}
- S=256 最优性刻画:dp(S) 锯齿函数的三个条件同时满足
- 内核忠实验证:3-10× MSE 改进
- 生产内核审计:识别多个主流实现的次优设计
技术影响
- 为 FlashAttention-3/4 的工程决策提供了首次定量理论解释
- 作者已将 S=256 变更应用到生产内核 hpc-ops
- 为 FP8 注意力内核设计提供了明确的优化指南
八、参考资源
- arXiv: https://arxiv.org/abs/2606.06521
- License: CC BY 4.0
- 评估硬件: A800 GPU
- 相关实现: FlashAttention-3/4, hpc-ops, FlashInfer, TensorRT-LLM, SageAttention2
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | dp(S) 锯齿函数与 S=256 最优性标记 | dp-sawtooth.png |
| Figure 2 | MSE vs sink strength | mse-vs-sink.png |
| Figure 3 | MSE vs sequence length | mse-vs-seqlen.png |