Tangram: Unlocking Non-Uniform KV Cache Compression for Efficient Multi-turn LLM Serving
Tangram 利用「Head-wise 保留量存在输入无关的两级结构」的观察,把非均匀 KV 压缩静态化:Budget Reservation 在调度时固定每头预算、Ragged Paging 用同预算 head 组成独立 page 表消除碎片、AOT Load Balancing 预算 CTA 划分。作为 vLLM drop-in 层,在五个模型 SCBench 上匹配原精度同时端到端吞吐相较 Full-KV 最高提升 2.6×。
Tangram: Unlocking Non-Uniform KV Cache Compression for Efficient Multi-turn LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Tangram: Unlocking Non-Uniform KV Cache Compression for Efficient Multi-turn LLM Serving |
| 作者 | Hyungmin Kim, Minsoo Kim, Hongseok Kim, Jungwook Choi |
| 发表日期 | 2026-06-04 (arXiv, v2) |
| arXiv | 2606.06302 |
| 分类 | cs.LG, cs.SE |
| 系统名 | Tangram(vLLM 上的 drop-in KV 管理层) |
| 支持模型 | Qwen3-4B、Llama-3.1-8B、Gemma-3-12B、GPT-OSS-20B、Qwen3-30B-A3B |
| 基准 | SCBench |
二、核心思想
问题定义:多轮 LLM 服务中,KV cache 随对话轮数和并发用户线性增长;例如 Qwen2.5-32B 在 16 并发下 10 轮内 KV cache 就超过模型权重本身(图 1a),内存而非算力成为吞吐瓶颈。
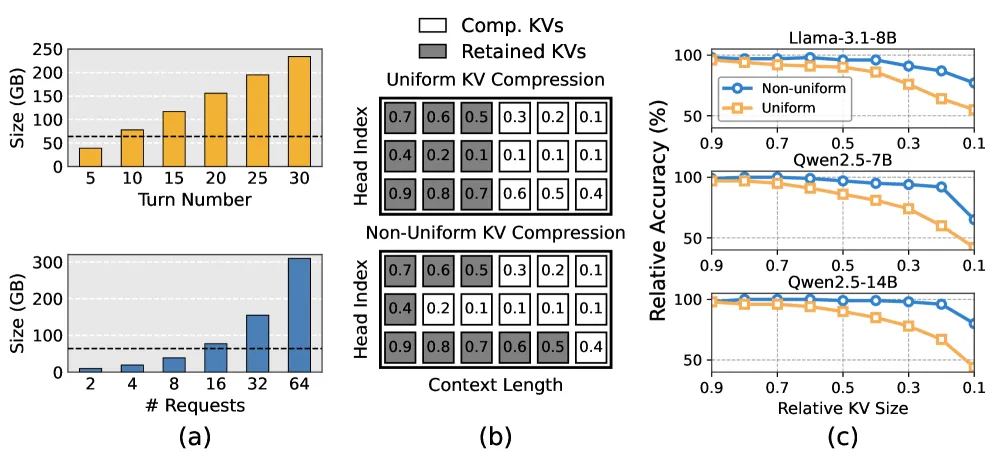
非均匀 KV 压缩(按 head 分配不同预算)在精度上远优于均匀截断,但现代 serving 栈(PagedAttention、chunked prefill、continuous batching)默认「所有 head 长度相同」,导致三大系统难题:
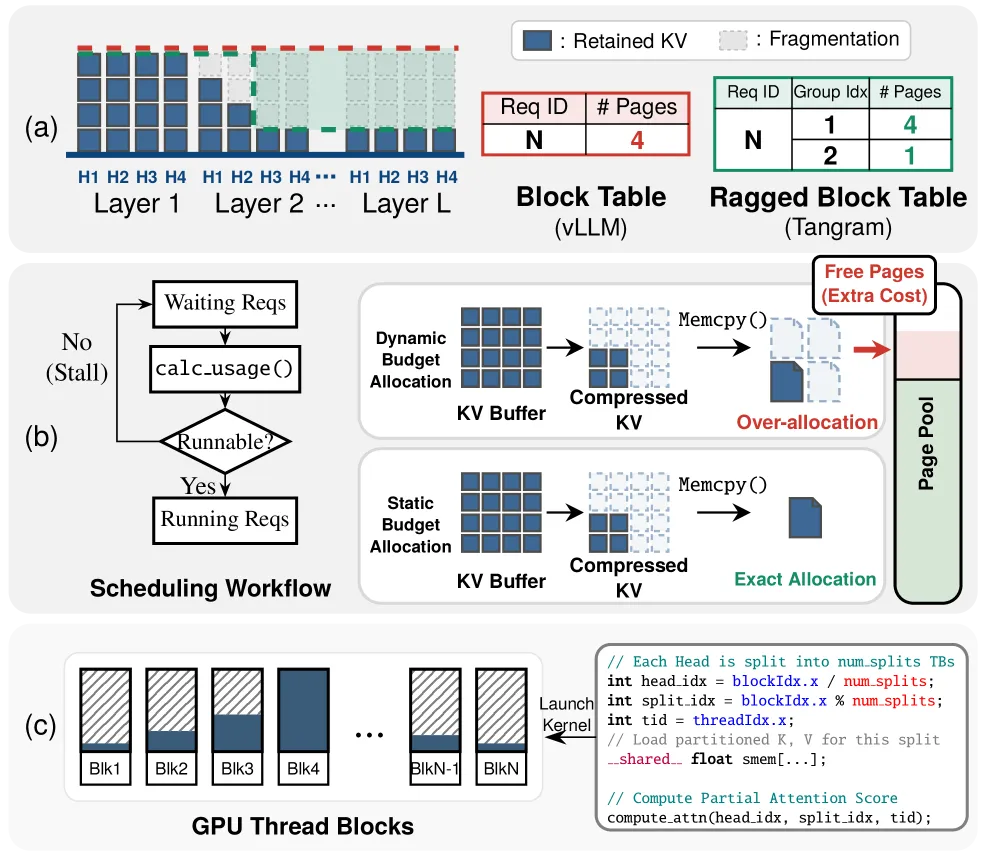
- Monolithic Page 碎片:一个 page 被所有 head 共享,只要一个 long head 未释放整页就无法回收。
- Prefill 时的 Page Reclamation 开销:分散页跟踪/回收最多消耗 25% prefill 时间。
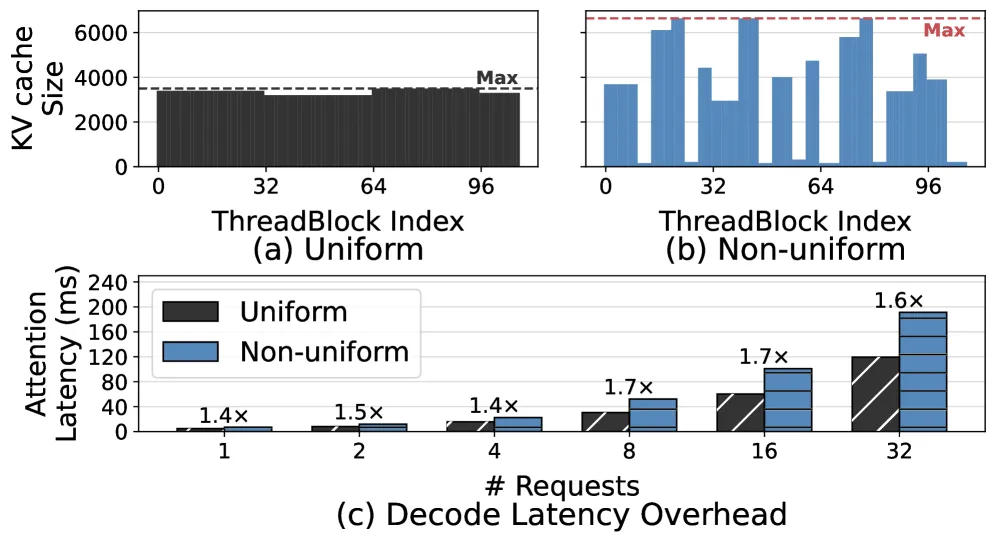
- Decode Attention 负载失衡:head 之间保留量差异使 GPU SM 负载偏斜,attention 延迟膨胀至 1.7×;单步 decode 15–20% 花在 re-planning。
关键观察:Head-wise KV retention 具有两级结构:
- 输入无关的 head 排序:不同输入下同一 head 的排序几乎稳定;
- 每 head 的比例落在极窄区间。
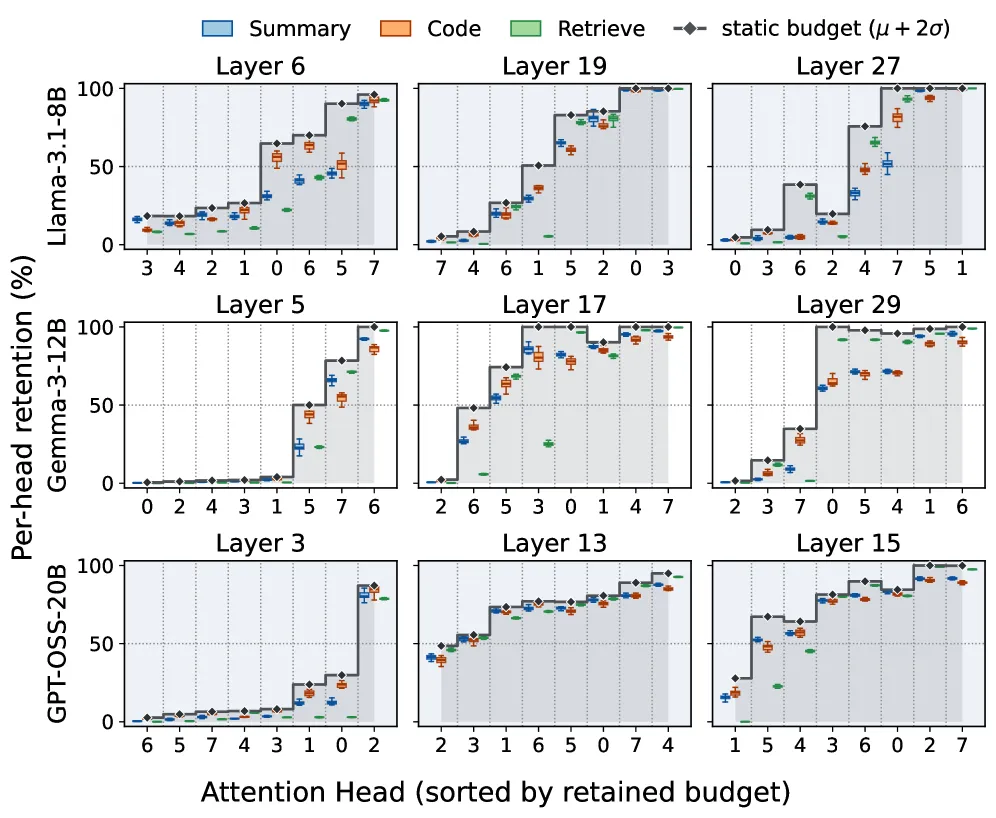
因此只需 50 个校准样本 即可离线预测每 head 预算,从而把「运行时动态决策」转化为「静态计划」。
解决方案:Tangram = Budget Reservation + Ragged Paging + AOT Load Balancing。
三、技术架构/方法
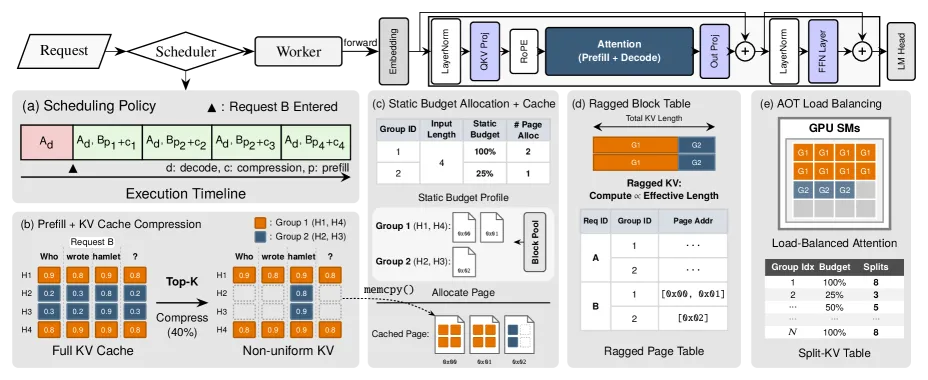
3.1 Budget Reservation:把压缩融入 prefill
- 每个 request 到达时压缩被融入 chunked prefill:每 chunk 计算完 KV 即基于打分函数 与静态 per-head 预算 做 top-k 选择:
- 来自 50 pilot 样本的离线校准;引入安全系数 覆盖 per-input 偏差。
- 全局保留比 表示未压缩基线。
- 结果:post-compression footprint 在调度时就固定,无需运行时 page reclamation。
3.2 Ragged Paging:head-group 独立 page 表
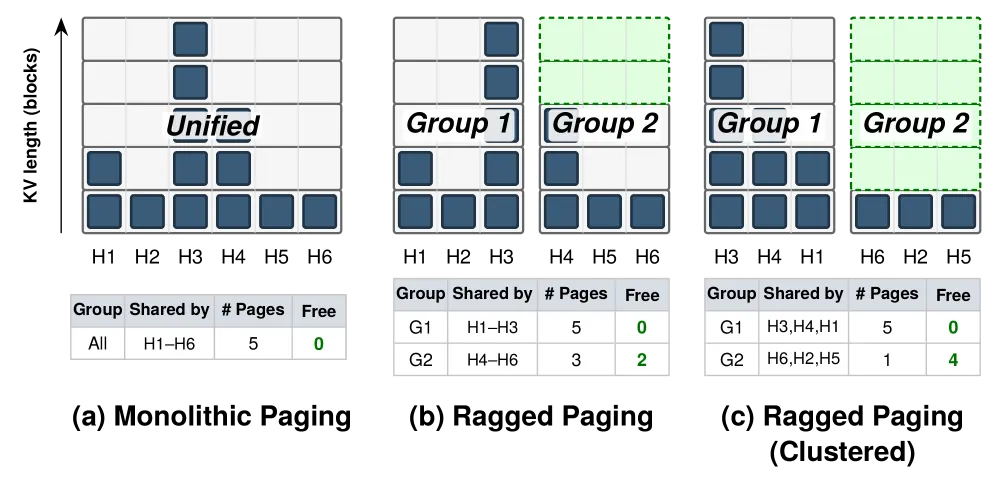
- 将 paging 粒度从「跨所有 head」缩到 -head 组:每组独立 page table,页大小 。
- 每组按其组内最大预算 分配,避免被 long head 拖累。
- Budget-Aware Clustering:把 retention 相近的 head 聚类到同一组,最大化可回收内存。
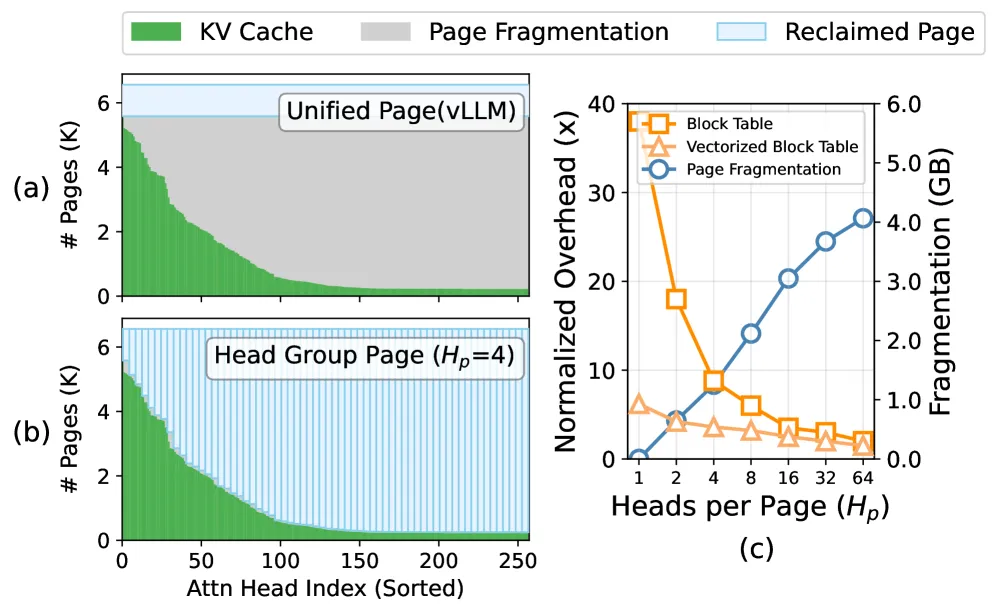
在 Llama-3.1-8B、100K token 单请求、30% 保留下,Ragged Paging 回收原本被困住的短 head 空间。
是关键超参:小 碎片最少但管理开销高;大 反之。
3.3 AOT Load Balancing:预算 CTA 分配
- 因 静态已知,attention 计算的 shape 也提前确定。
- 通过
CUDAMaxOccupancy获取 GPU 可并发 CTA 总数 。 - Algorithm 1 依据每 head-group 聚合预算 比例分配 CTA,输出静态 Workload Split Map 。
- 大预算组分配更多 CTA,小预算组更少;每 CTA 负载均衡,消除因单 CTA 拖尾导致的 tail latency。
- 完全避免每步 decode 的动态 re-planning。
四、核心创新
| 创新点 | 说明 |
|---|---|
| Head-wise retention 两级结构观察 | 输入无关排序 + 窄范围比例,为静态化提供基础,只需 50 样本校准 |
| Budget Reservation | 调度时固定每 head 预算,消除运行时 page reclamation 开销(可节省 25% prefill) |
| Ragged Paging | 独立 head-group page 表,把碎片转为可回收内存 |
| Budget-Aware Clustering | 按 retention 相近性聚类,进一步扩大可释放页 |
| AOT Load Balancing | 静态 Workload Split Map 预算 CTA,消除 15–20% decode re-planning |
| Compression Fusion into Prefill | 压缩融入 chunked prefill + continuous batching,与现代 serving 一致 |
| vLLM Drop-in Substrate | 兼容多种非均匀压缩方法(Ada-SnapKV、Expected Attention、FastKVzip) |
五、实验结果
5.1 设置
- 模型:Qwen3-4B、Llama-3.1-8B、Gemma-3-12B、GPT-OSS-20B、Qwen3-30B-A3B(含 MoE,均支持 100K+ 上下文)。
- Workload:SCBench,长/中/短三档任务。
- 校准:50 pilot samples;safety coefficient ;。
- Baseline:vLLM Full-KV ()。
5.2 多轮精度
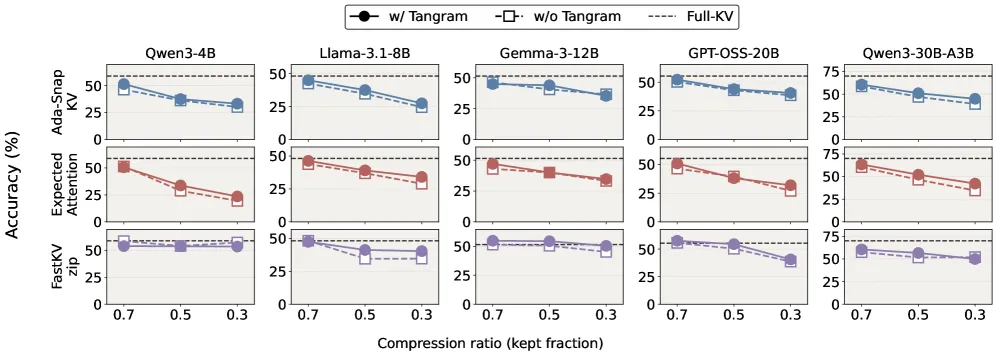
- 在 Ada-SnapKV、Expected Attention、FastKVzip 三种非均匀压缩方法 × 5 模型 × =0.7/0.5/0.3 下,
w/ Tangram完全匹配、部分超越w/o Tangram原实现精度。 - 结论:Tangram 是「保精度的系统 substrate」,压缩比来自底层方法,Tangram 只将其转化为真实吞吐。
5.3 端到端吞吐
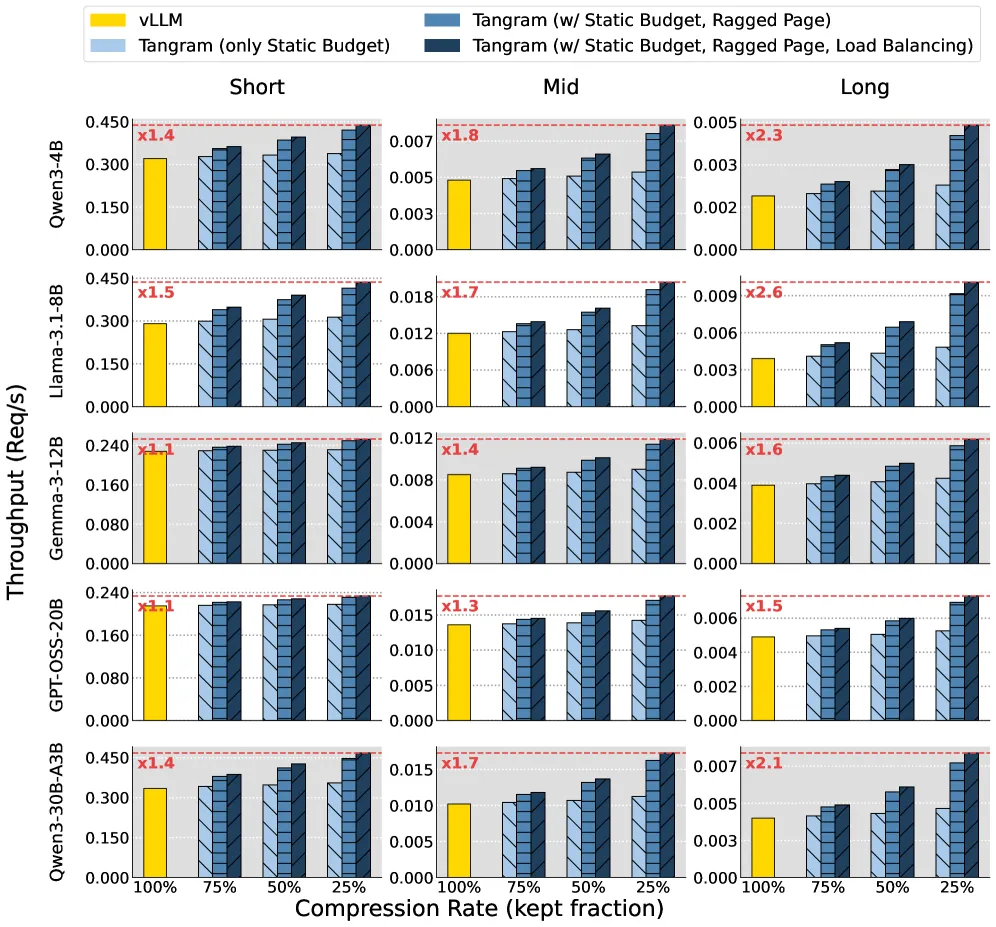
- 在 FastKVzip 上,Tangram 相较 vLLM Full-KV 最高 2.6× 端到端吞吐(,Long task)。
- 增量消融:Budget Reservation → Ragged Paging → AOT Load Balancing,每步都带来正向增益。
- 收益随上下文长度递增(Short→Mid→Long)。
5.4 消除 Page Reclamation
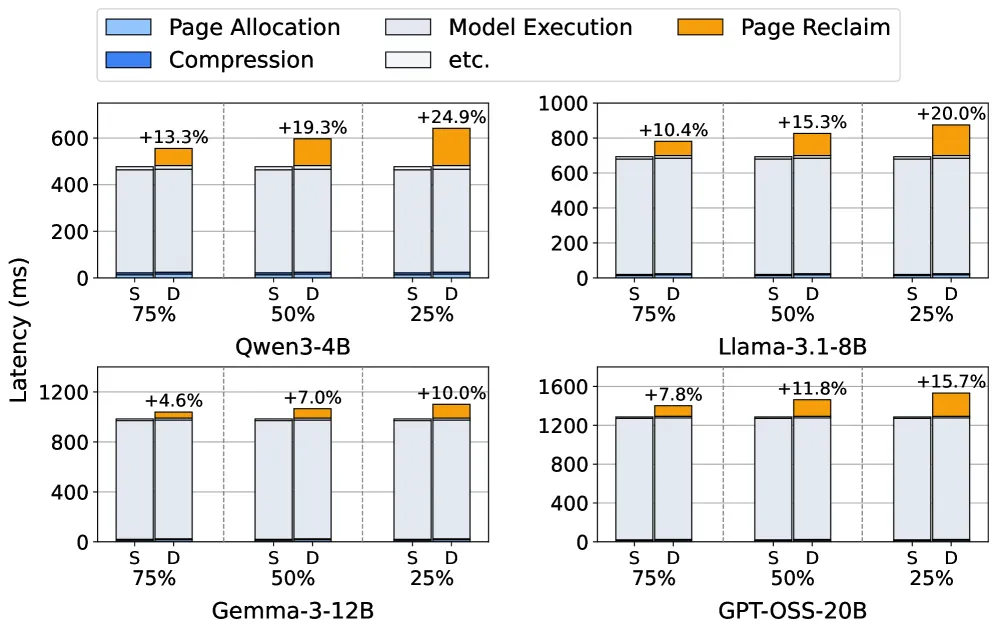
- 动态非均匀压缩 page reclamation 消耗最多 25% prefill 时间。
- Tangram 静态预算直接分配所需页,reclamation 开销近零。
5.5 影响
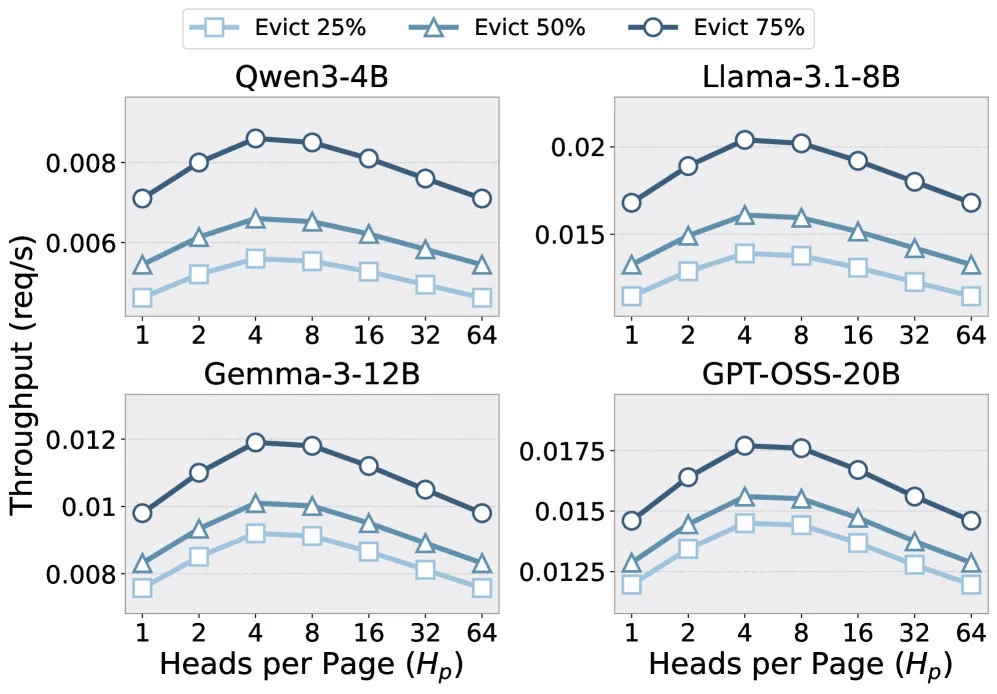
- 在 25/50/75% 驱逐率下, 是碎片 vs 管理开销的权衡;论文默认 。
5.6 AOT Load Balancing 效果
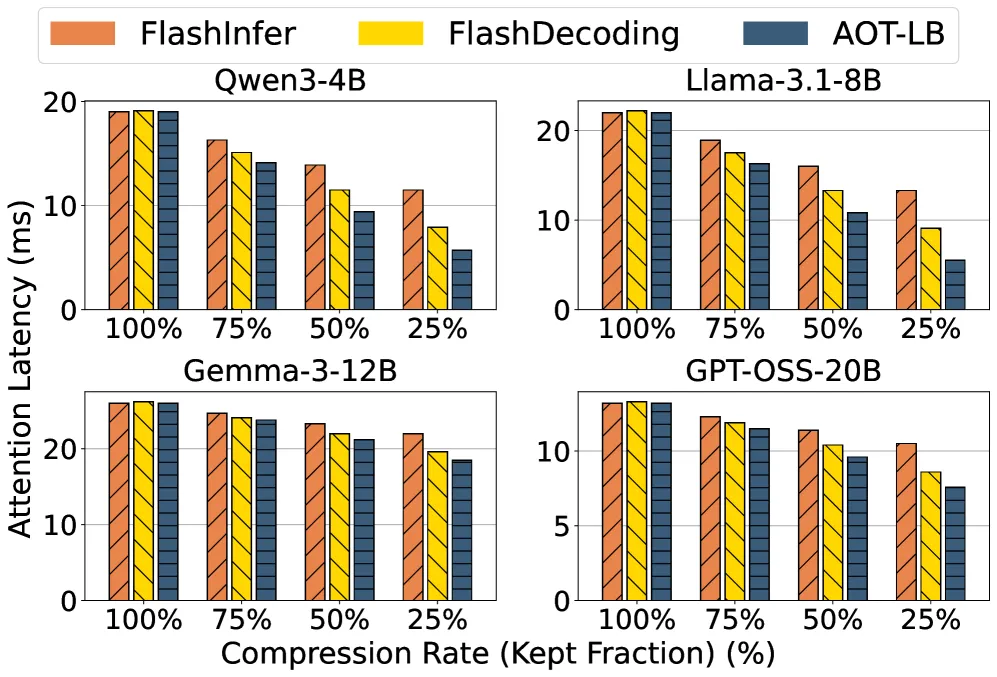
- 在 batch=4 固定下,AOT 显著降低 attention latency(消除 decode re-planning 的 15–20% 开销与 1.7× 的 skew)。
5.7 高压场景 TTFT
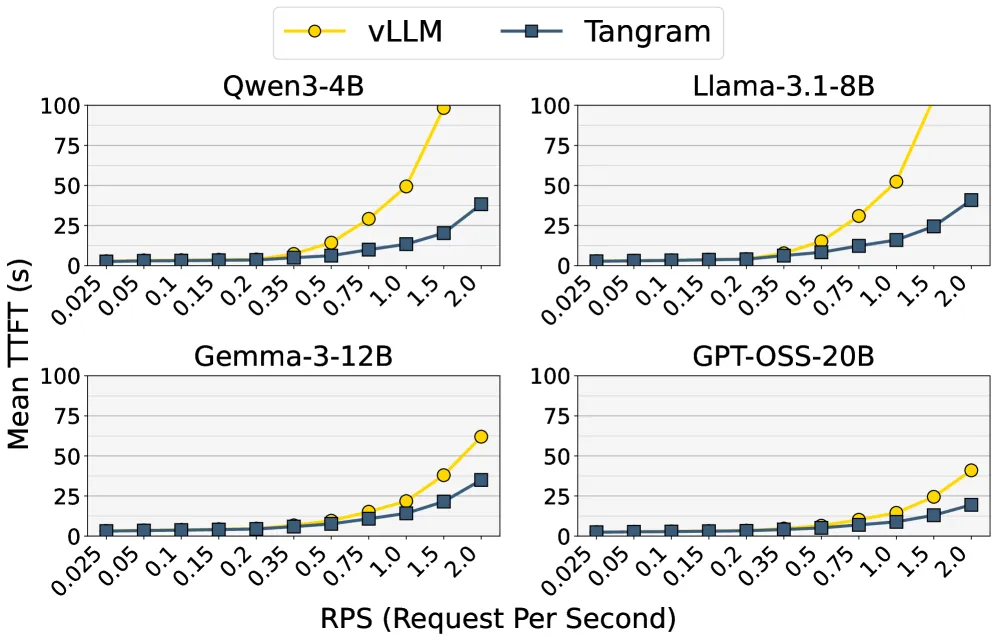
- 平均 30K token、75% 驱逐;随请求率增大,vLLM TTFT 陡升,Tangram 保持低位。
5.8 Budget-Aware Clustering 效果
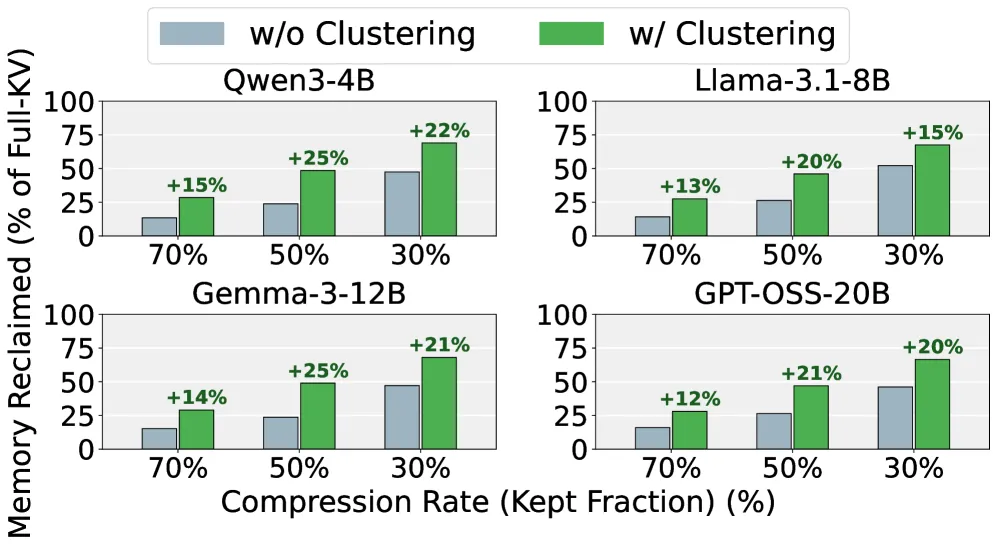
- 启用 Budget-Aware Clustering 后,全 KV 归一比例下的实际回收量显著增加()。
六、总结
核心贡献
- 系统性揭示非均匀 KV 压缩在生产 serving stack 上的三大障碍(碎片、reclamation、负载失衡)。
- 提出「Head 保留量两级结构」的关键观察,只需 50 校准样本即可静态化预算。
- 三个正交技术(Budget Reservation、Ragged Paging、AOT Load Balancing)合力将理论内存节省转化为实际吞吐。
- 作为 vLLM drop-in 层匹配 Ada-SnapKV、Expected Attention、FastKVzip 等非均匀压缩方法的原精度,同时最高 2.6× 吞吐。
技术影响
- 为「head-heterogeneous」系列 KV 压缩打通了从算法到服务的最后一公里。
- Ragged Paging 与 Workload Split Map 概念可推广到其他 head-varying 场景(如 MoE、稀疏 attention)。
- 引入「离线校准 + 安全系数」的静态化思路,为 dynamic → static 转化提供范式。
局限性
- 依赖离线校准;分布漂移显著时精度可能受影响。
- 需按模型调优,安全系数 保守设置有一定容量代价。
- 未直接支持运行时改变 ,无法适配预算需强动态调整的场景。
- 主要在 SCBench 与 100K 级别上下文上评估;更极端上下文/更多模型的行为需进一步观察。
七、参考资源
- arXiv: https://arxiv.org/abs/2606.06302
- HTML: https://arxiv.org/html/2606.06302v2
- 主题:cs.LG, cs.SE
- 相关方法:Ada-SnapKV、SnapKV、Ada-KV、KVzip / FastKVzip、Expected Attention、PagedAttention (vLLM)