RedKnot: Efficient Long-Context LLM Serving with Head-Aware KV Reuse and SegPagedAttention
将位置无关 KV 复用(PIC)的恢复粒度从「token 级」提升到「注意力头级」——离线将每个 (layer, head) 分类为 global(12-15%,复用时重算)/ local(85-88%,滑窗内原样复用),配合 token 选择性稀疏 FFN 攻克短上下文 FFN 瓶颈;再以 SegPagedAttention 按 (layer, head) 分页物化头级稀疏、走 FlashAttention 快路避开 attn_mask 4.9-7.6× 惩罚。8×H800 上 TTFT 加速 1.6-3.54×(DeepSeek-V4 达 5.16×)、并发会话 4.7-7.8×、prefill FLOPs 降 67-79.5%,精度媲美稠密
RedKnot: Efficient Long-Context LLM Serving with Head-Aware KV Reuse and SegPagedAttention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RedKnot: Efficient Long-Context LLM Serving with Head-Aware KV Reuse and SegPagedAttention |
| 作者 | Yang Liu, ZhaoKai Luo, HuaYi Jin, ZhiYong Wang, RuoZhou He, BoYu Wang, Guanjie Chen, Junhao Hu |
| 论文 | arXiv:2606.06256(v2,2026-06-26) |
| 发布 | 2026 年 6 月 4 日(v1),6 月 26 日(v2) |
| 领域 | cs.AI |
| 开源 | https://github.com/rednote-machine-learning/RedKnot(基于 SGLang 实现) |
| 测试硬件 | 8× NVIDIA H800(80GB HBM,~3.3 TB/s) |
| 测试模型 | Mistral-7B、Qwen3-32B、Llama-3.3-70B、Qwen3.5-397B-A17B、DeepSeek-V4-Flash |
二、核心思想
问题定义
LLM 已成为现代软件系统的执行底座:RAG 把上万检索 token 拼进单一 prompt;Claude Code / Codex / OpenClaw 等编码 agent 串起数十次工具调用、聚合输入达数十万 token。输入长度增长远快于 GPU 显存带宽和算力提升,使 prefill 阶段的 TTFT(首 token 时延)成为交互式服务的主导成本——64K token prompt 在 4× 张量并行 Llama-3.3-70B 上稠密注意力约需 64 秒。
两条并行研究线索应运而生:
- 位置无关 KV 缓存(Position-Independent Caching, PIC):对共享文档块的请求预算 prefill——预计算可复用的 KV,无视位置偏移拼接进后续 prompt(CacheBlend、EPIC、ProphetKV、PromptCache);
- 多头 KV 稀疏化:利用「只有一小部分头需要全序列访问」的观察,逐出/压缩其余头的 KV(DuoAttention、RazorAttention、HeadKV、H2O、Scissorhands)。
两方向纸面收益巨大,但部署系统只实现了预测加速的一小部分。论文将 gap 归因于三个结构性错配:
| 错配 | 现象 | 依据 |
|---|---|---|
| 恢复粒度错配 | 现有 PIC 在 token 粒度 恢复残差,但底层稀疏是 per-head——不同头关注不同 token 子集,满足所有头的 token 选择器必须取并集,往往覆盖块的大部分,复用失效 | §3.1 |
| 计算假设错配 | PIC 隐含假设注意力主导 prefill,但在 agent 典型的 2-8K 段长下,FFN 占 TTFT 57-62%——任何注意力侧技术都触及不到 | Fig 3 |
| 存储布局错配 | 即便每头只保留部分 KV,仍以稠密 [B,H,L,D] 布局存储、运行时用 attn_mask 表达,禁用 FlashAttention 快路、招致 4.9-7.6× kernel 惩罚,字节节省无法转为算力节省 | §3.4 |
根因统一:现有 PIC 系统的恢复、计算、存储三个粒度都不匹配 workload 的 per-head / per-channel 稀疏结构;弥合 gap 需同时对齐三条轴。
解决方案概述
RedKnot 通过三个协同设计的机制操作化这一对齐(图 1):
- ❶ Head-class 稀疏化:离线将每个
(layer, head)对分类为 global(12-15% 的头,复用时重新 prefill)或 local(85-88%,在滑动窗口内原样复用),并配自适应运行时 restore——当 edge-mass 信号检测到分类不足时把个别 local 头提升为全注意力,消除 token 级补丁的级联陈旧性; - ❸ SegPagedAttention:以 per-
(layer, head)分页 KV 存储 + 融合 varlen 注意力 kernel 替代稠密布局,物理上只保留每个头需要的 token,让每个头都留在 FlashAttention 快路上、永不构造attn_mask,kernel 加速随上下文长度单调上升(与 dense+mask 的边际递减相反); - ❹ 稀疏 FFN:只对注意力分数最高的 top-
ktoken 求值——这条轴结构上独立于上下文长度,因而是唯一能加速注意力侧优化触及不到的短上下文 agent workload 的杠杆。
三机制作用于正交轴(heads / storage / channels),节省乘性叠加而非争夺同一 slack。
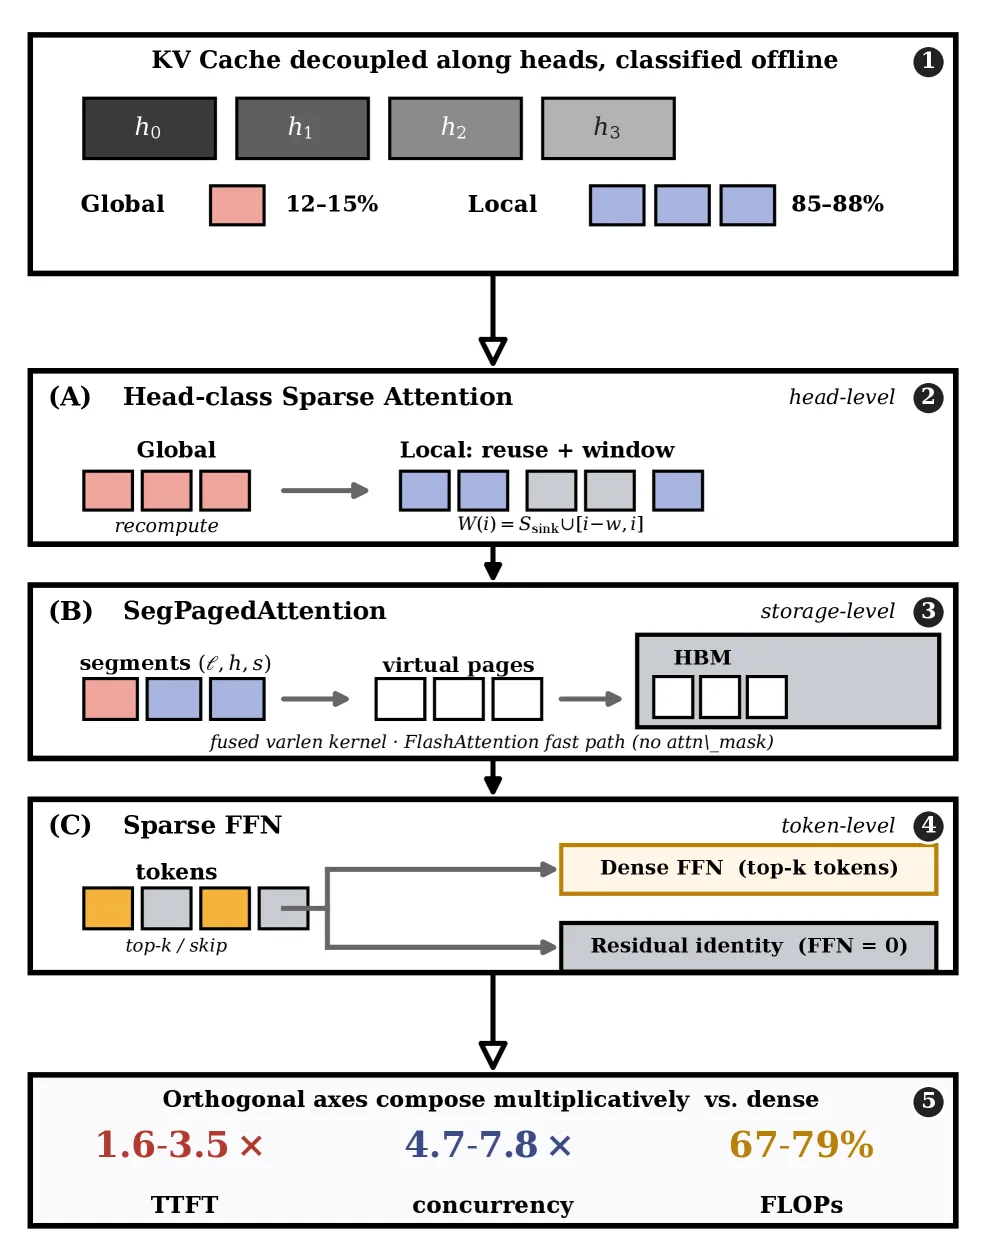
图 1:RedKnot 沿头维度解耦 KV 缓存,将头分类为 global / local,协同优化稀疏注意力、按选中 token 稀疏执行 FFN 与 SegPagedAttention。组合设计带来 1.6-3.5× 更低 TTFT、4.7-7.8× 更高并发、67-79% 更少 FLOPs(对比稠密注意力)。
三、动机与机会(Motivation)
3.1 Token 级恢复的局限
现有 PIC(CacheBlend / EPIC / ProphetKV)选一小部分 token 重算/纠正,假设「只有少量 token 对恢复复用 KV 与全 prefill 的质量差至关重要」。但在多头注意力下,不同头关注不同 token 子集、位置敏感度不同——一个头需纠正的 token 与另一个头不同。系统必须一起恢复某 token 的所有头 → 有效重算集变成各头重要 token 的并集,可覆盖块的大部分。
如图 2,对 Qwen3-32B / Qwen3.5-397B 逐 KV 头算稀疏 token 集再取并集,其占总输入的比例:浅层接近 1(几乎全部 token),深层显著下降。故 token 级方法面对不利权衡:选少 → 头特定误差未纠正、伤质量;选多 → 逼近全 prefill、复用收益消失。
此外 token 级恢复还有级联误差:token i 被选中重算时,前面 token 0..i-1 仍用陈旧复用 KV,故 i 看到的注意力上下文本身被污染,重算 KV 无法恢复到全 prefill 真值,误差前向传播——这是任何 token 级 PIC 方案的固有局限。
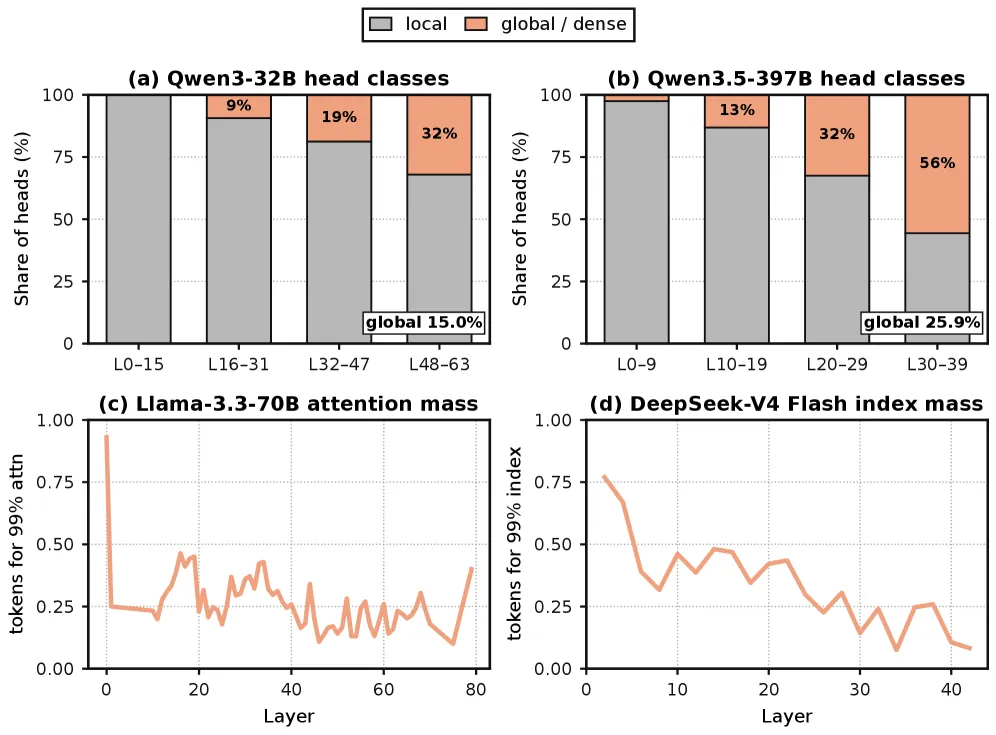
图 2:(a)(b) KV 缓存的全局性随层深显著增加——浅层局部性主导、深层全局性主导;(c)(d) 注意力后 token 级重要性非均匀,层越深注意力越集中于小 token 子集,浅层则分散。
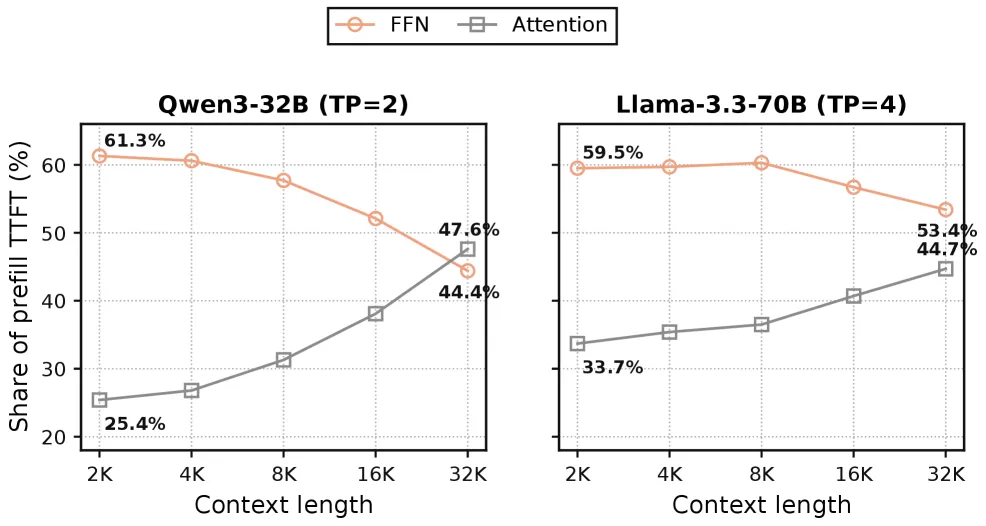
图 3:短上下文下 prefill TTFT 由 FFN 计算主导而非 KV 构造。2K-8K 上下文 FFN 占 >57%;即便 32K,Qwen3-32B / Llama-3.3-70B 的 FFN 仍占 44.4% / 53.4%。
3.2 注意力的头级敏感度
PIC 目标是在块出现于不同 prefix 后仍复用其预计算 KV。相比全 prefill,不同 KV 头偏离缓存态的程度差异巨大:有的头因注意力强受前缀影响而显著改变(global 头),有的头因注意力主要局限于局部上下文而几乎不变(local 头)。这一 global/local 属性对给定 (layer, head) 高度稳定。
在 Mistral-7B、Qwen3-32B、Llama-3.3-70B、Qwen3.5-397B、DeepSeek-V4-Flash 上做 needle-in-a-haystack 测试(图 4):local 头占 83.4%-96.8%,global 头仅 3.2%-16.6%。稳定性允许离线 profile 每个 KV 头属性、跨请求复用;复用时只对小集 global 头集中恢复计算,直接复用大部分 local 头 KV——比 token 级重算更细粒度、成本更低。
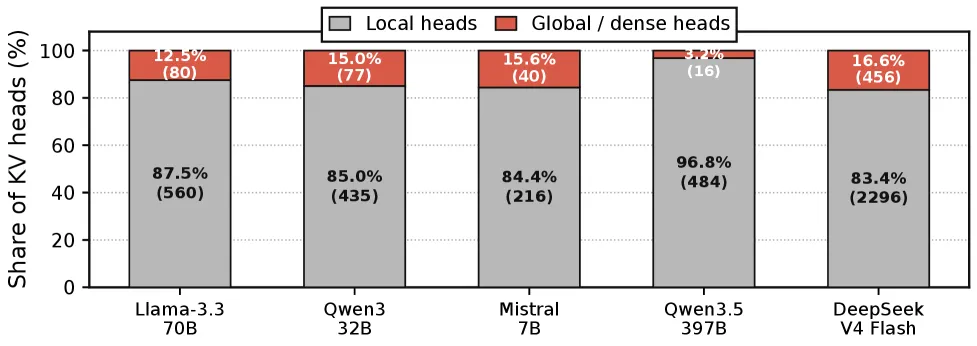
图 4:代表性模型的 global 与 local KV 缓存头数量。local 头压倒性主导。
3.3 高效 PIC 的机会
两个二维机会:
- 从 token 级到 head 级恢复:只重算跨整块的 global 头(12.5-15.6%),local 头(~85%)原样复用;global/local 分配跨请求稳定,离线 profile 一次、零 per-request 分类开销。同时实现更高保真(每个前缀敏感头都全刷新)与更低成本(无 local 头冗余计算);
- token 选择性降 FFN 成本:头级注意力恢复后,用恢复的注意力信号估计 token 重要性——重要 token 走原始稠密 FFN,其余走残差恒等路径。这条稀疏结构独立于 KV 稀疏与上下文长度,是加速短上下文场景的主杠杆。
3.4 挑战
- C1:离散 per-head 稀疏破坏 token 级恢复——头间稀疏模式差异大,取并集逼近全 prefill,选小则头特定误差 + 级联污染(同 §3.1);
- C2:长上下文放大噪声、稀释关键证据——即便证据可得,长输入本身也损害推理质量(lost-in-the-middle、RULER、LongBench);RAG/agent prompt 中只有小部分 token 对当前 query 有用,稠密 prefill 让无关 token 消耗算力、扰动隐状态、经残差流传播噪声更新;
- C3:Token 级 KV 布局放大 HBM 流量——70B 模型 128K 上下文 KV 缓存 >40GB;现代 GPU 算存平衡点 A100 ~156、H100 ~295 FLOP/Byte,长上下文推理常低于此阈值、受内存带宽限制。头级异构访问(global 需全上下文、local 只需 sink+近窗)与 token-block 粒度布局错配 → 访问一个头隐式加载/移动/重写同块无关头,读写放大、浪费带宽,也限制分布式/分离式服务。
四、技术架构
4.1 RedKnot 总览
RedKnot 含两个核心组件:Elastic Sparsity 模块 与 KV-cache 头粒度存储模块。端到端流程(图 5):
- ❶ 离线阶段:对文本跑推理生成 KV 缓存;通过 profiling 为每个模型构建以
(layer, head)索引的 KV 头 hashmap,记录每个头的 global/local 属性; - ❷ 头粒度存储:以 KV 头粒度存储 KV,建立每个头的段到虚拟页号的映射;
- ❸ 在线 query:加载相关文本,完全重算 global 头(除非其 KV 落在 prefix),local 头大量复用、仅重算一小部分;
- ❹ 部分稀疏 FFN:某层 KV 算完后用部分稀疏 FFN 降开销,同时缓解深层 KV 的注意力噪声;
- ❺ 实现低算力、低 TTFT、高精度的高效长上下文服务。
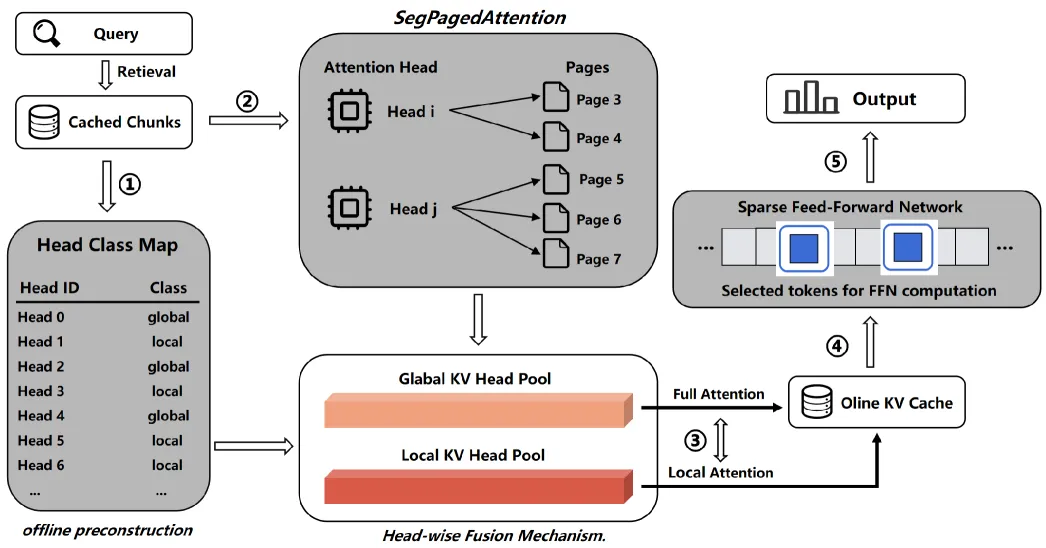
图 5:RedKnot 总览——离线 profiling 构建头分类映射与头粒度 KV 存储,在线按头类恢复 + 部分稀疏 FFN。
4.2 Elastic Sparsity(应对 C1/C2)
目标:恢复 PIC 复用质量而不重放全稠密 prefill 路径。分解为三步——
① RoPE 位置对齐:RoPE 具旋转不变性,位置偏移可表为 query-key 内积的相对旋转。缓存块离线于位置 、复用于在线位置 时:
移除搬块导致的确定性位置错配,剩余误差主要来自上下文错配(块现于不同前缀之后)。
② 逐层 elastic recovery:
- 浅层(
ℓ < L_dense):local 注意力恢复 + 全 FFN 计算——保守设计保护早期残差流(隐状态更敏感、误差易被后续层放大); - 深层:global 头注意力恢复 + 稀疏 FFN——深层语义选择性更强、注意力更集中。
③ 头级注意力恢复:global 头在新前缀下重算 KV(除非已被标准 prefix 复用覆盖);local 头在 token i 只重算局部可见集:
例:i=1000, w=256 时只重算 sink token 与位置 744-1000 的局部窗,直接复用其余 local 头 KV。
④ 部分稀疏 FFN 恢复:深层用恢复的注意力信号估计 token 重要性,高重要性 token 走稠密 FFN、其余走残差恒等路径——只在纠正可能影响最终隐状态处花 FFN 计算。
两条稀疏维度互补:头级注意力恢复减少跨头冗余 KV 重算;部分稀疏 FFN 避免跨 token 稠密 FFN 重放。Algorithm 1 汇总该过程。
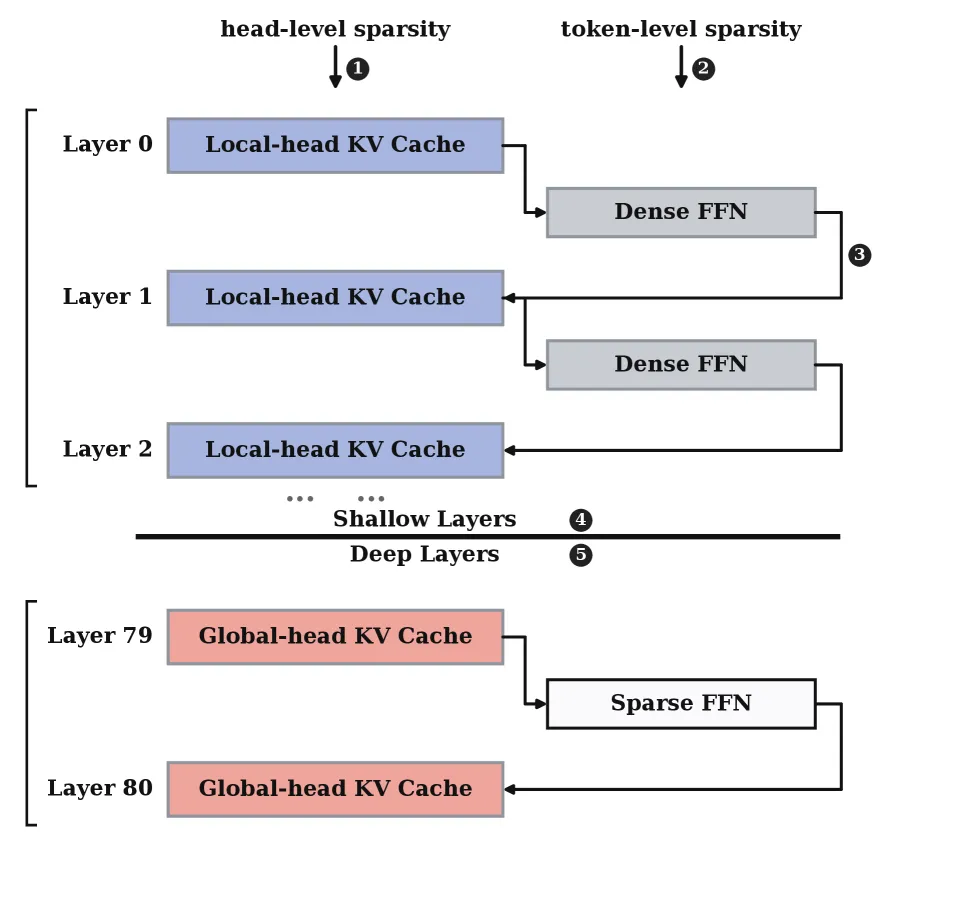
图 6:Elastic Sparsity 工作流——KV 走多头稀疏策略,FFN 走 token 级稀疏;浅层复用 local 头 KV + 稠密 FFN,深层重算 global 头 + 稀疏 FFN。
4.3 SegPagedAttention(应对 C3)
存储与执行底座,支撑 Elastic Sparsity 的头级恢复策略,也为现有头稀疏 KV 算法提供通用系统底座。现有分页 KV 系统按 token-block 粒度 组织(块内所有头一起分配/传输/访问),对头级 PIC 恢复太粗。SegPagedAttention 引入头分段 KV 布局:
- ❶ 缓存态表为 head segment,由
(ℓ, h, s)索引(层 id、KV 头 id、该头流内段 id); - ❷ 每个 head segment 含单个 KV 头的连续 KV 范围;引入虚拟页间接层——head segment 映射到一或多个连续虚拟页,虚拟页再映射到底层 PagedAttention 管理的非连续物理页,保留现有分页基础设施同时暴露头可寻址逻辑布局;
- ❸ global 段的存储页 I/O 访问频率高(需全上下文/长程恢复);
- ❹ local 段的存储页 I/O 频率低(只消费 sink + 短近窗)。
关键优势:解耦头特定执行策略与 token-block 存储。token 级分页下,块内任一头需全上下文恢复就会加载/重算整块所有头;SegPagedAttention 让运行时只访问所需 head segment 的页——global 段访问全映射页范围(除非在 prefix),local 段只访问可见区(sink 页 + 近窗页)重叠的页。Algorithm 2 汇总:构建头特定元数据后,融合 varlen 注意力 kernel 一次遍历打包的头特定页列表,避免为每个 token block/段独立启动。
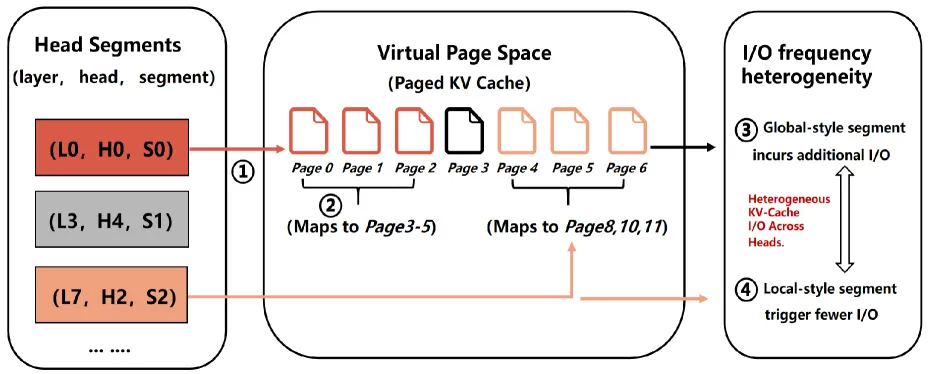
图 7:SegPagedAttention 总览——head segment 经虚拟页间接层映射到非连续物理页,global/local 段呈现不同 I/O 频率,融合 varlen kernel 一次处理全层各头。
4.4 架构无关实现
RedKnot 实现为架构无关运行时而非模型专用稀疏注意力 kernel。核心抽象是 reusable state object(关联层、头/头组、段范围、状态类型、位置变换、执行策略)——可对应显式 KV 页、MLA 潜状态或循环线性注意力状态。每个架构后端实现四个 adapter 函数:Profile(测每层每头有效范围、产头策略映射)、BuildState(构建离线复用态)、SelectVisibleState(决定每头运行时可见段)、Execute(调后端算子:显式 KV 融合注意力 / FlashMLA / 循环态组合)。
- Qwen3.5-style 混合模型:全注意力层用标准头级 KV 路径;Gated DeltaNet 线性注意力层不暴露 token 级 KV 但有多头循环态,同样按头级原则分类——global 线性头重算循环态,local 线性头缓存窗外循环态为紧凑 prefix-state checkpoint,只重放近窗
[i-w_{ℓ,h}, i]内更新;MoE 块用全注意力层作 token 重要性同步点(注意力 mass 超阈 τ 的 token 走全 MoE,低重要走轻量路径); - DeepSeek-V4-style MLA 模型:运行时保持原生 MLA 表示(仅离线 profiling 用解压头视图分类);global 头在线重算,local 头存窗外历史为压缩 ;因大多 local 头用 128-token 滑窗,只重算每个非首块的前 128 token(跨块上下文缺失影响最大处);最终用 log-sum-exp softmax 融合 与 ——关闭离线压缩时数值等价稠密全注意力;用 DeepSeek-V4 内置 indexer 信号作稀疏指示器。
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 头级稀疏化 PIC | 在注意力头而非 token 粒度恢复缓存 KV,规避 token 并集问题与级联误差 | §3.1、§4.2;Fig 8 EM/F1 |
| SegPagedAttention | per-(layer, head) 分页 KV + 融合 varlen kernel,物理物化头稀疏、留在 FlashAttention 快路 | §4.3;消除 4.9-7.6× mask 惩罚 |
| 虚拟页间接层 | head segment→虚拟页→非连续物理页,兼容现有 PagedAttention 分配器 | §4.3 |
| 选择性稀疏 FFN | 只对高注意力 mass token 走稠密 FFN,攻克短上下文 FFN 瓶颈(独立于上下文长度) | §3.3、§4.2 |
| 架构无关运行时 | reusable state object + 四 adapter 接口,统一 GQA / MLA / 线性注意力 | §4.4 |
| 稀疏即去噪 | 长上下文下稀疏恢复抑制低价值 token 态、反而提升精度 | §5.7;Fig 13 crossover |
六、实验结果
6.1 评测设置
- 硬件:8× H800(80GB,~3.3 TB/s),Xeon 8468V ×2,2TB DDR,NVMe RAID-0;PD 分离用 4× RDMA RoCE v2(~200 Gbps);
- 软件:Ubuntu 24.04、CUDA 12.9、PyTorch 2.9.1、Triton 3.5.1、SGLang、定制 vLLM 0.13.0(PD 实验);
- 模型与稀疏配置(离线 profiling 决定 global/local、local 窗、稀疏 FFN 阈值, = 需全局恢复的头占比):
| 模型 | 并行 | local 窗 | 备注 | |
|---|---|---|---|---|
| Mistral-7B | TP=1 | 9.4% | 256 | — |
| Qwen3-32B | TP=2 | 9.4% | 4096(后 16 层滑窗) | 前 48 层全注意力 |
| Llama-3.3-70B | TP=8 | 10.0% | 256 | 前 20 层稠密 FFN,深层 mass_thresh 0.2→0.05 |
| Qwen3.5-397B-A17B | TP=8 | ~4.3% | 2048 | 60 层(15 全注意力 + 45 GatedDeltaNet),~52% 省算力、2.07× TTFT |
| DeepSeek-V4-Flash | TP=8 / PP=8 | 4.6% | 128 | MLA 单共享潜 KV 头,indexer top-k |
- 数据集:HotpotQA、MuSiQue、2WikiMQA、TriviaQA、MultiFieldQA、Qasper 等(8K-128K);
- 基线:稠密 HF-sdpa、FlashAttention-3、SGLang、vLLM-PD、token 级 PIC(CacheBlend、ProphetKV);
- 指标:F1、EM、首 token logit cosine、top-1/top-10 agreement、TTFT、QPS/GPU、并发会话数。
6.2 质量与 TTFT(§5.2)
RedKnot 总体取得比 token 级 PIC 更优的质量-时延权衡:精度接近全重算(通常 ≥95% 稠密 F1),TTFT 加速 1.4-5.2×,且优势随上下文增长。
质量:Llama-3.3-70B HotpotQA 上 RedKnot 把 EM 从 0.60(稠密)提到 0.80(32K/64K),而 CacheBlend/ProphetKV 停在 0.4-0.6;Qwen3-32B MultiFieldQA 上 RedKnot F1=0.52(近稠密 0.6),ProphetKV 崩到 ~0.1;top-1 agreement 0.93、top-10 0.87(基线 ≤0.5)。Qwen3.5-397B 上甚至在若干情形超全重算(2WikiMQA 32K F1 0.68 vs 0.62);DeepSeek-V4-Flash(FP8)上 HotpotQA/TriviaQA 与重算几乎一致(16K F1 0.67、EM 0.76)。
TTFT:稠密模型上从 M-TQA-16K 的 1.6× 升到 L70-HQA-64K 的 3.5×(该长度最快,基线停在 2.0-2.4×);Qwen3.5-397B 从 16K 的 2.05× 升到 64K 的 2.30×;DeepSeek-V4-Flash 从 16K 的 3.51× 升到 128K 的 5.16×。加速源自两处互补:头级执行减注意力恢复(只重算 global 头)+ 稀疏 FFN 突破 token 级基线保留稠密 FFN 的天花板。
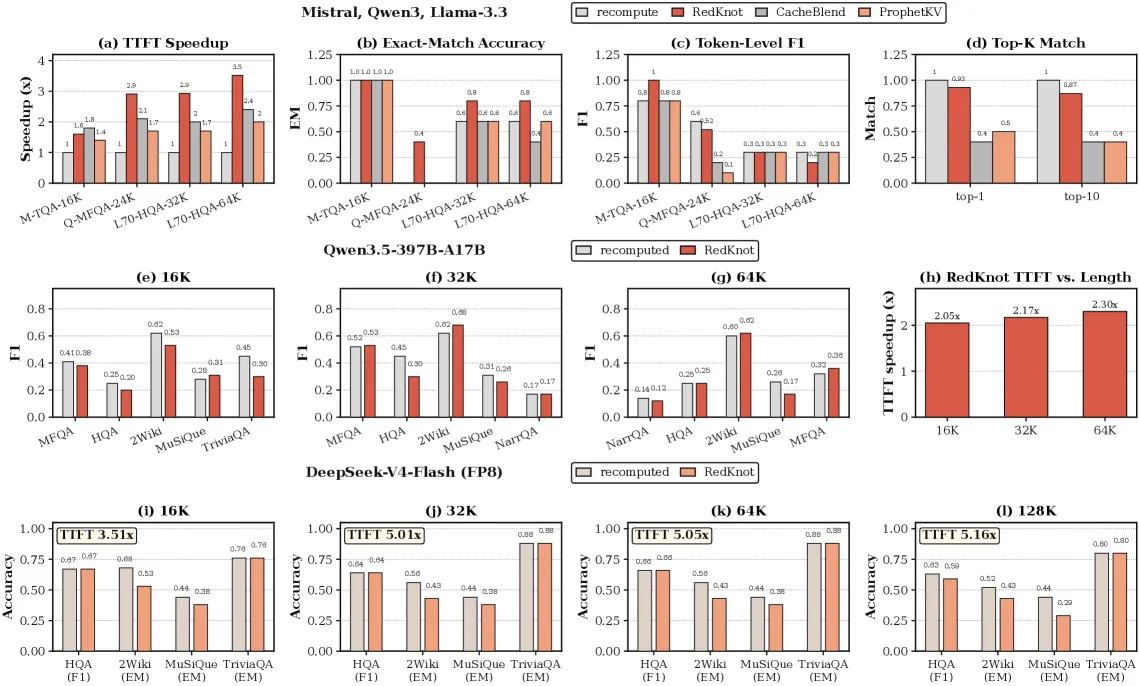
图 8:三个模型族的端到端精度与 TTFT。RedKnot 逐面板 TTFT 加速 3.51×-5.16×,精度通常 ≥95% 稠密 F1,全面支配 token 级 PIC 的质量-时延权衡。
6.3 吞吐与 SegPagedAttention(§5.3)
QPS 吞吐:所有 KV 复用方法都显著高于稠密重算,优势随长度增长。Qwen3.5-397B @64K RedKnot ~0.2 QPS/GPU vs 重算 ~0.05(~4×)。短上下文(8K-16K)下 CacheBlend/ProphetKV 略高于 RedKnot——因当前 RedKnot 后端仍用稠密 KV 布局 + attn_mask 表达头稀疏(实现瑕疵,下文 kernel 隔离测量移除之)。
SegPagedAttention kernel 隔离(Qwen3-32B-shaped,半 global 半 local、local 320-token 窗):
- decode:Dense+mask 从 8K 的 31.8ms 涨到 128K 的 506.8ms;SegPagedAttention 几乎持平(12.6/12.4/24.1ms)→ 2.5× / 9.8× / 21.0× 加速;融合全头 varlen 再快 2.85-3.39×;
- prefill:64 层从 0.34s→0.055s(8K)、1.35s→0.12s(32K)、5.42s→0.23s(128K)→ 6.3× / 11.3× / 23.3×;
- 本质是带宽效应:稠密布局无法阻止 GPU 加载被忽略 token 的流量;SegPagedAttention 让 local 头只搬 320-token 窗。token 吞吐:SDPA+mask 从 5.9K→1.5K tok/s(保留 25%),SegPaged 从 37.4K→17.1K(保留 46%,8K 时快 6.3×)。
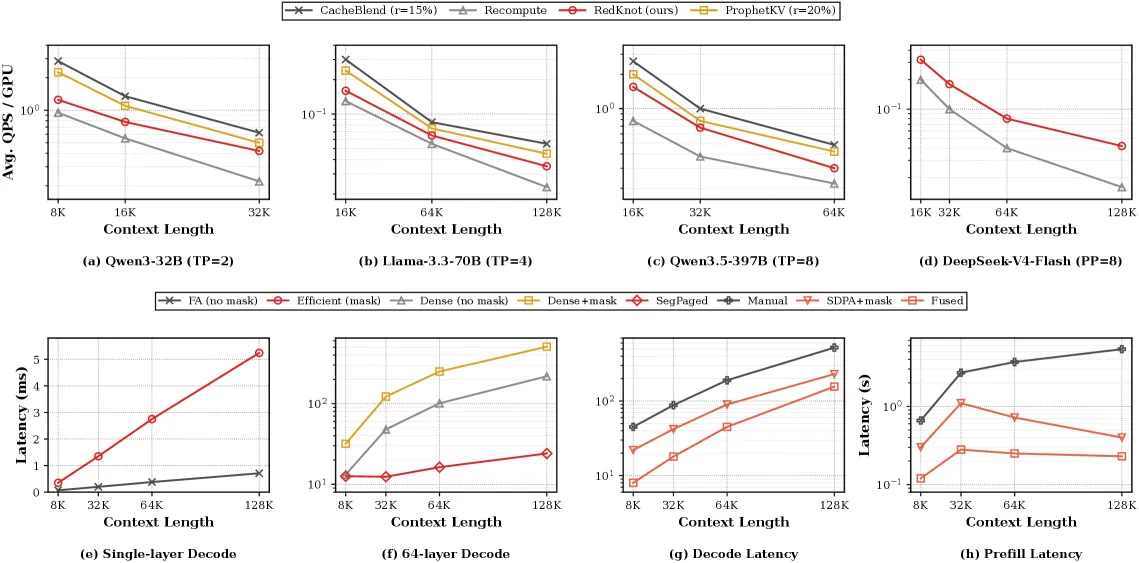
图 9:吞吐(QPS/GPU 对数轴)与 SegPagedAttention kernel 隔离时延,所有路径数值等价(cos > 0.99998)。
6.4 Prefix 压缩(§5.4,PD 分离场景)
global/retrieval 头保全 prefix KV,local 头只保 sink+窗、逐出中间(真逐出,非零填充)。Qwen3-32B trim<32 配置(前 32 层 trim local 头,W=4096, sink=128):
- 首 decode 步 logit cosine 始终 >0.99 阈(8K 0.9911 / 32K 0.9987),KV 传输节省从 8K 的 24% 单调升到 32K 的 44%;
- 固定 ~46 GiB KV 预算下并发批从 5→10(32K),聚合 decode QPS/GPU 0.057→0.108(1.90×);
- 跨数据集 logit cosine ≥0.974。单流时延变化小(~1.1×),收益本质来自固定显存下的并发。
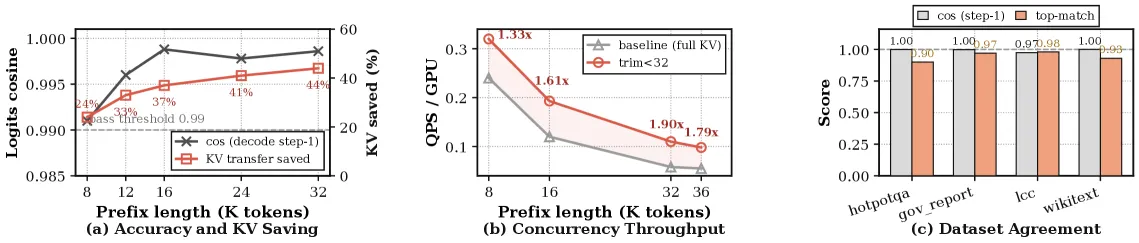
图 10:Qwen3-32B PD 分离下的 prefix 多头 KV 压缩——精度、KV 传输节省、并发吞吐。
6.5 KV 缓存生命周期管理(§5.5)
回放真实 MuSiQue 请求流(2417 问题、48,315 次块访问、17,629 唯一 passage):
- 62% 的块从不复用,「cache-all」需 524GB KV(DeepSeek-V4 MLA);
- 复用计数重尾分布,多数块只见 1-2 次;
- 复用几乎全为非 prefix(per-chunk 非 prefix 比均值 0.95)→ prefix 缓存捕获极少可用复用;
- 高复用块倾向长驻留;
- 成本-收益前沿:只缓存复用 ≥R 次的块——
R≥20用 1.5GB 省 39% 重算,R≥5用 7.8GB 省 75%,R≥2用 25.5GB 省 99%。
启示:应在块证明值得缓存后才 materialize KV(admission gate 按复用计数阈值),按复用 + recency 逐出、按 arbitrary chunk 而非 prefix 粒度管理。
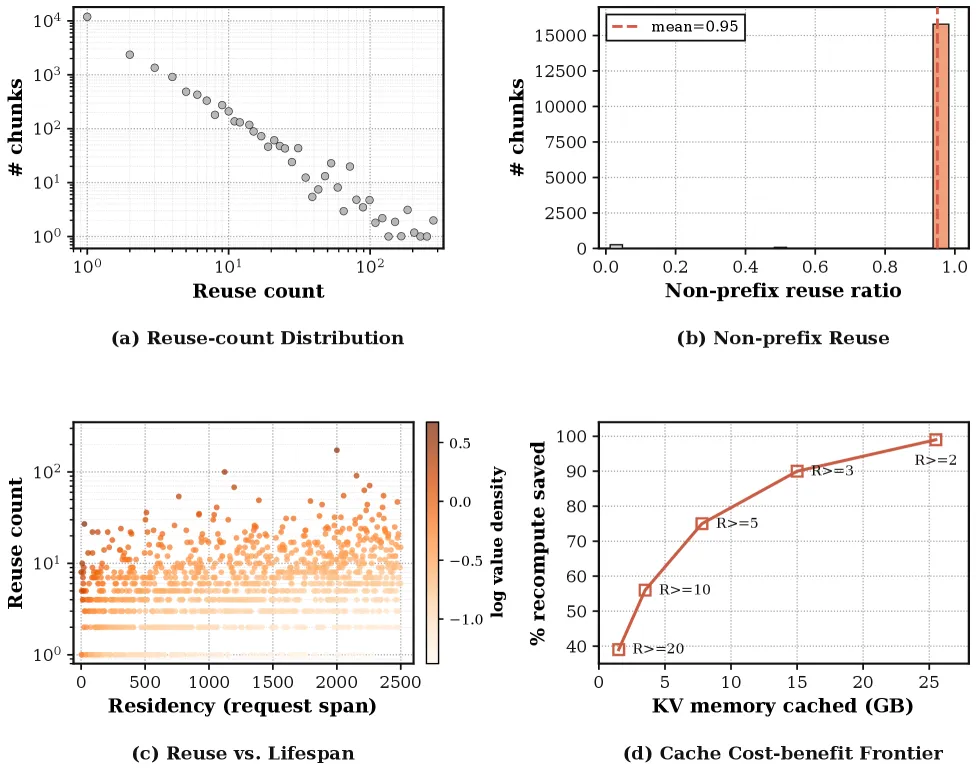
图 11:MuSiQue 流的块级 KV 复用统计——复用计数分布、非 prefix 复用占比(均值 0.95)、复用 vs 驻留、省重算 vs 所需 KV 显存。
6.6 其他系统级收益(§5.6)
- PD 边界 KV 传输:Llama-3.3-70B 传输量 8K 降 4.3×、16K 降 5.7×,传输时延降 4.1×;Qwen3-32B 字节降 5.6-6.3× 但时延仅 1.0-1.5×(张量小,剩余时间被启动/打包/链路建立主导);
- 突发吞吐:Llama-3.3-70B 8K +43%、16K +27%;Qwen3-32B 8K +28%(收益随长度缩小——该后端仍走 dense+mask,付 SDPA mask 惩罚);
- 并发会话容量(SegPagedAttention 物理物化稀疏):32K 从 4→31(7.8×),64K 从 3→14(4.7×),投影 3.4-3.9× 容量吞吐——把绑定约束从「多少稠密 KV 装进 HBM」变为「多少紧凑 per-head 缓存装得下」。
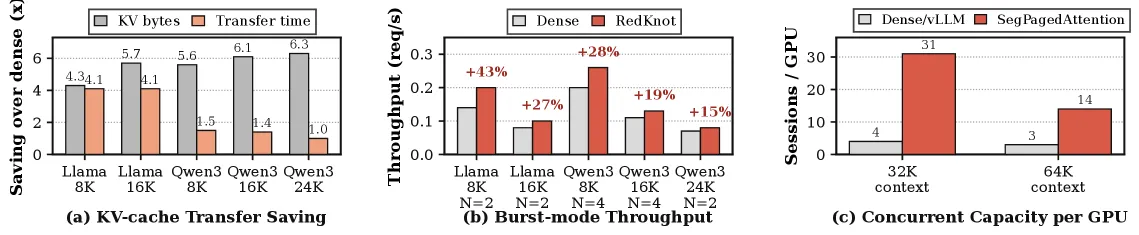
图 12:头类 KV 稀疏的系统级效应——PD 传输节省、突发吞吐、每 GPU 并发会话数。
6.7 稀疏去噪(§5.7)
隔离长上下文行为:并非所有 token 对下一 token 决策同等有用。在 Qwen3.5-397B / DeepSeek-V4-Flash 上:
- 覆盖 99% 注意力 mass 所需 token 比例随上下文长度快速下降(检索型 HotpotQA/2WikiMQA 最稀疏,摘要型 GovReport 最稠密);
- 稠密精度随长上下文噪声退化,RedKnot 保持稳定并在长上下文区间反超稠密——短上下文稠密略优(保留弱长程信号),长上下文稠密传播更多干扰 token、精度在中长区后下降;RedKnot 稀疏恢复抑制低价值 token 态、保留高 mass 结构,在 64K-128K 收益比 8K-16K 更大。
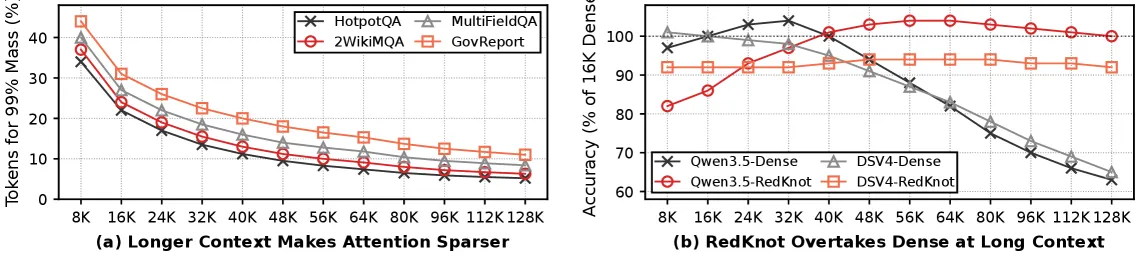
图 13:稀疏去噪随上下文增长愈发有用。(a) 覆盖 99% 注意力 mass 的 token 比例随长度下降;(b) 稠密精度退化,RedKnot 稳定并在长上下文反超。
七、未来工作
论文主张下一代推理引擎不应围绕稠密层、稠密序列、prefix-only 缓存命中组织,而应建立稀疏、复用、有效性对整个引擎可见的新服务契约:
- 头级 KV 作一等引擎对象:让 per-
(layer, head)KV 对象成为引擎原生——缓存管理器按每头 live 范围分配页,注意力 API 默认接受 ragged per-head 长度,调度器推理异构头成本(global 头带宽重、留近 GPU;local 头可压缩/分层/激进逐出); - 位置无关 KV 作默认缓存契约:暴露内容寻址、头感知的缓存对象,元数据含 per-head 有效性、恢复成本、压缩足迹、预期复用频率;admission 优先可能复现的块,eviction 兼顾字节与恢复价值,PD 分离只传 head-class payload;
- 跨注意力与 FFN 的噪声感知调度:runtime 不仅决定「能跳过什么」,还决定「为质量应跳过什么」——把算力当预算资源分配给高信号头/token/块,按任务类型自适应阈值,协调注意力稀疏与 FFN 稀疏;
- 统一稀疏服务栈:避免反复把稀疏决策翻译回稠密接口,让缓存布局、kernel 分发、网络传输、admission、eviction、调度共享同一稀疏元数据——使稀疏成为一等运行时抽象。
八、参考资源
- arXiv 论文:https://arxiv.org/abs/2606.06256
- 开源实现:https://github.com/rednote-machine-learning/RedKnot(基于 SGLang,定制 vLLM 0.13.0 for PD)
- 对比基线:CacheBlend、ProphetKV、EPIC(token 级 PIC);DuoAttention、RazorAttention、HeadKV、H2O、Scissorhands(多头 KV 稀疏)
- 评测基准:HotpotQA、MuSiQue、2WikiMQA、TriviaQA、MultiFieldQA、Qasper、LongBench、RULER
- 测试模型:Mistral-7B、Qwen3-32B、Llama-3.3-70B、Qwen3.5-397B-A17B、DeepSeek-V4-Flash