AgentJet: A Flexible Swarm Training Framework for Agentic Reinforcement Learning
面向 Agentic RL 的灵活 Swarm 训练框架
AgentJet: A Flexible Swarm Training Framework for Agentic Reinforcement Learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | AgentJet: A Flexible Swarm Training Framework for Agentic Reinforcement Learning |
| 作者 | Qingxu Fu, Boyin Liu, Shuchang Tao, Zhaoyang Liu, Bolin Ding |
| 机构 | Tongyi Lab, Alibaba Group |
| 论文 | arXiv:2606.04484 |
| 代码 | GitHub - modelscope/AgentJet |
| 发布 | 2026年6月3日 |
| 主题 | cs.AI, cs.LG, cs.MA |
二、核心思想
问题定义
Agentic Reinforcement Learning (RL) 使大语言模型 (LLM) 能够进行多轮推理、工具调用和复杂工作流执行。然而,现有的 RL 训练框架存在以下关键局限:
- 运行时脆弱性: Agent rollout 环境与模型训练共存于同一集群,单个组件故障可导致整个训练管道崩溃
- 调试摩擦: 修改 agent 代码或奖励函数需要重启整个训练过程(5-10 分钟迭代周期)
- 多模型约束: 当前系统主要优化单个策略模型,难以支持异构多智能体系统
- 冗余上下文: 多轮交互中对话上下文积累大量冗余(重复的系统提示、工具定义、观察历史)
- 环境锁定: 多任务联合训练需要强隔离,单体架构难以提供
解决方案概述
AgentJet 是一个分布式 swarm 训练框架,通过客户端-服务器范式完全解耦 agent 运行时与训练基础设施:
- Swarm Server Nodes (优化器节点): 在 GPU 集群上托管可训练模型并运行优化
- Swarm Client Nodes (采样节点): 在任意设备上执行任意 agent
核心能力
| 能力 | 说明 |
|---|---|
| 异构多模型 RL | 训练使用多个 LLM 作为大脑的异构多智能体团队 |
| 多任务 Cocktail 训练 | 隔离的 agent 运行时,支持不兼容依赖的任务混合训练 |
| 容错执行 | 外部环境故障不会中断训练过程 |
| 热插拔调试 | 训练期间可编辑 agent 代码,秒级重启 |
| Timeline 合并 | 消除冗余上下文,实现 1.5-10× 训练加速 |
| 自动化研究 | 自主进行多天 RL 研究的自动化系统 |
三、技术架构
整体框架图
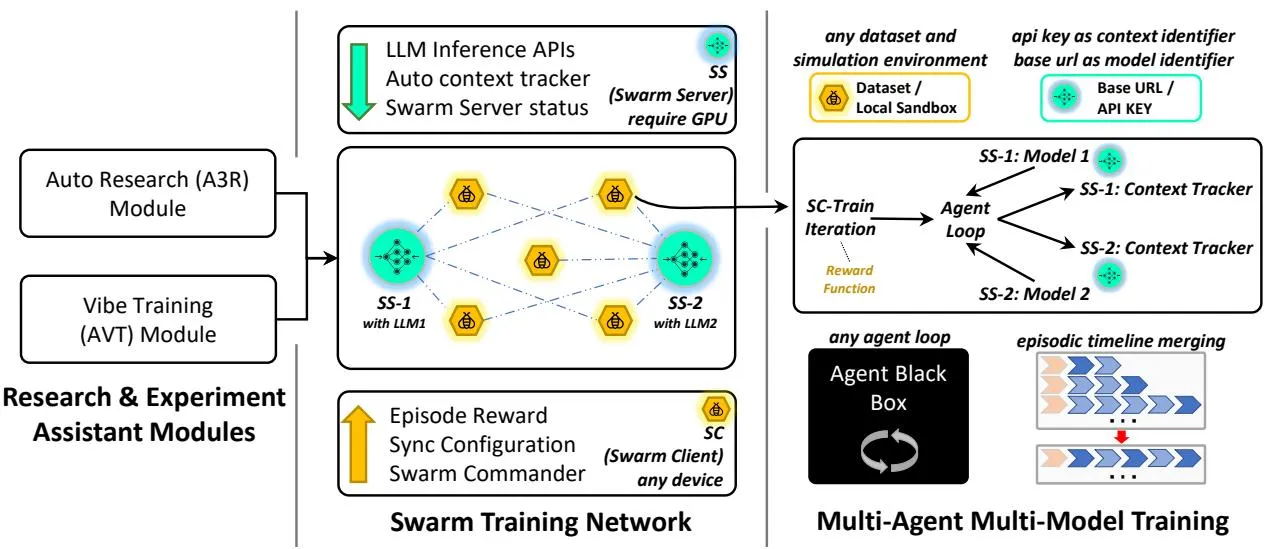
Figure 1: AgentJet swarm 训练架构。Swarm servers (优化器节点) 在 GPU 集群上托管模型权重,Swarm clients (采样节点) 执行 agent 工作流并收集 RL 训练轨迹。Swarm 网络动态形成,支持容错操作、热插拔调试和多模型训练。
核心组件
| 组件 | 说明 | 关键特性 |
|---|---|---|
| Swarm Server | 训练引擎,运行在 GPU 服务器上 | 执行策略梯度更新,托管 vLLM/SGLang 推理 API,管理 episode 生命周期 |
| Swarm Client | 轻量级 CPU-only 进程 | 执行任意 agent 工作流,读取数据集,运行 agent 循环,计算奖励 |
| Context Tracker | Episode 级上下文跟踪与重建 | 拦截所有 LLM 请求,tokenize、记录、转发 |
| Timeline Merger | 合并冗余时间线 | 1.5-10× 训练加速 |
Swarm RL 范式
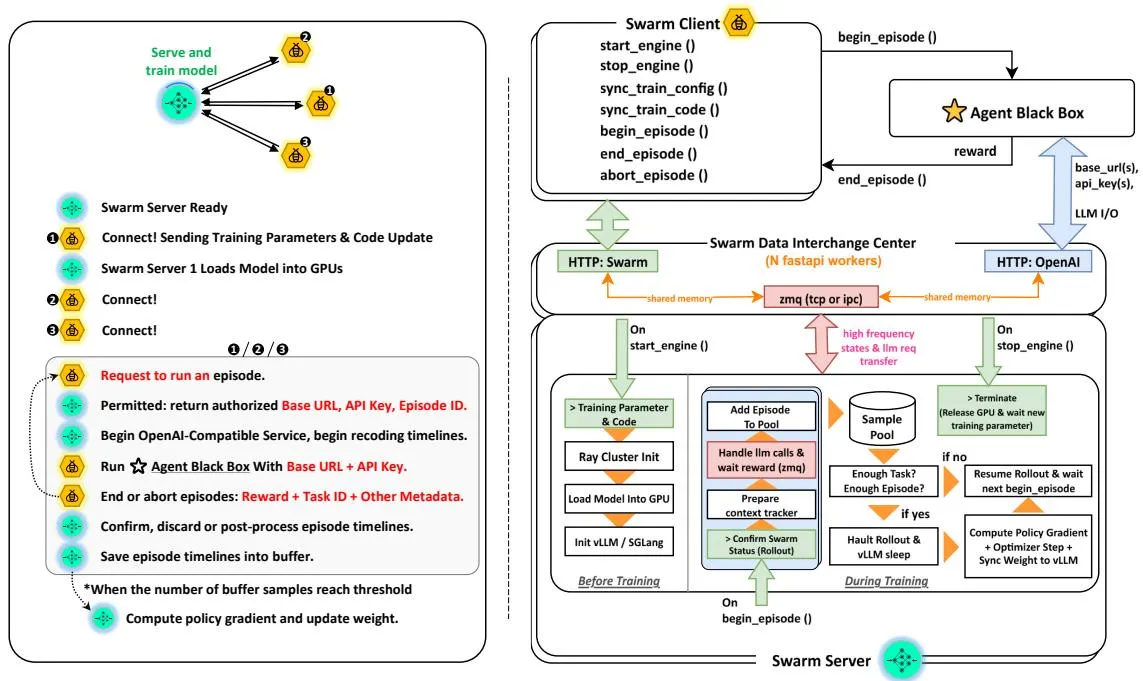
Figure 2: Server 和 client 节点之间的 Swarm RL 范式,展示网络建立、episode 生命周期和异步权重更新触发。
训练流程:
- 设置 Swarm Servers: 服务器携带模型和优化器,注册到 swarm 网络
- 连接 Swarm Clients: 客户端作为 agent runner 和 RL 轨迹生成器
- 收集轨迹: 服务器暴露 OpenAI 兼容推理 API,客户端执行 agent episodes
- 优化模型: 当样本池达到容量时,执行 timeline 合并和策略梯度更新
- 评估: 评估任务可随时在任意节点上调度
Episode 批处理策略
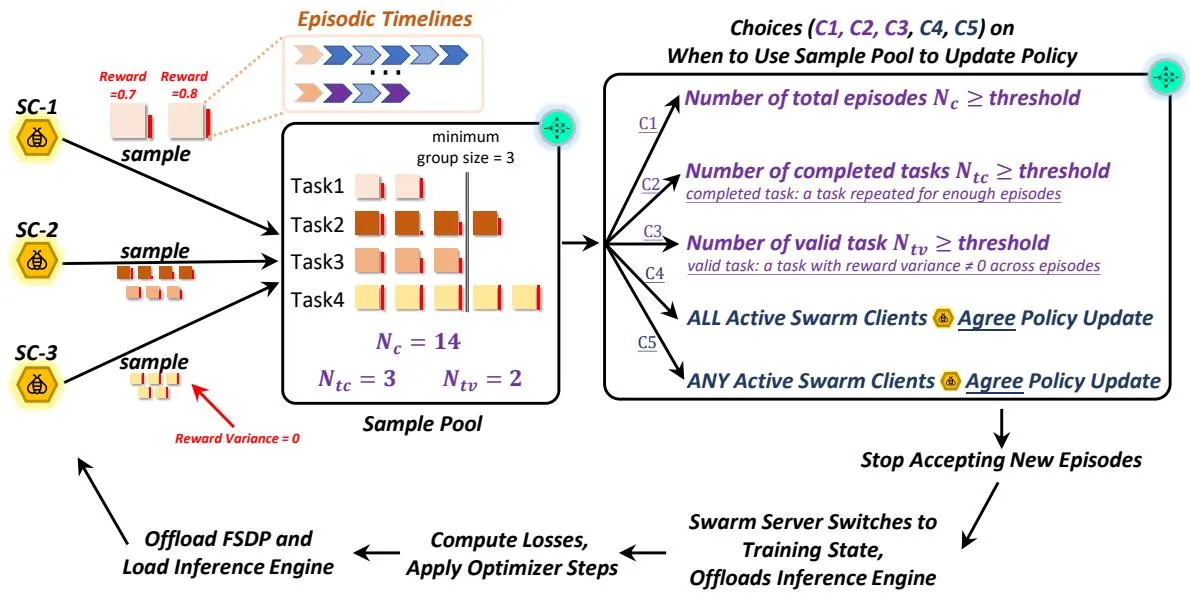
Figure 3: AgentJet 中的 Swarm 协调 RL。Swarm clients 对 OpenAI 兼容推理端点运行 agent episodes;完成的 episodes 在任务组织的样本池中累积。
AgentJet 提供五种收集策略:
| 策略 | 类型 | 触发条件 |
|---|---|---|
| C1 - Episode 计数 | 服务端 | |
| C2 - 任务计数 | 服务端 | |
| C3 - 非虚拟任务计数 | 服务端 | (奖励方差非零) |
| C4 - 所有客户端同意 | 服务端-客户端 | 所有活跃客户端确认 |
| C5 - 任一客户端同意 | 服务端-客户端 | 任一活跃客户端确认 |
其中 为样本池, 为任务标识符, 为完成的 episodes 集合。
上下文跟踪与 Timeline 合并
Context Tracker 公式:
每个被拦截的 LLM 调用产生一个独立的时间线。时间线 是 个消息块的有序数组:
其中:
- : 文本消息
- : token ID 序列
- : 作者标签
- : 每个 token 的 log 概率
- : 损失掩码(仅对 LLM 生成的 token 设为 1)
Timeline 合并算法:
合并以逆序进行: 吸收 ,然后 (如果尚未被吸收)吸收剩余的更早时间线,依此类推。
匹配策略:
- token 级别: 精确 token-id 匹配,适合严格训练/推理一致性
- text 级别(默认): 精确文本匹配,容忍 tokenizer 漂移,产生更激进的合并
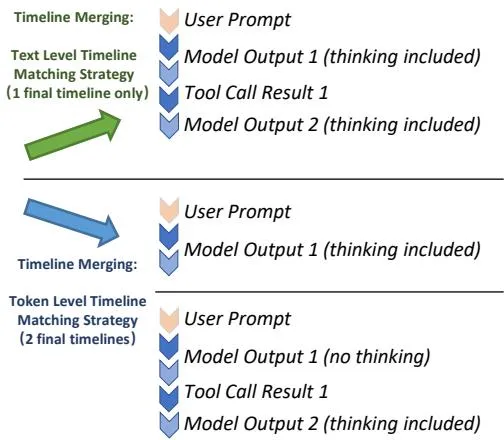
Figure 5: Qwen3 上的 text 级别 vs token 级别 timeline 匹配。早期 assistant 消息的 thinking 块在后续 turn 追加时被剥离,导致两个时间线在文本上一致但在 token id 上分歧。
核心性能
| 指标 | 数值 |
|---|---|
| Timeline 合并加速 | 1.5-10× |
| AppWorld 训练加速 | 6.25×(2160s → 346s/step) |
| Werewolf 训练提升 | 23.0% → 47.2% (7B), 40.9% → 64.7% (14B) |
| Cocktail 训练 | AIME 0.72 vs 0.73(几乎无损) |
| 框架无关性 | 4 种框架最终奖励差异仅 0.025 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Swarm 解耦架构 | 完全解耦训练和推理平面,支持任意设备的 many-to-many 拓扑 | 容错、热插拔调试、多模型训练 |
| 异构多模型 RL | 非共享参数的多智能体训练,每个 agent 独立模型权重 | Werewolf 非共享参数训练 66.5% vs 共享参数 64.7% |
| Timeline 合并 | 消除多轮 rollout 中的冗余上下文 | AppWorld 6.25× 加速,训练质量无损 |
| Cocktail 训练 | 单个模型在异构任务混合上联合优化 | AIME 0.72 vs 0.73,减少 N+1 次训练运行 |
| 框架无关集成 | 通过 OpenAI 兼容端点捕获训练信号 | 4 种框架差异 <0.04 |
| Vibe Training | 自然语言描述生成完整训练代码 | ”Who is the Spy” 全自动生成 |
| A3R 自动研究 | 自主进行多天 RL 实验的分层多智能体系统 | 3 天 19 个 PAI 作业完成最小稳定批量大小研究 |
五、实验结果
5.1 共享参数多智能体训练
Werewolves RPG 实验:
| 实验 | 可训练模型 | 大小 | 静态模型 | 初始 SR | 最终 SR |
|---|---|---|---|---|---|
| Exp 1 | ww | 7B | Qwen3-235B-A22B | 23.0 | 47.2 |
| Exp 2 | ww | 14B | Qwen3-235B-A22B | 40.9 | 64.7 |
| Exp 3 | sr | 14B | Qwen3-235B-A22B | - | 38.5→46.5 |
| Exp 4 | wt | 14B | Qwen3-235B-A22B | - | 38.8 |
| Exp 5 | ht | 14B | Qwen3-235B-A22B | - | 31.9 |
| Exp 6 | sr, wt | 14B | Qwen3-235B-A22B | 22.9 | 35.9 |
| Exp 7 | vl, sr, wt, ht | 14B | Qwen3-235B-A22B | 23.9 | 41.6 |
行为改进:
- 角色扮演一致性:被投票淘汰时,原始模型倾向于暴露身份,微调后 agent 保持伪装
- 社交欺骗策略:发展出误导、理性诉求等多种策略
- 隐式协调:狼人 agent 学习在无显式通信的情况下协调投票
5.2 非共享参数多智能体训练
| 实验 | 可训练模型 | 训练角色 | 静态模型 | 初始 SR | 最终 SR |
|---|---|---|---|---|---|
| Exp 1 | M1(14B-LoRA,4GPU) + M2(14B-LoRA,4GPU) | sr+wt+ht | Qwen3-235B | 22.5 | 30.5 |
| Exp 2 | M1(14B-LoRA,3GPU) + M2(14B-LoRA,3GPU) + M3(14B-LoRA,2GPU) | sr+wt+ht | Qwen3-235B | 22.0 | 34.2 |
| Exp 3 | 同上 | ww | Qwen3-235B(vl,sr,wt,ht) | 40.8 | 66.5 |
| Exp 4 | M1(14B-LoRA,4GPU) + M2(14B-LoRA,4GPU) | vl+sr+wt+ht | Qwen3-235B(ww) | 24.0 | 37.0 |
关键发现:
- 独立参数训练狼人 66.5% vs 共享参数 64.7%,行为多样性带来 1.8% 提升
- 村民阵营中,随机角色分配 (37.0%) 优于固定分配 (30.5%, 34.2%)
5.3 多任务 Cocktail 训练
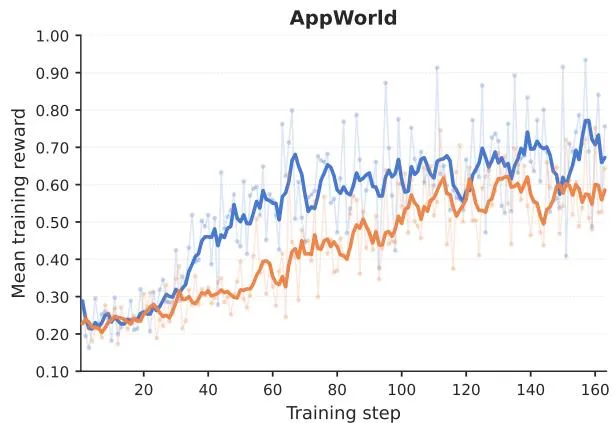
Figure 7: AIME (左) 和 AppWorld (右) 的逐步训练奖励比较。
| 任务 | Cocktail | Separate | 差异 |
|---|---|---|---|
| AIME | 0.72 | 0.73 | -0.01 |
| AppWorld | 0.58 | 0.68 | -0.10 |
分析: AIME 上几乎无损,AppWorld 上存在约 10 奖励点的差距,因为 AppWorld 需要更长的工具使用轨迹。
5.4 Timeline 合并效果
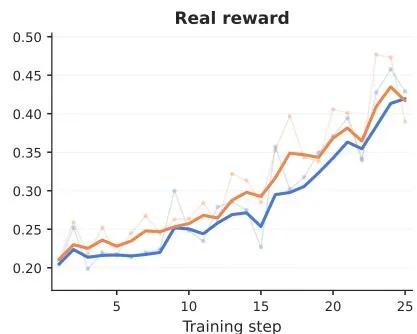
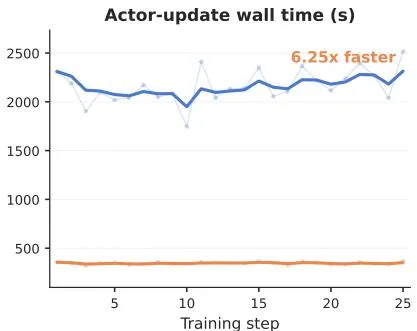
Figure 8: Timeline 合并对多轮 AppWorld swarm RL 任务的影响。
| 指标 | 无合并 | 有合并 | 加速比 |
|---|---|---|---|
| Actor 更新时间 | 2160±171s | 346±13s | 6.25× |
| LLM 调用/步 | 12.6±1.0 | 11.4±0.7 | - |
| 训练奖励 | 相同 | 相同 | - |
5.5 框架无关性
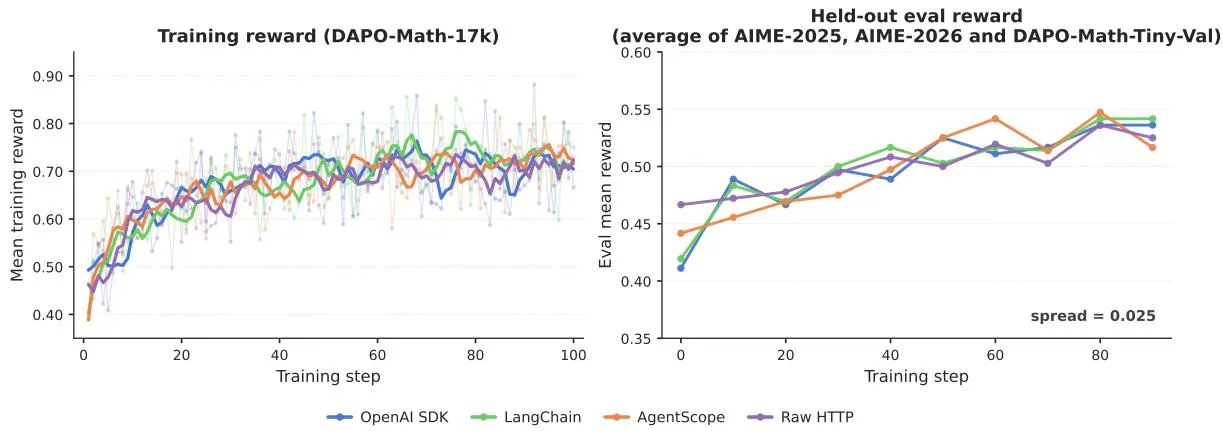
Figure 10: 四种 agent-loop 实现的框架无关训练。
| 框架 | 最终评估奖励 |
|---|---|
| OpenAI SDK | 0.536 |
| LangChain | 0.542 |
| AgentScope | 0.517 |
| Raw HTTP | 0.525 |
四种框架的最终奖励差异仅 0.025,最大交叉差距 <0.04。
5.6 Vibe Training
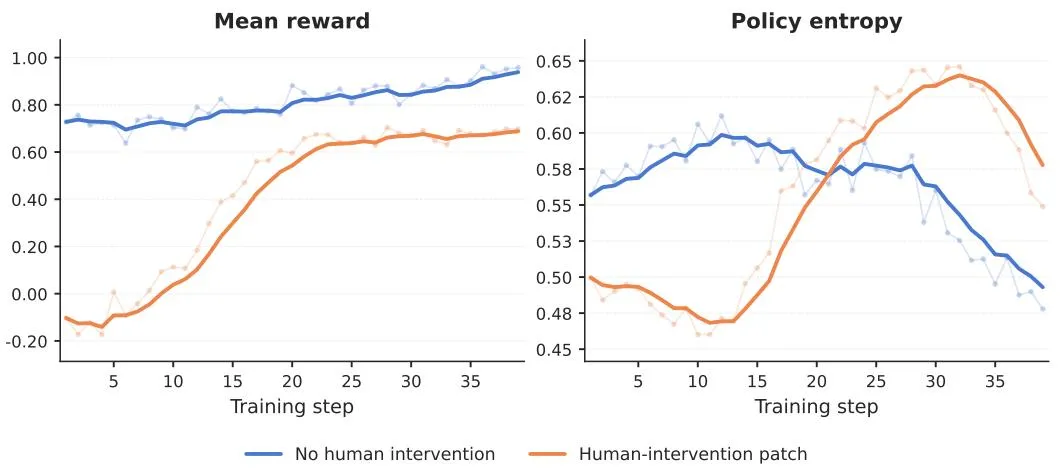
Figure 11: “Who is the Spy” 多智能体游戏的 vibe training 曲线。
- 无干预(红):7B 平民策略从 0.73 提升到 0.96(39 步 GRPO)
- 有奖励修补(蓝):从 -0.10 开始,39 步后恢复到 0,最终约 90 步达到 0.90
5.7 A3R 自动研究
AIME 最小稳定批量大小研究:
| 阶段 | 批量大小 | p@1 | p@2 | 均值奖励 |
|---|---|---|---|---|
| Stage 1 (mr=10000) | 1 | 36.67 | 53.33 | 0.3667 |
| Stage 1 | 2 | 41.67 | 50.00 | 0.4167 |
| Stage 1 | 4 | 45.00 | 60.00 | 0.4500 |
| Stage 1 | 8 | 51.67 | 60.00 | 0.5167 |
| Stage 2 (mr=10000) | 16 | 53.33 | 73.33 | 0.5333 |
| Stage 2 | 32 | 51.67 | 63.33 | 0.4997 |
| Stage 2 | 64 | 50.00 | 60.00 | 0.5000 |
| Stage 3 (mr=12000) | 16 | 60.00 | 73.33 | 0.6000 |
最终推荐:
- 最便宜稳定配置: bs=4, mr=12000
- 最佳配置: bs=16, mr=12000 (pass@1 +8.3, pass@2 +13.3)
六、与现有方法对比
| 方面 | OpenRLHF | veRL | AReaL | Forge | AgentJet |
|---|---|---|---|---|---|
| 架构 | 单体 | 混合控制器 | 异步解耦 | 中间件解耦 | 完全 Swarm 解耦 |
| 多模型训练 | 不支持 | 不支持 | 不支持 | 部分支持 | 完整支持 |
| 容错性 | 弱 | 弱 | 中等 | 中等 | 强 |
| 热插拔调试 | 不支持 | 不支持 | 不支持 | 不支持 | 支持 |
| Timeline 合并 | 无 | 无 | 无 | 无 | 1.5-10× |
| Cocktail 训练 | 不支持 | 不支持 | 不支持 | 不支持 | 支持 |
| 自动化研究 | 无 | 无 | 无 | 无 | A3R |
| 框架无关 | 部分 | 部分 | 部分 | 部分 | 完全 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| OpenRLHF | 通用 RLHF 框架,Ray + vLLM 架构 |
| veRL | 混合单控制器/多控制器编程模型 |
| AReaL | 完全异步训练-推理解耦,3-5× 加速 |
| Forge (MiniMax) | 中间件抽象层,Context Management 作为显式 agent 动作 |
| Agent Lightning | 将 agent 经验转换为 state-action-reward 转换 |
| OpenTinker | RLaaS 架构,Agent Protocol Coordinator |
| OpenClaw-RL | 每次 agent 交互作为实时训练信号 |
| AI Scientist | 端到端自动化研究 |
| A3R | 长周期实验编排,多 GPU 集群并行 |
八、总结
核心贡献
- Swarm 架构: 完全解耦训练和推理平面的客户端-服务器范式
- 异构多模型多智能体 RL: 非共享参数的多智能体训练
- Timeline 合并: 消除冗余上下文,1.5-10× 训练加速
- Cocktail 训练: 单个模型在异构任务混合上联合优化
- Vibe Training: 自然语言到可运行训练管道的自动化
- A3R 自动研究: 自主进行多天 RL 实验的分层多智能体系统
技术影响
- 解耦范式: 将 agent 执行与模型优化完全分离,提供更清洁的接口
- REPL 式训练: 热插拔调试使 agentic RL 具有更交互式的研究体验
- 自动化研究: 长周期实验的自主编排,减少人工干预
- 框架无关性: 通过 OpenAI 兼容端点实现零代码修改的 agent 集成
局限性
- Vibe Training 无内置奖励黑客防护
- Cocktail 训练在工具密集基准(如 AppWorld)上仍落后于专用专家训练
- 自动化研究依赖于编码 agent 的能力
- 当前 server 实现基于 veRL,可能受限于其设计
九、参考资源
- 论文: arXiv:2606.04484
- 代码: GitHub - modelscope/AgentJet
- 主题: cs.AI, cs.LG, cs.MA
- 页数: 约 20 页, 13 图