Mellum2 Technical Report
JetBrains 开源 12B MoE 代码大模型,2.5B 激活参数,128K 上下文,支持代码生成/推理/工具调用
Mellum2 Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Mellum2 Technical Report |
| 作者 | Marko Kojic, Ivan Bondyrev, Aral de Moor, Joseph Shtok, Petr Borovlev, Kseniia Lysaniuk, Madeeswaran Kannan, Ivan Dolgov, Nikita Pavlichenko |
| 机构 | JetBrains Research |
| 论文 | arXiv:2605.31268 |
| 代码 | github.com/JetBrains/mellum2 |
| 发布 | 2026-05-29 |
| 许可 | Apache 2.0 |
| 版本 | v1 (2026-05-29) |
二、核心思想
问题定义
当前开源代码模型面临质量与成本的权衡困境:
- Dense 模型(4-14B):推理成本低,但在复杂编码和推理任务上遇到瓶颈
- 大 MoE 模型:达到前沿质量,但部署成本过高,不适合日常使用
核心需求:寻找一个在知识容量和推理成本之间取得平衡的模型,能够以 2.5B dense 模型的计算成本运行,同时具备 12B 参数的知识容量。
解决方案概述
Mellum 2 是 JetBrains 开源的 12B 参数 MoE 模型,每 token 仅激活 2.5B 参数。作为 Mellum 4B dense 模型的通用继任者,它支持:
- 代码生成与编辑
- 多步推理与调试
- 工具调用与函数调用
- Agent 编码
- 对话式编程辅助
通过系统性消融实验确定最佳架构配置,在单张 H100 上匹配 Qwen2.5-7B 的推理速度,同时在编码、数学、推理等基准测试中具有竞争力。
三、技术架构
整体架构图
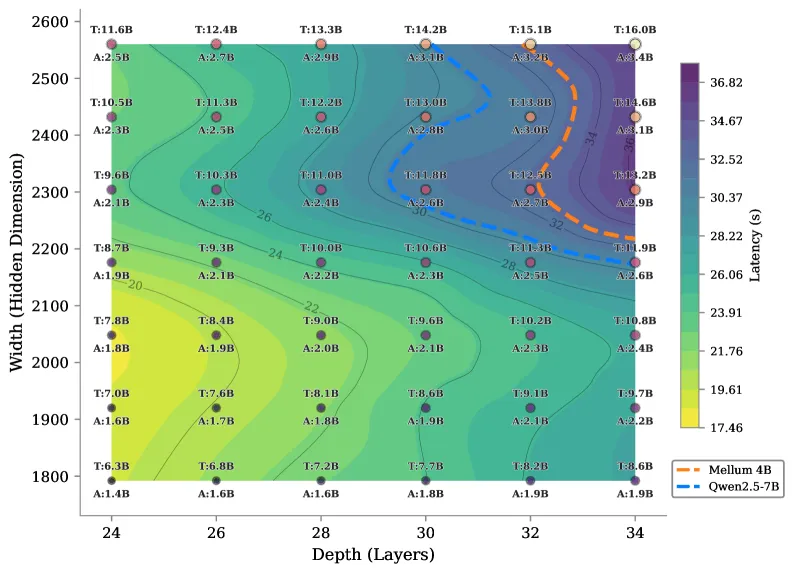
Mellum 2 基于 Qwen3-MoE 配方构建,核心架构参数:
Mellum 2 Architecture
├── Backbone: 28 layers, hidden dim 2304
├── Attention: 32 Q heads, 4 KV heads (GQA)
│   └── Sliding Window: 3:1 pattern (1024 window)
├── MoE: 64 experts, 8 active per token
│   └── Expert MLP size: 896
├── MTP: 1 layer (α=0.1)
├── Vocabulary: 98,304 tokens
└── Context: 8,192 → 131,072 (128K via YaRN)
核心设计决策
| 决策 | 选择 | 原因 |
|---|---|---|
| Dense vs MoE | MoE (64 experts, 8 active) | 在 2.5B 激活参数下匹配 7B dense 性能 |
| GQA 配置 | 4 KV heads | 高并发下吞吐量最优 |
| SWA 模式 | 3:1 (3/4 层使用 1024 窗口) | 延迟最低,质量损失最小 |
| MTP | 单层,α=0.1 | 辅助预训练目标 + 推测解码草稿模型 |
| 优化器 | Muon (Moonlight 配置) | 比 AdamW loss 低 2.5% |
三阶段预训练课程
| 阶段 | Token 数 | 占比 | Web | Code | Math | LR 状态 |
|---|---|---|---|---|---|---|
| 1: Foundation | 6.18T | 58% | 70% | 23% | 6% | Warmup → Hold |
| 2: Quality Uplift | 2.79T | 26.2% | 44% | 42% | 14% | Hold |
| 3: Capability Sharpening | 1.69T | 15.9% | 23% | 59% | 18% | Decay |
| Total | 10.65T | 100% | - | - | - | - |
关键策略:
- “Web early, curated late”:从多样网页数据逐步转向高质量代码和数学
- 数据重复:高质量数据最多重复 4 次,raw code 3 个 epoch
- FIM 目标:除了标准 next-token prediction,还训练 Fill-in-the-Middle
训练超参数
| 参数 | 值 |
|---|---|
| 优化器 | Distributed Muon (Moonlight config) |
| 峰值学习率 | 3×10⁻⁴ |
| LR 调度 | WHD (Warmup-Hold-Decay) |
| Warmup 步数 | 2,000 |
| Decay 步数 | 49,306 |
| 总训练步数 | 323,459 |
| 序列长度 | 8,192 |
| 全局 batch size | 4,096 sequences |
| 精度 | BF16 + FP8 (hybrid) |
长上下文扩展
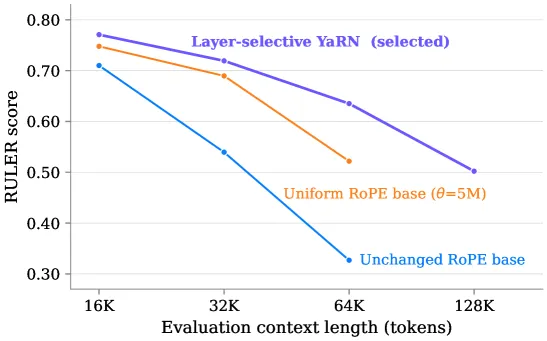
Layer-Selective YaRN:
- 仅对全局(full-attention)层应用 YaRN 频率重映射
- 滑动窗口层保持原始 RoPE 参数
- 64K 评估上下文下 RULER 得分 0.64(vs uniform θ-bump 0.52)
后训练流程
监督微调 (SFT)
训练两个变体:
- Instruct (no-thinking):直接回答,不生成推理链
- Thinking:生成显式推理链后再回答
SFT 数据组成:
- 通用聊天和指令跟随
- 单轮代码生成/编辑/解释
- Agent 编码(长程交互轨迹)
- 工具调用和函数调用
- 推理链数据
- 安全数据
强化学习 (RLVR)
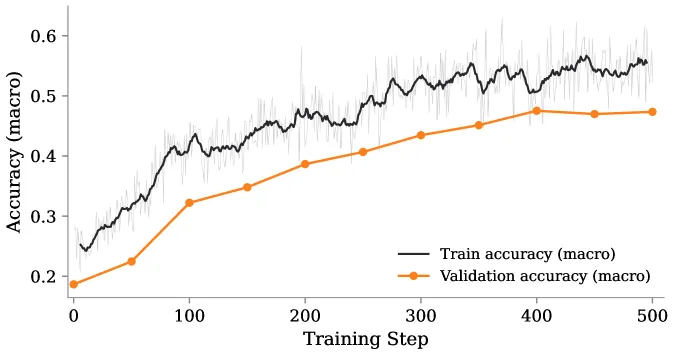
- 使用 GRPO 变体(Group Relative Policy Optimization)
- RLVR 而非 RLHF:所有 prompt 都有程序化验证的奖励
- 两个阶段分别训练 Instruct 和 Thinking 变体
- 验证栈与训练循环解耦,独立微服务架构
推理效率
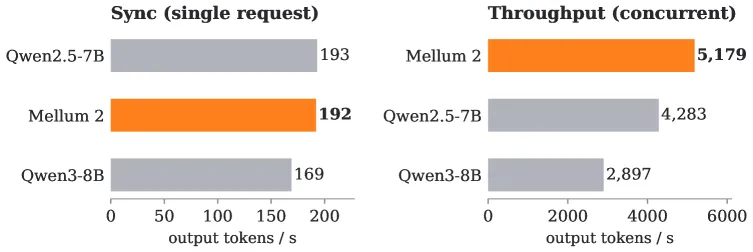
| 模式 | Mellum 2 | Qwen2.5-7B | Qwen3-8B |
|---|---|---|---|
| Sync (tokens/s) | 192 | 193 | 108 |
| Throughput (tokens/s) | 5,179 | 4,280 | 2,893 |
| 请求吞吐 (req/s) | 20.2 | 16.7 | 11.3 |
关键发现:
- Sync 模式匹配 Qwen2.5-7B(192 vs 193 tokens/s)
- Throughput 模式领先 Qwen2.5-7B 21%,领先 Qwen3-8B 79%
- MTP 头作为推测解码草稿模型,无需额外模型
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 系统性架构消融 | 在固定推理预算下消融 Dense/MoE、GQA、SWA、MTP 等配置 | 图 1-3 消融实验 |
| 推理感知架构选择 | 所有架构决策以单 H100 匹配 Qwen2.5-7B 速度为目标 | 图 13 吞吐量对比 |
| Layer-Selective YaRN | 仅对全局层应用位置编码扩展,滑动窗口层保持不变 | 图 7 RULER 评分 |
| MTP 双用途 | 单层 MTP 既是预训练辅助目标,又是推测解码草稿模型 | 无需额外模型开销 |
| Muon 优化器 | 采用 Moonlight 配置的 Muon,比 AdamW loss 低 2.5% | 图 4 消融实验 |
五、实验结果
预训练评估
| 基准测试 | Mellum 2 (2.5B/12B) | OLMo-3-7B | Qwen2.5-7B | Qwen3-4B | Qwen3.5-4B |
|---|---|---|---|---|---|
| HumanEval | 41.5 | 45.1 | 55.5 | 57.3 | 50.0 |
| MBPP | 62.4 | 50.6 | 63.6 | 67.0 | 52.2 |
| MMLU | 70.9 | 62.1 | 71.8 | 71.1 | 74.2 |
| MMLU-Pro | 59.3 | 34.5 | 48.6 | 51.5 | 52.4 |
| BBH | 74.9 | 63.6 | 69.0 | 71.3 | 80.2 |
| GSM8K | 81.7 | 73.5 | 81.9 | 82.0 | 80.1 |
| GPQA Diamond | 31.3 | 28.8 | 32.8 | 36.9 | 41.4 |
关键发现:
- MMLU-Pro: 59.3%,超越所有对比模型(包括 Qwen3.5-4B 的 52.4%)
- BBH: 74.9%,超越 Qwen2.5-7B (69.0%) 和 Qwen3-4B (71.3%)
- GSM8K: 81.7%,与 Qwen2.5-7B (81.9%) 持平,尽管激活参数更少
后训练评估 (Instruct)
| 基准测试 | Mellum 2 SFT | Mellum 2 RL | Qwen3.5-4B | Qwen3.5-9B | OLMo-3-7B | Ministral-3-14B |
|---|---|---|---|---|---|---|
| EvalPlus | 76.2 | 78.4 | 69.4 | 71.8 | 67.3 | 74.1 |
| MultiPL-E | 64.6 | 67.1 | 51.0 | 67.1 | 36.1 | 71.5 |
| BFCL v4 | 31.8 | 44.2 | 52.0 | 60.6 | 19.8 | 38.8 |
| AIME | 29.9 | 41.7 | 38.3 | 58.3 | 40.0 | 33.3 |
| GSM-Plus | 73.0 | 80.5 | 85.2 | 87.9 | 85.8 | 86.6 |
| MMLU-Redux | 77.4 | 78.1 | 87.5 | 91.1 | 71.8 | 85.9 |
| GPQA Diamond | 38.9 | 40.9 | 76.8 | 79.8 | 40.9 | 58.6 |
| IFEval | 69.3 | 75.8 | 82.1 | 83.9 | 83.2 | 67.3 |
| JetBrains pairwise | 66.7 | 68.1 | 60.6 | 77.8 | 44.4 | 72.4 |
关键发现:
- RL 阶段显著提升编码能力(EvalPlus: 76.2→78.4, MultiPL-E: 64.6→67.1)
- 工具调用能力大幅提升(BFCL v4: 31.8→44.2, BFCL v3: 43.1→66.3)
- JetBrains 内部 pairwise 测试:RL 后超越 Qwen2.5-7B-Instruct (68.1% win rate)
推理效率对比
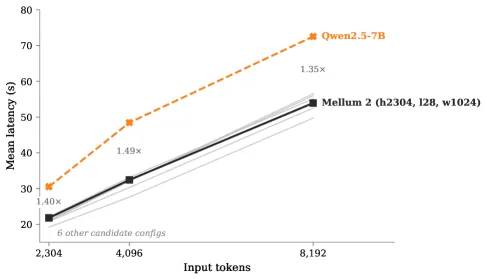
- 3:1 SWA 模式在不同输入长度下均表现最佳
- 仅在 3/4 层使用滑动窗口,保持全局注意力层的位置编码能力
- 相比 Qwen2.5-7B,长输入下延迟显著降低
六、消融实验
优化器消融
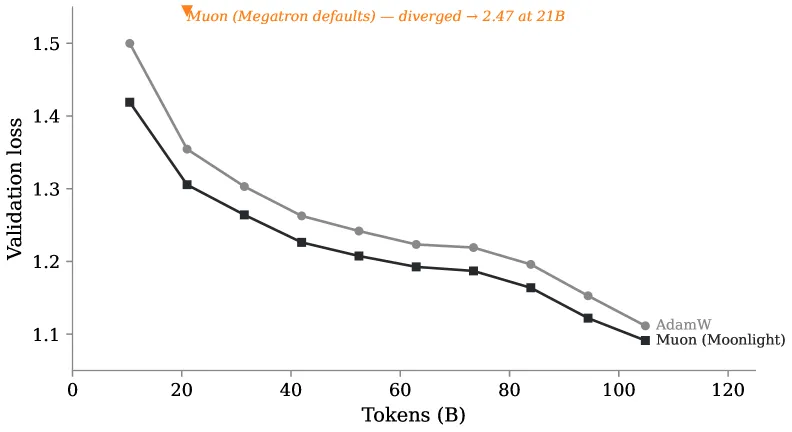
| 优化器 | Dense 7B loss | MoE-14B loss |
|---|---|---|
| AdamW | 基线 | 基线 |
| Muon (Megatron) | 发散 | -0.026 |
| Muon (Moonlight) | -0.028 | -0.023 |
关键发现:
- Moonlight 配置在 Dense 和 MoE 架构上都稳定
- Megatron 默认配置在 Dense 上发散
- Muon 比 AdamW loss 降低约 2.5%
长上下文扩展消融
| 方法 | RULER (64K) | RULER (128K) |
|---|---|---|
| Layer-Selective YaRN | 0.64 | 0.65 |
| Uniform θ-bump | 0.52 | N/A (64K cap) |
| Unchanged θ | 0.33 | N/A (32K collapse) |
关键发现:
- 仅对全局层应用 YaRN 效果最佳
- 滑动窗口层不需要位置编码扩展
- 未修改的 θ 在 32K 后崩溃
七、相关工作
| 工作 | 关系 | 差异 |
|---|---|---|
| Qwen3-MoE | 基础架构 | Mellum 2 针对 IDE 部署优化,减少 KV heads 和 SWA |
| Qwen3-Coder-30B-A3B | 同类 MoE 代码模型 | Mellum 2 更小(12B vs 30B),更适合单 GPU 部署 |
| Ling-Coder-Lite | 同类小型 MoE | Mellum 2 专注于 IDE 集成场景 |
| OLMo-3-7B | 开源 Dense 模型 | Mellum 2 在多个基准上超越,且推理成本更低 |
| DeepSeek-V3 | 大规模 MoE | Mellum 2 是其轻量化部署版本 |
八、总结
核心贡献
- 系统性架构消融:在固定推理预算下消融 Dense/MoE、GQA、SWA、MTP 等配置,确定最佳架构
- 高效 MoE 架构:12B 总参数 / 2.5B 激活参数,匹配 7B dense 性能
- 三阶段预训练课程:10.65T token,从网页数据逐步转向高质量代码
- Layer-Selective YaRN:创新的长上下文扩展方法,64K→128K
- MTP 双用途设计:既是预训练辅助目标,又是推测解码草稿模型
- 完整开源:Base、Instruct、Thinking 三个 checkpoint,Apache 2.0 许可
技术影响
- IDE 集成:为 JetBrains IDE 提供高效代码助手
- 部署友好:单 H100 即可部署,匹配 7B dense 速度
- 开源生态:Apache 2.0 许可,促进社区发展
- 方法论:推理感知的架构选择方法可推广到其他部署场景
局限性
- HumanEval 相对较弱:41.5% vs Qwen2.5-7B 的 55.5%
- GPQA Diamond 较低:31.3% vs Qwen3.5-4B 的 41.4%
- MMLU 较低:70.9% vs Qwen3.5-4B 的 74.2%
- 长上下文评估保守:RULER 评分受 prompt 格式问题影响
- 未测试极长代码:128K 上下文的实际编码能力有待验证
九、参考资源
- 论文: arXiv:2605.31268
- 代码: github.com/JetBrains/mellum2
- 相关模型:
- Qwen3-MoE - 基础架构
- Qwen3-Coder - 同类代码模型
- OLMo-3 - 开源 Dense 模型
- DeepSeek-V3 - 大规模 MoE
- 关键技术:
- Muon Optimizer - 优化器
- YaRN - 长上下文扩展
- GRPO - 强化学习
- 部署环境: