PEEK: Picking Essential frames via Efficient Knowledge distillation
通过知识蒸馏实现高效视频帧选择的查询无关方法,在低帧预算下显著优于现有方法
PEEK: Picking Essential frames via Efficient Knowledge distillation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PEEK: Picking Essential frames via Efficient Knowledge distillation |
| 作者 | Killian Steunou, Anas Filali Razzouki, Khalil Guetari, Mounîm A. El-Yacoubi, Yannis Tevissen |
| 机构 | 未明确标注(IDRIS HPC资源支持) |
| 论文 | arXiv:2605.31029 |
| 代码 | GitHub(论文提及) |
| 发布 | 2026年5月29日 |
| 许可 | 未明确 |
二、核心思想
PEEK是一种高效的动态视频帧选择方法,通过知识蒸馏将文本条件化的帧相关性排名从强大的教师模型蒸馏到轻量级的时间模型。核心创新在于:
- Oracle教师评分:使用SigLIP 2对候选帧与ground-truth字幕进行相关性评分,生成密集的字幕条件化相关性排名
- 查询无关蒸馏:训练轻量级时间Transformer仅从视觉内容预测这些排名,推理时无需字幕或文本编码器
- 分层argmax选择:将视频分段,在每个子段内选择最高分帧,平衡相关性和时间覆盖
问题定义
视频语言模型只能处理有限数量的帧,帧选择成为高效视频字幕的关键瓶颈。现有方法:
- 均匀采样:计算便宜但对视觉内容无关
- 自适应采样:计算昂贵(CSTA增加65.4%时间,MaxInfo增加211.9%时间)
解决方案概述
PEEK通过两阶段蒸馏框架解决这一问题:
- Stage 1:冻结的SigLIP 2教师模型对每个候选帧与ground-truth字幕进行评分
- Stage 2:轻量级时间Transformer(1.7M参数)学习从MobileCLIP2视觉嵌入预测这些分数
- 推理:仅需0.36秒/段,增加5.2%总时间,无需字幕或文本编码器
三、技术架构
整体框架图
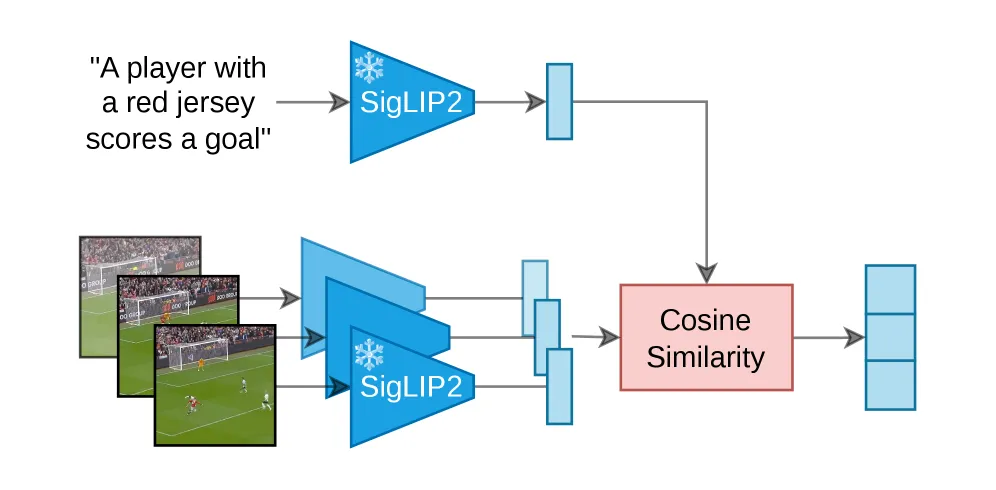
PEEK包含三个核心组件:
- Oracle教师:SigLIP 2 (so400m-patch14-384),计算帧-字幕余弦相似度
- 学生模型:2层时间Transformer,1.7M参数,隐藏维度256
- 选择策略:分层argmax,平衡相关性和时间覆盖
核心公式
教师评分(Stage 1): 给定标注的时间段 ,其中 是源视频, 是时间窗口, 是关联字幕。
教师帧嵌入 ,字幕嵌入 ,原始教师分数为余弦相似度:
归一化到 :
学生模型(Stage 2): 输入:冻结的MobileCLIP2视觉嵌入
投影层:
其中 是固定正弦位置编码,。
经过 层Transformer编码器(多头自注意力 + ReLU FFN + Dropout)后:
ListMLE损失: 设 是按教师目标降序排列的帧索引排列,负对数似然为:
分层argmax选择: 将视频分为 个非重叠时间子段,在每个子段内选择最高分帧:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 教师模型 | SigLIP 2 (so400m-patch14-384) | 冻结,生成监督信号 |
| 学生视觉编码器 | MobileCLIP2-S0 | 冻结,512维嵌入 |
| 时间Transformer | 2层,4头注意力 | 1.7M参数,h=256,FFN=1024 |
| 损失函数 | ListMLE | 列表式排名优化 |
训练流程
Stage 1(Oracle评分):
- 使用SigLIP 2计算每个候选帧与ground-truth字幕的余弦相似度
- Min-max归一化到 作为训练目标
- 仅保留标量分数,不使用教师嵌入
Stage 2(学生训练):
- 输入:冻结的MobileCLIP2视觉嵌入
- 目标:预测教师的帧相关性排名
- 优化:AdamW,学习率 ,余弦退火,权重衰减0.03
- 训练:25个epoch,2个warmup epoch,batch size 1024
推理:
- 分层argmax选择 个帧
- 选定帧按时间顺序排列后送入下游VLM
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 字幕条件化Oracle评分 | 量化语义帧相关性对视频字幕的价值 | Oracle在k=1时显著优于所有查询无关方法 |
| 查询无关蒸馏 | 将文本条件化排名蒸馏到仅视觉模型 | PEEK在k=1时CIDEr提升1.74-3.00点 |
| 分层argmax | 平衡相关性和时间覆盖 | 比原始top-k在所有指标上一致提升 |
| ListMLE损失 | 列表式排名优化优于点对点损失 | 在k=1时CIDEr提升最大 |
Oracle评分诊断价值
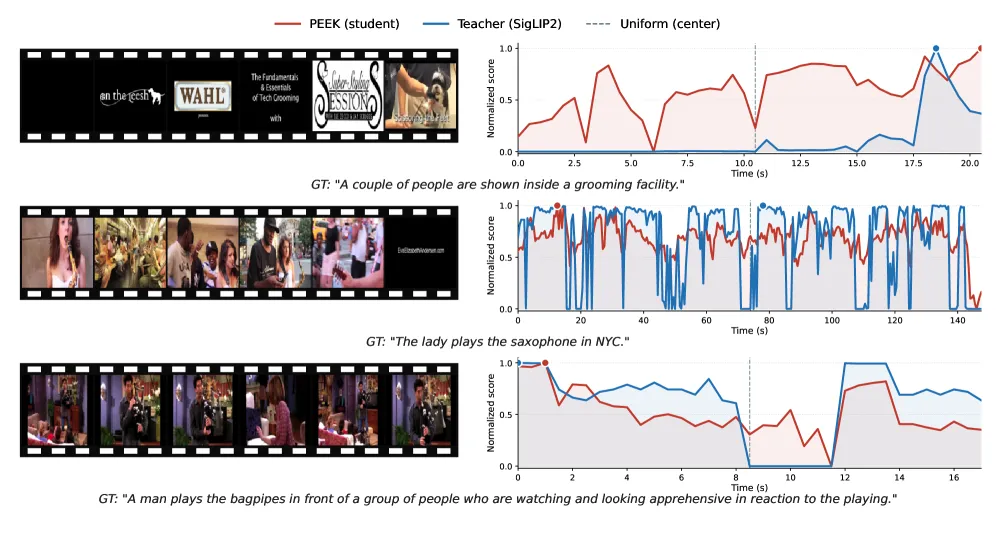
Oracle评分提供了字幕感知选择能恢复什么的诊断估计。PEEK与Oracle在全局显著区域一致,但局部更平滑。
五、实验结果
基准测试
Table 1: 数据集统计
| 数据集 | 分割 | 视频数 | 段数 | 平均段时长 | 平均视频时长 | 平均字数 |
|---|---|---|---|---|---|---|
| ANC | train | 10,009 | 37,421 | 35.5s | 117.3s | 13.5 |
| ANC | val | 4,917 | 17,031 | 37.7s | 118.2s | 13.6 |
| ANC | test | 4,869 | 17,505 | 36.3s | 117.4s | 13.4 |
| MSR-VTT | test | 2,990 | 2,990† | 20.0s | 20.0s | 13.0 |
Table 2: ActivityNet Captions测试结果
| VLM | 选择器 | CIDEr k=1 | CIDEr k=2 | CIDEr k=4 | CIDEr k=8 |
|---|---|---|---|---|---|
| SmolVLM2-2.2B | Uniform | 27.94 | 32.12 | 37.44 | 37.03 |
| PEEK | 29.68 | 33.24 | 38.44 | 38.05 | |
| Qwen2.5-VL-3B | Uniform | 30.89 | 36.18 | 41.66 | 42.21 |
| PEEK | 33.23 | 37.41 | 42.56 | 42.12 | |
| Qwen3.5-4B | Uniform | 31.46 | 36.48 | 41.58 | 42.69 |
| PEEK | 33.64 | 38.23 | 42.83 | 42.58 | |
| Qwen2.5-VL-7B | Uniform | 31.05 | 37.15 | 43.76 | 43.58 |
| PEEK | 34.05 | 38.30 | 43.48 | 44.10 |
关键发现:
- PEEK在14/16个配置中获得最佳CIDEr
- 在k=1时,PEEK比最强查询无关基线提升+1.74到+3.00 CIDEr点
- 在k=2时,PEEK对所有4个VLM都是最佳
Table 3: MSR-VTT零样本测试结果
| VLM | 选择器 | CIDEr k=1 | CIDEr k=2 | CIDEr k=4 | CIDEr k=8 |
|---|---|---|---|---|---|
| SmolVLM2-2.2B | PEEK | 38.55 | 41.14 | 41.82 | 28.56 |
| Qwen2.5-VL-3B | PEEK | 35.80 | 36.24 | 38.57 | 39.48 |
| Qwen3.5-4B | PEEK | 34.18 | 35.96 | 35.99 | 38.79 |
| Qwen2.5-VL-7B | PEEK | 30.29 | 33.29 | 34.33 | 36.93 |
零样本迁移:
- 在k=1时,PEEK对所有4个VLM和所有指标都是最佳
- CIDEr提升:+2.68(SmolVLM2),+1.46(Qwen2.5-VL-3B),+2.26(Qwen3.5-4B),+1.25(Qwen2.5-VL-7B)
- 在k=4和k=8时,结果更混合,时间覆盖和视觉多样性变得更有竞争力
效率分析
Table 4: 选择和端到端字幕时间
| 选择器 | 推理时需要文本 | 选择器时间 | 每段时间 | 完整管线 |
|---|---|---|---|---|
| Uniform/Random | 否 | 可忽略 | – | 33h35m |
| PEEK(ours) | 否 | 1h44m (26m) | 0.36s | 35h20m (+5.2%) |
| CSTA | 否 | 21h58m | 4.52s | 55h33m (+65.4%) |
| MaxInfo | 否 | 71h04m | 14.62s | 104h39m (+211.9%) |
| Oracle | 是 | 9h52m | 2.03s | 43h27m (+29.4%) |
效率优势:
- PEEK仅增加5.2%总时间(vs CSTA 65.4%,MaxInfo 211.9%)
- 每段选择仅需0.36秒
- 17,505段总计1小时44分钟GPU时间
消融实验
Table 5: 帧选择策略对比
| 选择策略 | CIDEr k=2 | CIDEr k=4 | CIDEr k=8 |
|---|---|---|---|
| 原始top-k | 32.79 | 36.52 | 39.47 |
| 分层argmax | 33.92 | 37.36 | 39.97 |
分层argmax在所有指标和预算上一致优于原始top-k,确认时间覆盖对避免选择近重复帧很重要。
Table 6: 损失函数对比
| 损失 | CIDEr k=1 | CIDEr k=2 |
|---|---|---|
| MSE + pairwise | 29.46 | 34.49 |
| ListMLE | 30.29 | 33.29 |
ListMLE在k=1和k=2时提升所有指标,在k=1时CIDEr增益最大。
六、相关工作
| 方向 | 代表工作 | PEEK优势 |
|---|---|---|
| 均匀采样 | Uniform | 语义感知选择,低帧预算显著提升 |
| 信息多样性 | MaxInfo | 更高效(5.2% vs 211.9%时间增加) |
| 视频摘要 | CSTA | 字幕导向相关性 vs 通用重要性 |
| 学习选择器 | PickNet, LFS | 查询无关,无需推理时文本 |
| 文本条件化 | KeyVideoLLM | 推理时无需字幕 |
七、总结
核心贡献
- 提出字幕条件化帧评分作为Oracle诊断,量化语义帧相关性对视频字幕的价值
- 将SigLIP 2字幕条件化排名蒸馏到轻量级时间评分器(1.7M参数)
- 在ActivityNet Captions和MSR-VTT上,PEEK是所有评估中最强的查询无关选择器
- 仅增加5.2%字幕时间,远低于CSTA(65.4%)和MaxInfo(211.9%)
技术影响
- 证明字幕相关性信号可以从视觉证据中恢复
- 为低帧预算视频字幕提供实用解决方案
- 轻量级模型(1.7M参数)可作为实际预处理阶段
局限性
- 评估仅限于短字幕生成,长视频字幕可能需要保留多个事件
- 教师信号来自ground-truth字幕,可能偏向参考字幕对齐而非所有视觉有意义事件
- 在较大帧预算(k=4, k=8)时,优势减小,均匀采样变得有竞争力
- 非单调行为:某些VLM在更多帧时CIDEr下降(如Qwen2.5-VL-7B从k=4到k=8)