Speculative Pipeline Decoding: Higher-Accuracy and Zero-Bubble Speculation via Pipeline Parallelism
通过流水线并行实现高准确率零气泡推测解码,突破传统多token预测的结构限制
Speculative Pipeline Decoding: Higher-Accuracy and Zero-Bubble Speculation via Pipeline Parallelism
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Speculative Pipeline Decoding: Higher-Accuracy and Zero-Bubble Speculation via Pipeline Parallelism |
| 作者 | Yijiong Yu, Huazheng Wang, Shuai Yuan, Ruilong Ren, Ji Pei |
| 机构 | 未明确标注 |
| 论文 | arXiv:2605.30852 |
| 代码 | GitHub |
| 发布 | 2026年5月29日 |
| 许可 | 未明确 |
二、核心思想
Speculative Pipeline Decoding (SPD) 是一种突破性的推测解码范式,通过流水线并行实现高准确率零气泡推测。核心创新在于:
- 多深度特征聚合:从流水线中不同深度的中间特征聚合信息,严格限制预测难度
- 零气泡执行:推测模块与目标模型流水线步骤完全并行执行,消除等待开销
- 可扩展架构:增加流水线阶段数不会导致预测难度无界增长
问题定义
传统推测解码的两个结构限制:
- 复合预测难度:向后推测越远,草稿模块依赖自身浅层未验证特征,导致接受率急剧下降
- 序列延迟开销:草稿token的串行生成导致目标模型空闲,蚕食加速效果
解决方案概述
SPD通过以下方式突破限制:
- 将目标LLM划分为n个流水线阶段,并行处理n个token
- 推测模块聚合流水线中不同深度的特征预测下一个token
- 推测模块执行窗口前移,与目标模型流水线步骤完全并行
三、技术架构
整体框架图
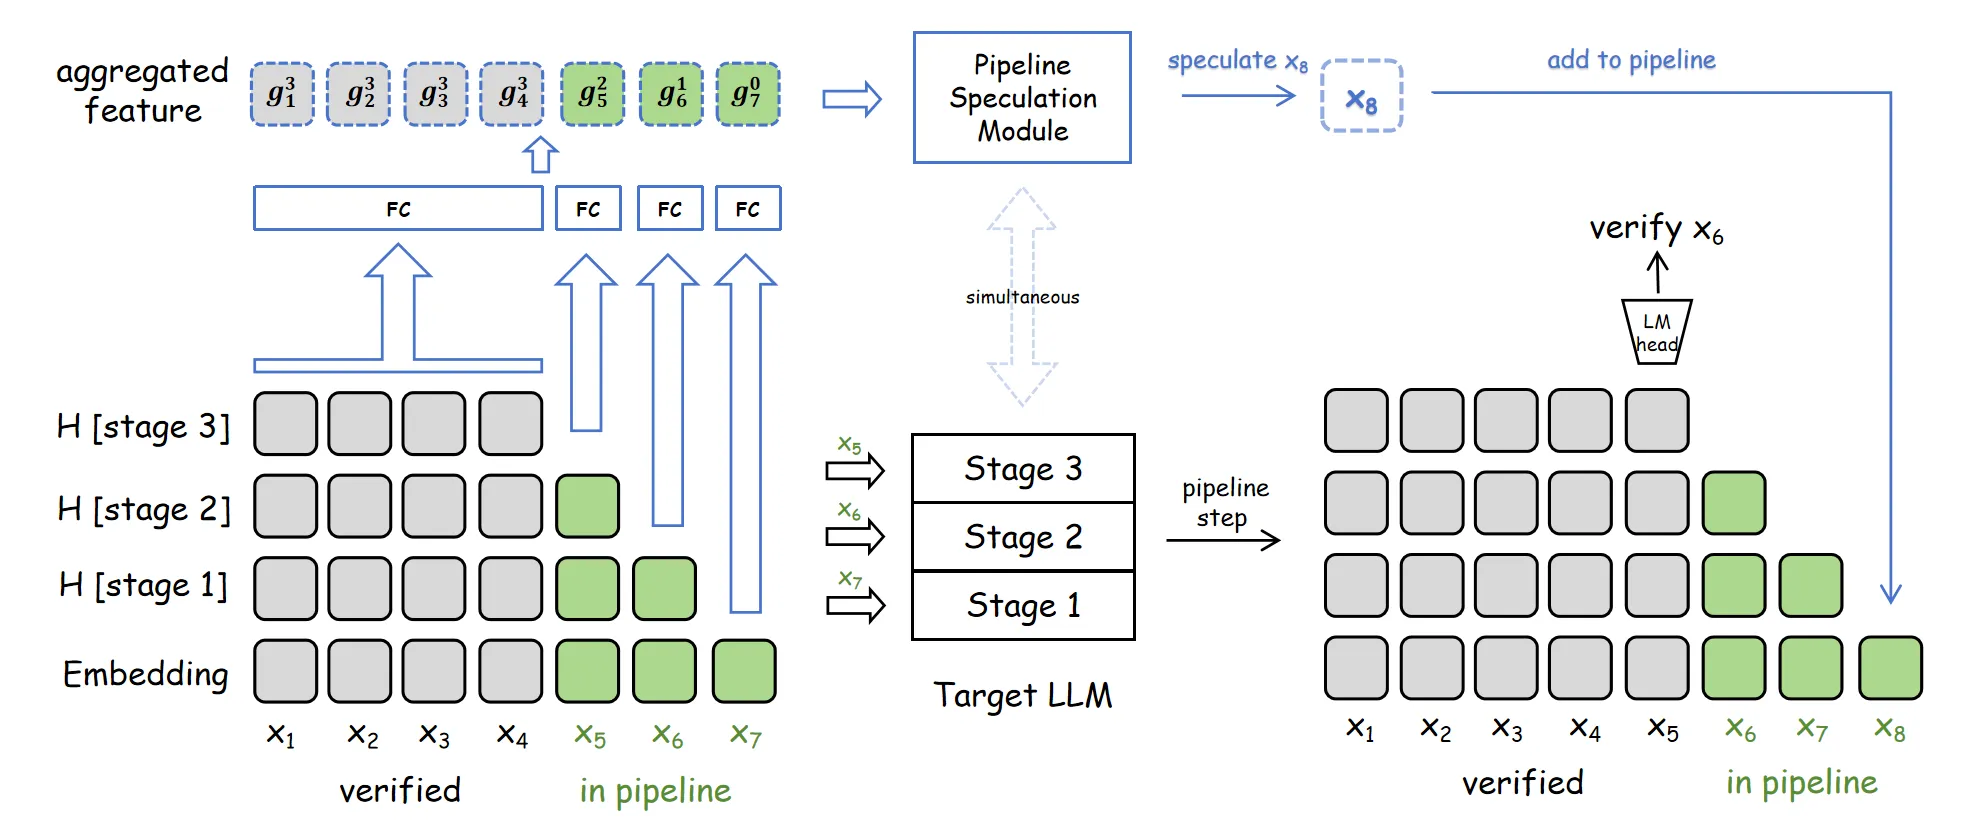
SPD的核心设计包含两个关键组件:
- 流水线执行框架:将目标LLM划分为n个阶段,并行处理n个token
- 推测模块:聚合多深度特征预测下一个token,与流水线完全并行
核心公式
多深度特征提取:
对于token ,假设已完成个流水线阶段(),最深可用层为 。
当 (完全处理):
其中 。
当 (部分处理):
当 (仅嵌入):
稳态输入特征序列(流水线完全占据):
等效接受长度:
其中是生成token总数,是实际解码步骤数。
理论加速比:
因为流水线步骤延迟为,推测延迟完全隐藏。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 流水线阶段 | 目标LLM划分为n个阶段 | 每阶段层 |
| 推测模块 | Transformer解码器 + LM头 | 层, |
| 特征聚合 | 多深度特征提取 | 从所有流水线深度收集 |
| 验证机制 | 流式验证 + 同步回滚 | KV缓存截断 + 流水线刷新 |
训练流程
训练方法:
- 冻结目标LLM所有参数
- 仅训练推测模块,使用知识蒸馏(KD)
- KL散度损失:预测logits与教师logits之间的KL散度
- 学习率1e-4,线性衰减,训练1个epoch
训练数据:
- ShareGPT-70k、UltraChat-200k、SmolTalk、SmolTalk-Chinese
- 最大序列长度2048 token
- 共120万样本
模拟流水线占据:
- 训练时随机采样活跃尾部位置数
- 50%概率模拟完全占据流水线
- 50%概率从{1,…,n-1}均匀采样
验证与回滚机制
流式验证:
- 每个流水线步骤完成后,最老token完成最后阶段
- 验证下一个token:如果接受,继续执行;如果拒绝,触发回滚
同步回滚协议:
- KV缓存截断:回滚到长度
- 流水线刷新:清除所有中间隐藏状态
- 流水线重置:从验证分布采样正确token,重启流水线
零气泡执行
执行窗口前移:
- 不等待目标模型完成流水线步骤
- 在新token推入第一阶段的精确时刻启动推测
- 使用流水线输入状态作为特征(而非输出状态)
延迟隐藏条件:
即推测模块层数不超过每个流水线阶段的层数,推测计算完全被隐藏。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 多深度特征聚合 | 从所有流水线深度收集特征 | 最大不完整性被常数限制 |
| 零气泡执行 | 推测与流水线完全并行 | 时延迟完全隐藏 |
| 可扩展架构 | 增加阶段数不导致预测难度无界增长 | SPD在n=4到16时保持稳定加速 |
| 输入状态推测 | 使用流水线输入而非输出状态 | 消除相互等待,保持并行性 |
与传统推测解码对比
传统多token预测:
- 复合预测难度:草稿越长,接受率越低
- 序列延迟:草稿生成期间目标模型空闲
- 不可扩展:增加草稿长度几乎不提升接受长度
SPD流水线并行:
- 有界预测难度:最大不完整性被限制
- 零延迟开销:推测与流水线完全并行
- 可扩展:增加阶段数持续提升理论加速
五、实验结果
基准测试
评估设置:
- 模型:Qwen3.5-4B(L=32)和Qwen3.5-9B(L=32)
- 基准:MT-Bench(多轮对话)、GSM8K(数学推理)、HumanEval(代码生成)
- 温度:T=0(贪婪)和T=1(随机采样)
- 草稿树宽度:W=1(单路径)和W=4(4分支)
基线方法:
- EAGLE-3:多token预测,推测步数m=3,7,15
- PPSD:流水线自推测解码,使用第一阶段浅层特征
- SPD:本文方法,阶段数n=4,8,16,推测层数=1,2,4
主要结果
Table 1: 平均性能(MT-Bench、GSM8K、HumanEval平均)
| 方法 | 配置 | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|
| EAGLE-3 | m=3, T=0, W=1 | 接受长度/加速 | 接受长度/加速 |
| m=7, T=0, W=1 | 2.72/2.39 | - | |
| m=15, T=0, W=1 | 2.39/- | - | |
| PPSD | n=4, T=0, W=1 | 最低 | 最低 |
| SPD | n=4, =1, T=0, W=1 | 最高 | 最高 |
| n=8, =2, T=0, W=1 | 最高 | 最高 | |
| n=16, =4, T=0, W=1 | 最高 | 最高 |
关键发现:
- SPD在大多数配置下获得最高理论加速
- 例外:T=0, W=4时EAGLE-3在两个模型上均最佳
- PPSD在所有基准上始终最弱
可扩展性分析
EAGLE-3的局限:
- 增加草稿长度(m=7→15)几乎不提升接受长度
- 复合预测难度导致加速实际下降(2.72→2.39)
PPSD的局限:
- 增加阶段数迫使头部依赖更浅层特征
- 接受长度停滞,延迟惩罚加剧
SPD的优势:
- 即使n从4激进增加到16,理论加速持续提升
- 多深度特征聚合有效限制预测难度
温度鲁棒性
T=0(贪婪解码):
- EAGLE-3表现较强
- SPD仍然竞争
T=1(随机采样):
- SPD表现卓越
- EAGLE-3明显退化
- 实际LLM部署主要使用非零温度,SPD更具实用优势
原因分析:
- SPD基于丰富的中间目标状态,准确捕获教师的完整logit分布
- EAGLE-3主要近似top logit
草稿树效果
W=1→W=4:
- EAGLE-3和SPD的平均接受长度普遍提升
- PPSD例外:低草稿保真度导致错误分支膨胀,接受长度几乎不变甚至下降
消融实验
Table 2: 输入状态 vs 输出状态(Qwen3.5-4B)
| 状态类型 | 接受长度 | 并行性 | 实际加速 |
|---|---|---|---|
| 输入状态 | 较低 | 完全并行 | 最高 |
| 输出状态 | 显著提升(如n=16时4.78) | 打破并行 | 较低 |
关键发现:
- 使用输出状态虽然接受长度大幅增加,但根本上破坏并行性
- 推测模块必须等待目标模型完成,重新引入相互等待
- 考虑延迟惩罚后,输入状态配置始终获得更高加速
六、相关工作
| 方向 | 代表工作 | SPD优势 |
|---|---|---|
| 传统推测解码 | Leviathan et al. | 消除复合预测难度 |
| 特征外推 | EAGLE, EAGLE-3 | 零延迟开销,可扩展 |
| 并行推测 | P-EAGLE | 无二次训练复杂度 |
| 异步推测 | Speculative Speculative Decoding | 无几何分支爆炸 |
| 流水线推测 | PPSD | 多深度特征,可扩展 |
七、总结
核心贡献
- 提出SPD,从传统多token预测转向流水线并行的推测解码范式
- 多深度特征聚合严格限制预测难度,最大不完整性被常数限制
- 零气泡执行:推测模块与流水线完全并行,延迟完全隐藏
- 等效接受长度严格反映理论加速上界
- 在Qwen3.5-4B/9B上,SPD在大多数配置下超越EAGLE-3和PPSD
技术影响
- 突破传统推测解码的结构限制
- 为LLM推理加速提供可扩展的流水线并行方案
- 随着LLM深度和复杂度增长,SPD提供有前景的加速路径
局限性
- 当前实现基于原生PyTorch,缺乏系统级优化
- 异构架构(如Qwen3.5-4B的混合注意力层)存在负载不平衡
- 单GPU执行可能遇到内存带宽瓶颈
- 多GPU执行需要跨设备通信优化