Qwen-VLA
统一的具身基础模型,通过DiT动作解码器将视觉-语言建模扩展到连续动作生成
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments |
| 作者 | Qiuyue Wang, Mingsheng Li, Jian Guan, Jinhui Ye, Sicheng Xie, Yitao Liu, Junhao Chen, Zhixuan Liang, Jie Zhang, Xintong Hu, Xuhong Huang, Pei Lin, Junyang Lin, Dayiheng Liu, Shuai Bai, Jingren Zhou 等 (40+ 作者) |
| 机构 | Qwen Team (Alibaba) |
| 论文 | arXiv:2605.30280 |
| 代码 | GitHub: QwenLM/Qwen-VLA |
| 发布 | 2026-05-28 |
| 许可 | 未明确 |
二、核心思想
问题定义
具身智能通常通过针对单一任务(如操作或导航)的专用模型来研究,导致能力碎片化,跨任务、环境和机器人形态的泛化能力有限。不同具身任务在输出格式、控制频率、预测时间范围、动作维度和评估协议上存在显著差异,但它们共享一个共同的计算结构:智能体必须基于视觉观察、语言指令和形态特定约束来预测未来动作或轨迹。
解决方案概述
Qwen-VLA 是一个统一的具身基础模型,将 Qwen 的视觉-语言建模栈从感知、理解和推理扩展到连续动作和轨迹生成。核心创新包括:
- 统一动作-轨迹预测框架:将操作、导航和轨迹预测统一到共享的动作空间中
- 形态感知提示条件化:通过文本描述指定当前机器人形态和控制约定,无需为每个平台设计单独的输出头
- 渐进式训练策略:T2A预训练 → 持续预训练 → 监督微调 → 强化学习
- DiT动作解码器:基于流匹配的1.15B参数动作专家
三、技术架构
整体框架图
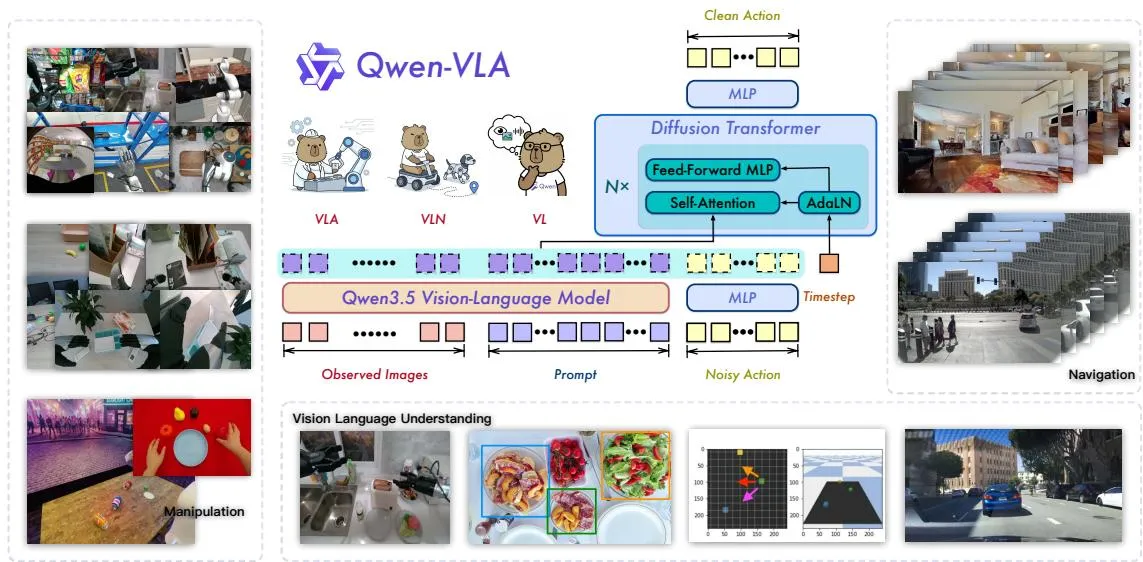
Qwen-VLA 的架构由两个核心组件构成:
- 视觉-语言骨干网络:基于 Qwen3.5-4B,采用早期视觉-语言融合设计,ViT产生的视觉token直接交错到文本token流中
- DiT动作专家:1.15B参数的单流DiT风格流匹配策略,将VLM隐藏状态与噪声动作块拼接后通过联合自注意力处理
核心公式
统一条件预测框架:
其中 为视觉上下文, 为语言指令, 为形态描述, 为任务标识符, 为预测时间范围。
流匹配动作损失:
给定干净目标 和噪声 ,线性插值为:
每个活跃通道的均方误差:
动作损失(双层平均):
视觉-语言损失:
联合目标:
强化学习目标(PPO):
其中 为重要性比率, 为GAE优势估计。
动作表示
统一张量接口: 每个训练样本贡献目标张量 ,其中 为固定预测时间范围, 为所有控制模式共享的固定通道维度。
控制信号类型:
- 操作信号:delta末端执行机位置 、旋转(欧拉角/四元数)、关节位置、夹爪开度、灵巧手关节角
- 导航轨迹信号:每路点 ,编码地面平面上的相对位移和航向变化
通道布局: 给定控制模式使用 通道,放置在 的前 维,其余维度零填充。每通道二进制掩码 记录有效信号。
动作归一化: 每个数据集使用分位数统计进行归一化:
训练流程
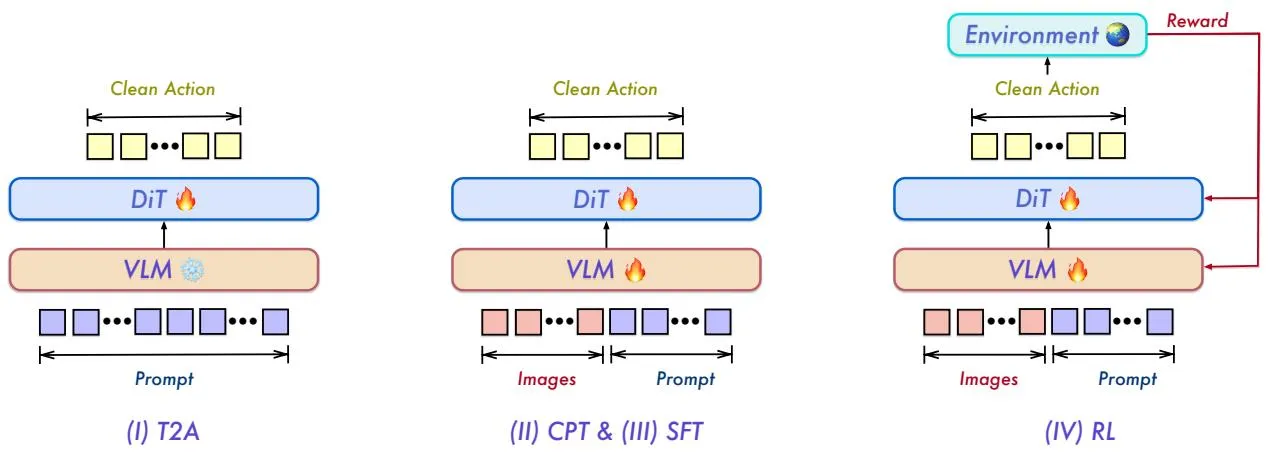
Qwen-VLA 采用四阶段渐进式训练策略:
| 阶段 | 名称 | 描述 | 关键特点 |
|---|---|---|---|
| Stage I | T2A (Text-to-Action) | 冻结VLM,仅训练DiT | 语言到动作的解压缩器,无视觉输入 |
| Stage II | CPT (Continued Pretraining) | 解冻两个模块 | 异构混合数据,模拟+真实轨迹 |
| Stage III | SFT (Supervised Fine-Tuning) | 两个并行分支 | 多任务SFT + 真实机器人部署 |
| Stage IV | RL (Reinforcement Learning) | PPO优化 | 稀疏二元奖励,闭环任务成功 |
T2A阶段的核心洞察: 将动作学习视为”解压缩”问题。语言指令(如”拿起红色杯子”)加上形态提示用少量token紧凑编码任务意图,但对应的动作轨迹可能跨越数百个高维关节位置值。T2A教会解码器作为语言条件化的动作解压缩器。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一动作-轨迹空间 | 操作、导航、自我中心动作建模共享一个预测空间 | 无需为每个形态设计单独输出头 |
| 形态感知提示条件化 | 通过文本描述指定机器人平台、臂配置、控制约定 | 切换形态只需更改文本提示 |
| T2A预训练 | 无视觉输入的语言条件化动作先验学习 | 20%合成+80%真实数据最佳(71.09%) |
| 渐进式训练策略 | 压缩视角:动作先验压缩 → 视觉接地 → 任务专业化 → 成功驱动优化 | 分离关注点,提高训练稳定性 |
| 流匹配动作解码器 | DiT风格,1.15B参数,16个DiT块 | 低延迟实时控制,少量欧拉积分步骤 |
| 多模态联合训练 | 操作轨迹、人类自我中心演示、合成数据、导航数据、VL数据 | 74.2%操作 + 6%人类 + 7.5%导航 + 3.7%合成 |
五、预训练数据
数据组成
| 数据源 | 比例 | 说明 |
|---|---|---|
| 机器人操作轨迹 | 74.2% | 桌面、移动、双臂、灵巧手控制 |
| 人类自我中心轨迹 | 6.0% | Ego4D, EPIC-KITCHENS, EgoDex, EgoVerse, Xperience |
| 导航轨迹 | 7.5% | 指令跟随(4.3%)、物体搜索(2.3%)、目标跟踪(1.0%) |
| 合成模拟轨迹 | 3.7% | ROBOINF管线,359,848条成功轨迹 |
| 通用视觉-语言数据 | 3.4% | 描述、VQA、OCR、指令跟随 |
| 空间接地(2D) | 2.5% | 边界框接地数据 |
| 自动驾驶VQA | 2.4% | 时序场景理解、环绕视图空间推理 |
| 细粒度动作描述 | 0.2% | 48,000个视频-描述对 |
机器人形态
| 机器人 | 臂数 | 动作类型 |
|---|---|---|
| WidowX | 单臂 | ΔEEF + G |
| Google Robot | 单臂 | ΔEEF + G |
| Franka Panda | 单/双臂 | ΔEEF + G; Abs Joint + G |
| Mobile ALOHA | 双臂 | ΔEEF + G; Abs Joint + G |
| AgiBot A2-D | 双臂 | Abs Joint + G; Abs Joint + DH |
| Real Human | 双臂 | ΔEEF (from MANO) |
合成数据管线 (ROBOINF)
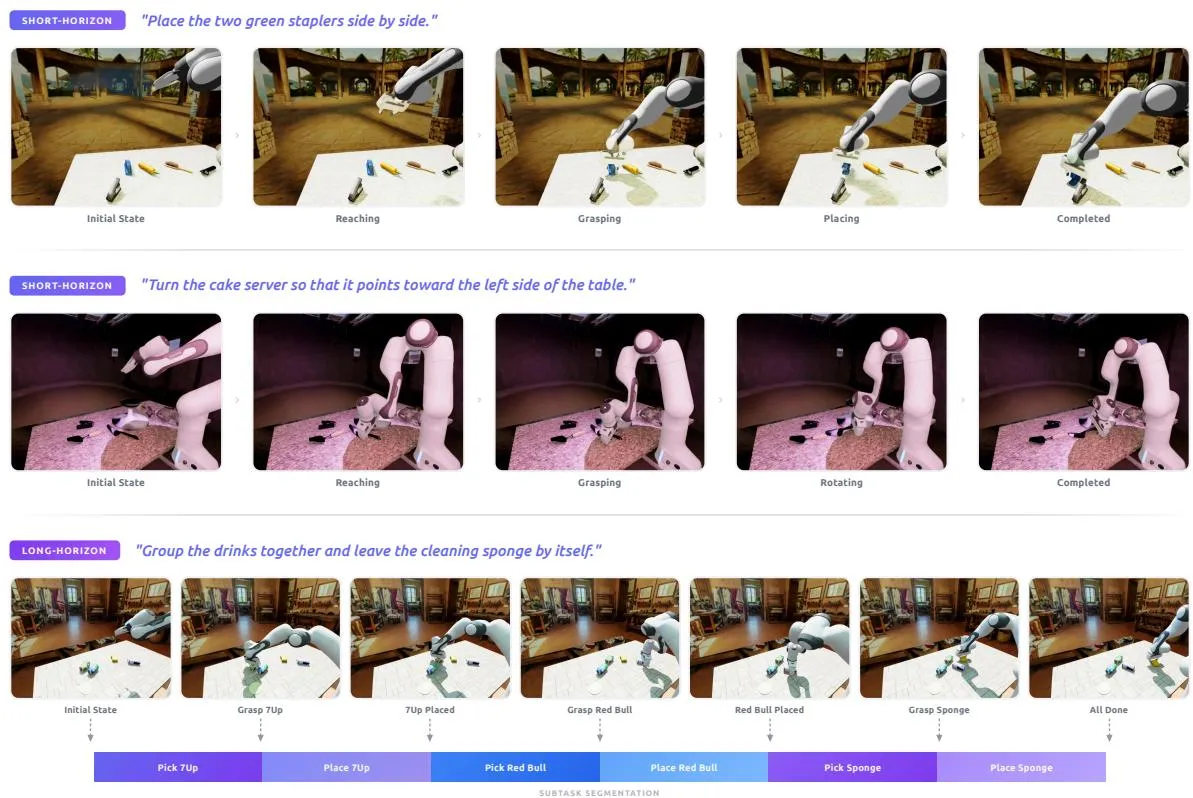
- 20个桌面场景 × 10个物体初始位姿配置 = 200个基础场景配置
- 450个操作任务(短/长时间范围)
- 每个任务300条成功轨迹,含环境和执行增强
- 视觉随机化:~3K背景、~1K桌面纹理
- 总计359,848条成功轨迹(含子任务段)
六、实验结果
操作基准测试
| 方法 | 类型 | LIBERO | RoboCasa-GR1 | Simpler-WidowX | RoboTwin-Easy | RoboTwin-Hard |
|---|---|---|---|---|---|---|
| π₀ | 专家 | 94.4 | - | - | 65.9 | 58.4 |
| StarVLA-OFT | 专家 | 96.6 | 48.8 | 64.6 | 50.4 | - |
| GR00T N1.6 | 专家 | 97.2 | 49.9 | 63.2 | 47.6 | - |
| π₀.₅ | 专家 | 97.6 | 37.0 | 46.9 | 82.7 | 76.8 |
| ABot-M0 | 专家 | 98.6 | 58.3 | - | 86.0 | 85.0 |
| Qwen-VLA-Instruct | 通用 | 97.9 | 56.7 | 73.7 | 86.1 | 87.2 |
关键发现: 单个通用模型在大多数基准上匹配或超越专门针对每个基准微调的专家模型。
真实世界结果(ALOHA双臂平台)
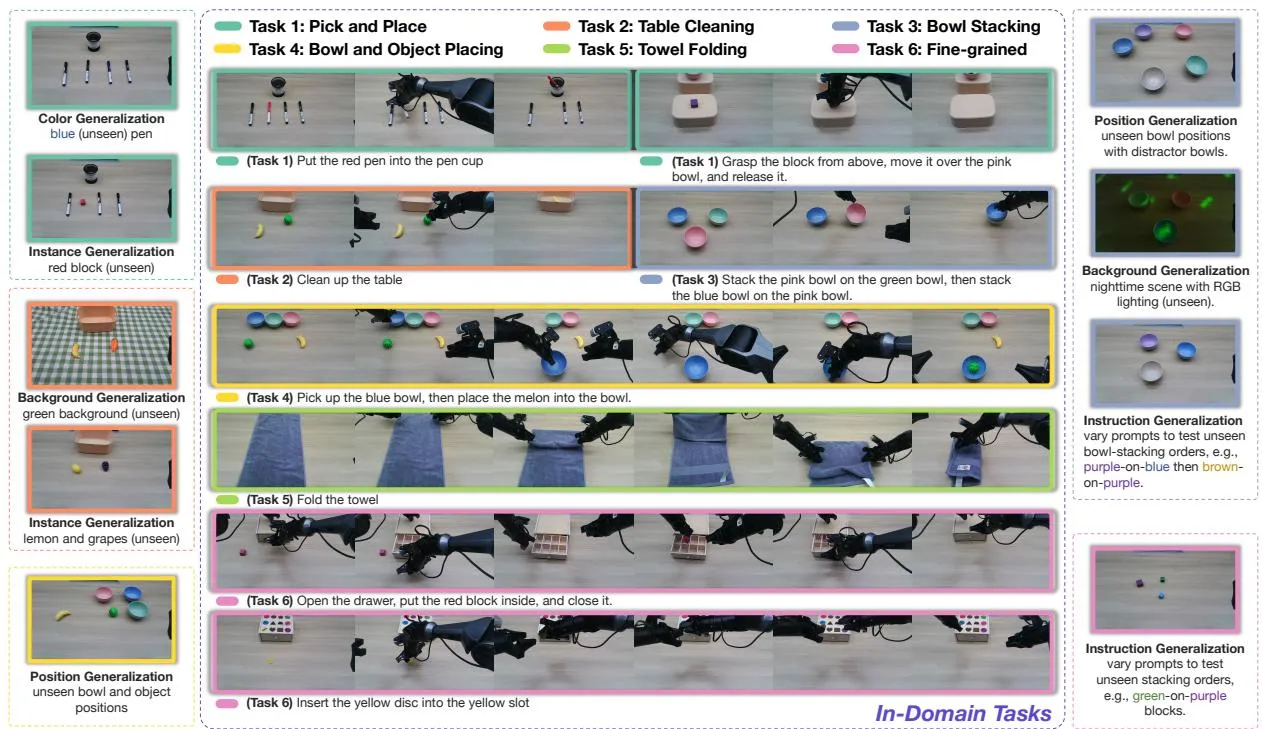
域内性能(成功率%):
| 模型 | 拾放 | 桌面清理 | 碗堆叠 | 碗拾放 | 毛巾折叠 | 精细操作 | 平均 |
|---|---|---|---|---|---|---|---|
| GR00T N1.6 | 30.8 | 38.5 | 53.8 | 19.2 | 19.2 | 10.3 | 28.6 |
| π₀.₅ | 73.1 | 84.6 | 88.5 | 69.2 | 80.8 | 33.3 | 71.6 |
| Qwen-VLA-aloha (无预训练) | 30.8 | 53.8 | 61.5 | 64.1 | 50.0 | 30.8 | 48.5 |
| Qwen-VLA-aloha (有预训练) | 96.2 | 92.3 | 98.7 | 87.2 | 65.4 | 61.5 | 83.6 |
域外性能(成功率%):
| 模型 | 颜色 | 实例 | 位置 | 背景 | 指令 | 平均 |
|---|---|---|---|---|---|---|
| GR00T N1.6 | 46.2 | 38.5 | 3.8 | 19.2 | 19.2 | 25.4 |
| π₀.₅ | 57.7 | 61.5 | 19.2 | 26.9 | 42.3 | 41.5 |
| Qwen-VLA-aloha (有预训练) | 88.5 | 76.9 | 53.8 | 80.8 | 84.6 | 76.9 |
导航结果(VLN-CE)
| 方法 | R2R OS↑ | R2R SR↑ | RxR SR↑ | RxR SPL↑ |
|---|---|---|---|---|
| NaVid | 49.2 | 41.9 | 45.7 | 38.2 |
| Uni-NaVid | 53.3 | 47.0 | 48.7 | 40.9 |
| NaVILA | 62.5 | 54.0 | 49.3 | 44.0 |
| StreamVLN | 64.2 | 56.9 | 52.9 | 46.0 |
| Qwen-VLA-Instruct | 69.0 | 57.5 | 59.6 | 47.8 |
域外泛化评估
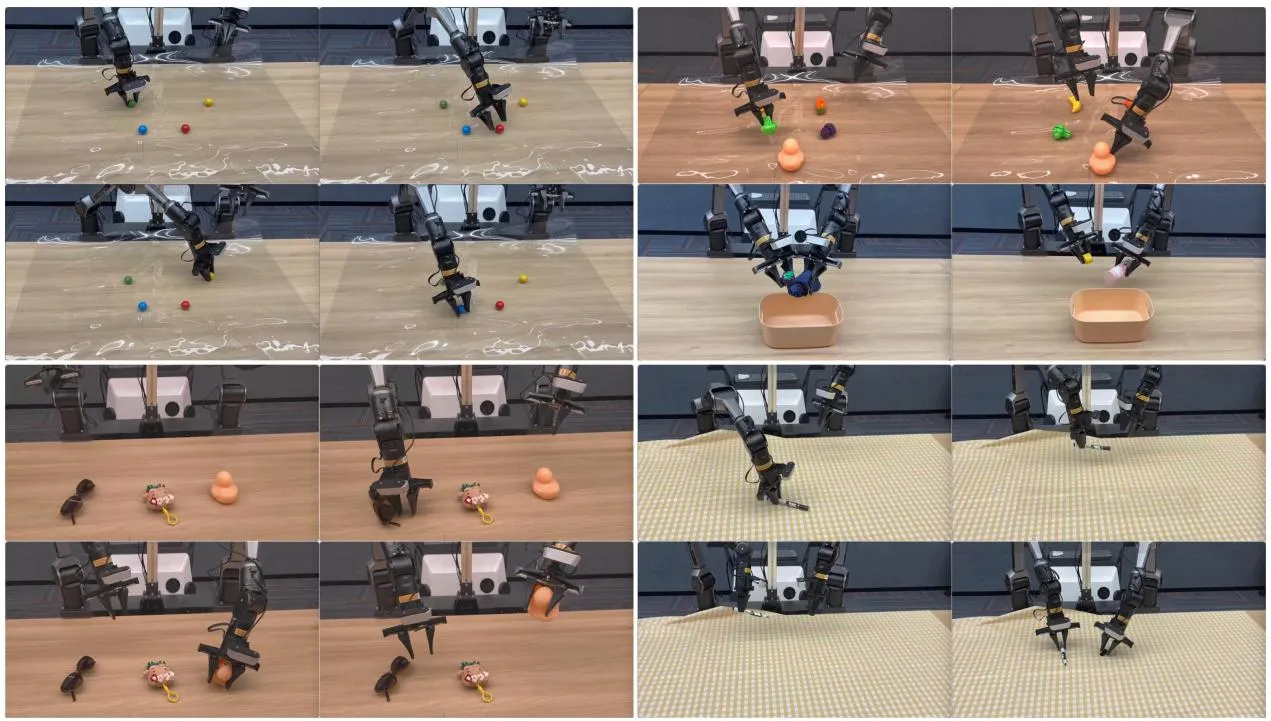
SimplerEnv-OOD(仅在简单拾放上微调):
| 方法 | MoveAway | MoveRight | PlaceNear | PlaceRight | PutFront | StackYellow | 平均 |
|---|---|---|---|---|---|---|---|
| π₀.₅ | 26.1 | 0.0 | 0.0 | 32.1 | 13.0 | 4.2 | 12.6 |
| Qwen-VLA-Instruct | 43.8 | 33.3 | 39.6 | 47.9 | 4.2 | 22.9 | 32.0 |
DOMINO动态操作(零样本):
| 方法 | SR↑ | MS↑ |
|---|---|---|
| OpenVLA-OFT (微调) | 9.1 | 24.1 |
| StarVLA-OFT (微调) | 10.9 | 30.5 |
| PUMA (微调) | 17.2 | 35.0 |
| Qwen-VLA-Instruct (零样本) | 26.6 | 39.5 |
重要发现: Qwen-VLA 在零样本设置下超越了所有在动态操作数据上微调的方法,包括PUMA(+9.4pp SR, +4.5pp MS)。
七、消融实验
T2A预训练消融
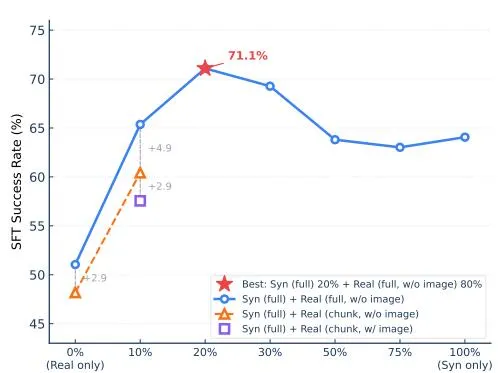
| 消融维度 | 最佳配置 | 性能 |
|---|---|---|
| 数据组成 | 20%合成 + 80%真实 | 71.09% |
| 序列预测模式 | 全序列 > 块预测 | +4.94pp |
| 视觉输入 | 无图像 > 有图像 | +2.87pp |
| 时间步分布 | Sigmoid-Normal(T2A) + Beta(SFT) | 71.09% |
| 训练时长 | 2,000步 | 71.09%(40K步降至60.42%) |
多模态联合训练消融
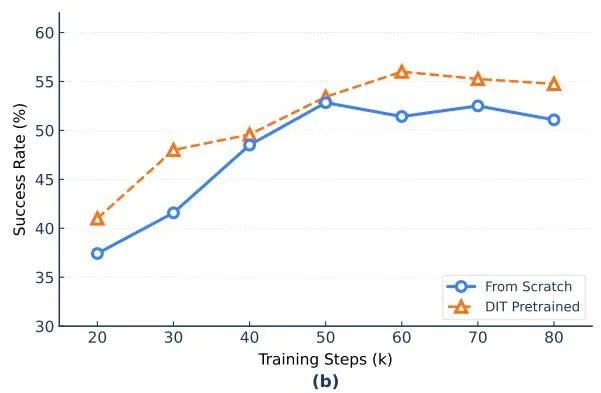
- 混合VL数据在操作基准上带来明显收益
- RoboCasa-GR1: VLA-Only 51% → VL+VLA 56% (+5pp)
- RoboTwin-2.0: VLA-Only 82% → VL+VLA 86% (+4pp)
八、相关工作
| 方向 | 代表工作 | Qwen-VLA的优势 |
|---|---|---|
| 通用VLA | OpenVLA, π₀, π₀.₅ | 统一动作空间,跨形态泛化 |
| 专用操作模型 | GR00T N1.6, ABot-M0 | 通用模型匹配/超越专家 |
| 导航模型 | NaVid, StreamVLN, NaVILA | 联合训练保持导航性能 |
| 动态操作 | PUMA, LingBot-VA | 零样本超越微调方法 |
九、总结
核心贡献
- 统一具身基础模型:将操作、导航和自我中心动作建模统一到共享的动作-轨迹空间,基于Qwen3.5-4B骨干和1.15B DiT动作解码器
- 大规模联合预训练:构建涵盖操作轨迹、人类自我中心演示、合成模拟、导航和VL数据的异构预训练混合
- 形态感知提示条件化:通过文本描述统一多样机器人平台,无需为每个形态单独的策略
- 渐进式训练策略:T2A预训练 → CPT → SFT → RL,桥接离散VL token和连续动作轨迹
技术影响
- 证明了异构具身决策问题可以在单一VLA模型中统一
- 通用模型可以匹配或超越针对每个基准专门微调的专家模型
- 大规模具身预训练提供了强大的域外泛化能力
- T2A阶段的”压缩视角”为动作学习提供了新的理论框架
局限性
- 论文未详细公开模型权重和完整训练代码
- 合成数据管线(ROBOINF)的完整技术细节在单独的博客中
- RL阶段仅在单一模拟环境(SimplerEnv)中训练,但展示了跨环境迁移
- 未详细讨论计算资源需求和训练成本
十、参考资源
- 论文: arXiv:2605.30280
- 代码: GitHub: QwenLM/Qwen-VLA
- 博客: Qwen Blog
- 技术报告: 随代码仓库发布