RTP-LLM: High-Performance Alibaba LLM Inference Engine
阿里巴巴高性能LLM推理引擎,服务超1亿用户的大规模部署
RTP-LLM: High-Performance Alibaba LLM Inference Engine
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RTP-LLM: High-Performance Alibaba LLM Inference Engine |
| 作者 | Alibaba Group |
| 论文 | arXiv:2605.29639 |
| 发布 | 2026-05-28 |
| 主题 | cs.OS (Operating Systems) |
二、核心思想
问题定义
大规模LLM部署面临多重挑战:
- 模型加载缓慢:大模型(数百B参数)加载到GPU耗时长
- Prefill-Decode耦合:计算密集的prefill阶段与内存密集的decode阶段混合执行
- KV缓存效率低:缓存复用率不高,导致重复计算
- 生产环境复杂性:需支持多种模型架构、多模态、量化等
解决方案概述
RTP-LLM是阿里巴巴集团部署的高性能推理引擎,服务超1亿用户:
- 文件顺序驱动I/O:优化模型加载,实现4.7-6.3倍加速
- Prefill-Decode解耦:分离计算密集和内存密集阶段
- 多层级KV缓存:GPU显存→本地CPU内存→远程RDMA内存→分布式存储
- 模块化推测解码:支持多种算法,1.12-2.48倍吞吐提升
- 自适应KV缓存量化:减少内存占用
- 解耦多模态处理:独立优化视觉和语言处理
三、技术架构
整体框架图
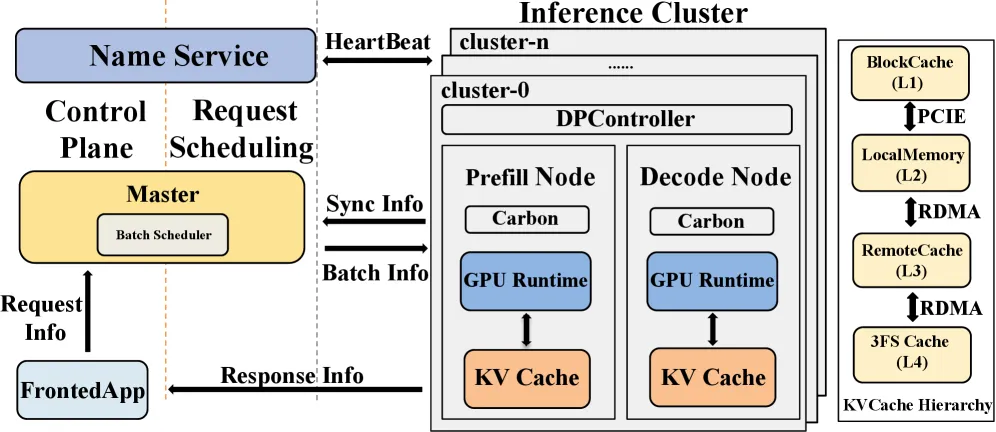
Figure 1: RTP-LLM系统架构。包含Frontend Application、Master、Prefill Node、Decode Node、Multi-Tiered Cache、Name Service、DP-Controller等组件。
核心组件
| 组件 | 说明 | 关键功能 |
|---|---|---|
| Frontend Application | 请求入口 | 接受用户请求,tokenization,元数据提取 |
| Master | 全局协调器 | 流量调度,负载均衡,全局状态视图 |
| Prefill Node | 计算密集节点 | 并行处理输入prompt,生成初始KV缓存 |
| Decode Node | 内存密集节点 | 自回归生成token,使用缓存attention状态 |
| Multi-Tiered Cache | 多层级缓存 | GPU→本地CPU→远程RDMA→分布式存储 |
| DP-Controller | 批次管理 | 协调请求批次执行,GPU内存管理 |
| Name Service | 服务发现 | 心跳检测,集群状态监控 |
核心算法
Algorithm 1 - 系统工作流:
输入: 用户请求 req, 集群状态 cluster_state
输出: 处理结果 result

1: H ← GenerateHashKeys(req.tokens)           // 生成前缀哈希键
2: M ← PrefixMatching(H)                      // 在缓存中查找匹配块
3: B ← MasterDecision(req, cluster_state)     // 负载均衡和批处理决策
4: for req ∈ B do
5:   if req.kv_cache ∈ block_cache then        // GPU显存层
6:     UpdateReferenceCount(req.kv_cache)
7:   else if req.kv_cache ∈ local_memory then  // 本地CPU内存层
8:     TransferToGPU(req.kv_cache)
9:   else                                       // 需要重新计算
10:    RecomputeKVCache(req)
11:  end if
12:  ExecuteInference(req)
13: end for
部署策略
PD-Fusion(融合模式):
- Prefill和Decode在同一节点执行
- 适合中小规模部署
PD-Disaggregation(解耦模式):
- Prefill和Decode物理分离到专用节点
- 支持独立扩展和专门优化
- 典型配置:4节点Prefill + 1节点Decode
并行策略
| 并行类型 | 说明 | 适用场景 |
|---|---|---|
| Tensor Parallelism (TP) | 权重矩阵在多GPU间分区 | 单节点内,加速计算密集操作 |
| Pipeline Parallelism (PP) | 层级分布在多GPU上 | 跨节点,处理超大模型 |
| Data Parallelism (DP) | 模型权重在多节点复制 | 集群级,扩展吞吐量 |
| Expert Parallelism (EP) | MoE专家在多设备分布 | MoE模型,内存高效 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 文件顺序驱动I/O | 优化模型加载,集成fastsafetensors | 4.7-6.3倍加载加速 |
| PD解耦架构 | 分离prefill和decode阶段 | 35-37% TTFT P95延迟降低 |
| 多层级KV缓存 | GPU→CPU→RDMA→分布式存储 | 215%缓存复用提升 |
| 模块化推测解码 | 支持多种算法 | 1.12-2.48倍吞吐提升 |
| 自适应KV缓存量化 | FP8量化减少内存 | 35-40%批处理延迟降低 |
| 解耦多模态处理 | 独立优化视觉和语言 | 1.86-2.52倍多模态推理提升 |
五、实验结果
实验设置
- 模型规模:8B - 480B参数(Qwen系列)
- 硬件:多节点GPU集群,NVLink + InfiniBand
- 基线:vLLM, SGLang
- 工作负载:真实生产流量(Internal Robot Q&A, Taobao Merchant Service)
流量调度性能
Table 2: 流量调度性能对比
| 工作负载 | 调度 | TTFT P95 (ms) | Inference P95 (ms) |
|---|---|---|---|
| Internal Robot Q&A | Off | 83.3 | 136 |
| Internal Robot Q&A | On | 52.3 | 96.2 |
| Taobao Merchant Service | Off | 350 | 1760 |
| Taobao Merchant Service | On | 226 | 1210 |
关键发现:流量调度使TTFT P95降低35-37%。
KV缓存复用
Table 3: KV缓存复用长度对比
| 工作负载 | 调度 | 缓存复用长度 (tokens) | 提升 |
|---|---|---|---|
| Internal Robot Q&A | Off | 26.6 | - |
| Internal Robot Q&A | On | 83.8 | 215% |
| Taobao Merchant Service | Off | 833 | - |
| Taobao Merchant Service | On | 840 | +7 |
PD解耦性能
Table 4: Qwen3-Coder-480B-A35B-Instruct-FP8性能对比
| 指标 | RTP-LLM | SGLang | vLLM |
|---|---|---|---|
| Cache Hit Rate (%) | 45.09 | 28.70 | 19.10 |
| TTFT (ms) | 1338.38 | 6322.7 | 7134.8 |
| Tokens/s | 1081.72 | 1152.95 | 1084.58 |
关键结果:
- Cache Hit Rate: 比SGLang高1.57倍,比vLLM高2.36倍
- TTFT: 比SGLang快4.72倍,比vLLM快5.33倍
推测解码性能
Table 5: DeepSeek-V3-0324推测解码吞吐量对比
| 框架 | RTP-LLM | vLLM | SGLang |
|---|---|---|---|
| Tokens/s | 187.53 | 167.95 | 75.785 |
关键结果:
- 比vLLM快1.12倍
- 比SGLang快2.48倍
优势来源:RTP-LLM的直接C++算子启动机制消除了Python到C++的调用开销。
模型加载性能
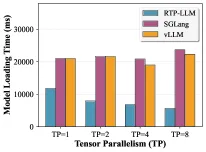
Figure 4: 中等规模模型(8B-32B参数)在不同TP配置下的加载时间对比。
关键结果:模型加载加速4.7-6.3倍。
量化推理性能
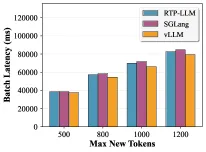
Figure 5: Qwen3-32B在不同量化配置下的批处理延迟和精度损失对比。
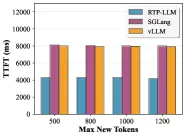
Figure 6: Qwen3-32B在不同量化配置下的TTFT和Tokens/s对比。
关键结果:
- 批处理延迟降低35-40%
- TTFT提升1.9-3.0倍
- 精度损失(PPL)在7.59-8.09范围内,与基线相当
多模态推理性能
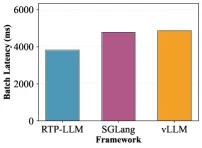
Figure 7: Qwen/Qwen2.5-VL-7B-Instruct在GQA数据集上的性能和GPU内存利用率对比。
关键结果:多模态推理吞吐提升1.86-2.52倍。
六、相关工作
| 方法 | 特点 | RTP-LLM优势 |
|---|---|---|
| vLLM | PagedAttention | 更高的缓存命中率(2.36倍) |
| SGLang | 高效推理框架 | 更低的TTFT(4.72倍) |
| TensorRT-LLM | NVIDIA优化 | 更全面的生产特性 |
| DeepSpeed | 分布式推理 | 更优的流量调度 |
七、总结
核心贡献
- 生产验证的架构:在阿里巴巴部署,服务超1亿用户
- PD解耦架构:分离prefill和decode,实现独立优化和扩展
- 多层级KV缓存:跨越GPU→CPU→RDMA→分布式存储的层次化缓存
- 全面优化:涵盖模型加载、流量调度、推测解码、量化、多模态等
性能总结
| 优化项 | 性能提升 |
|---|---|
| 模型加载 | 4.7-6.3倍加速 |
| TTFT P95 | 35-37%降低 |
| 缓存复用 | 215%提升 |
| 推测解码吞吐 | 1.12-2.48倍提升 |
| 量化推理 | 35-40%延迟降低,1.9-3.0倍TTFT提升 |
| 多模态推理 | 1.86-2.52倍吞吐提升 |
技术影响
RTP-LLM展示了生产级LLM推理系统需要综合优化多个层面:
- 系统架构:PD解耦、多层级缓存
- 调度策略:流量调度、负载均衡
- 算法优化:推测解码、量化
- 工程实践:故障恢复、服务发现
未来方向
- 支持更大规模模型(1000B+)
- 优化跨数据中心部署
- 增强动态负载适应能力
八、参考资源
- 论文: arXiv:2605.29639
- 相关框架: