UnityMAS-O: A General RL Optimization Framework for LLM-Based Multi-Agent Systems
面向 LLM 多智能体系统的通用 RL 优化框架
UnityMAS-O: A General RL Optimization Framework for LLM-Based Multi-Agent Systems
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | UnityMAS-O: A General RL Optimization Framework for LLM-Based Multi-Agent Systems |
| 作者 | Yiqun Chen, Wei Yang, Erhan Zhang, Shijie Wang, Qi Liu, Zechun Niu, Bin Zhang, Haitao Li, Rui Li, Lingyong Yan, Jinyuan Feng, Biqing Qi, Xiaochi Wei, Yan Gao, Yi Wu, Yao Hu, Jiaxin Mao |
| 机构 | Renmin University of China, Xiaohongshu Inc. |
| 论文 | arXiv:2605.26646 |
| 代码 | GitHub - chenyiqun/UnityMAS-O |
| 发布 | 2026年5月26日 |
| 主题 | cs.AI, cs.CL, cs.MA |
二、核心思想
问题定义
基于 LLM 的多智能体系统通过角色专业化将复杂任务分解为交互式角色,但大多数系统仍通过提示、工具和控制规则手动编排,智能体很少通过统一的强化学习接口进行优化。
核心挑战: 现有 RL 后训练框架主要针对单策略优化,缺乏用户定义多智能体工作流、结构化交互、角色特定信用分配和可配置参数共享的抽象。
解决方案概述
UnityMAS-O 是一个通用的 LLM 多智能体系统 RL 优化框架:
- 工作流即优化单元: 将完整工作流视为优化单元,而非单个响应或策略轨迹
- 四个一等对象: 逻辑智能体角色、图轨迹、用户定义奖励、智能体-模型映射
- 解耦设计: 逻辑智能体与物理模型参数解耦,支持全共享、全分离和部分共享
- 多层次奖励: 在角色、turn 和轨迹级别分配奖励
核心性能
| 指标 | 数值 |
|---|---|
| QA 提升 (NQ) | 0.5B: 0.022→0.445, 14B: 0.594 |
| QA 提升 (HotpotQA) | 0.5B: 0.032→0.397, 7B: 0.573 |
| 代码 All-Passed | 4B: 0.255→0.686 (+169%), 8B: 0.290→0.738 (+154%) |
| 验证轮次减少 | 从 2.5 轮降至 1.68-1.76 轮 |
三、技术架构
整体框架图
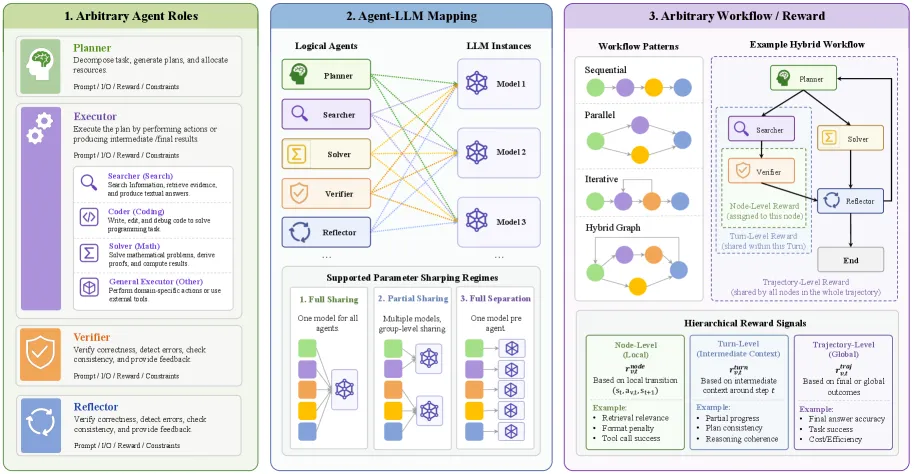
Figure 1: UnityMAS-O 中的智能体级抽象。用户定义逻辑角色,将其映射到物理 LLM 实例,用工作流图连接,并附加角色、turn 或轨迹级奖励进行多智能体 RL 优化。
核心公式
工作流图
工作流表示为有向计算图:
其中 为逻辑智能体角色, 指定信息、控制或环境状态在角色间的流动。
智能体-模型映射
其中 为可训练模型实例集合。
支持三种参数共享模式:
- 全共享:
- 部分共享: 相关角色组共享参数
- 全分离:
多智能体轨迹
对于任务实例 ,执行 产生结构化轨迹:
其中 为工作流状态, 为活跃角色, 为该角色生成的输出。
优化目标
其中 为可训练参数, 为角色 在步骤 的奖励。
角色特定奖励
支持节点级、turn 级和轨迹级奖励的组合。
分布式训练架构
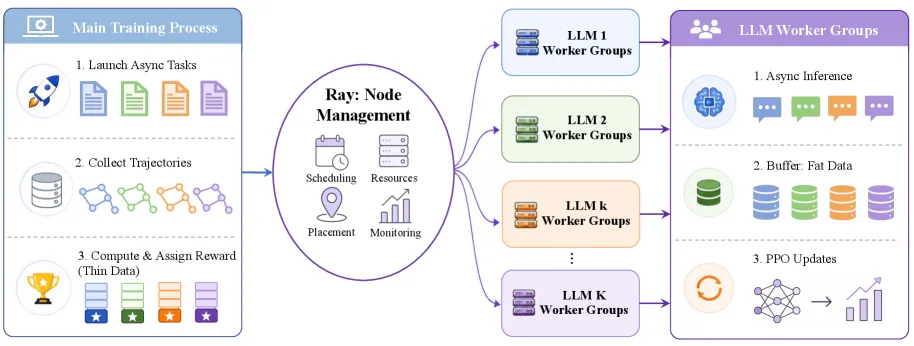
Figure 2: UnityMAS-O 的分布式训练架构。中央控制器执行用户定义的工作流,将逻辑智能体调用路由到模型本地 worker 组,组装奖励和轨迹元数据,并协调分布式策略更新。
系统组件
| 组件 | 说明 |
|---|---|
| 中央控制器 | 维护全局训练循环,调度工作流状态,评估停止条件,组装奖励 |
| Ray 执行层 | 提供远程调用、worker 生命周期管理和 GPU 放置 |
| LLM Worker 组 | 模型本地训练单元,处理生成、缓冲、优势计算和参数更新 |
模型本地缓冲
对于角色 在步骤 的调用,训练片段提交到 的缓冲区:
PPO 风格训练循环
- 异步 Rollout: 控制器启动工作流执行,worker 组生成输出
- 奖励组装: 评估奖励并提交到对应模型的缓冲区
- 批次构建: 对齐轨迹级奖励与 token 序列
- 优势计算: 计算 GAE 优势估计
- 模型更新: 每个 worker 组更新自己的 actor 和 critic 参数
工作流模板
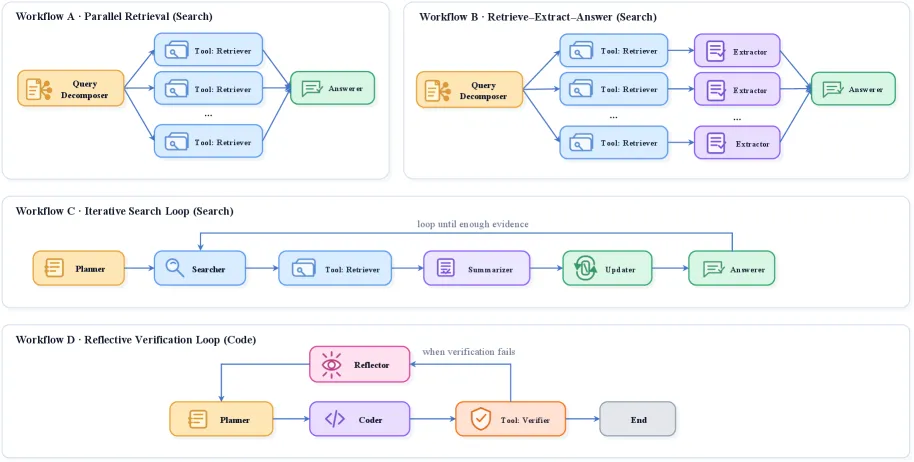
Figure 3: 实验中使用的工作流模板。三个搜索工作流(并行检索、检索-提取-回答、迭代搜索)和一个带反射验证的代码工作流。
| 工作流 | 说明 | LLM 智能体数 | 模型映射 |
|---|---|---|---|
| A: 并行检索 | 分解查询→并行检索→生成答案 | 2 | decompose 和 answer 使用独立模型组 |
| B: 检索-提取-回答 | 在 A 中插入证据提取 | 3 | decompose、evidence、answer 使用独立模型组 |
| C: 迭代搜索循环 | M-ASK 迭代状态更新 | 5 | planning 和 answer 共享推理模型 |
| D: 反射验证循环 | 计划-编码-验证-反射 | 3 | planner、coder、reflector 使用独立模型组 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 工作流即优化单元 | 将完整多智能体工作流视为优化单元 | 支持图结构轨迹优化 |
| 四个一等对象 | 逻辑智能体、图轨迹、用户定义奖励、智能体-模型映射 | 统一抽象跨工作流 |
| 解耦逻辑与物理 | 逻辑智能体与物理模型参数解耦 | 支持全共享、部分共享、全分离 |
| 多层次奖励接口 | 角色级、turn 级、轨迹级奖励分配 | 信用分配更精确 |
| Ray + verl 运行时 | 星型拓扑分布式架构 | 中央控制器 + 模型本地 worker 组 |
五、实验结果
QA 和 Agentic Search
设置: Natural Questions (NQ) 和 HotpotQA,Qwen3 系列模型 (0.5B-14B)
峰值验证 F1:
| 任务 | 工作流 | 0.5B | 1.5B | 3B | 7B | 14B |
|---|---|---|---|---|---|---|
| NQ | QD-Retrieve-Answer | 0.445 | 0.508 | 0.535 | 0.536 | 0.594 |
| NQ | QD-Retrieve-Evidence-Answer | 0.429 | 0.480 | 0.473 | 0.509 | 0.575 |
| NQ | M-ASK 迭代搜索 | 0.142 | 0.515 | 0.513 | 0.621 | – |
| HotpotQA | QD-Retrieve-Answer | 0.397 | 0.493 | 0.493 | 0.523 | 0.552 |
| HotpotQA | QD-Retrieve-Evidence-Answer | 0.359 | 0.435 | 0.473 | 0.486 | 0.522 |
| HotpotQA | M-ASK 迭代搜索 | 0.226 | 0.525 | 0.529 | 0.573 | – |
关键发现:
- 小模型改进尤其显著(0.5B 从接近失败到有用性能)
- M-ASK 在 HotpotQA 上受益最多(需要多跳证据聚合)
- 所有工作流和模型规模都在训练后有所提升
参数共享分析
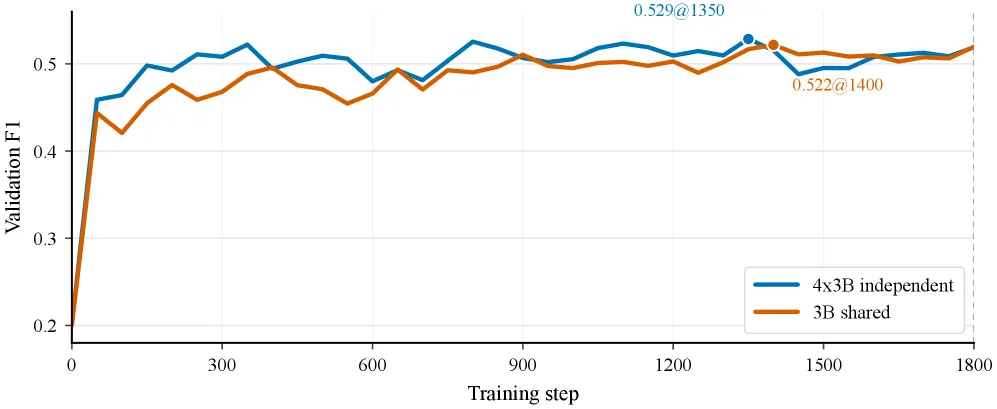
Figure 5: HotpotQA M-ASK 验证 F1,3B 共享参数设置 vs 4x3B 独立设置。
| 设置 | 初始 F1 | 最终 F1 | 训练步数 |
|---|---|---|---|
| 3B 共享 | 0.200 | 0.520 | 1800 |
| 4x3B 独立 | 0.201 | 0.529 | 1350 |
独立设置收敛更快但最终性能相近,表明 UnityMAS-O 可以在多个角色共享同一物理 LLM 时仍有效训练。
代码生成
设置: Reflective Verification Loop,三轮计划-编码-验证-反射
| 设置 | Before RL | Best after RL | 绝对增益 | 相对增益 |
|---|---|---|---|---|
| 3xQwen3-4B | 0.255 | 0.686 | +0.431 | +169% |
| 3xQwen3-8B | 0.290 | 0.738 | +0.448 | +154% |
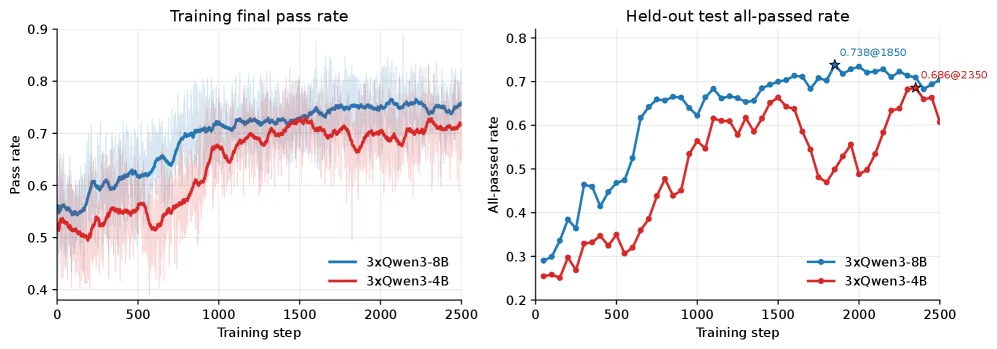
Figure 6: Reflective Verification Loop 代码工作流的训练动态。左:训练最终通过率;右:held-out 测试 all-passed 率。
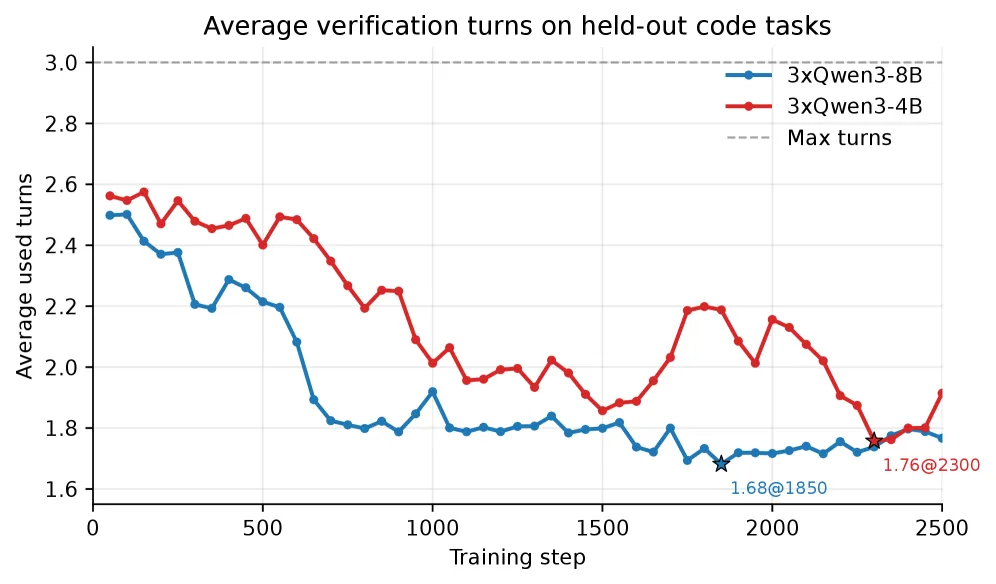
Figure 7: Reflective Verification Loop 在 held-out 代码示例上使用的平均验证轮次。
关键发现:
- All-Passed 指标下改进巨大(要求最终程序通过所有测试)
- 验证轮次从约 2.5 轮降至 1.68-1.76 轮(约 40% 减少)
- MARL 不仅提高最终正确性,还改善了内部停止行为
六、与现有方法对比
| 方面 | verl/TRL/OpenRLHF | UnityMAS-O |
|---|---|---|
| 优化单元 | 单策略 prompt/轨迹 | 图结构多智能体工作流轨迹 |
| 智能体角色 | 通常隐式 | 一等逻辑智能体,有角色标识和接口 |
| 模型分配 | 以单策略为中心 | 显式智能体-模型映射,支持全/部分/独立共享 |
| 奖励接口 | 响应/token/轨迹级 | 角色/turn/工作流级奖励 |
| 运行时结构 | 模型训练的 rollout 和更新流水线 | 中央工作流控制器 + 模型本地 worker 组 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| verl/HybridFlow | 基础框架,UnityMAS-O 扩展其多智能体支持 |
| TRL/OpenRLHF | 单策略 RL 框架,UnityMAS-O 提供多智能体抽象 |
| M-ASK | 迭代搜索工作流,UnityMAS-O 实例化其奖励设计 |
| DeepSeek-R1/Qwen3 | 基础模型,UnityMAS-O 优化其多智能体工作流 |
| AgentScope/MetaGPT | 多智能体框架,UnityMAS-O 提供 RL 优化能力 |
八、总结
核心贡献
- 统一抽象: 联合表示工作流图、逻辑智能体、智能体-模型映射、角色特定奖励和结构化轨迹
- 参数共享支持: 原生支持全共享、部分共享和全分离
- 分布式运行时: Ray + verl 基础的星型拓扑运行时
- 任务无关设计: 用户可定义不同工作流而无需重写优化基础设施
- 实验验证: QA/search 和代码生成工作流上的 before/after MARL 增益
技术影响
- 工作流即优化单元: 将多智能体系统从手动编排转向 RL 优化
- 解耦设计: 逻辑智能体与物理模型解耦,支持灵活的参数共享研究
- 信用分配: 角色特定奖励使信用分配更精确
- 可复用基底: 为转换多样 LLM 多智能体工作流为可训练系统提供通用基底
局限性
- 仅在 QA/search 和代码生成上验证,未覆盖更多任务类型
- 未进行大规模智能体数量的扩展性研究
- 信用分配仍依赖用户定义的奖励函数
- 未探索异步执行和资源分配优化
九、参考资源
- 论文: arXiv:2605.26646
- 代码: GitHub - chenyiqun/UnityMAS-O
- 主题: cs.AI, cs.CL, cs.MA
- 页数: 约 20 页, 7 图