RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models
从权重稀疏到激活稀疏:DiT 模型的 N:M 半结构化稀疏加速
RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models |
| 作者 | Xing Cong, Hanlin Tang, Kan Liu, Tao Lan, Lin Qu, Chenhao Xie |
| 机构 | Alibaba Group, Independent Researcher |
| 论文 | arXiv:2605.26632 |
| 发布 | 2026年5月26日 (v1), 2026年6月1日 (v2) |
| 主题 | cs.CV, cs.AI |
二、核心思想
问题定义
Diffusion Transformers (DiT) 在图像生成中表现优异,但推理成本高昂。虽然量化和蒸馏已有研究,但半结构化稀疏(可近乎减半 FLOPs)仍未被充分探索。关键原因在于现有方法聚焦于权重稀疏化,而剪枝 50% 权重会移除关键模型容量,严重降低生成质量。
核心观察
本文发现 DiT 激活天然具有稀疏性,且对 N:M 半结构化稀疏化远比权重更鲁棒:
- 权重不是天然稀疏的: 权重元素服从准高斯分布,几乎随机分布在归一化范围内,缺乏内在的 2:4 稀疏模式
- 激活由于叠加效应天然稀疏: 每个 token 仅激活 5%~10% 的神经元,激活值高度集中在零附近
- 激活稀疏化引入的误差远小于权重稀疏化: 相对 Frobenius 误差 (RFE) 在所有层上都显著更低
解决方案概述
RT-Lynx 提出端到端 DiT 稀疏化框架:
- 将 N:M 稀疏化应用于激活而非权重
- 引入范数补偿和 LoRA 适配来恢复精度
- 设计高度优化的 CUDA 内核实现实际加速
核心性能
| 指标 | 数值 |
|---|---|
| Sparse GEMM 加速 | 最高 1.88× |
| 线性层加速 | 平均 1.55× |
| 端到端加速 | 约 1.2× |
| 精度保持 | 近无损(FID 甚至优于原始模型) |
| 与其他方法正交 | 可与蒸馏、量化、缓存、稀疏注意力叠加 |
三、技术架构
整体架构
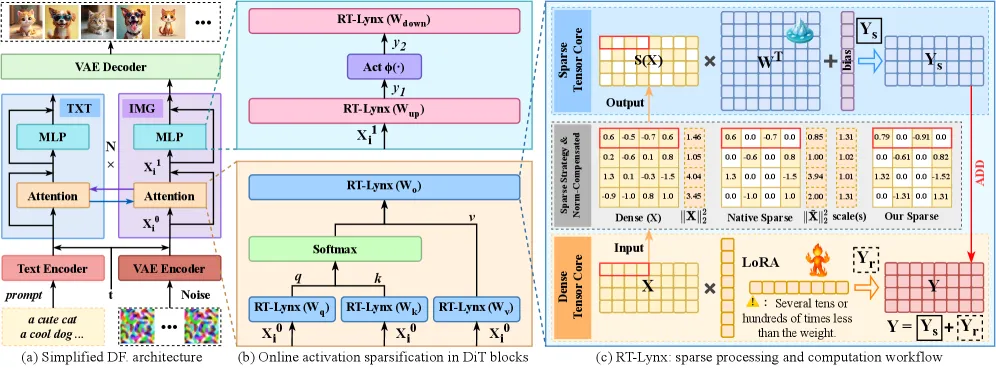
Figure 4: (a) DiT 模型抽象架构,标出用于稀疏分析的 Transformer 模块。(b) 激活稀疏应用位置:QKV 投影和 MLP 的 Up/Down 映射。(c) 在线激活稀疏化 + LoRA 补偿的整体流水线,骨干权重冻结,仅微调低秩 LoRA 矩阵。
核心洞察
洞察 1: 权重 vs 激活的稀疏性差异
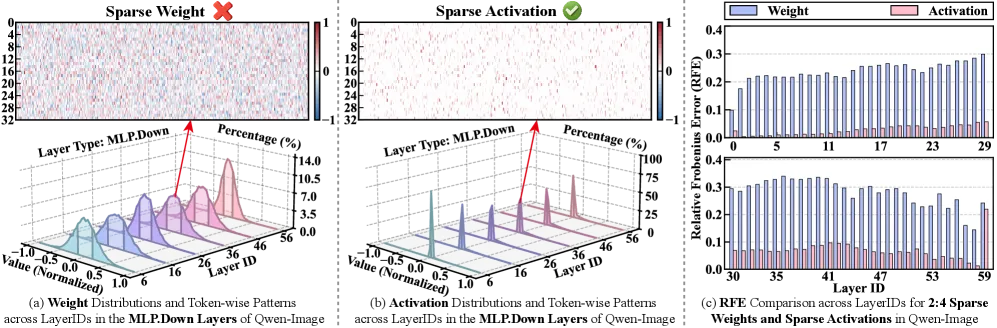
Figure 2: (a)-(b) 比较 Qwen-Image mlp.down 层的权重和激活:下半部分显示六个深度的归一化值分布([-1,1] 分为 50 个 bin),上半部分可视化第 36 层的逐行热力图。(c) Top-K 2:4 稀疏化在不同层深度上引起的相对误差。
- 权重: 准高斯分布,广泛随机分布,无内在结构化稀疏模式
- 激活: 高度集中在零附近,仅 5%~10% 神经元被显著激活
- 误差: 激活稀疏化的 RFE 在所有层上都远低于权重稀疏化
洞察 2: 权重稀疏 vs 激活稀疏
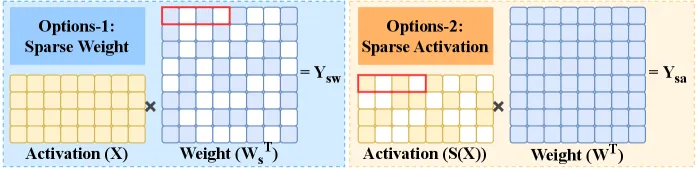
Figure 3: 2:4 半结构化模式下的权重稀疏 vs 激活稀疏。白色块表示被丢弃的元素。
核心公式
线性层计算
标准线性层: Y = X \cdot W^T \tag{1}
权重稀疏路径(静态): Y = X \cdot W_s^T \tag{2}
激活稀疏路径(动态、输入自适应): Y = S(X) \cdot W^T \tag{3}
范数补偿稀疏化
直接剪枝激活元素会降低整体范数。范数补偿方案显式保留原始激活的 范数:
S(X) = s \cdot \tilde{X}, \quad s = \frac{\|X\|_2^2}{\|\tilde{X}\|_2^2 + \epsilon} \tag{4}
其中 确保数值稳定性。此公式将 的幅度恢复到 的水平,有效消除稀疏化引起的范数衰减。
LoRA 补偿
尽管大部分激活元素接近零,它们仍编码图像的精细细节(头发、边缘、纹理)。引入轻量 LoRA 分支补偿稀疏化误差:
Y = Y_s + Y_r = S(X) \cdot W^T + X \cdot (L_A L_B)^T \tag{5}
其中 , 是 LoRA 矩阵,。
训练损失:
训练在 2k 步内收敛。
算法流程
Algorithm 1: RT-Lynx
- 输入: 激活 , 权重 , LoRA , 2:4 TopK 算子
- // 每组保留 2 个
- ,
- ,
- 返回
选择性层跳过
对于单流 DiT 架构(Z-Image, FLUX),LoRA 分支无法完全弥补性能差距,因此跳过某些线性层:
- Z-Image: 跳过单流路径中的 attn.o_proj 和 mlp.up
- FLUX: 跳过单流路径中的 attn.o_proj 和 mlp.down
CUDA 内核优化
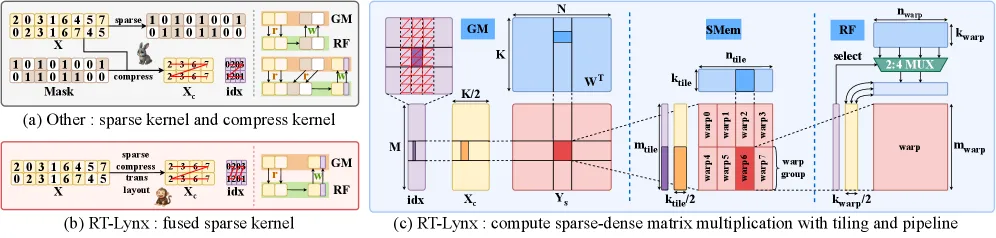
Figure 5: (a) 现有 N:M 稀疏方法分离剪枝、格式化和计算。(b) 提出的在线框架将这些步骤融合为统一执行流。(c) SpTC 上的分块流水线稀疏矩阵乘累加。
两个关键优化:
- 融合在线稀疏化: 将模式确定、Top-K 选择和压缩融合到单个 CUDA 执行路径,在寄存器级别直接生成 SpTC 兼容布局的 2:4 结构化激活
- 集成工作流: 交错稀疏计算与密集 LoRA 执行,消除 LoRA 中间物化,减少同步开销
SpTC (Sparse Tensor Core) 工作原理:
- 矩阵 A 在 K 维度上每 4 个元素仅保留 2 个非零元素
- 存储为 加上 2-bit 索引
- 计算时用索引从密集矩阵 B 的 4 个候选输入中选择匹配的 2 个元素
- 理想情况下可实现最高 2× 吞吐量提升
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 范式转移 | 从权重稀疏化转向激活稀疏化 | 激活天然稀疏(5%-10% 神经元活跃),RFE 远低于权重稀疏 |
| 范数补偿 | 保留原始激活的 l2 范数 | 消除稀疏化引起的范数衰减,几乎零开销 |
| LoRA 补偿 | 低秩分支恢复高频细节 | R=64 即可,2k 步收敛,恢复头发/边缘/纹理 |
| 融合 CUDA 内核 | 在线稀疏化 + SpTC 执行一体化 | 稀疏开销 <10%,最高 1.88× Sparse GEMM 加速 |
| 正交性 | 与蒸馏/量化/缓存/稀疏注意力可叠加 | 所有组合均保持近无损质量 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 模型 | Qwen-Image, Qwen-Image-2512, FLUX.1-dev, Z-Image |
| 稀疏模式 | 2:4 半结构化 |
| LoRA rank | R = 64 |
| 训练数据 | 20k 用户请求 prompt-image 对 |
| 评估数据集 | MJHQ-30K (5k), sDCI (5k) |
| 硬件 | NVIDIA H20 GPU |
| CUDA | 13.0 |
| 指标 | FID↓, IR↑, CLIP-Score↑, CLIP-IQA↑ |
精度对比 (Qwen-Image)
| 方法 | MJHQ FID↓ | MJHQ IR↑ | sDCI FID↓ | sDCI IR↑ |
|---|---|---|---|---|
| Full (FP16) | 21.98 | 1.219 | 31.15 | 1.172 |
| Sparse Weight | 51.63 | -0.1605 | 66.91 | -0.2159 |
| Sparse Activation (原生) | 35.85 | 0.5994 | 48.59 | 0.4724 |
| Wanda | 40.81 | 0.5356 | 55.61 | 0.3245 |
| RIA | 43.02 | 0.4627 | 58.90 | 0.2325 |
| BaWA | 39.68 | 0.5888 | 54.54 | 0.3761 |
| Slim | 22.25 | 1.278 | 29.26 | 1.217 |
| RT-Lynx | 21.25 | 1.304 | 25.78 | 1.226 |
关键发现: RT-Lynx 甚至超越 FP16 原始模型(FID 21.25 vs 21.98),而所有权重稀疏方法都严重退化。
消融实验
| 方法 | Qwen-Image MJHQ FID↓ | sDCI FID↓ |
|---|---|---|
| Full | 21.98 | 31.15 |
| SA-Native | 35.85 | 48.59 |
| SA-NC (范数补偿) | 25.28 | 37.56 |
| SA-NC-LoRA | 21.25 | 25.78 |
逐步集成范数补偿 (NC) 和 LoRA 有效关闭性能差距。
跨模型泛化
| 模型 | Full FID | RT-Lynx FID | 方法 |
|---|---|---|---|
| Qwen-Image | 21.98 | 21.25 | SA-NC-LoRA |
| Qwen-Image-2512 | 20.45 | 20.84 | SA-NC-LoRA |
| FLUX.1-dev | 22.05 | 21.17 | SA-NC-LoRA-SL |
| Z-Image | 25.70 | 26.17 | SA-NC-LoRA-SL |
与其他加速方法的正交性
| 组合 | 方法 | 端到端加速 |
|---|---|---|
| 蒸馏 (Z-Image) | Turbo(step-8) | 9.91× |
| RT-Lynx+Turbo | 11.86× | |
| 量化 (Qwen-Image) | W8A8 | 1.11× |
| RT-Lynx+W8A8 | 1.32× | |
| 缓存 (FLUX.1-dev) | TeaCache | 2.64× |
| RT-Lynx+TeaCache | 3.13× | |
| 稀疏注意力 (Qwen-Image-2512) | SpargeAttn | 1.11× |
| RT-Lynx+SpargeAttn | 1.36× |
效率评估
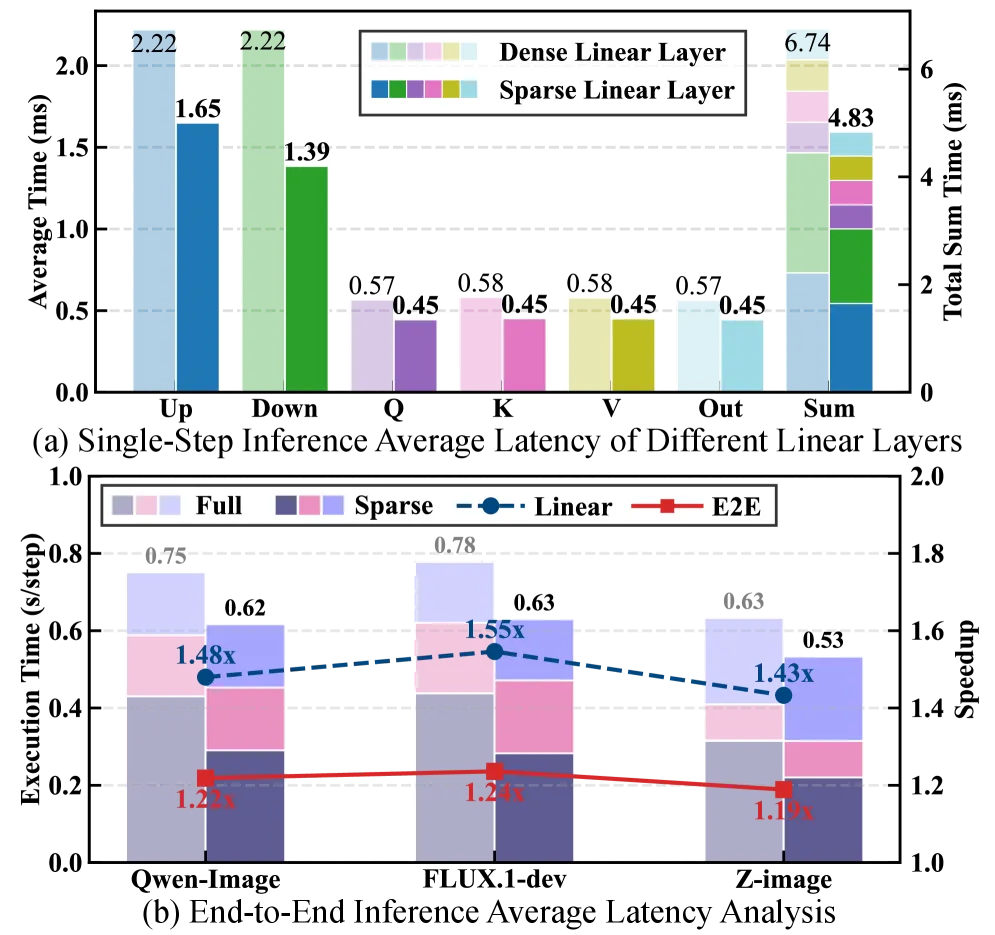
Figure 8: (a) Qwen-Image 中不同线性层类型的平均单步延迟。(b) 跨模型的全图像生成每步延迟,含时间分解。
Sparse GEMM 性能 (H20 GPU):
| M=N | K | PyTorch-GEMM | RT-Lynx-Kernel | 加速比 | 稀疏开销 |
|---|---|---|---|---|---|
| 2048 | 3072 | 0.199ms | 0.135ms | 1.47× | 8.33% |
| 4096 | 3072 | 0.781ms | 0.465ms | 1.68× | 4.60% |
| 8192 | 3072 | 2.994ms | 1.802ms | 1.66× | 2.28% |
| 4096 | 12288 | 3.099ms | 1.652ms | 1.88× | 4.83% |
| 8192 | 12288 | 11.95ms | 6.754ms | 1.77× | 2.37% |
端到端加速:
| 模型 | 原始延迟 | RT-Lynx 延迟 | 加速比 |
|---|---|---|---|
| Qwen-Image | 0.75s | 0.62s | 1.21× |
| FLUX.1-dev | 77.99s | 63.00s | 1.24× |
| Z-Image | 49.44s | 40.76s | 1.21× |
六、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| SparseGPT/Wanda | 权重稀疏化 SOTA,但 DiT 上严重退化 |
| Slim | 类似 LoRA 策略,但 R=0.1*d 导致推理开销高 |
| MaskLLM | 学习驱动的稀疏掩码,但针对 LLM |
| Amber | 使用 8:16 稀疏模式,当前 GPU 不支持 |
| SVDQuant | 4-bit 量化,RT-Lynx 与之正交可叠加 |
| TeaCache | 特征缓存加速,RT-Lynx 与之正交可叠加 |
| SpargeAttn | 稀疏注意力,RT-Lynx 与之正交可叠加 |
七、总结
核心贡献
- 范式转移: 发现 DiT 激活天然稀疏,提出从权重稀疏化到激活稀疏化的范式转移
- 范数补偿 + LoRA 适配: 结合 norm-based 补偿和 LoRA 适配,完全恢复稀疏化后的模型性能
- 即插即用稀疏推理流水线: 融合在线 N:M 稀疏化与 SpTC 执行,实现端到端加速
- 首次实现 DiT 无损 N:M 稀疏化: 在多个主流 DiT 模型上验证,线性层平均 1.55× 加速
技术影响
- 激活稀疏是 DiT 的正确稀疏化方向: 相比权重稀疏,激活稀疏更自然、更鲁棒
- 与所有主流加速方法正交: 可与蒸馏、量化、缓存、稀疏注意力无缝叠加
- 实际部署价值: 最高 11.86× 端到端加速(与蒸馏组合)
- 开源模型覆盖: 验证于 Qwen-Image, FLUX.1-dev, Z-Image 等主流架构
局限性
- 端到端加速约 1.2×,主要受限于非线性层(注意力等)
- 单流 DiT 架构需要额外的层跳过策略
- LoRA 微调需要 2k 步训练数据和计算资源
- 仅在 2:4 稀疏模式上验证
八、参考资源
- 论文: arXiv:2605.26632
- 主题: cs.CV (Computer Vision), cs.AI (Artificial Intelligence)
- 页数: 约 20 页, 19 图