The MiniMax-M2 Series: Mini Activations Unleashing Max Real-World Intelligence
MiniMax-M2系列:小型激活释放最大真实世界智能
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | The MiniMax-M2 Series: Mini Activations Unleashing Max Real-World Intelligence |
| 作者 | MiniMax (100+位作者) |
| 机构 | MiniMax |
| 论文 | https://arxiv.org/abs/2605.26494 |
| 发布 | 2026-05-26 |
| 页数 | 35页,10张图,4个表 |
核心亮点
- 229.9B总参数,9.8B激活参数的MoE语言模型
- 设计原则:mini activations can unleash maximum real-world intelligence
- 三大核心组件:agent驱动数据流水线、Forge RL系统、自我进化能力
- M2.7版本在agentic coding、deep search、reasoning等benchmark上达到前沿水平
二、核心思想
问题定义
大语言模型正在从短对话迁移到长程agentic工作流:编写和发布代码、浏览网页、操作工具、产生结构化办公产出。这带来两个挑战:
- 效率瓶颈:agentic任务的超长上下文在训练和推理中引入巨大的效率和成本瓶颈
- 复杂任务:真实世界部署需要解决高风险复杂任务,如生产级软件工程和知识密集型办公自动化
解决方案概述
MiniMax-M2系列围绕单一设计原则构建:mini activations can unleash maximum real-world intelligence。旗舰模型M2是62层decoder-only Transformer,229.9B总参数,每token仅激活9.8B参数。
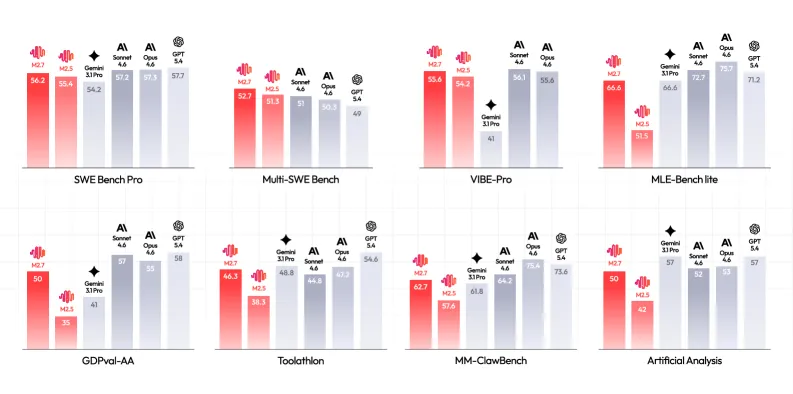
Figure 1: MiniMax-M2.7与闭源前沿基线在agentic coding、agentic cowork和reasoning & knowledge benchmark上的性能对比。M2.7仅用约10B激活参数,与更大计算量的系统保持竞争力。
三、技术架构
3.1 整体架构
M2是基于MoE架构的大规模稀疏语言模型:
| 参数 | 值 |
|---|---|
| 总参数 | 229.9B |
| 激活参数 | 9.8B/token |
| 层数 | 62层 decoder-only Transformer |
| 隐藏维度 | 3,072 |
| 词汇表大小 | 200,064 |
| 预训练token数 | 29.2T |
| 最大上下文长度 | 192K |
| 专家数量 | 256 fine-grained experts |
| 激活专家数 | 8/token |
| 注意力头数 | 48 query heads, 8 KV heads (GQA) |
| 位置编码 | RoPE |
每个Transformer块由multi-head self-attention模块和MoE feed-forward层组成。注意力采用full multi-head attention(所有层),使用GQA。MoE层包含256个fine-grained experts,每token激活8个专家,使用sigmoid gating和可学习的expert-specific bias terms。
3.2 MoE设计选择
Fine-Grained Experts:采用更多更小的expert设计,增加路由组合多样性,减少设备间expert利用率方差。
Sigmoid Gating:使用sigmoid门控替代softmax,配合可学习的expert-specific bias terms,改善负载均衡,大幅减少对auxiliary losses的依赖。
消融实验(Table 1):
| 配置 | Baseline | w/ MTP | w/ Fine-Grained |
|---|---|---|---|
| 激活参数 | 2B | 2B | 2B |
| 总参数 | 17.8B | 17.8B | 17.8B |
| 训练token | 500B | 500B | 500B |
| num_experts | 32 | 32 | 128 |
| topk | 2 | 2 | 8 |
Fine-Grained Experts在MATH、MMLU、ARC-Challenge、KorBench、HumanEval上均优于baseline。
3.3 注意力机制
M2采用full multi-head attention(所有层),而非hybrid SWA(滑动窗口注意力)。消融实验(Table 2)表明full attention在pretraining评估中优于hybrid SWA。
3.4 Multi-Token Prediction (MTP)
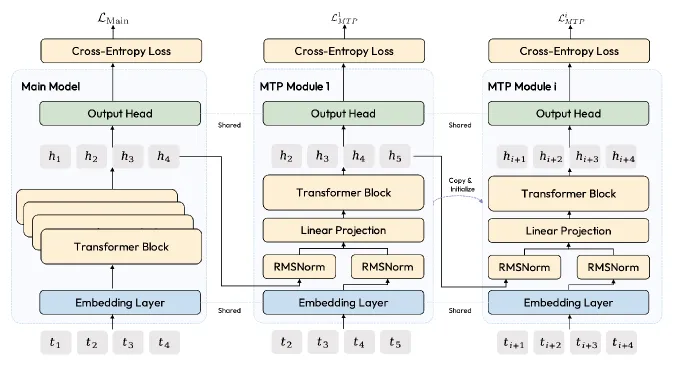
Figure 2: M2中使用的Multi-Token Prediction (MTP)模块架构。
MTP模块在预训练时预测多个未来token,在推理时可扩展为多步speculative decoding的draft path,加速推理。消融实验(Table 1)显示MTP在各benchmark上均有提升。
3.5 预训练数据
- 数据来源:网页文档、学术文献、书籍、编程代码、结构化问答内容
- 数据分布:代码、数学和STEM内容显著上采样
- 长上下文扩展:多阶段训练,从8K → 32K → 192K tokens,衰减阶段使用9.3T tokens
四、Post-Training数据收集
4.1 Agentic Coding
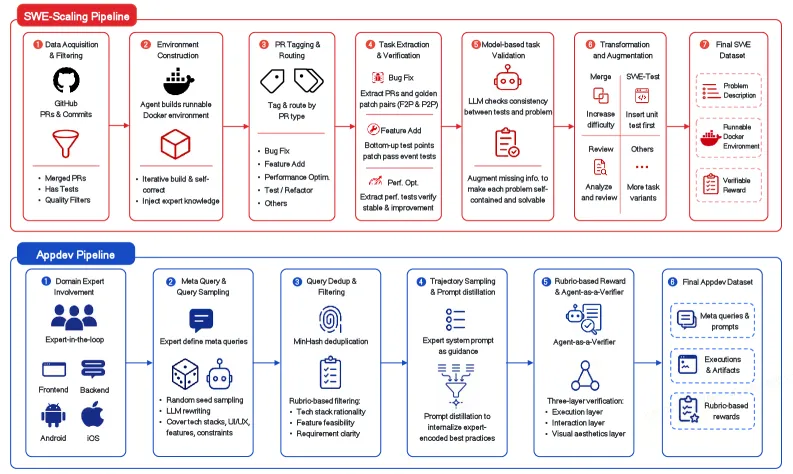
Figure 3: SWE和AppDev任务的agentic coding数据流水线。
三个子领域:
- Software Engineering (SWE):真实数据驱动收集,从GitHub issues收集真实软件工程任务
- Application Development (AppDev):专家驱动数据收集,由人类专家设计应用开发任务
- Terminal-Gym:自动化任务合成和环境生成
4.2 Agentic Cowork
- Deep Search和Open-Web Research:网页浏览和信息检索任务
- Knowledge-Worker Office Tasks:知识工作者办公任务
- Financial Analysis:金融分析和电子表格操作
- Slide Generation:幻灯片生成和编辑
4.3 Reasoning-Intensive Tasks
推理密集型任务,包括数学、科学推理等。
4.4 General-Purpose Conversation and Writing
通用对话和写作任务。
4.5 Role-Play and Persona Coherence
角色扮演和人格一致性任务。
五、Supervised Fine-Tuning (SFT)
SFT阶段使用收集的高质量数据进行监督微调,覆盖agentic coding、cowork、reasoning等所有能力领域。
六、Reinforcement Learning (RL)
6.1 Forge RL系统
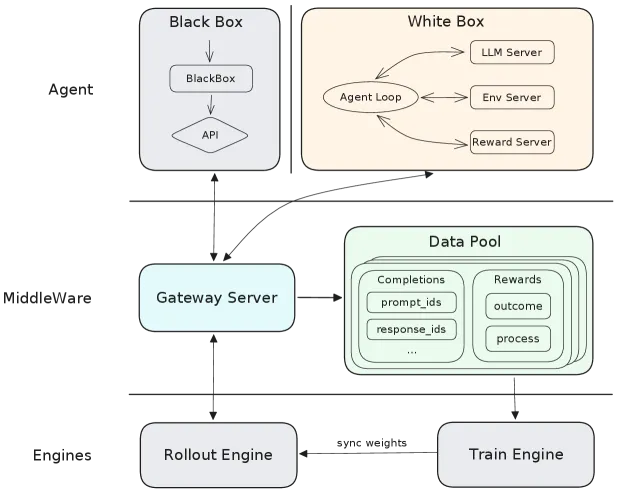
Figure 4: Forge RL系统概述。三个解耦模块——Agent Side、Training/Inference Side和中间件抽象层(Gateway Server, Data Pool)——通过标准化接口通信,允许agent和训练循环独立扩展。
核心设计原则:将LLM作为policy,模型生成过程之外的所有内容(上下文管理、内存访问、agent状态转换)视为环境。这种分离提供了清晰的抽象。
MDP建模:
在每步,agent观察状态(包含当前上下文窗口内容),生成动作(文本或tool-call token序列),环境返回下一个状态。
6.2 RL算法:CISPO
采用Clipped Importance Sampling Policy Optimization (CISPO):
其中是重要性采样比率。
非对称裁剪:上界防止策略更新过大,下界0允许积极降低不probable动作的权重。
6.3 奖励设计
复合奖励框架包含三个组件:
- Outcome Reward:基于最终结果的奖励
- Process Reward:密集的中间奖励,针对特定行为模式(语言混合惩罚、工具调用格式错误惩罚、结构化推理步骤奖励)
- Credit Assignment:在span达192K tokens、数千中间动作的agent轨迹中进行信用分配
6.4 Windowed FIFO调度
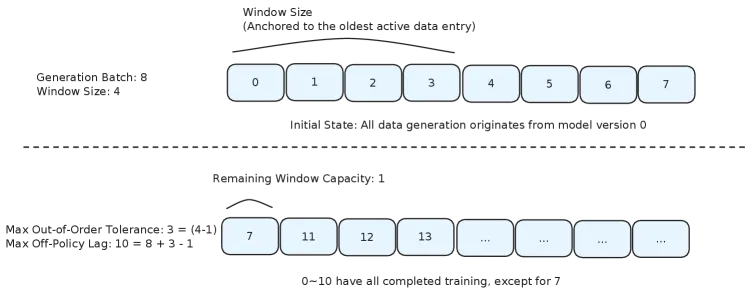
Figure 5: Windowed FIFO调度。训练调度器仅获取生成队列中大小为的滑动窗口内已完成的轨迹:窗口内完成顺序自由(缓解队头阻塞);跨窗口边界强制FIFO(保持分布一致性)。
6.5 Prefix Tree合并
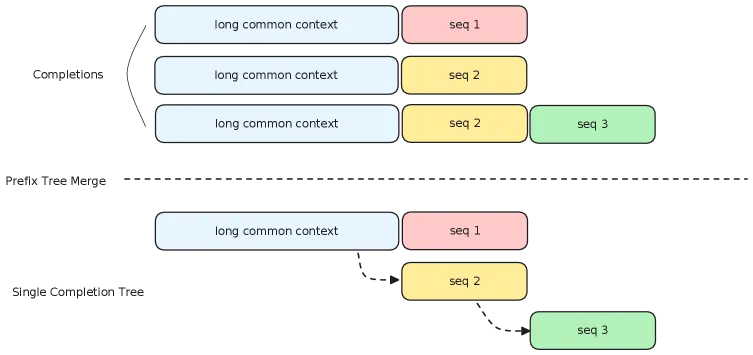
Figure 6: Prefix tree合并。共享前缀的完成在训练batch中合并为树;共享前缀仅计算一次,计算分支到各个响应段。在loss计算前解构树,过程数学等价于独立样本训练,同时消除冗余前缀重计算。
6.6 白盒和黑盒Agent支持
Forge支持白盒(可访问模型权重)和黑盒(仅API)agent在同一训练循环中训练。
七、Agentic机制
7.1 交错思考 (Interleaved Thinking)
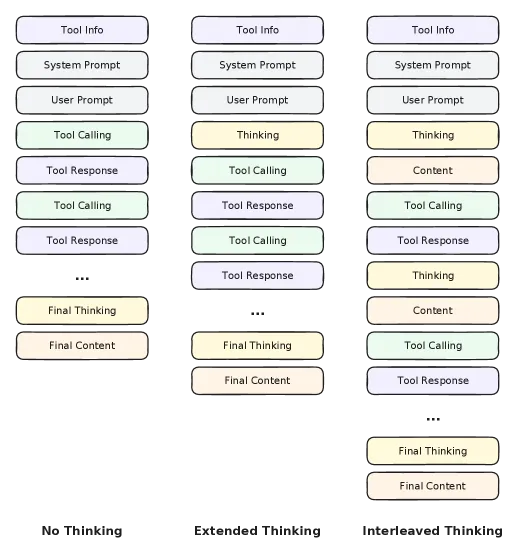
Figure 7: M2中交错思考的Plan-Act-Reflect循环。
交错chain-of-thought:模型在每个turn交替产生推理token 和动作token :
其中是执行动作后返回的观察(工具输出)。每个推理段以完整历史为条件。
推理状态持久化:关键架构决策是将turn 的完整模型输出(包括所有thinking blocks)追加到消息历史中,作为turn 的上下文:
Plan-Act-Reflect循环:在每个turn执行结构化认知循环:
- Plan:回顾先前推理和观察的累积状态,制定或调整策略
- Act:选择并执行基于计划的工具调用
- Reflect:评估观察是否符合预期,更新世界模型
7.2 自我进化 (Self-Evolution)
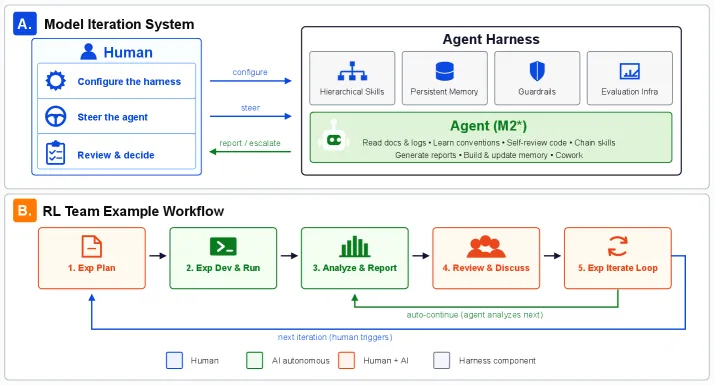
Figure 8: (A) 驱动M2.7自主执行的模型迭代系统。(B) RL团队使用的双循环工作流。
M2.7展示了自我进化的早期操作形式:模型自主诊断失败的训练运行,编辑自己的agent scaffold,并在代表性ML-engineering任务上运行多轮自我改进。
模型迭代系统原则:人类引导,模型构建。研究者配置目标、通过聊天引导agent、审查输出决定下一步。agent在”Agent Harness”中运行——工作空间完全由内部M2.7模型生成,零人类编写代码。
双循环工作流:M2.7进入自主执行阶段,分析运行日志、诊断指标异常。通过自动调试代码和调整配置,模型直接干预训练循环,吸收30%到50%的日常迭代工作量。
八、评估结果
8.1 能力演进
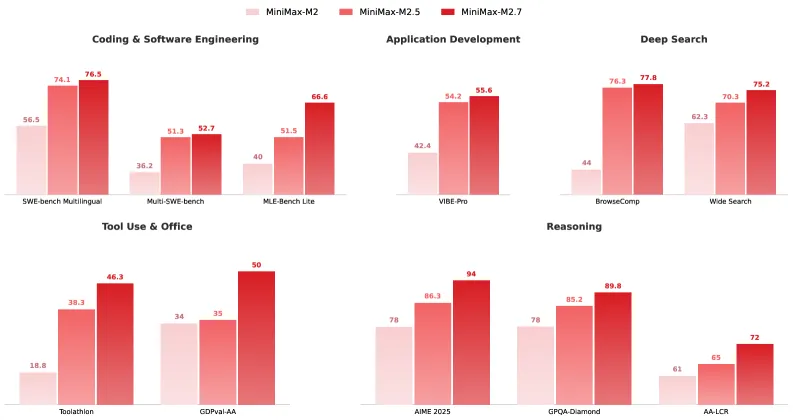
Figure 9: MiniMax-M2系列在11个benchmark上的能力演进。每个面板按能力领域分组benchmark,每个benchmark三个bar对应M2、M2.5和M2.7。所有11个benchmark在三个checkpoint上持续改进。
8.2 主要结果 (Table 4)
| 类别 | Benchmark | M2.7 | M2.5 | Opus 4.6 | Sonnet 4.6 | GPT 5.4 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|---|
| Coding Agent | SWE-bench Pro | 56.2 | 55.4 | 57.3 | 57.2 | 57.7 | 54.2 |
| SWE-bench Multilingual | 76.5 | 74.1 | 77.8 | 75.9 | 70.5 | – | |
| Multi-SWE-bench | 52.7 | 51.3 | 50.3 | 51.0 | 49.0 | – | |
| NL2Repo | 39.8 | 26.6 | 43.7 | 43.3 | 46.8 | 35.9 | |
| Terminal-Bench 2.0 | 57.0 | 51.7 | 65.4 | 59.1 | 75.1 | 68.5 | |
| MLE Bench Lite | 66.6 | 51.5 | 75.7 | 72.7 | 71.2 | 66.6 | |
| App Dev | VIBE-Pro | 55.6 | 54.2 | 55.6 | 56.1 | – | 41.0 |
| HyperTask | 67.6 | 59.4 | 75.7 | 74.1 | – | 50.9 | |
| Search | BrowseComp | 77.8 | 76.3 | 84.0 | 74.7 | 82.7 | 85.9 |
| Wide Search | 75.2 | 70.3 | 79.4 | 75.8 | 77.9 | – | |
| RISE | 64.3 | 50.2 | 68.5 | 58.8 | 63.3 | – | |
| Office & Tools | GDPval-AA | 50.0 | 35.0 | 55.0 | 57.0 | 58.0 | 41.0 |
| Toolathlon | 46.3 | 38.3 | 47.2 | 44.8 | 54.6 | 48.8 | |
| MM Claw | 62.7 | 57.6 | 75.4 | 64.2 | 73.6 | 61.8 | |
| MEWC v2 | 63.3 | 49.8 | 62.0 | 77.2 | 76.5 | 42.2 | |
| Finance Modeling Pro | 57.0 | 33.8 | 69.0 | 66.2 | 75.3 | 35.6 | |
| Reasoning | AIME 2026 | 94.2 | 87.2 | 92.5 | 92.7 | 97.0 | 88.7 |
| GPQA-Diamond | 89.8 | 85.2 | 89.6 | 87.5 | 92.0 | 94.1 | |
| SciCode | 47.0 | 43.0 | 51.9 | 46.8 | 56.6 | 58.9 | |
| IFBench | 76.0 | 72.0 | 53.1 | 56.6 | 73.9 | 77.1 | |
| AA-LCR | 72.0 | 65.0 | 70.7 | 70.7 | 74.0 | 72.7 | |
| HLE | 28.0 | 19.0 | 36.7 | 30.0 | 41.6 | 44.7 | |
| MMLU-Pro | 81.8 | 85.2 | 89.1 | 87.3 | 87.5 | 91.2 |
关键结果:
- AIME 2026: 94.2(超越Opus 4.6的92.5和Sonnet 4.6的92.7)
- GPQA-Diamond: 89.8(接近Opus 4.6的89.6)
- IFBench: 76.0(超越所有闭源模型)
- SWE-bench Pro: 56.2(接近前沿水平)
- BrowseComp: 77.8(competitive with GPT 5.4的82.7)
8.3 自我进化案例:MLE Bench Lite
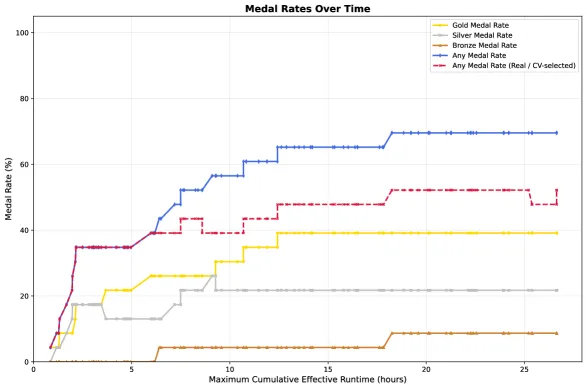
Figure 10: M2.7在MLE Bench Lite上迭代试验的奖牌率。
M2.7在MLE Bench Lite上达到66.6%的奖牌率,展示了自我进化能力的有效性。通过多轮迭代,模型能够自主调试和改进其在ML-engineering任务上的表现。
九、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| Fine-Grained MoE | 256个fine-grained experts,sigmoid gating | 229.9B参数,仅9.8B激活 |
| Forge RL系统 | agent-native RL,白盒+黑盒支持 | 稳定的RL-time scaling |
| Windowed FIFO调度 | 滑动窗口内自由顺序,跨窗口FIFO | 吸收轨迹长度方差 |
| Prefix Tree合并 | 共享前缀仅计算一次 | 消除冗余计算 |
| 交错思考 | Plan-Act-Reflect循环 | 多步推理能力提升 |
| 自我进化 | 模型自主调试和改进训练 | 30-50%日常迭代自动化 |
| CISPO算法 | 非对称裁剪重要性采样 | 稳定策略优化 |
十、相关工作
| 模型 | 总参数 | 激活参数 | 特点 |
|---|---|---|---|
| MiniMax-M2.7 | 229.9B | 9.8B | MoE, Agent RL, Self-evolution |
| Claude Opus 4.6 | – | – | 闭源前沿 |
| GPT 5.4 | – | – | 闭源前沿 |
| Gemini 3.1 Pro | – | – | 闭源前沿 |
| DeepSeek V3 | 671B | 37B | MoE, 长上下文 |
| Qwen3.5-397B | 397B | – | Dense, 多语言 |
十一、总结
核心贡献
- 高效MoE架构:229.9B总参数,仅9.8B激活,实现mini activations释放max intelligence
- Forge RL系统:首个支持白盒和黑盒agent的统一RL训练系统
- 交错思考机制:Plan-Act-Reflect循环,推理状态持久化
- 自我进化能力:M2.7自主调试训练运行,编辑自身scaffold
- 完整的agentic数据流水线:覆盖coding、cowork、reasoning等领域
技术影响
- 效率:仅9.8B激活参数达到接近闭源前沿模型的性能
- 可扩展性:Forge RL系统支持独立扩展agent和训练循环
- 实用性:自我进化减少30-50%的人工迭代工作量
- 开放性:详细披露架构设计、训练细节和评估结果
局限性
- 在部分benchmark上仍落后于最强闭源模型(如Terminal-Bench、MLE Bench)
- 自我进化能力仍处于早期阶段
- 训练需要大规模计算资源
- 部分benchmark数据可能包含在预训练语料中
十二、参考资源
- 论文: https://arxiv.org/abs/2605.26494
- MiniMax官网: https://www.minimaxi.com