Fine-Tuning and Serving Gemma 4 31B on Google Cloud TPU: A Technical Comparison with GPU Baselines
End-to-end TPU migration for Gemma 4 31B: 1.61× faster training at 2.12× lower cost, with 66% higher long-context inference throughput
Fine-Tuning and Serving Gemma 4 31B on Google Cloud TPU: A Technical Comparison with GPU Baselines
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fine-Tuning and Serving Gemma 4 31B on Google Cloud TPU: A Technical Comparison with GPU Baselines |
| 作者 | Jatin Kishnani, Mayank Goel, Amit Singh, Pulkit Agrawal, Sairanjan Mishra |
| 论文 | https://arxiv.org/abs/2605.25645 |
| 代码 | https://github.com/h2loop/gemma-tpu |
| 模型 | https://huggingface.co/google/gemma-4-31B |
| 发布 | 2026-05-25 (v1→v3) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
LLM 的微调和推理主要在 GPU 平台上进行(PyTorch + HuggingFace TRL + FSDP),但 TPU 在大规模并行计算和互连带宽方面具有独特优势。将 GPU 原生的训练/推理管线迁移到 TPU 面临一系列工程挑战:
- JAX/Tunix 与 PyTorch/TRL 的框架差异
- Mesh 配置和 sharding annotation 修正
- LoRA 模块命名约定变化(特别是
kv_einsum融合) - Orbax checkpoint 到 safetensors 的自定义合并流程
解决方案概述
本文是第一篇端到端展示在 TPU 上微调和部署 Gemma 4 31B 的工作,系统记录了从 GPU 原生管线(PyTorch + HuggingFace TRL + FSDP)迁移到 JAX + Tunix/Qwix 栈所需的全部代码级适配,并提供了 TPU 与 GPU 平台的实证比较。
任务:Verilog 代码生成(CodeV-R1 数据集,10K 样本),在 NVlabs/verilog-eval benchmark(156 个 spec-to-RTL 问题)上评估。
三、技术架构
硬件配置对比
训练硬件:
| 规格 | TPU v5p-8 | GPU a3-highgpu-2g |
|---|---|---|
| 加速器 | 4× TPU v5p chips | 2× NVIDIA H100 80GB |
| 每芯片 HBM | 102.8 GB | 80 GB |
| 总 HBM | 411.2 GB | 160 GB |
| 主机 RAM | ~355 GB | ~468 GB |
| 互连 | ICI | NVLink |
| 每小时费率 | $16.80/hr | $22.12/hr |
推理硬件:
| 规格 | TPU v6e-8 (Trillium) | GPU a3-highgpu-2g |
|---|---|---|
| 加速器 | 8× TPU v6e chips | 2× NVIDIA H100 80GB |
| 总 HBM | 250 GB | 160 GB |
| Tensor Parallelism | tp=8 | tp=2 |
| 每小时费率 | $21.52/hr | $22.12/hr |
训练配置(两者相同)
| 参数 | 值 |
|---|---|
| 优化器步数 | 1,244 steps |
| Batch size | 8 |
| 序列长度 | 4,096 |
| 数据集 | 10K CodeV-R1 samples (1 epoch) |
| LoRA | rank=64, alpha=64 |
| LR Schedule | AdamW cosine decay, peak 1e-4, 100 warmup |
关键工程适配
1. Device Mesh 配置
JAX 需要显式 2D mesh。v5p-8 暴露 4 个 JAX devices(8 TensorCores / 2)。Mesh 为 (fsdp=1, tp=4)。约束条件是 num_global_key_value_heads=4——只有 tp=4 有效,不是 tp=8。
2. LoRA 模块命名映射
Tunix JAX 重命名了 HF PyTorch 模块,最关键的变化是 kv_einsum——将 K 和 V 投影融合为单个张量 (in, 2, n_kv_heads, head_dim)。
3. Sharding Annotation 修正
Qwix 的 LoRA 注入继承了原始权重的 PartitionSpec,但 LoRA 因子有不同的 rank。修复方案:将不匹配的 PartitionSpec 重置为完全复制,加上可整除性检查。
4. XLA Compiler Flags
xla_llvm_disable_expensive_passes 将编译时间从 ~8 分钟降到 ~3 分钟(牺牲 2-5% 运行时吞吐)。
5. Data Pipeline
将 HuggingFace DataLoader 替换为 Google 的 Grain 库,实现自定义 loss masking(仅 assistant tokens)和 reasoning strip(移除 xml... 块,仅保留 ```verilog 围栏)。
6. Gradient Checkpointing
Tunix 通过 nnx.remat 在 decoder 层粒度暴露。等价于 HF 的 activation_checkpointing=True。
Checkpoint 转换流程
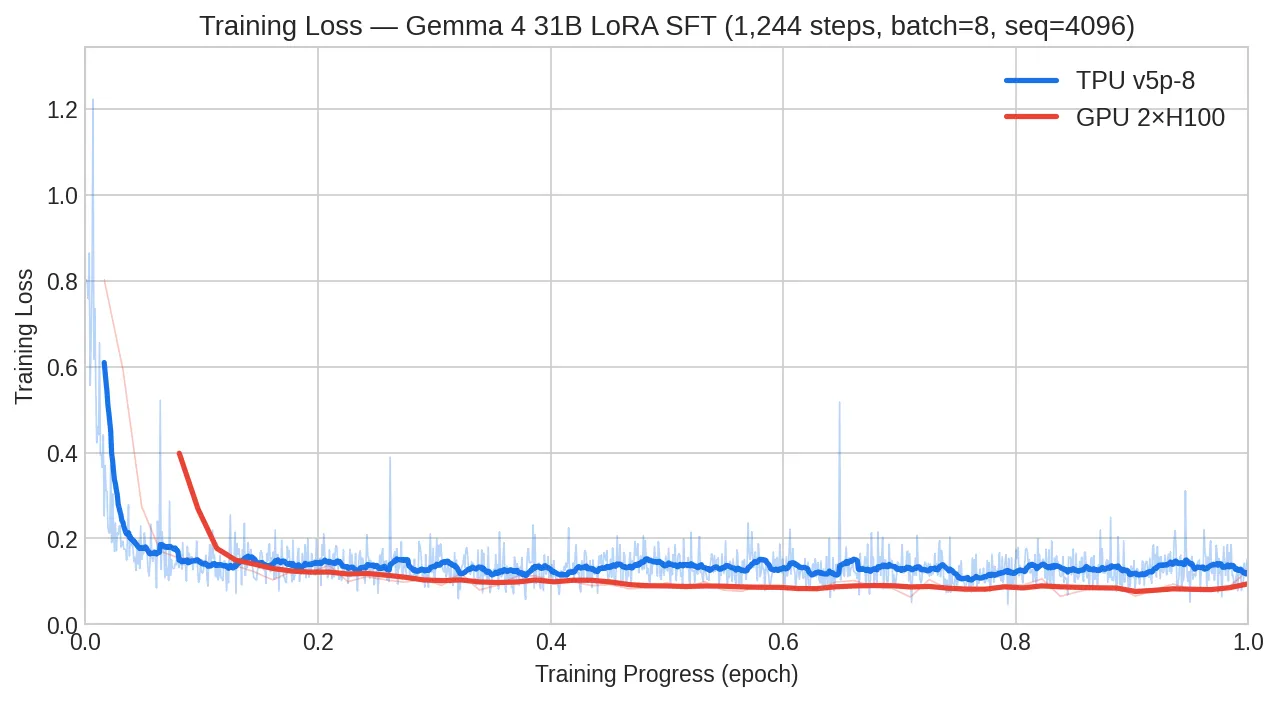
自定义 orbax_to_peft.py 执行:
- 将 base model 加载到 JAX mesh
- 通过 Qwix 注入 LoRA + dummy inputs
- 恢复 Orbax checkpoint LoRA params
- 收集每模块的 lora_a/lora_b 对
- 应用 LoRA delta:
W_merged = W_base + (alpha/r) * A*B^T - 保存为单个
model.safetensors文件
关键挑战:kv_einsum 映射到 TWO safetensors keys(独立的 K 和 V)。所有 deltas 转置以匹配 HuggingFace 约定(out, in)。
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 完整 TPU 迁移记录 | 文档化了 GPU→TPU 迁移的所有代码级适配 | 6 个关键适配领域 |
| Orbax→Safetensors 转换 | 自定义 checkpoint 合并流程 | orbax_to_peft.py |
| TPU vs GPU 实证比较 | 训练和推理的全面对比 | 11 张表,6 张图 |
| vLLM-TPU Docker 部署 | 详述 TPU 上 vLLM 推理设置 | 三大挑战:Docker-only、XLA 编译、HBM 分配 |
五、实验结果
训练性能对比
| 指标 | TPU v5p-8 | GPU 2×H100 | 胜出 |
|---|---|---|---|
| 墙钟时间 | 3.34 hr | 5.39 hr | TPU (1.61× 更快) |
| 吞吐量 | 763 tok/s | 486 tok/s | TPU (1.57× 更快) |
| 每样本时间 | 1.21 s | 1.94 s | TPU (1.60× 更快) |
| 最终 loss | 0.072 | 2.258 | TPU |
| 总成本 | $56.11 | $119.23 | TPU (2.12× 更便宜) |
| 成本/百万 token | $6.10 | $12.68 | TPU (2.08× 更便宜) |
TPU 更快的原因
- 聚合 HBM 带宽:11.06 TB/s (TPU) vs 6.7 TB/s (GPU)
- ICI 互连:TPU 芯片间 900 GB/s 双向
- XLA fusion:前向+后向编译为单层融合 kernel
- GPU 无 torch.compile:因异构注意力层而禁用
评估结果(Verilog Code Generation)
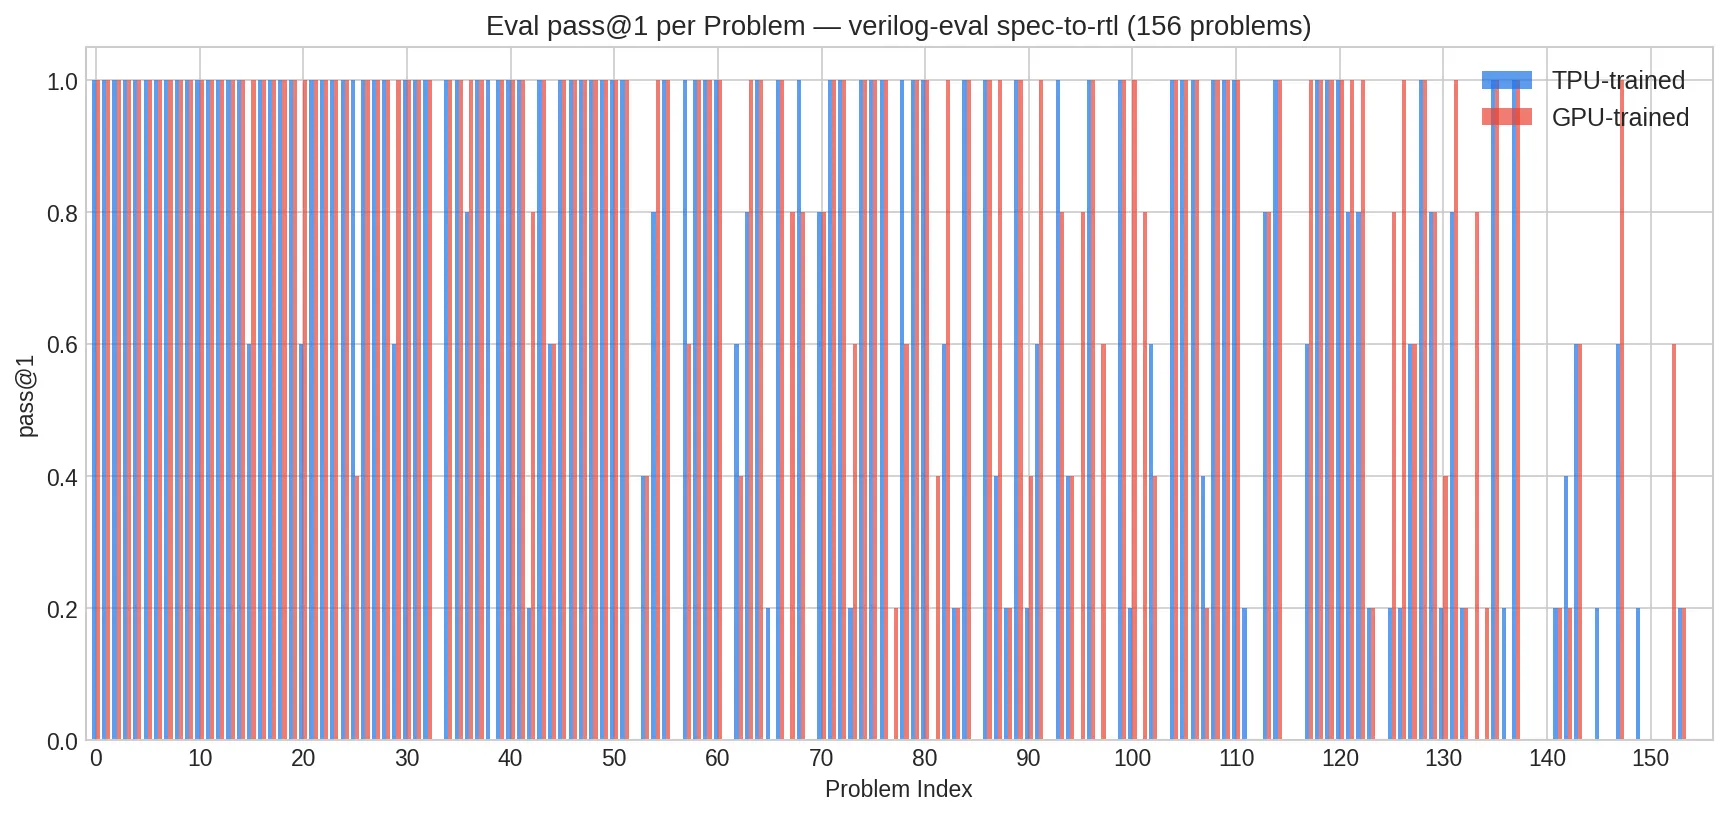
| 指标 | TPU-trained | GPU-trained |
|---|---|---|
| pass@1 | 0.6410 | 0.6974 |
| pass@5 | 0.7949 | 0.8141 |
GPU-trained 模型在评估质量上略优(归因于 loss 计算差异,而非硬件)。
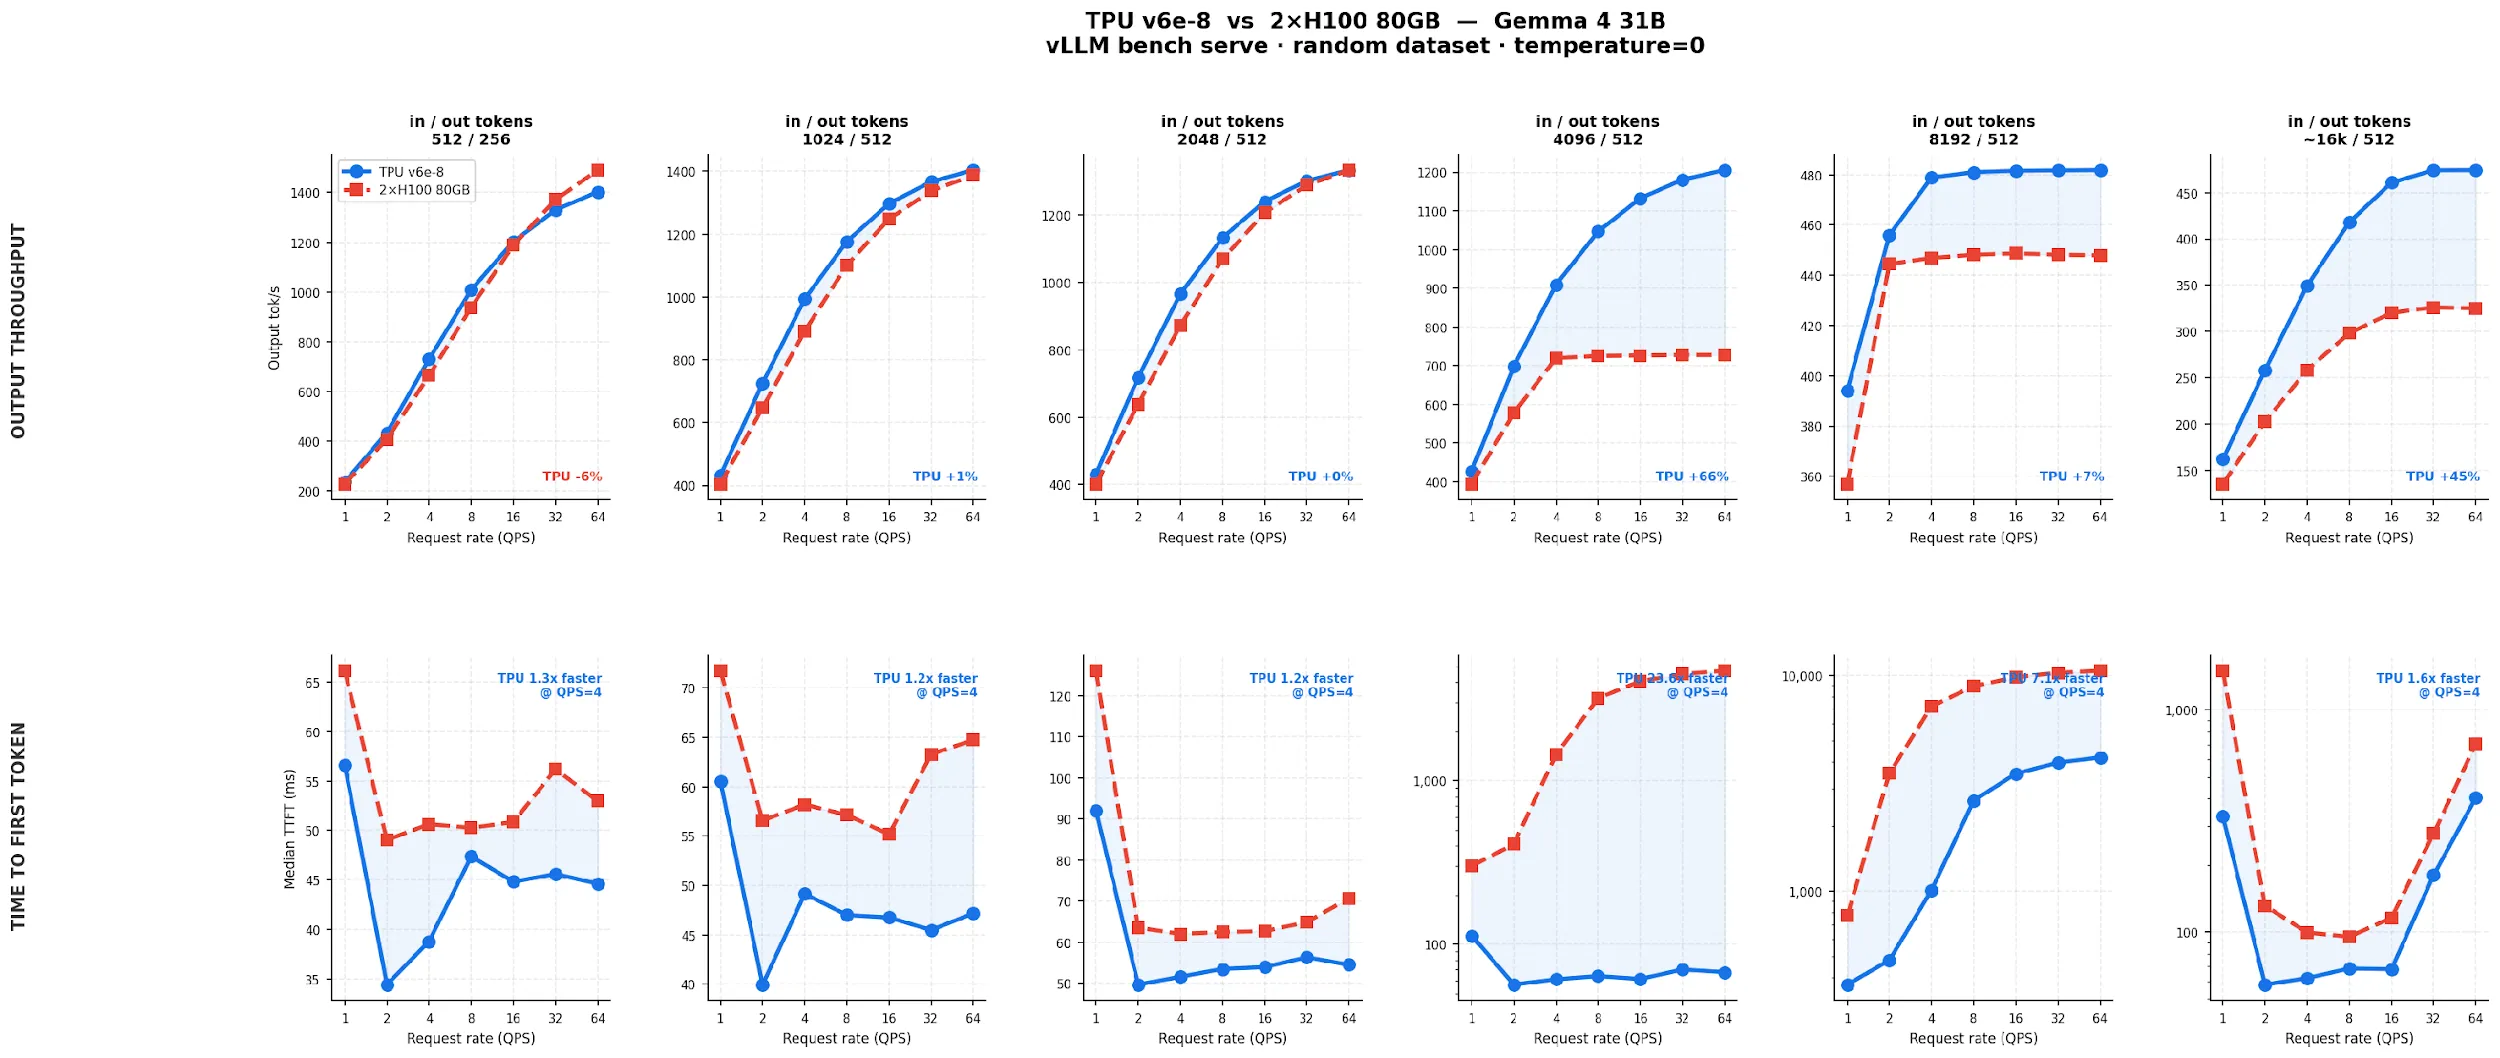
推理性能对比
| 上下文长度 | 指标 | TPU v6e-8 | GPU 2×H100 | 胜出 |
|---|---|---|---|---|
| 短 (512/256) | Peak throughput | 1,403 tok/s | 1,490 tok/s | GPU (+6%) |
| 短 | Median TTFT | 45 ms | 51 ms | TPU (1.1×) |
| 中 (1024/512) | Peak throughput | 1,404 tok/s | 1,387 tok/s | TPU (+1%) |
| 中 | TTFT @ QPS=4 | 49 ms | 58 ms | TPU (1.2×) |
| 中 | QPS 饱和点 | ~32 | ~8 | TPU (4×) |
| 长 (4096/512) | Peak throughput | 1,206 tok/s | 728 tok/s | TPU (+66%) |
| 长 (4096/512) | TTFT @ QPS=4 | 61 ms | 1,443 ms | TPU (23.6×) |
| 长 | TPOT | 23.9 ms | 31.2 ms | TPU (1.3×) |
| 超长 (8192/512) | Peak throughput | 482 tok/s | 449 tok/s | TPU (+7%) |
| 超长 | TTFT @ QPS=4 | 1,013 ms | 7,202 ms | TPU (7.1×) |
| 最大 (~16k/512) | Peak throughput | 474 tok/s | 326 tok/s | TPU (+45%) |
| 最大 | TPOT | 13.5 ms | 19 ms | TPU (1.4×) |
关键推理差异:
- TPU 使用
fp8_e5m2KV cache dtype(vs GPUbfloat16)→ 2× KV 容量 - TPU 使用 tp=8(vs GPU tp=2)
推理成本对比
| 工作负载 | TPU $/1M tok | GPU $/1M tok |
|---|---|---|
| 短 (≤2048 tokens) | $4.27 | $4.13 |
| 长 (4096 tokens) | $4.95 | $8.44 |
总拥有成本 (TCO)
| 场景 | TPU | GPU |
|---|---|---|
| 训练 + 1hr 推理 | $77.63 | $141.35 |
| 训练 + 8hr 推理 | $228.27 | $296.19 |
| 训练 + 24hr 推理 | $572.59 | $650.11 |
推理成本对比图
总结对比
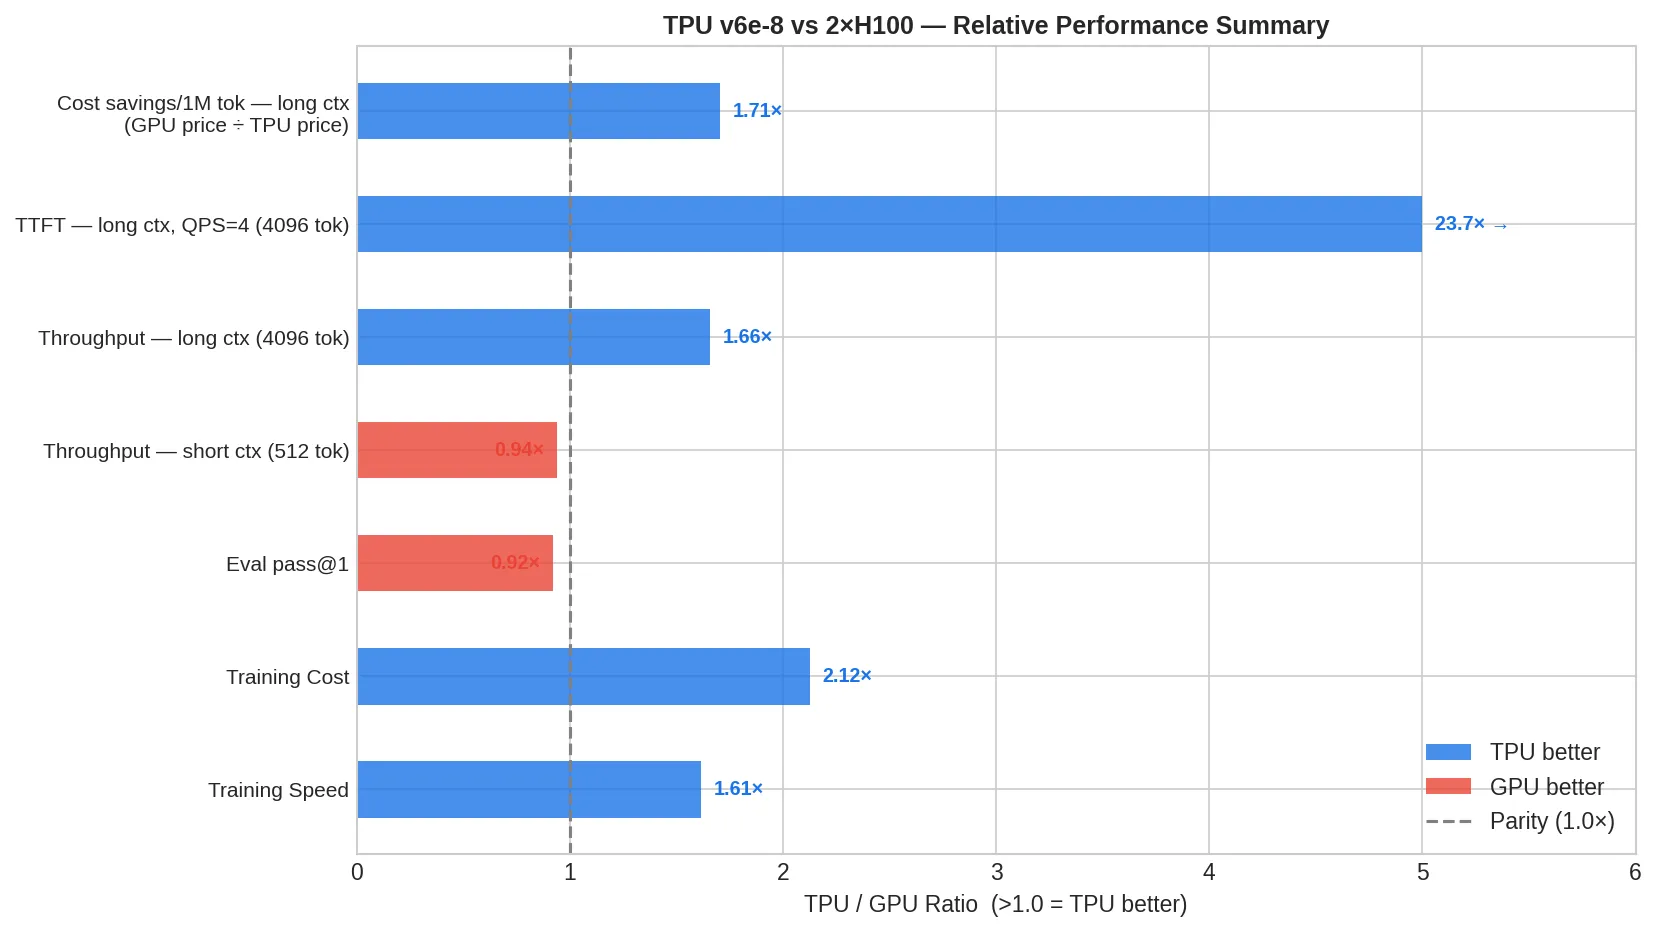
六、TPU vs GPU 优劣势总结
TPU 优势
- 训练速度 1.61× 更快
- 训练成本 2.12× 更低
- 长上下文推理吞吐 66% 更高
- 长上下文 TTFT 23.6× 更快
- 聚合 HBM 带宽更高(11.06 vs 6.7 TB/s)
- ICI 互连带宽优势(900 GB/s)
- fp8_e5m2 KV cache → 2× KV 容量
GPU 优势
- 短上下文吞吐略高(+6%)
- 生态成熟度(PyTorch/TRL/FSDP)
- 评估质量略优(pass@1: 0.697 vs 0.641)
- 更广泛的工具链支持
七、总结
核心贡献
- 首个 Gemma 4 31B TPU 端到端工作:从训练到推理的完整迁移记录
- GPU→TPU 代码级适配文档:mesh 配置、LoRA 命名、sharding 修正、gradient checkpoint、data pipeline、checkpoint 转换
- 全面的 TPU vs GPU 实证比较:训练 1.61× 更快/2.12× 更便宜,推理长上下文 66% 更高吞吐/23.6× 更快 TTFT
- vLLM-TPU 部署指南:Docker-only 部署、XLA 编译、HBM 分配三大挑战的解决方案
- 可复现代码:https://github.com/h2loop/gemma-tpu
技术影响
- 为 GPU 原生 LLM 管线迁移到 TPU 提供了实用指南
- 证明了 TPU 在长上下文推理中的显著优势(fp8 KV cache + tp=8)
- 为云提供商的硬件选择提供了实证依据
八、参考资源
- arXiv: https://arxiv.org/abs/2605.25645
- GitHub: https://github.com/h2loop/gemma-tpu
- HuggingFace: https://huggingface.co/google/gemma-4-31B
- Eval Benchmark: https://github.com/NVlabs/verilog-eval
- License: CC BY 4.0
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 训练 loss 曲线 | training-loss.png |
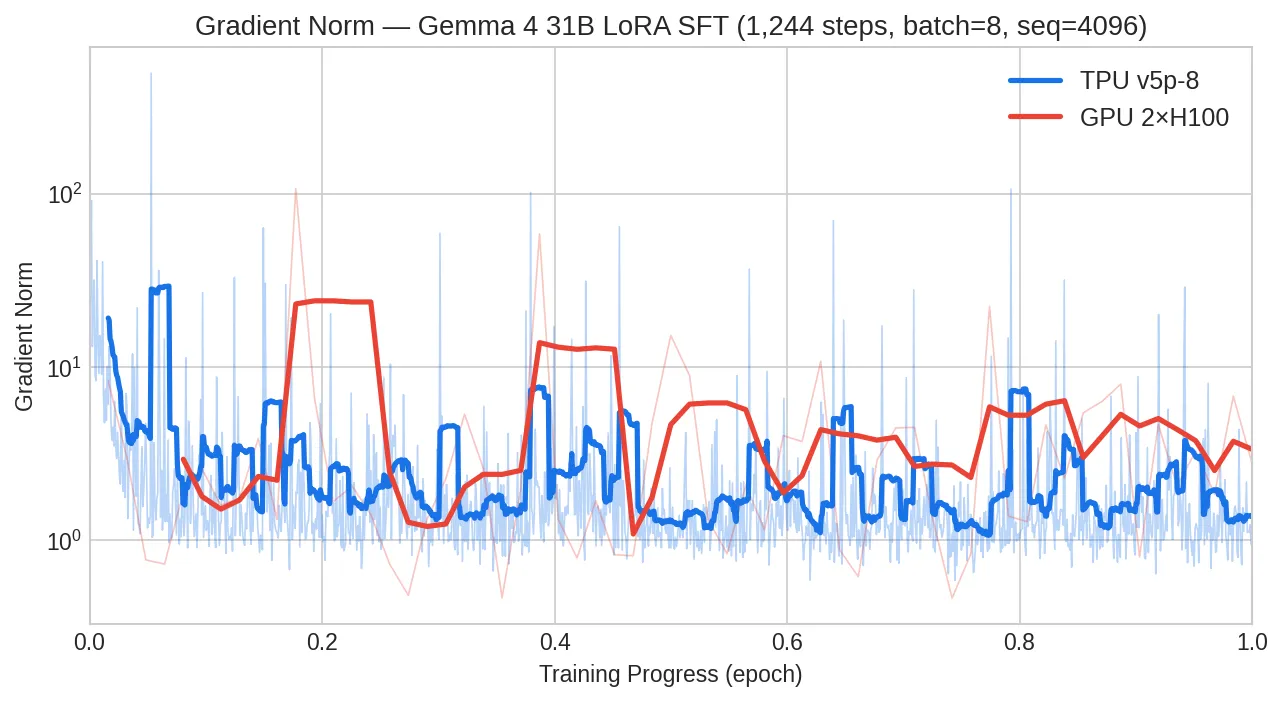
| Figure 2 | 梯度范数对比 | gradient-norm.png |
| Figure 3 | 每问题 pass@1 对比 | eval-pass1.png |
| Figure 5 | 推理成本对比 | inference-cost.png |
| Figure 6 | 总结对比 | summary.png |