Polar: Agentic RL on Any Harness at Scale
Polar:在任意Agent Harness上规模化进行Agentic RL训练
Polar: Agentic RL on Any Harness at Scale
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Polar: Agentic RL on Any Harness at Scale |
| 作者 | Binfeng Xu, Hao Zhang, Shaokun Zhang, Songyang Han, Mingjie Liu, Jian Hu, Shizhe Diao, Zhenghui Jin, Yunheng Zou, Michael Demoret, Jan Kautz, Yi Dong |
| 机构 | NVIDIA |
| 论文 | https://arxiv.org/abs/2605.24220 |
| 发布 | 2026-05-22 |
| 页数 | 17页,6图,4表 |
核心亮点
- Proxy-based rollout:通过代理LLM API调用来捕获token级数据,无需修改agent harness
- Agent harness无关:将agent视为黑盒,通过model API boundary进行训练
- 异步rollout staging:分离runtime初始化、agent执行、轨迹重建和评估
- Prefix merging:智能轨迹重建策略,5.39x加速
二、核心思想
问题定义
强化学习在语言agent中的应用越来越依赖于自定义harness来管理长上下文、多轮工具使用和多agent编排。然而,将这些harness移植到RL环境接口中仍然困难,且常常丢失重要的训练信号。
关键问题:Can we train agents with RL without opening the box?
即:不触碰agent harness或强制它们符合RL框架,能否用RL训练agent?
解决方案概述
Polar的核心观察是:虽然agent在内部实现上差异很大,但每个基于LLM的agent都必须与模型通信。这个model API boundary提供了一个存在于agent之外的公共接口。
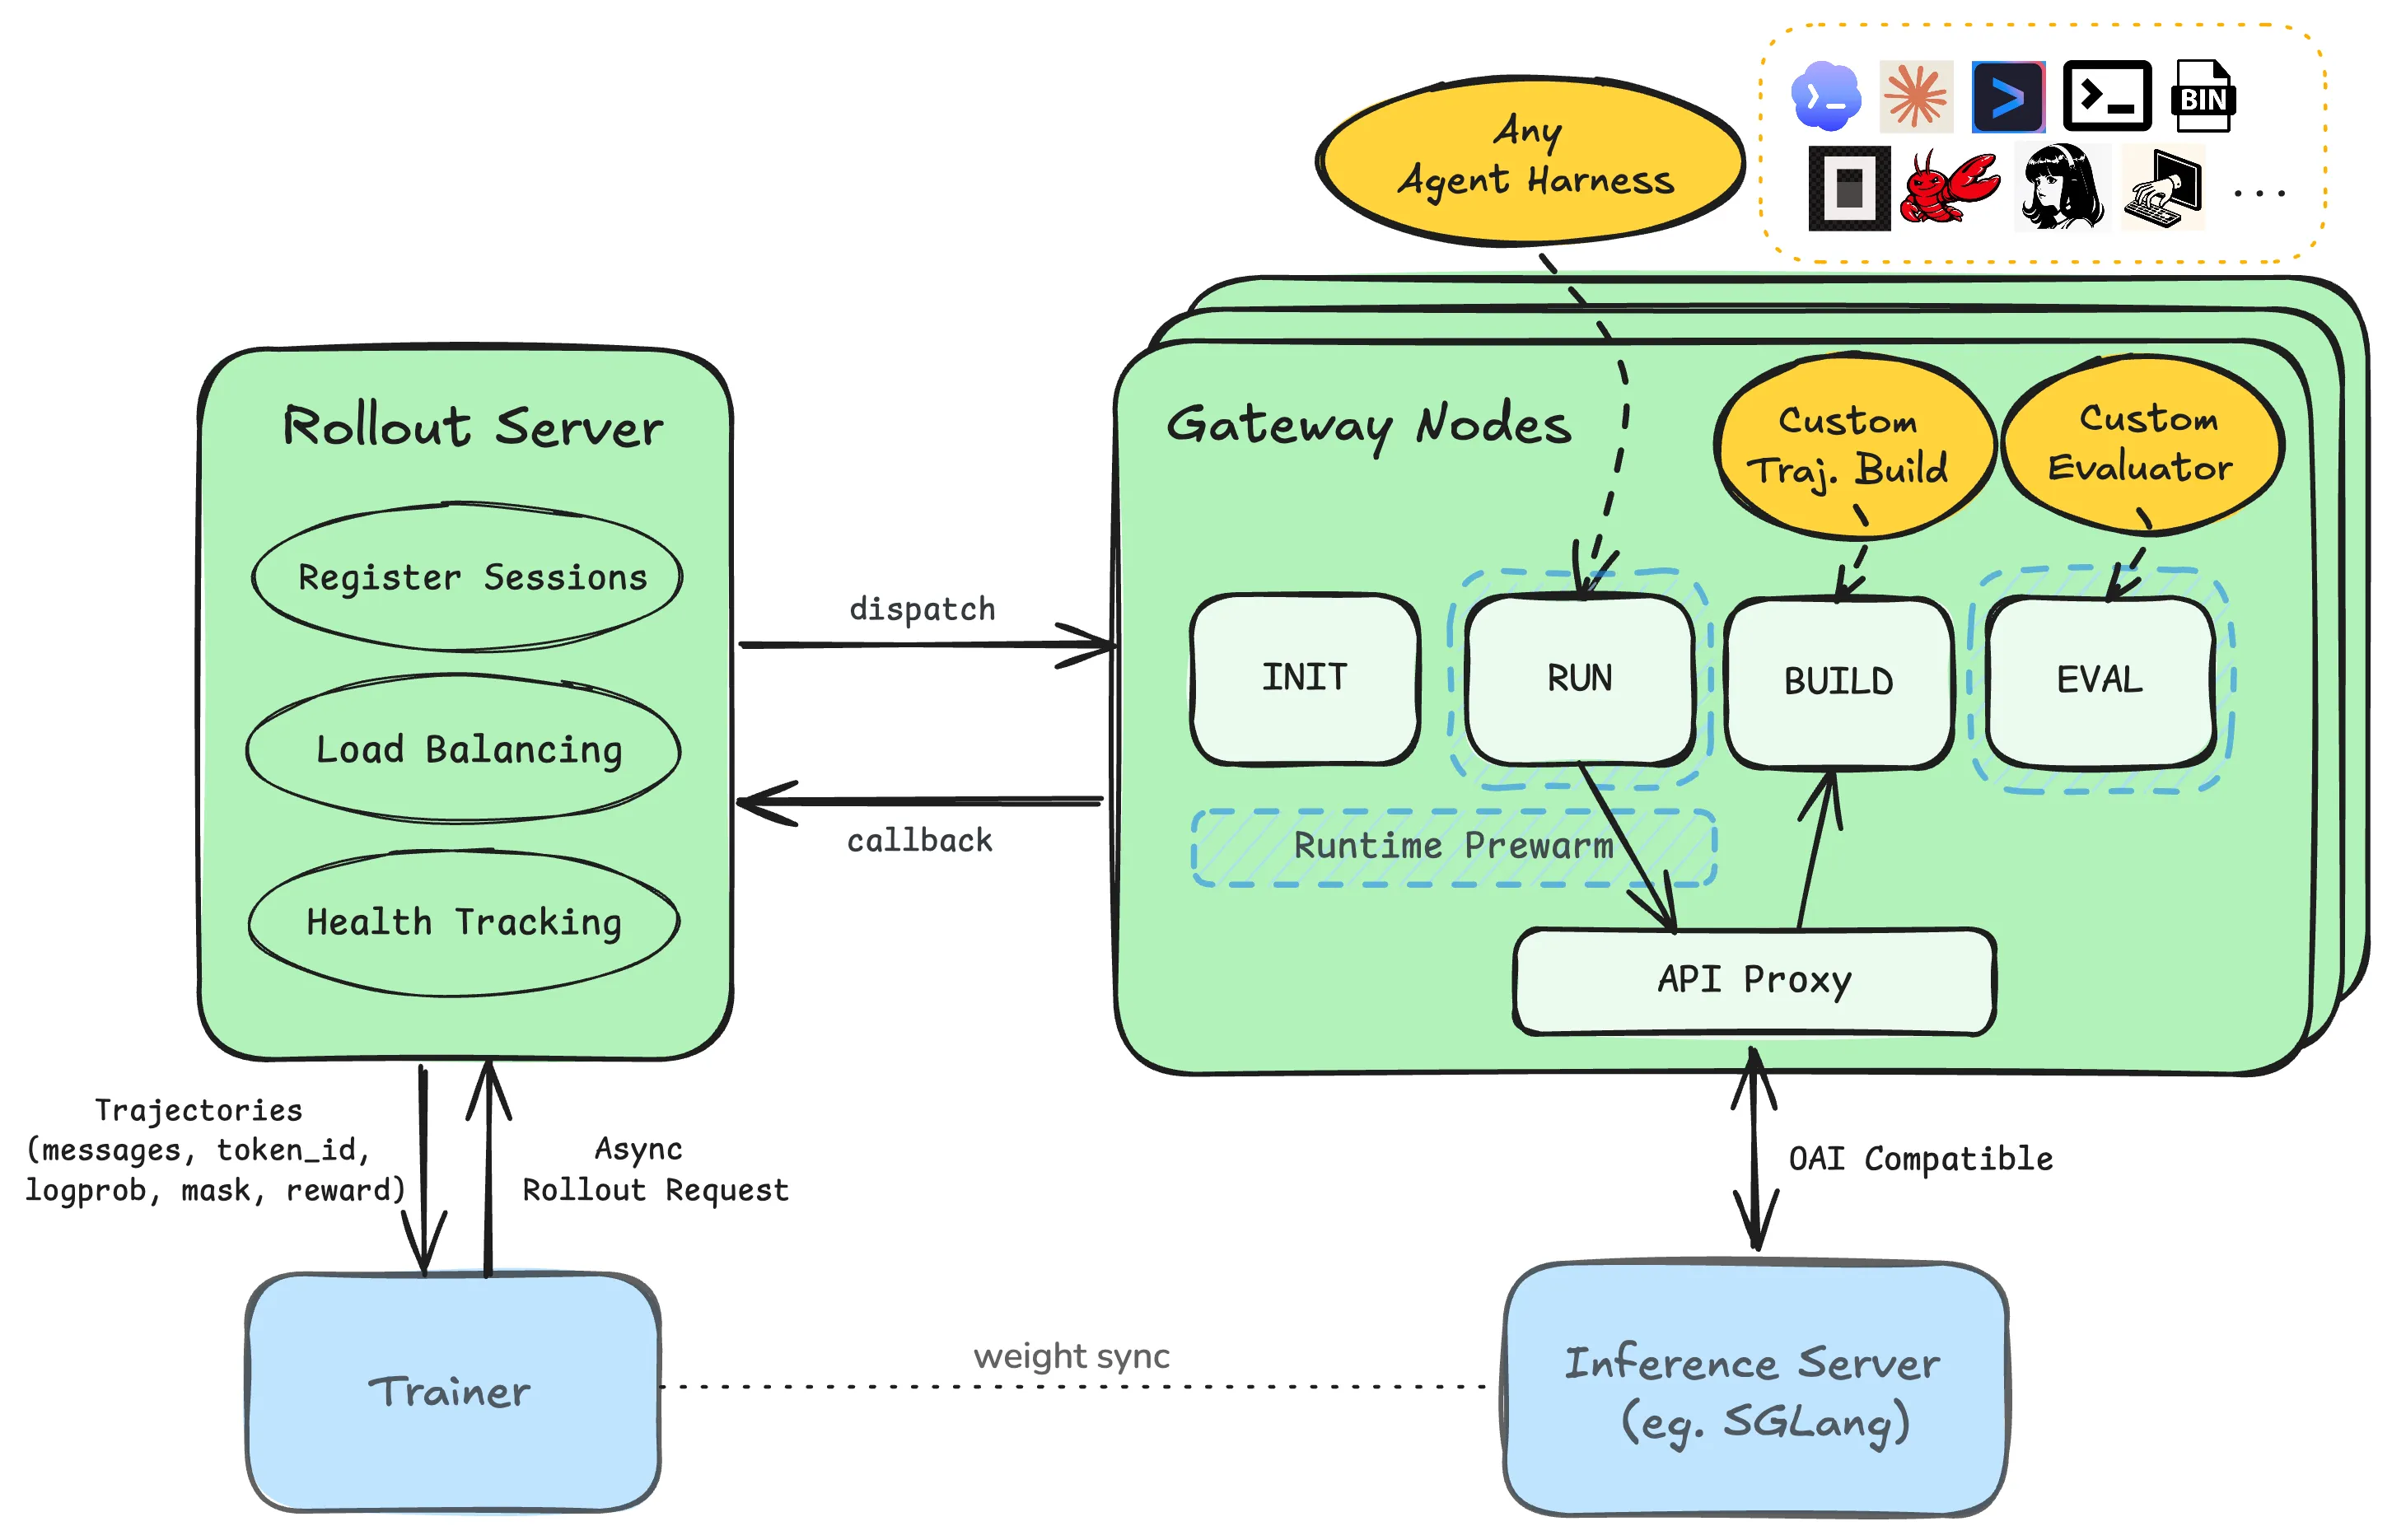
Figure 1: Polar架构概述。Polar在隔离的runtime中运行现有agent harness,在harness和推理服务器之间放置model API proxy。代理转发模型调用、记录token级请求和响应数据、重建RL轨迹,同时rollout gateway异步处理runtime预热、harness执行、评估和trainer回调。这种解耦设计使Polar能够将agent视为黑盒环境,无缝扩展到不同的训练框架。
三、技术架构
3.1 整体架构
Polar有两个核心组件:
| 组件 | 功能 |
|---|---|
| Rollout Server | 协调任务和全局调度 |
| Gateway Nodes | 执行session、托管model proxy、构建轨迹、运行评估 |
Session作为调度单元:每个session包含session ID、task ID、timeout budget、runtime specification、agent specification、trajectory builder、evaluator和callback URL。
训练框架独立:训练框架与Polar服务器独立,服务边界原生支持高效的异步RL规模化。
3.2 Proxy-based Rollout
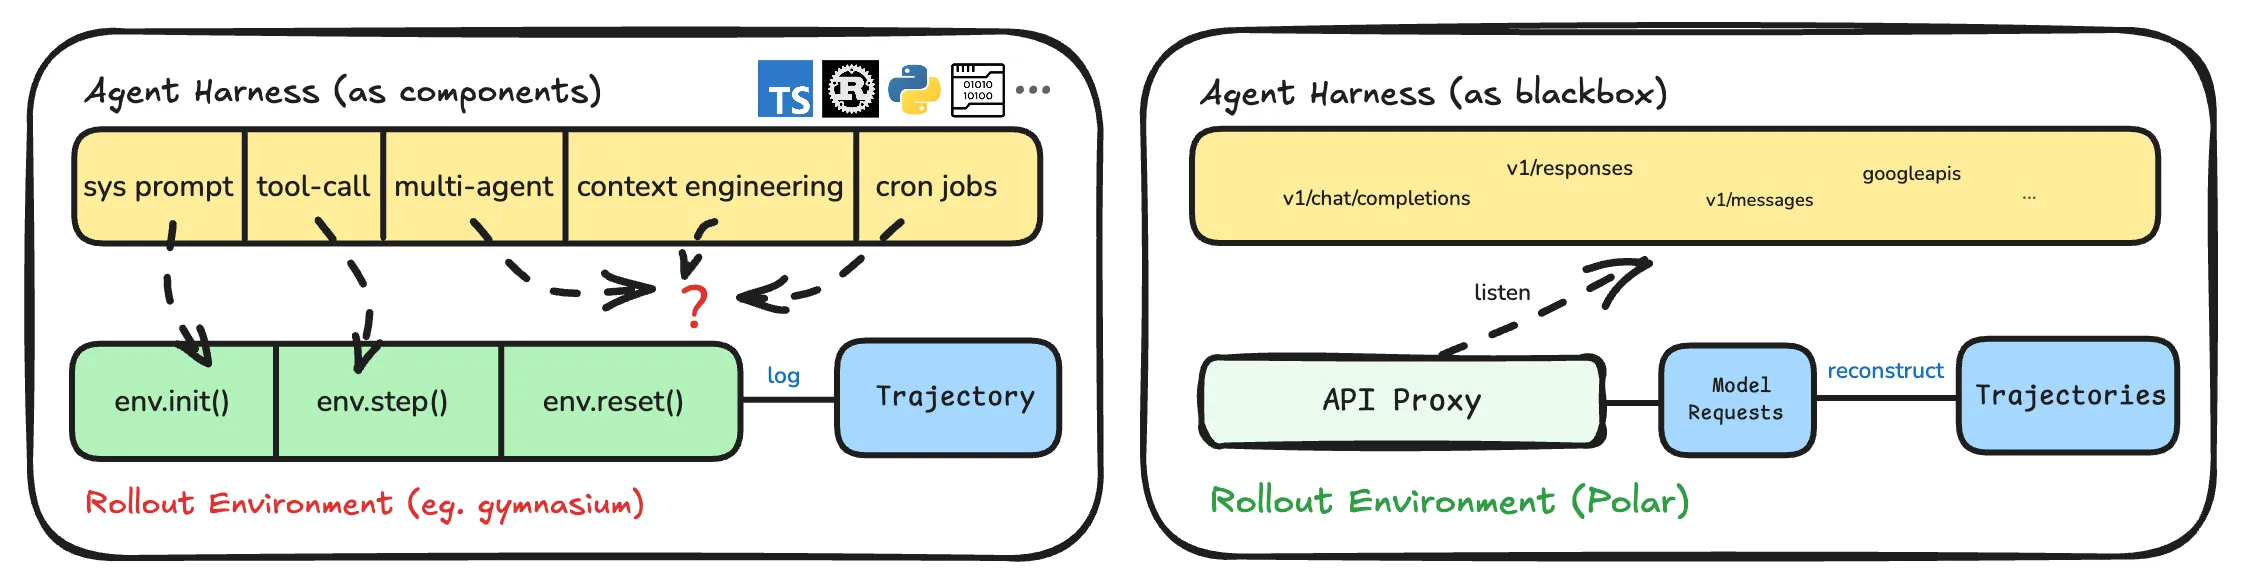
Figure 2: Polar使用model API proxy作为rollout边界。传统rollout框架通常要求agent或harness逻辑在框架拥有的环境API后面重写。这使trainer依赖于harness特定的集成代码,且可能遗漏原生执行路径的细节。Polar保持harness不变,在LLM API boundary放置provider-compatible proxy;代理记录prompt、sampled tokens、log probabilities和responses,然后在harness外部重建trainer-ready轨迹。
Proxy对每个传入模型请求执行四步:
- Detect provider API:通过请求路径和headers区分Anthropic Messages、OpenAI Chat Completions、OpenAI Responses和Google generateContent-style调用
- Normalize request:将roles、content parts、tool definitions等转换为OpenAI Chat Completions格式
- Capture token-level data:存储completion record,包含request messages、response messages、prompt token IDs、sampled response token IDs、finish reason和log probabilities
- Return provider shape:将响应转换回harness期望的schema
关键设计:Proxy boundary故意位于agent框架之下。它不需要理解harness如何计划、管理工具或决定何时停止,只需保持API兼容性并记录足够信息来重建训练样本。
3.3 Harness适配器
Harness adapter设计精简,可安装配置、注册MCP servers或skills、写入provider settings、返回运行agent的shell commands。Polar集成了popular agent harnesses作为快捷方式:
| Harness | 说明 |
|---|---|
claude_code | Anthropic Claude Code |
codex | OpenAI Codex |
gemini_cli | Google Gemini CLI |
qwen_code | Qwen Code |
opencode | OpenCode |
pi | Pi coding agent |
3.4 异步Rollout Staging
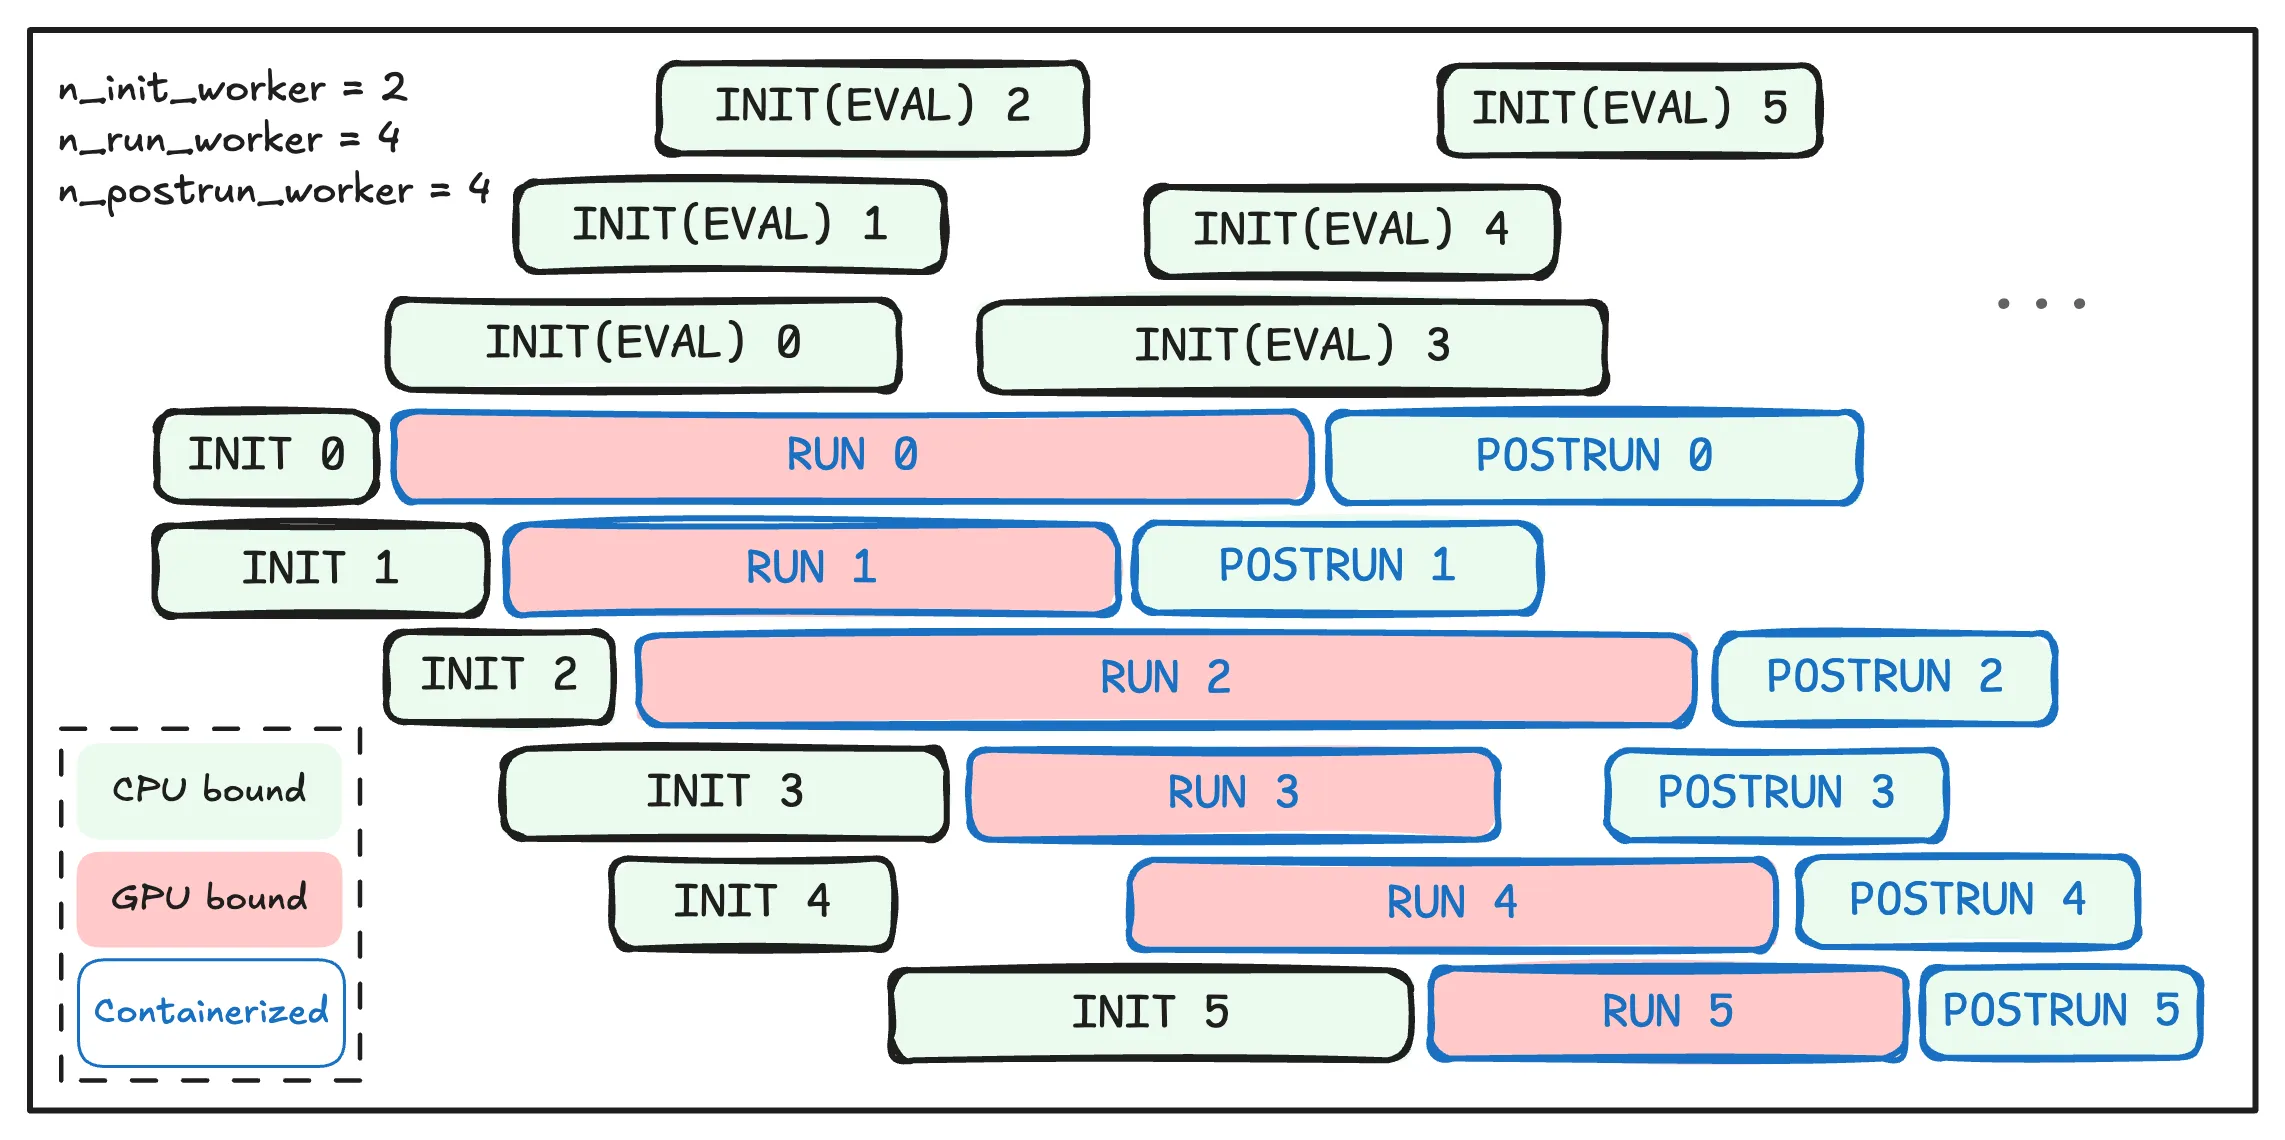
Figure 3: Polar中的Gateway级异步staging。Gateway将runtime初始化、ready缓冲、harness执行和post-run轨迹与评估工作分离到独立的worker pools中。Runtime准备和evaluator预热在关键路径之外进行,因此CPU密集的runtime设置和长尾评估不会阻塞活跃的GPU-bound agent运行。
每个gateway使用隔离的worker pools:
| 阶段 | 功能 |
|---|---|
| INIT | 启动runtime,执行prepare actions |
| READY | 缓冲已初始化的runtime,等待run slot |
| RUNNING | 执行harness |
| POSTRUN | 构建轨迹、运行evaluators、执行post-run hooks、发送callbacks、teardown resources |
关键优势:Ready buffer允许CPU密集的runtime准备在后台进行,不阻塞GPU-bound的agent执行。当evaluator请求clean runtime时,gateway在agent运行期间开始准备该runtime。
3.5 轨迹重建
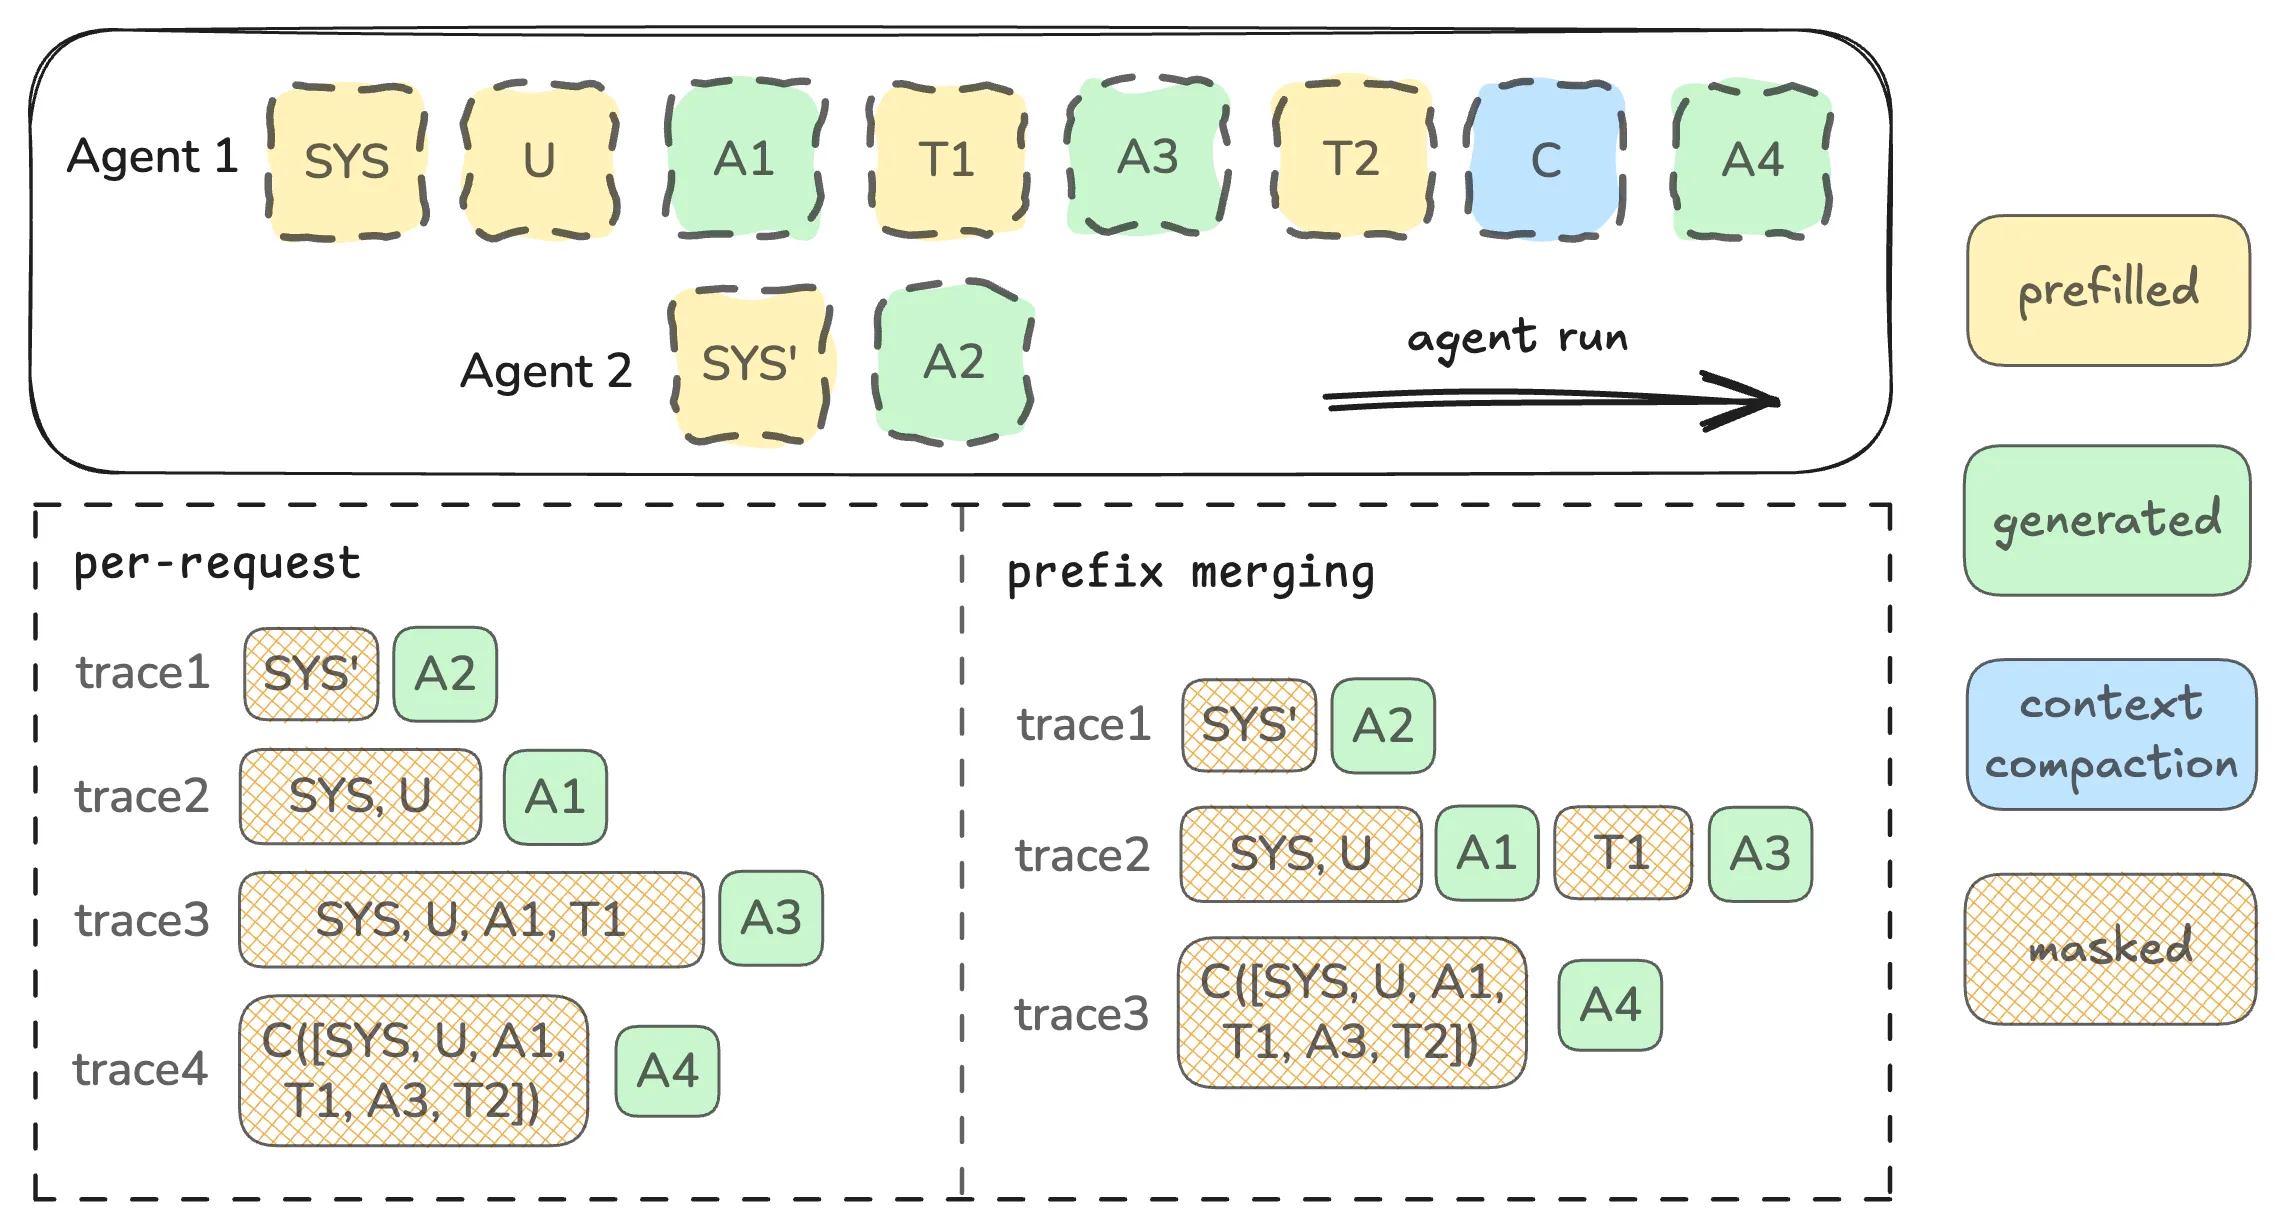
Figure 4: 轨迹重建示例。可视化的session包含一个三轮main agent,经历一次harness级context compaction并spawn一个subagent。Per-request builder将每个捕获的模型调用保持为独立trace。Prefix merging恢复append-only对话链,而compaction和subagent边界自然形成独立链。在每个merged trace中,Polar的prefix merging算法仅将sampled assistant tokens复制为trainable tokens,屏蔽canonical interstitial tokens,保持behavior-policy保真度同时减少trainer-facing样本。
两种轨迹构建策略:
| 策略 | 说明 | 优劣 |
|---|---|---|
| per_request | 每个completion变为一个trace | 无损但碎片化,增加trainer负担 |
| prefix_merging | 恢复append-only对话链 | 减少trace数量,5.39x加速 |
Prefix Merging算法:
对于session中的completions ,其中completion 有prompt token序列 、raw sampled response token序列 、response log probabilities 和prompt/response messages 。
Polar的prefix merging:
- 将completions分割为chains
- 每个chain内,completions保持strict append-only顺序
- 仅复制sampled assistant tokens为trainable tokens
- 屏蔽canonical interstitial tokens
3.6 评估与奖励传播
评估器在session完成后运行,将outcome或trace-level reward附加到轨迹上。支持多种reward类型:
- Outcome reward:基于最终结果的单一奖励
- Trace-level reward:每个trace的奖励
四、实验结果
4.1 SWE-Gym GRPO on Coding Harnesses
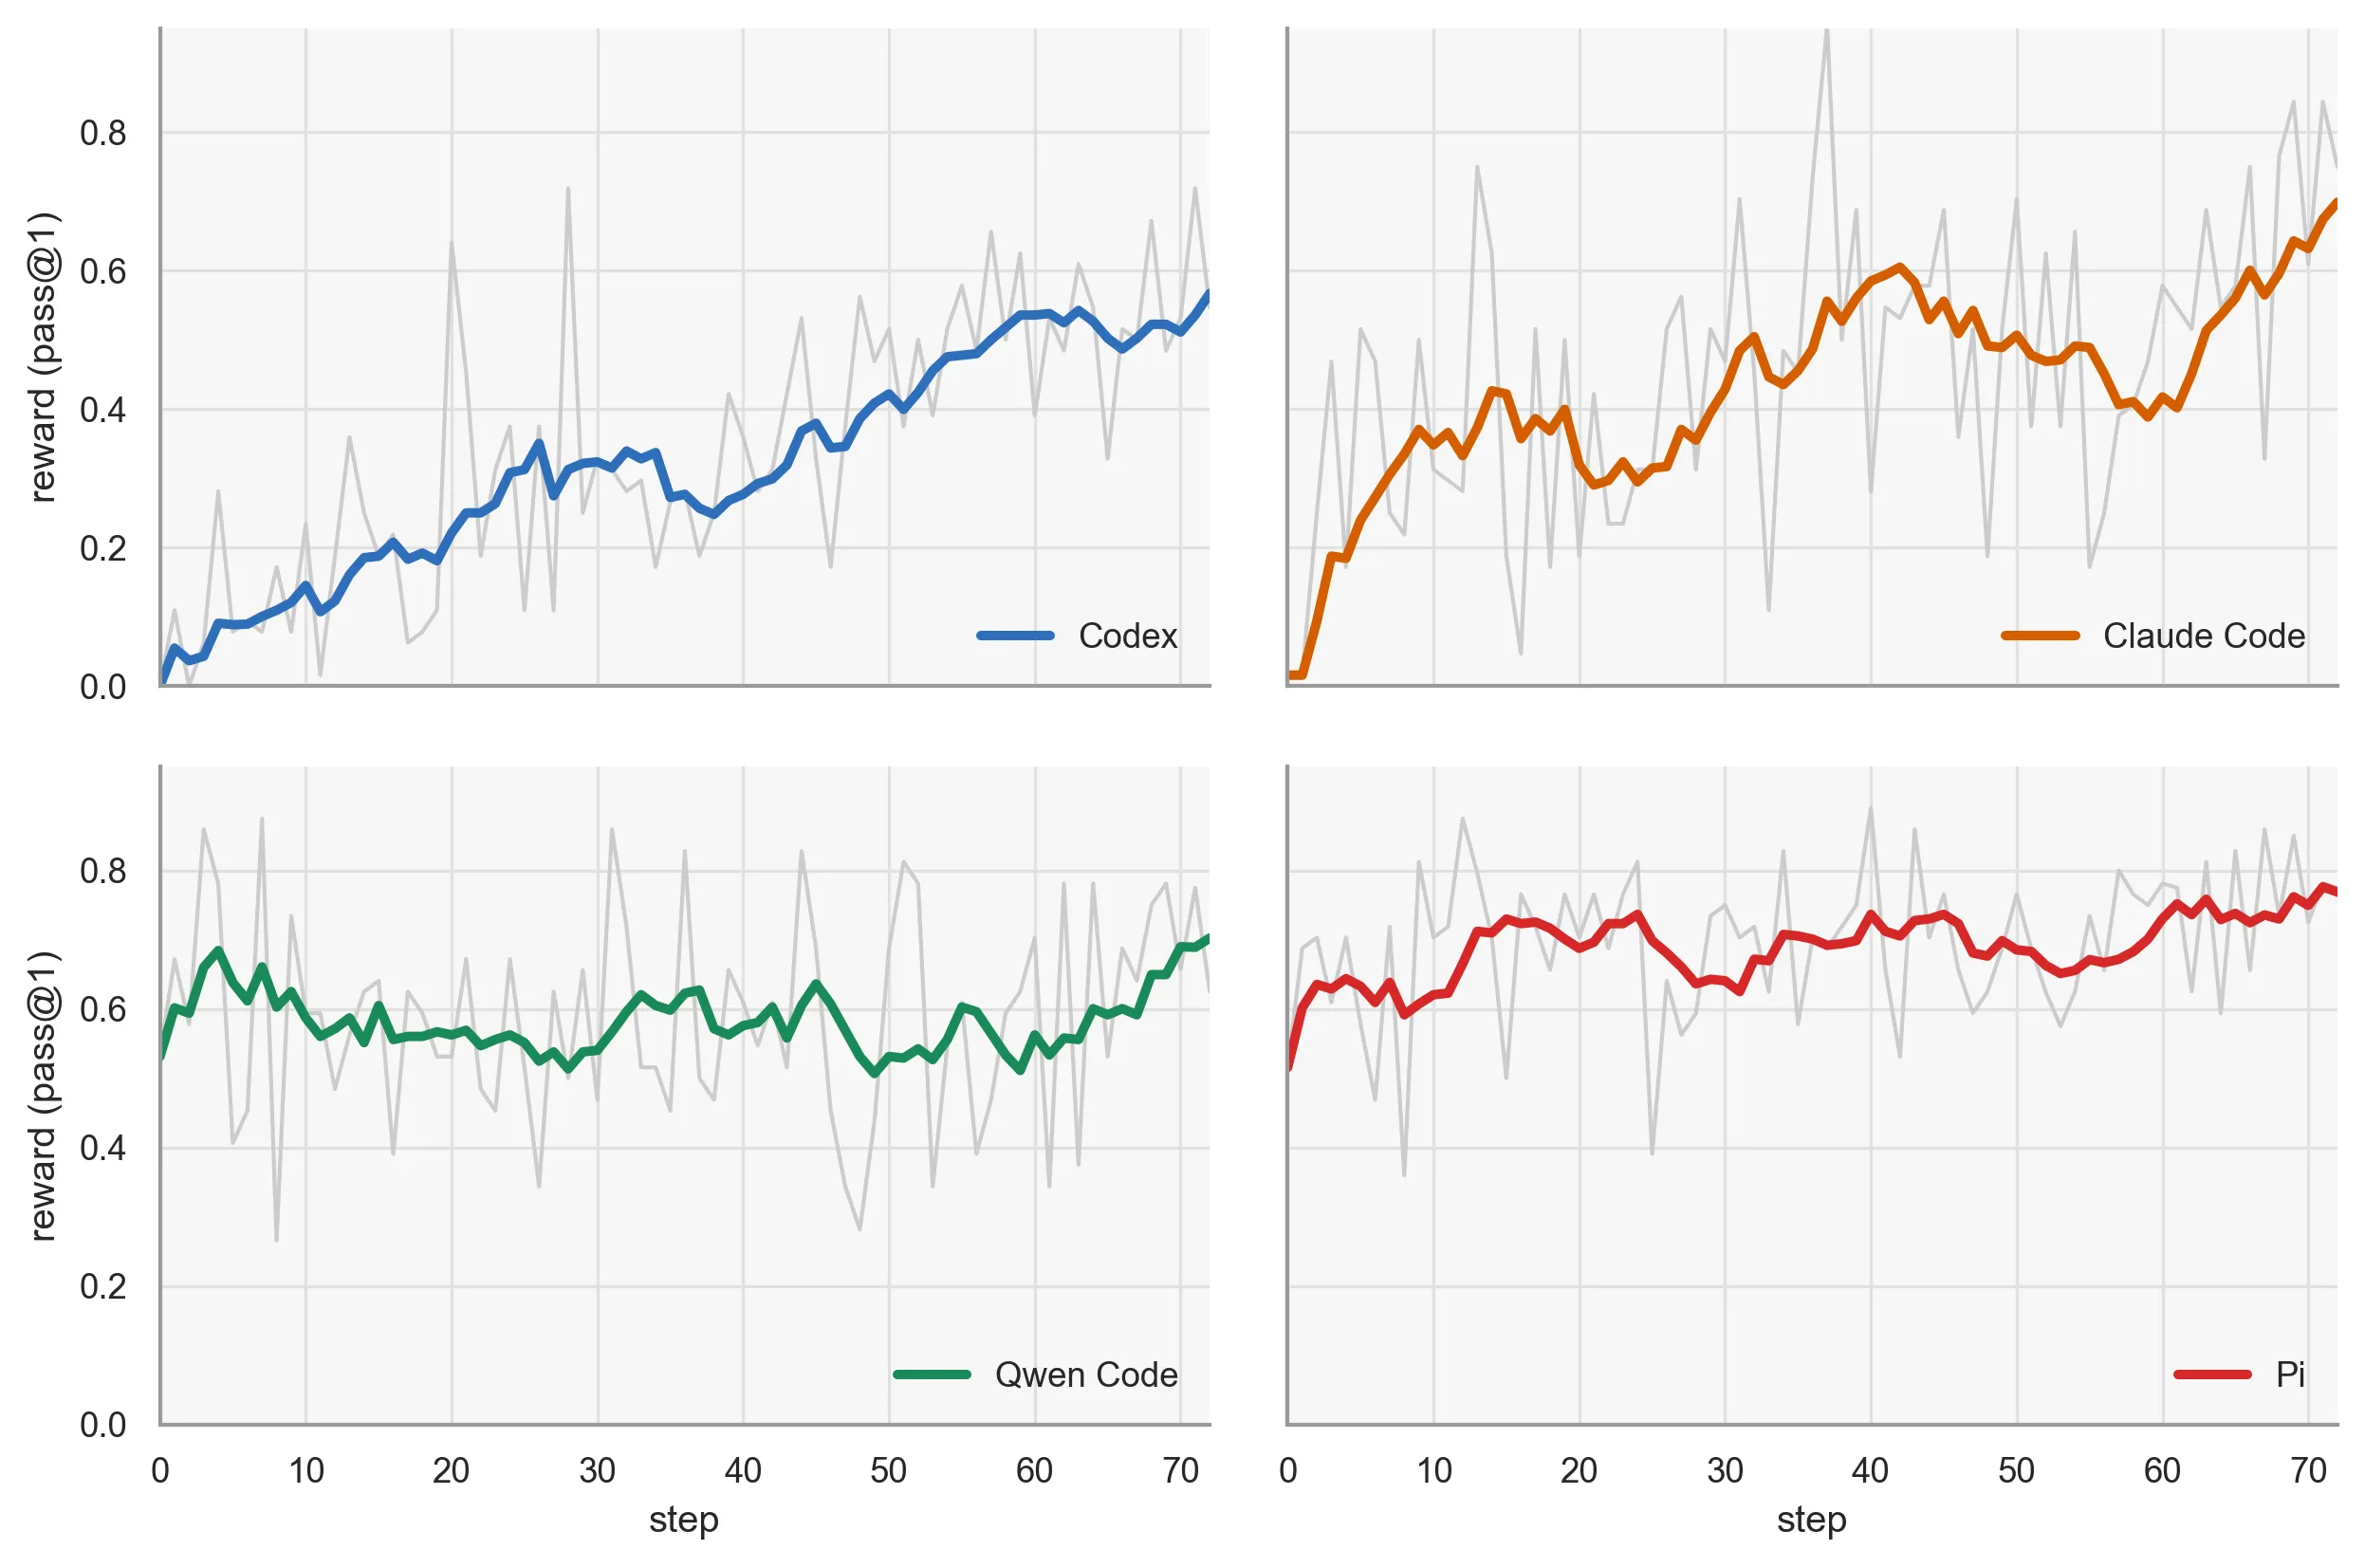
Figure 6: SWE-Gym GRPO训练曲线。每个面板显示四个评估coding harness之一的per-step outcome reward。RL在各harness上提升了reward,特别是在涉及复杂prompting、编排或不熟悉tool schema的执行路径上。
实验设置:
| 参数 | 值 |
|---|---|
| Base checkpoint | Qwen/Qwen3.5-4B |
| Training data | NovaSky-AI/SkyRL-v0-293-data, train split, 293 tasks |
| Trainer | Slime asynchronous GRPO |
| Epochs | 1 |
| Rollout batch size | 4 |
| Samples per prompt | 16 |
| Trace construction | prefix_merging |
| Optimizer | Adam |
| Learning rate | 1×10⁻⁶ |
| Weight decay | 0.1 |
| TIS | Enabled |
SWE-Bench Verified评估结果 (Table 1):
| Harness | Base | Polar RL | Gain |
|---|---|---|---|
| Codex | 3.8% | 26.4% | +22.6 |
| Claude Code | 29.8% | 34.6% | +4.8 |
| Qwen Code | 34.6% | 35.2% | +0.6 |
| Pi | 34.2% | 40.4% | +6.2 |
关键发现:
- Codex harness:最大提升(+22.6),因为Codex对Qwen模型来说是不熟悉的action protocol
- Claude Code:稳定提升(+4.8),从28.8%提升到67.0%(最后10步平均)
- Qwen Code:较小但稳定的提升(+0.6),从61.6%提升到66.0%
- Pi:显著提升(+6.2),从初始reward提升到更高水平
4.2 Prefix Merging消融实验
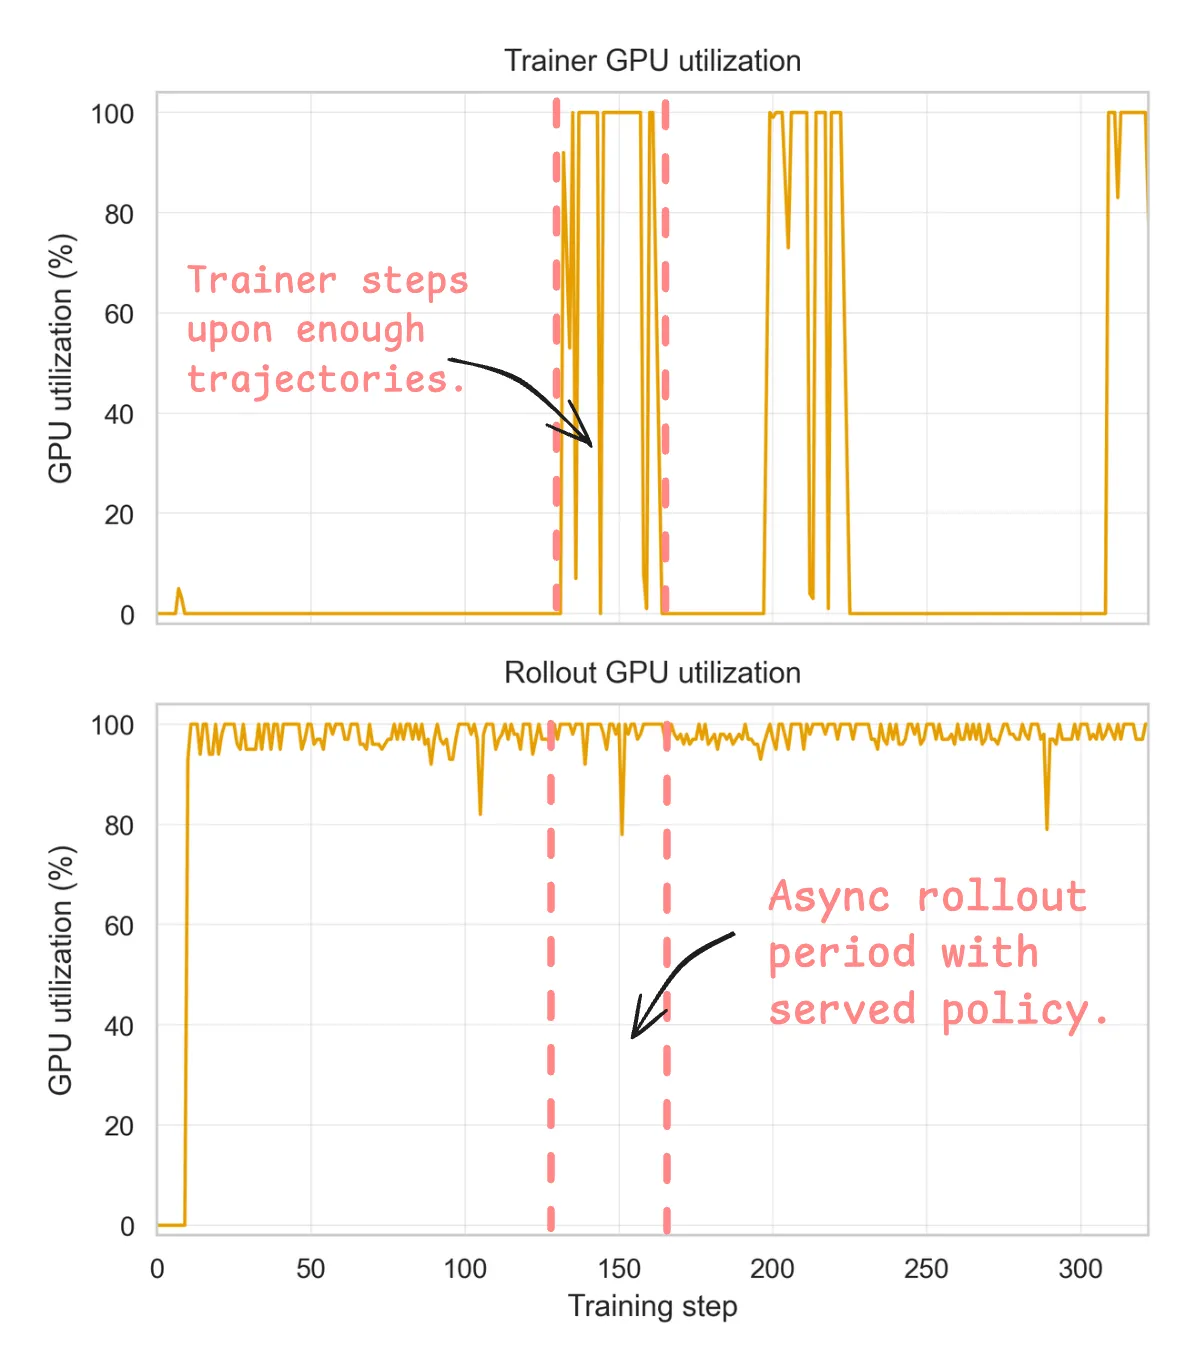
(a) 异步RL的GPU利用率
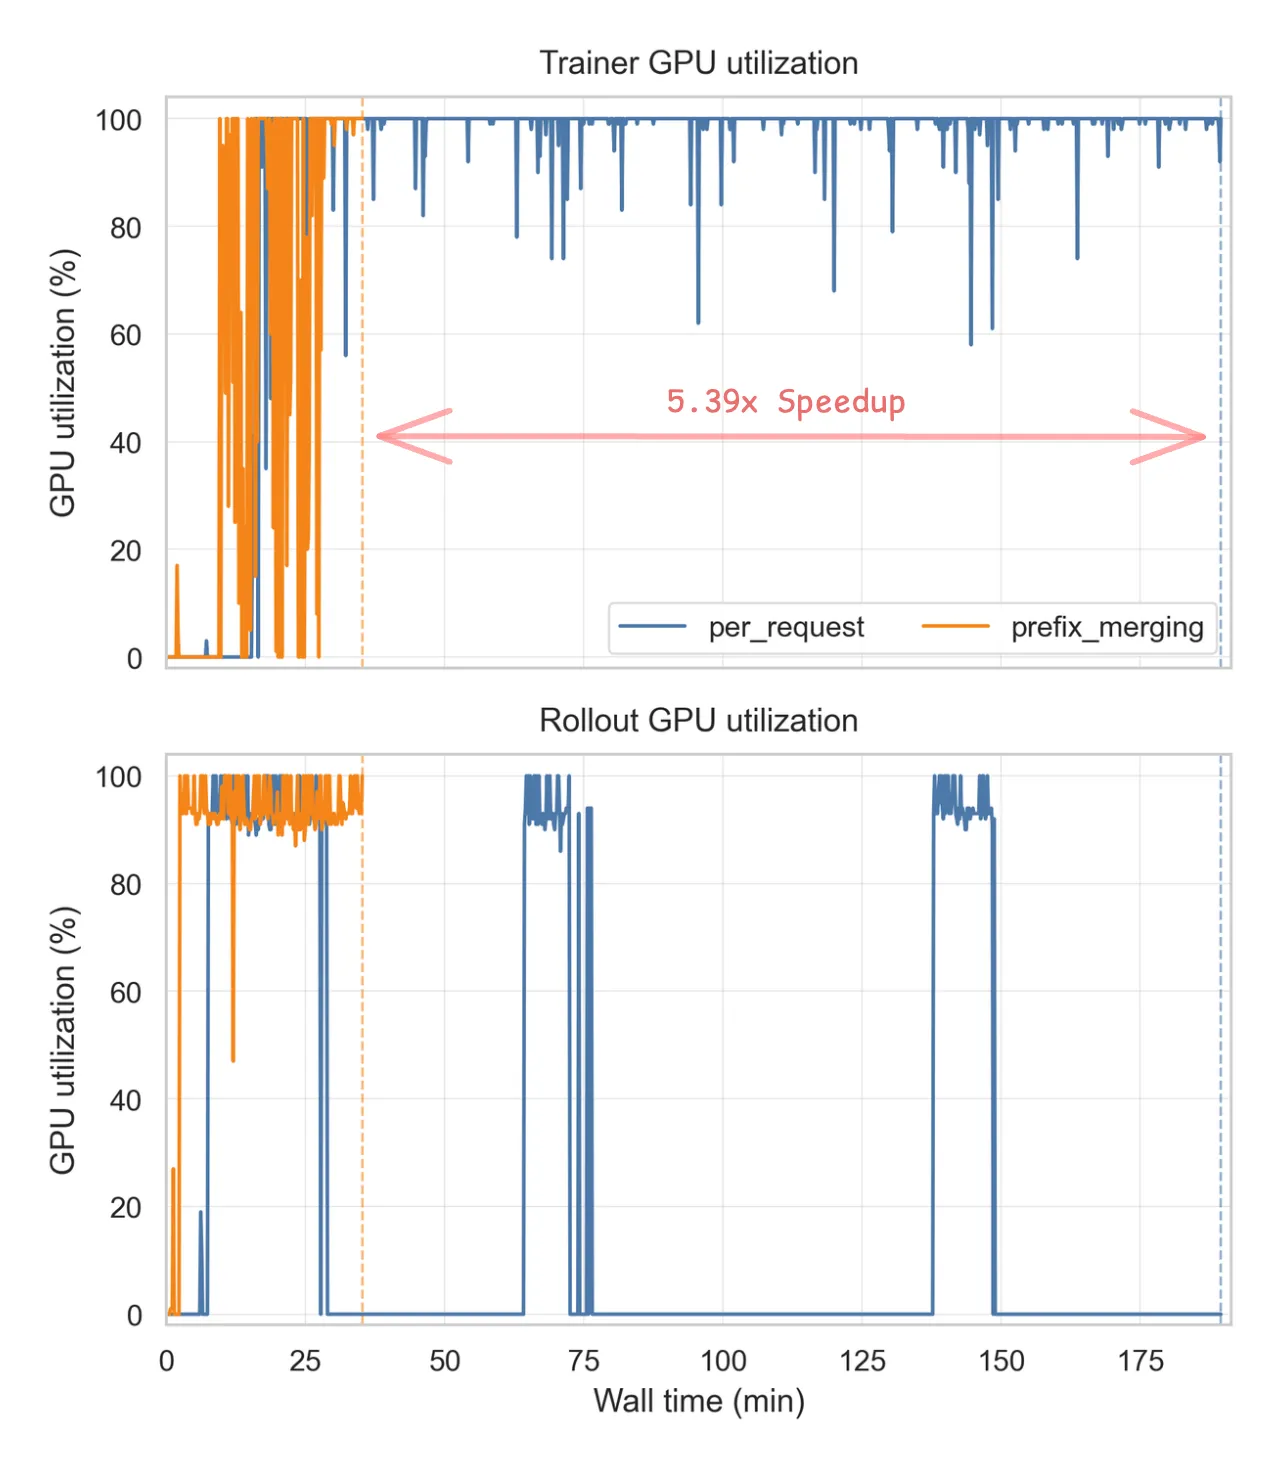
(b) 不同重建策略的GPU利用率
消融结果:
- per_request:1,185 request-level updates,wall-clock 189.5分钟
- prefix_merging:218 merged-trace updates,wall-clock 35.2分钟
- 加速比:5.39x
- GPU利用率:prefix_merging保持rollout GPUs 87.7%平均利用率
Reward Hacking问题:尝试per_request + outcome-reward broadcasting时,观察到显著的reward hacking。原因是noisy credit assignment:request-level traces在没有proper session normalization或advanced process reward model的情况下接收session-level credit。
4.3 Offline Data Generation
设置:
- 模型:Qwen3.5-122B-A10B (TP=8, max_model_len=32,768)
- Harness:pi-coding-agent v0.67.68
- 数据:1,638 instances,来自7个SWE-Gym repositories
- 硬件:8×H100 SGLang serve job
Per-repository接受率 (Table 2):
| Repo | Attempts | Accepted | Rate |
|---|---|---|---|
| getmoto/moto | 343 | 184 | 53.6% |
| python/mypy | 257 | 101 | 39.3% |
| conan-io/conan | 71 | 27 | 38.0% |
| pydantic/pydantic | 81 | 24 | 29.6% |
| iterative/dvc | 219 | 45 | 20.5% |
| pandas-dev/pandas | 477 | 98 | 19.7% |
| dask/dask | 141 | 25 | 17.7% |
| Total | 1,638 | 504 | 30.8% |
数据特点:
- 平均104 messages/session,51 assistant turns
- 长尾分布:部分session超过200 turns
- 总成本:约64 GPU-hours
- 数据格式:OpenAI-style messages with role, content, tool_calls, tool_call_id
五、与现有系统对比 (Table 3)
| 系统 | Async RL Support | Async Rollout Staging | Rollout as Service | Agent Harness Agnostic |
|---|---|---|---|---|
| Polar | ✓ | ✓ | ✓ | ✓ |
| ProRL Agent | ✓ | ✓ | ✓ | ✗ |
| SkyRL-Agent | ✓ | ✓ | ✗ | ⚫ |
| PRIME-RL | ✓ | ✗ | ✗ | ✗ |
| Agent Lightning | ⚫ | ✗ | ⚫ | ⚫ |
| rLLM | ⚫ | ✗ | ✗ | ✗ |
| OpenClaw-RL | ✓ | ✗ | ✗ | ⚫ |
Polar的独特优势:
- 唯一完全harness无关的系统:通过proxy-based approach实现
- 完整的异步支持:包括RL支持、rollout staging和rollout as service
- 解耦设计:训练框架与rollout服务完全独立
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| Proxy-based Rollout | 通过model API proxy捕获token级数据 | 无需修改agent harness |
| 异步Rollout Staging | 分离runtime初始化、执行、重建、评估 | CPU/GPU并行,不阻塞 |
| Prefix Merging | 智能轨迹重建,恢复append-only对话链 | 5.39x加速,87.7% GPU利用率 |
| Rollout as Service | 独立的rollout服务,支持异步RL | 解耦训练和rollout |
| 黑盒Agent训练 | 通过model API boundary训练任意agent | 无需agent内部代码修改 |
七、相关工作
7.1 Agent RL系统
| 系统 | 特点 |
|---|---|
| ProRL Agent | Polar的前身,需要harness特定集成 |
| SkyRL-Agent | 集成agent执行到RL pipeline |
| PRIME-RL | 需要用户适配agent到RL基础设施 |
| Agent Lightning | 较早期的agent RL系统 |
| rLLM | 早期rollout框架 |
| OpenClaw-RL | 新兴的agent RL系统 |
7.2 低侵入Agent Instrumentation
Polar的proxy-based方法与其他低侵入方法的区别:
- 传统方法:需要在agent内部插入instrumentation代码
- Polar方法:在agent外部(model API boundary)进行观测
7.3 Token Fidelity和Retokenization漂移
Polar确保token-level fidelity:
- 直接记录prompt token IDs和sampled response token IDs
- 避免retokenization带来的信息损失
- 保持behavior-policy保真度
八、总结
核心贡献
- Proxy-based Rollout范式:首次提出通过model API proxy进行agentic RL训练
- 完整的异步架构:分离runtime初始化、agent执行、轨迹重建和评估
- Prefix Merging算法:智能轨迹重建,5.39x加速
- Rollout as Service:解耦训练和rollout,支持大规模异步RL
- 开源实现:作为NeMo Gym环境发布
技术影响
- 通用性:可在任意agent harness上进行RL训练,无需代码修改
- 效率:prefix merging显著减少训练时间,提高GPU利用率
- 可扩展性:rollout as service支持大规模分布式训练
- 实用性:已集成popular coding harnesses(Claude Code、Codex等)
实际应用
- SWE-Bench训练:在Qwen3.5-4B上通过不同harness进行RL训练
- Offline数据生成:使用Polar生成高质量SFT数据
- 多harness支持:同一模型可在不同harness上训练
局限性
- 依赖model API compatibility:需要harness使用标准model API
- Token-level fidelity限制:某些harness可能有特殊的token处理
- 评估器依赖:需要外部评估器提供reward signal
- 长尾任务:超长session的轨迹重建仍有挑战