CacheTune: Adaptive KV Cache Reuse for Fast Long-Context LLM Serving
Frequency-guided and hardware-aware KV Cache reuse system achieving 3.72x-4.86x TTFT speedup and 3.93x-6.21x higher throughput via selective recomputation of semantic-critical tokens
CacheTune: Adaptive KV Cache Reuse for Fast Long-Context LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CacheTune: Adaptive KV Cache Reuse for Fast Long-Context LLM Serving |
| 作者 | Fei Li, Song Liu, Yan Liu, Jinhua Cui, Shiqiang Nie, Jinyu Wang, Weiguo Wu |
| 机构 | 西安交通大学计算机科学与技术学院 / 华中科技大学计算机科学与技术学院 |
| 论文 | https://arxiv.org/abs/2605.24022 |
| 代码 | 未公开 |
| 发布 | arXiv:2605.24022v1 [cs.AR], May 20, 2026 |
| 许可 | none |
二、核心思想
问题定义
长上下文 LLM 推理中,Time-To-First-Token (TTFT) 延迟已成为限制交互性能和部署成本的首要瓶颈。KV Cache reuse 提供了减少冗余 prefill 的直接路径,但面临两大核心挑战:
挑战 1:非前缀场景的语义一致性断裂
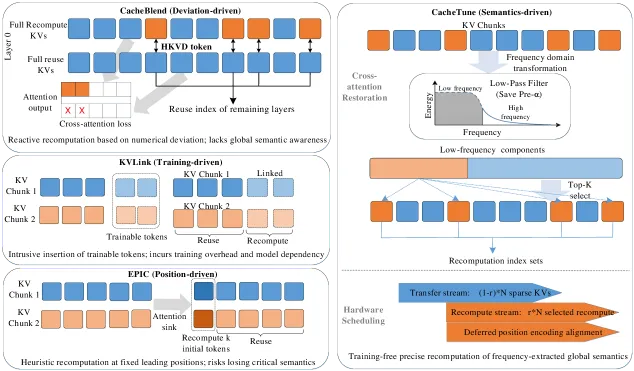
传统 prefix caching 仅适用于严格前缀场景。在 RAG、多轮对话摘要等场景中,可复用内容通常不是最终 prompt 的严格前缀,而是多个相互独立的文档 chunk、检索块或历史片段,动态拼接成当前查询。如果这些 chunk 独立编码到本地 KV Cache 中,每个 chunk 的表示缺乏全局上下文中应建立的跨 chunk 注意力关系(cross-attention),导致生成质量显著下降。
挑战 2:异构硬件层的 I/O 开销
当可复用 KV Cache 卸载到 GPU 外部缓存池时,跨异构硬件层的 I/O 开销成为新的 TTFT 瓶颈。即使理论上减少了冗余计算,实际中可能被漫长的数据传输路径和高移动开销抵消。
解决方案概述
本文提出 CacheTune——一个频率引导且硬件感知的 KV Cache 复用系统,通过算法-系统协同设计解决上述两大挑战:
- 频域分析识别关键 KV:离线通过频域分析识别对 cross-attention 恢复最关键的 KV pairs
- 选择性重计算:在线仅重计算这些语义关键 tokens,其余 KV 直接复用
- 稀疏 KV 传输:仅传输非重计算的 KVs,减少 I/O 开销
- 多流异步重叠:稀疏传输、在线重计算、延迟位置编码恢复通过多 CUDA 流异步重叠
- 硬件自适应调优:根据存储介质(CPU 内存 / SSD / HDD)自适应调整重计算比例
三、技术架构
整体框架
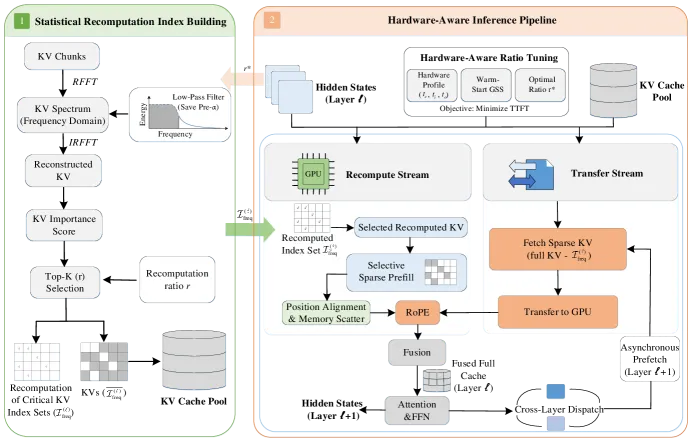
Request: Concatenated chunks [C1 | C2 | ... | Cn] + suffix query
    ↓
┌─────────────────────────────────────────────┐
│         Offline Phase (One-time)             │
│  1. Frequency-domain analysis of KV Cache    │
│  2. Identify semantic-critical tokens        │
│  3. Build frequency-based importance index   │
└─────────────────────────────────────────────┘
    ↓
┌─────────────────────────────────────────────┐
│         Online Phase (Per-request)           │
│  1. Retrieve cached KVs from external pool   │
│  2. Selectively recompute critical tokens    │
│  3. Sparse KV transfer + async overlap       │
│  4. Deferred positional encoding recovery    │
│  5. Hardware-aware adaptive r tuning         │
└─────────────────────────────────────────────┘
    ↓
Prefill → Decoding → Generation
KV Offloading 和稀疏复用流水线
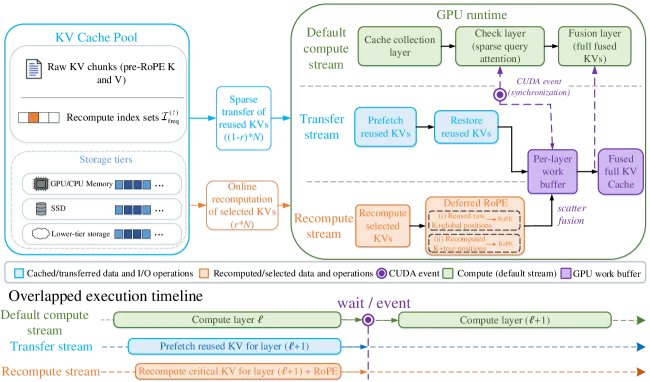
Step 1: KV Cache Offload
  └─ Prefill 阶段将 KV Cache 卸载到外部缓存池(CPU 内存 / SSD / HDD)

Step 2: Request Arrival
  └─ 新请求到达,包含多个 independent chunks + suffix query

Step 3: Sparse KV Retrieval
  └─ 仅检索未被标记为重计算的 KV pairs
  └─ 稀疏传输减少 I/O 量

Step 4: Selective Recomputation
  └─ 在线重计算语义关键 tokens 的 KV pairs
  └─ 重计算比例 r 由硬件感知搜索自适应确定

Step 5: Deferred Positional Encoding
  └─ 位置编码恢复延迟执行,与传输/重计算重叠

Step 6: Assemble & Prefill
  └─ 组合重计算和复用的 KV pairs
  └─ 执行最终 prefill
核心公式
频域能量分布分析
通过对 KV Cache 沿序列维度进行频域分析,发现 KV 对的能量分布呈现明显的低频主导特性:
其中 是沿序列维度的 key/value 矩阵, 是频率 处的能量。
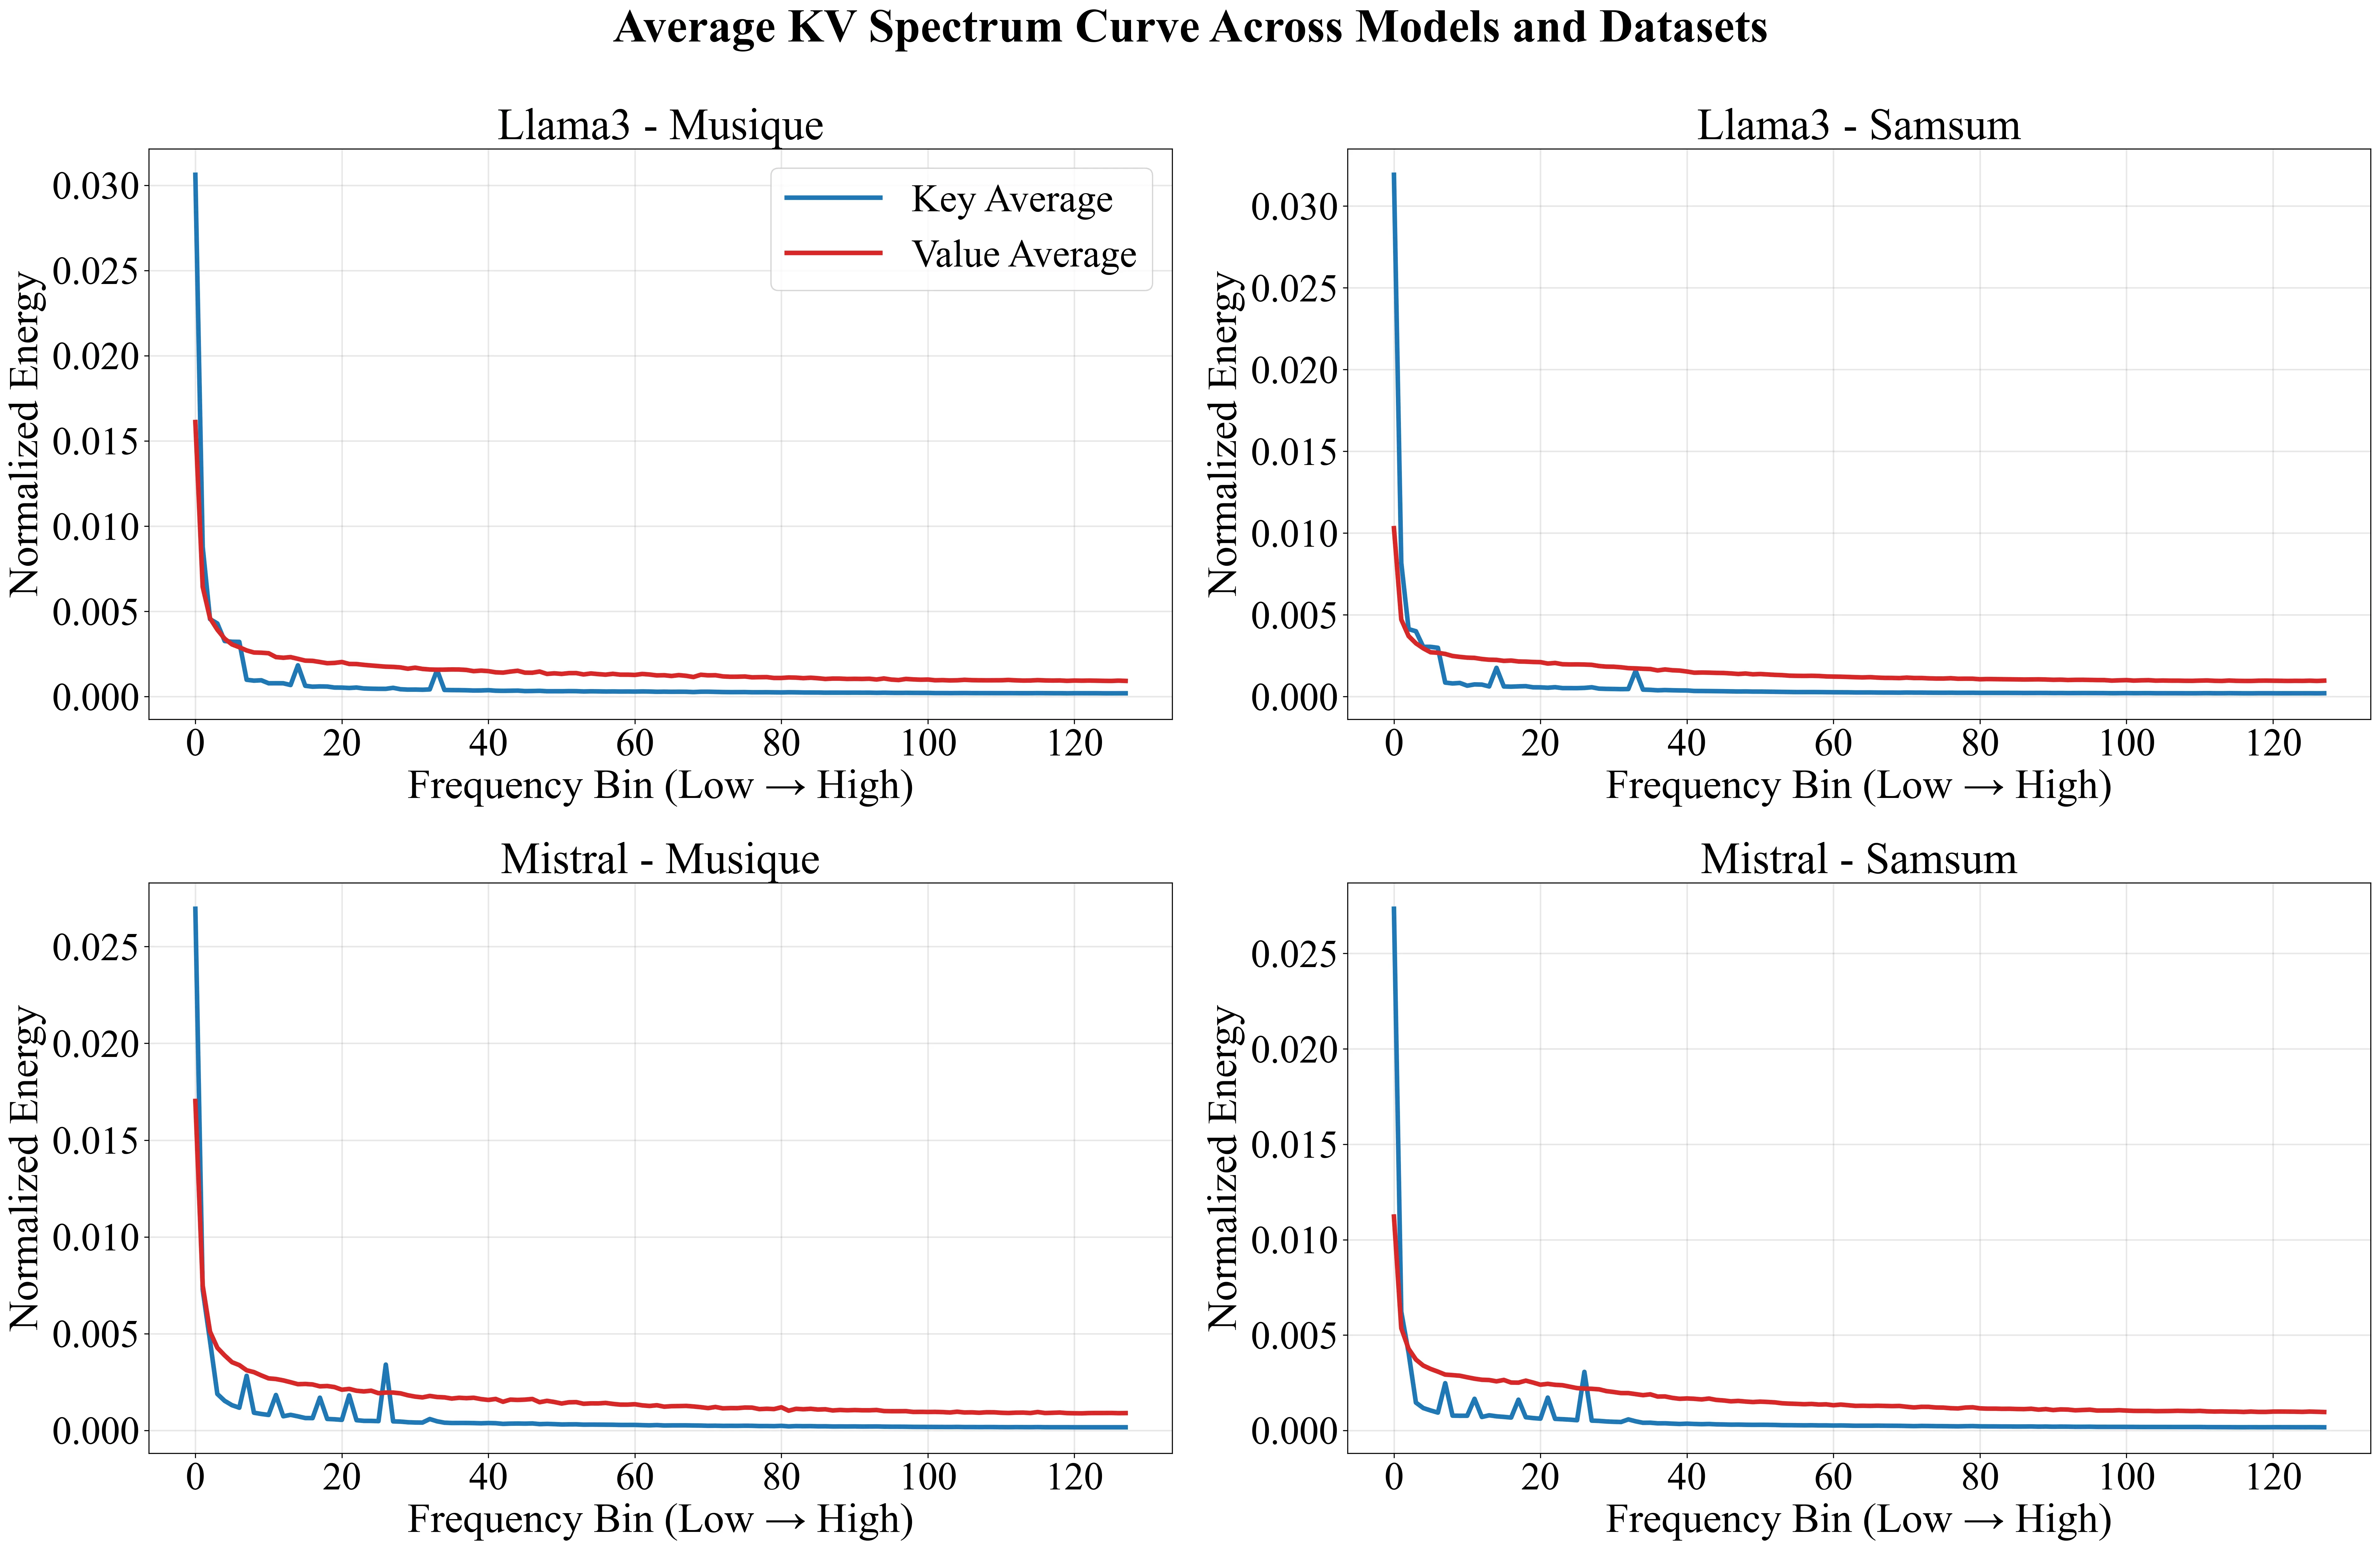
关键洞察:低频分量携带全局语义信息,高频分量携带局部细节。语义关键 tokens 主要集中在低频成分中。
Cross-Attention 热力图验证
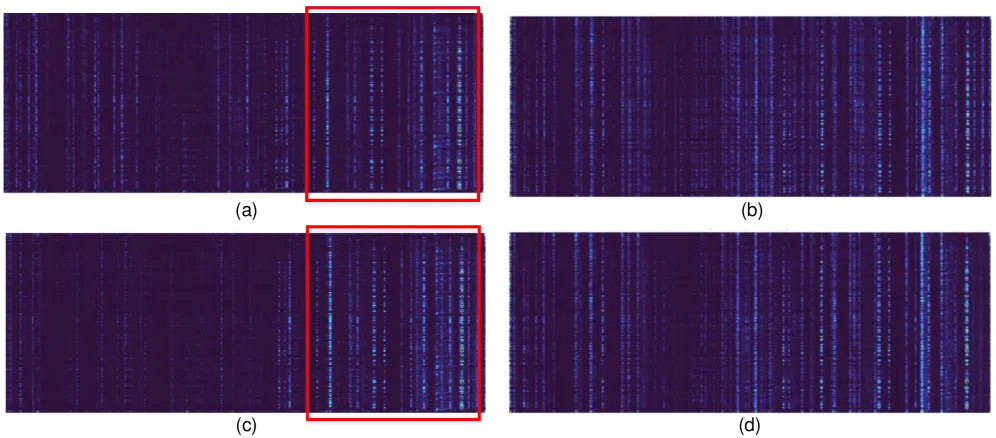
对比不同重计算策略下从 suffix query 到历史 KV Chunks 的 cross-attention 权重:
| 策略 | cross-attention 恢复质量 |
|---|---|
| (a) Full recompute | 基准 — 完整全局注意力 |
| (b) Direct reuse (r=0%) | 严重退化 — 缺少跨 chunk 注意力 |
| (c) Top 15% low-freq (Ours) | 接近 full recompute |
| (d) Top 15% high-freq | 效果差 — 高频不携带全局语义 |
关键发现:重计算低频组件对应的 tokens 能最有效地恢复缺失的 cross-attention。
选择性重计算公式
设 为通过频域分析识别的语义关键 token 集合, 为重计算比例:
其中 是重计算的 token 表示, 是从缓存中复用的 token 表示。
端到端 TTFT 模型
其中:
- :稀疏 KV 传输时间(随 增大而减小)
- :在线重计算时间(随 增大而增大)
- :位置编码恢复时间(可与其他操作重叠)
最优重计算比例:
通过硬件配置分析和经验校准搜索确定。
硬件感知的自适应重计算比例
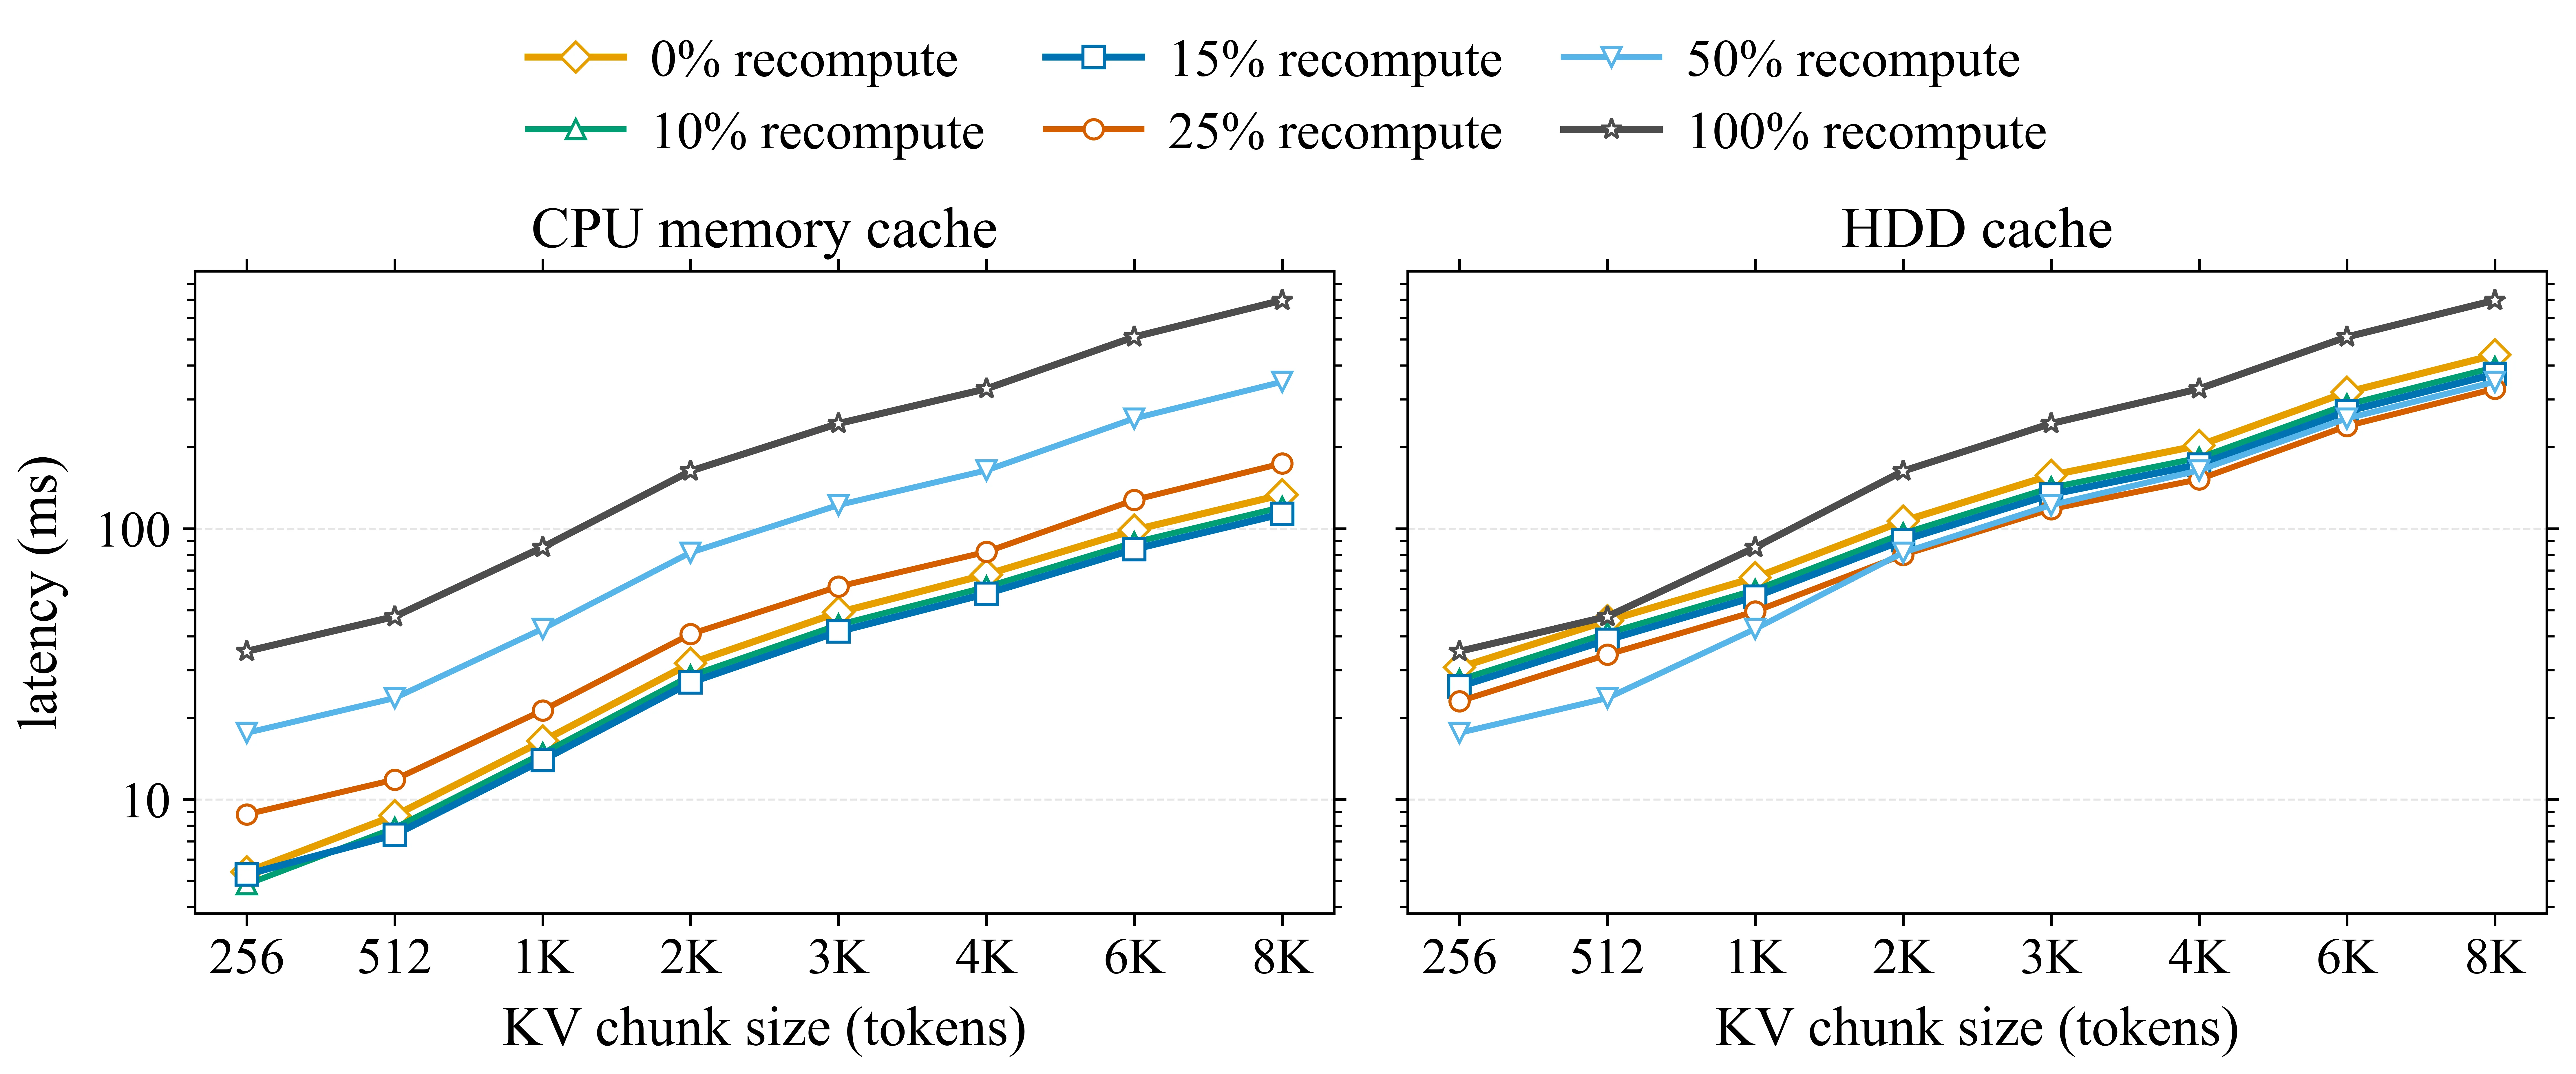
不同存储介质的最优重计算比例差异显著:
| 存储介质 | 最优 r | 原因 |
|---|---|---|
| CPU 内存 | 低 (≈5-10%) | I/O 快,传输成本低,无需过多重计算 |
| NVMe SSD | 中 (≈10-20%) | I/O 中等,需平衡传输与重计算 |
| HDD | 高 (≈20-30%) | I/O 慢,更多重计算以减少数据传输 |
多流异步重叠
CUDA Stream 0 (GPU Compute):
  ├─ Online selective recomputation of critical tokens
  └─ Final prefill

CUDA Stream 1 (PCIe Transfer):
  ├─ Sparse KV retrieval from external cache
  └─ Deferred positional encoding transfer

CUDA Stream 2 (Overlap Management):
  ├─ Synchronize streams
  └─ Adaptive r search
三个关键路径(sparse transfer、online recomputation、deferred positional encoding recovery)通过多 CUDA 流异步重叠,隐藏跨 tier 的 I/O 开销。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 频域 KV 重要性建模 | 首次通过频域分析识别对全局语义恢复最关键的 KV pairs | Fig. 3: low-freq tokens 重计算最有效,high-freq 无效 |
| 选择性重计算 | 仅重计算语义关键 tokens,其余直接复用 | Fig. 10: 频域方法优于基于 attention score 或 random 的策略 |
| 索引感知的 KV 卸载 | 仅传输非重计算的 KVs,稀疏传输减少 I/O | 多流异步重叠隐藏传输延迟 |
| 延迟位置编码恢复 | 位置编码恢复与传输/重计算并行执行 | 消除额外的序列化开销 |
| 硬件自适应 r 搜索 | 根据存储介质类型自适应调整重计算比例 | Fig. 4: CPU 内存 vs HDD 的最优 r 差异显著 |
| 算法-系统协同设计 | 频域语义选择 + 系统级 I/O-计算平衡 | 端到端 TTFT 降低 3.72x-4.86x |
五、实验结果
基准测试
评估设置:
- 主流 LLMs(多种参数规模)
- 长上下文任务(RAG、文档 QA、多轮对话摘要等)
- 多种存储配置(GPU 内存 → CPU 内存 → SSD → HDD)
核心指标:
- TTFT(Time-To-First-Token)
- Throughput(tokens/s)
- Generation Quality(accuracy)
性能提升
| 指标 | 提升幅度 | 说明 |
|---|---|---|
| TTFT Speedup | 3.72x – 4.86x | 相比全量重计算基线 |
| Throughput | 3.93x – 6.21x | 更高并发处理能力 |
| SSD/HDD 缓存下的 TTFT | 2.34x – 2.36x | 即使在 I/O 受限场景下仍有效 |
| 生成质量 | 接近 full recompute | 精度损失极小 |
Accuracy-TTFT 权衡
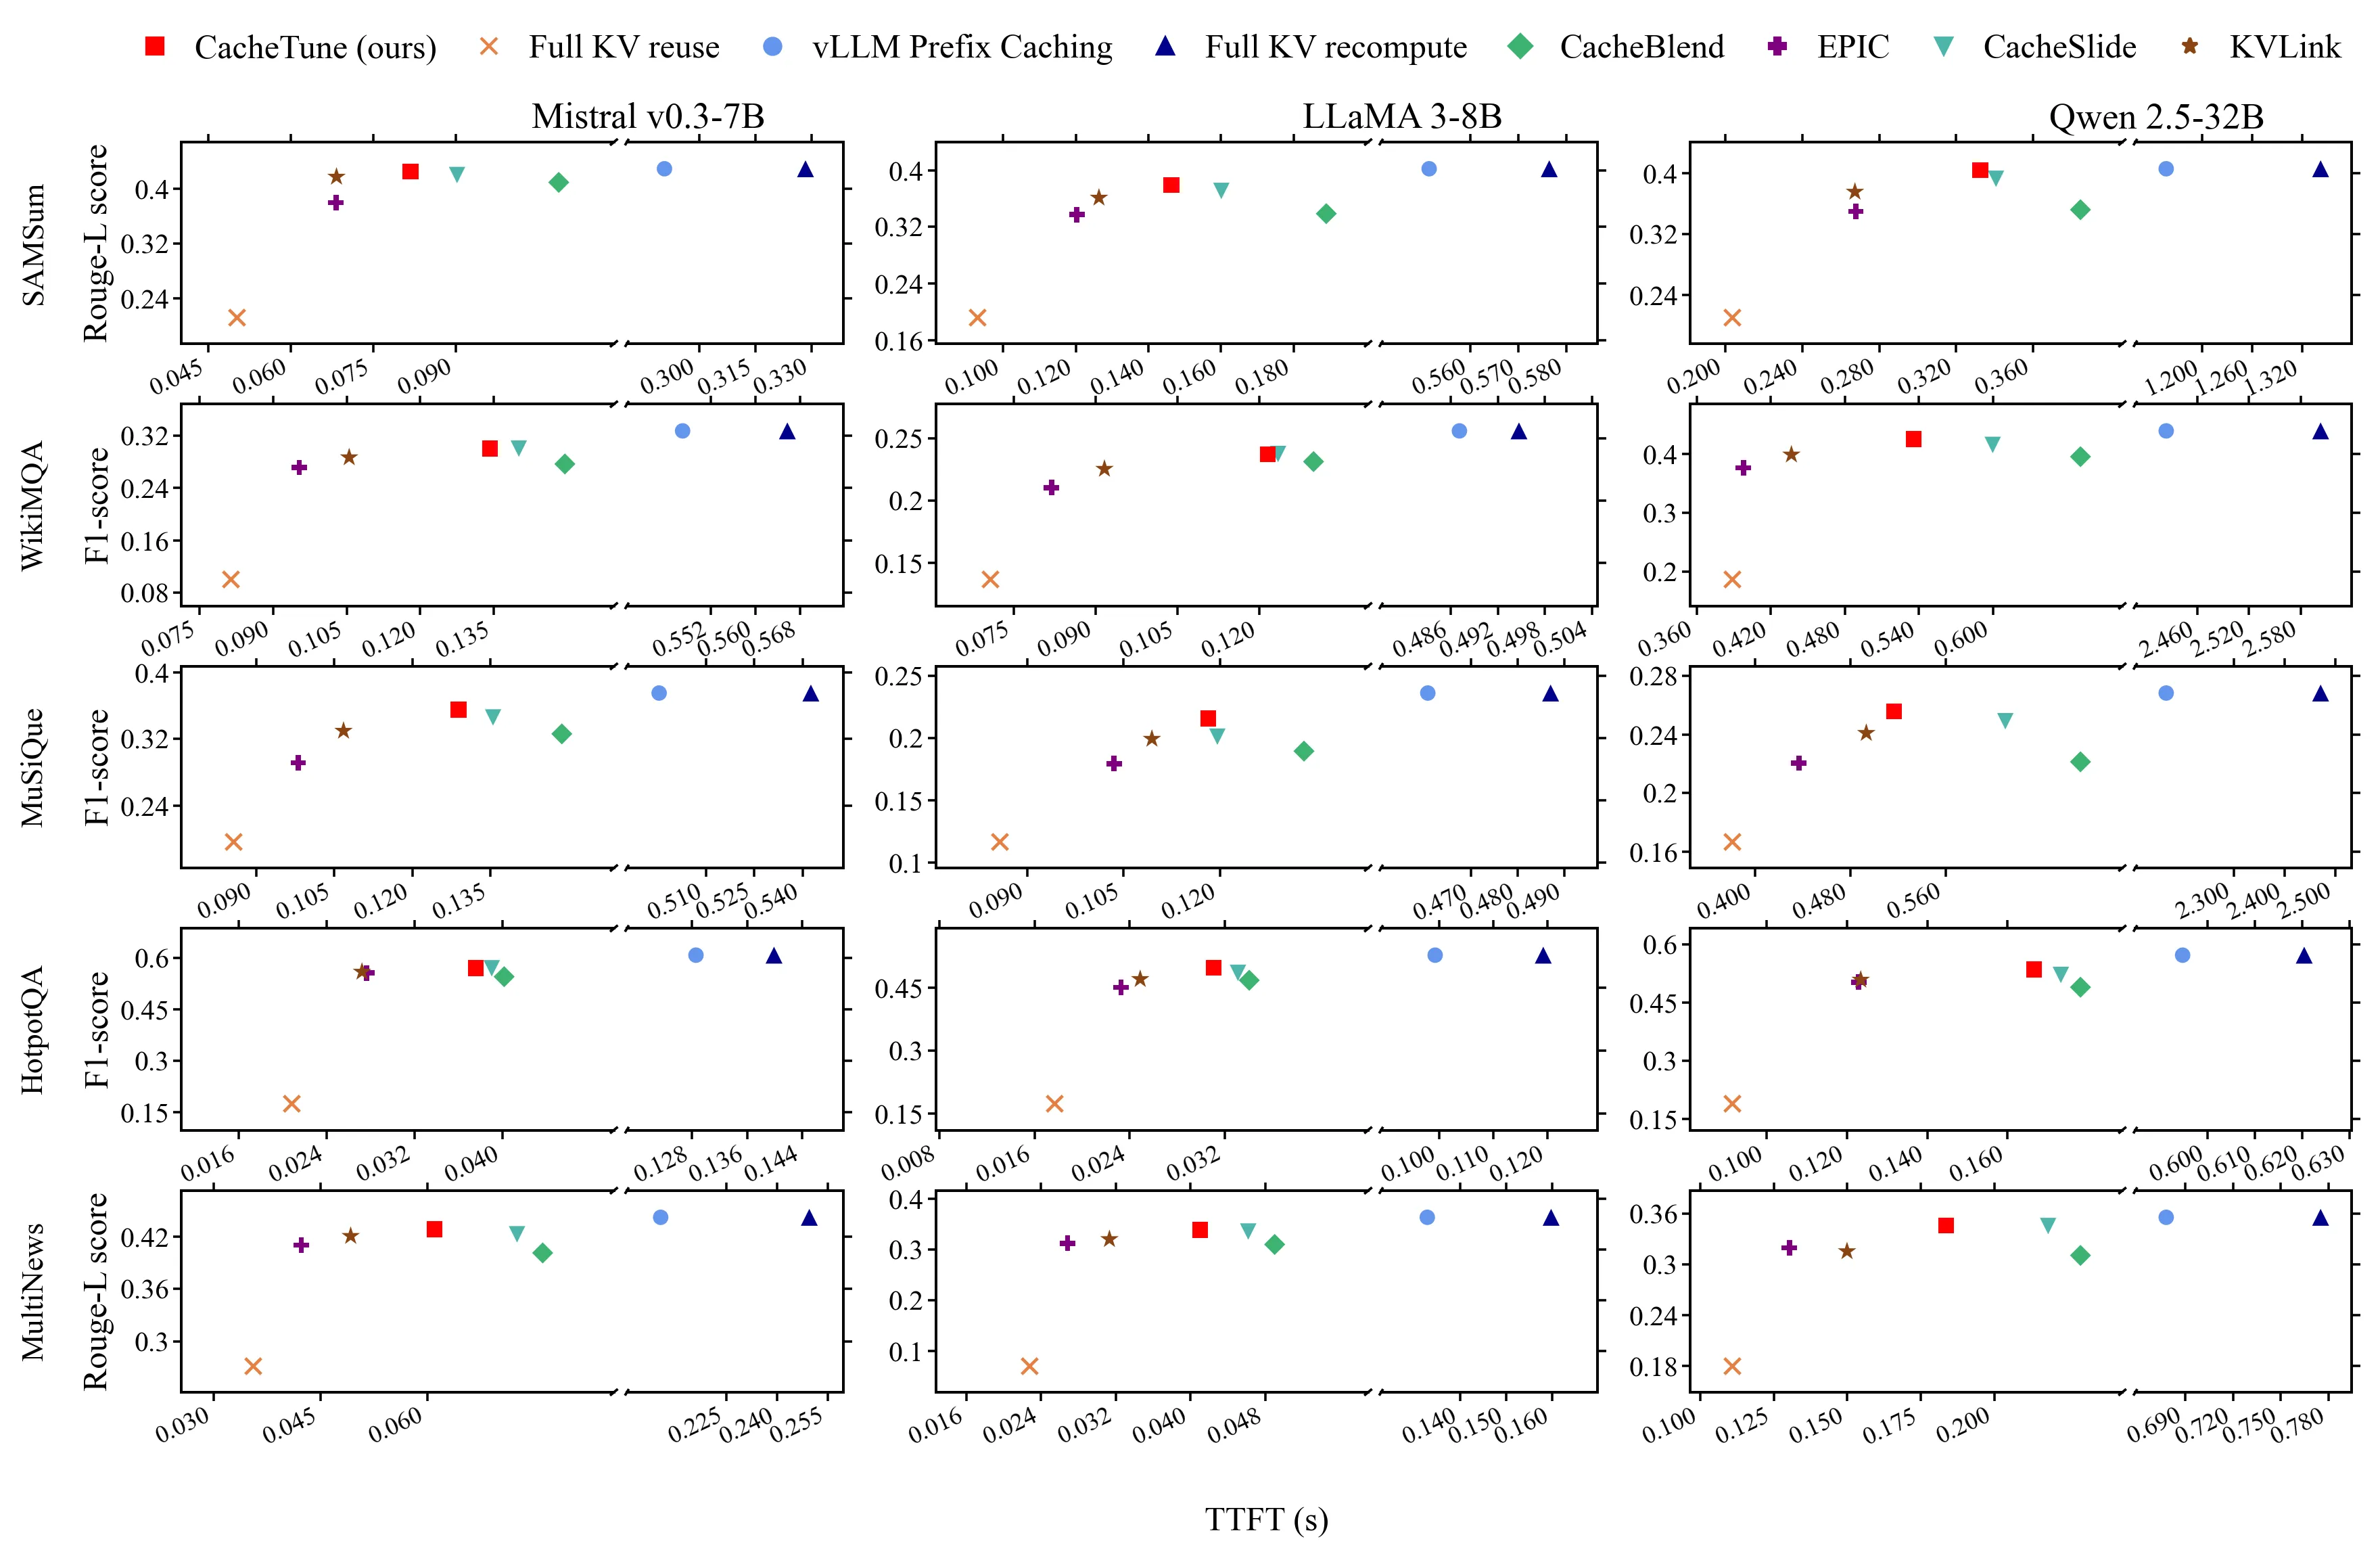
在不同模型和数据集任务上,CacheTune 在保持接近 full recompute 精度的同时,显著降低了 TTFT,优于 SOTA quality-latency trade-off 方法。
吞吐量表现
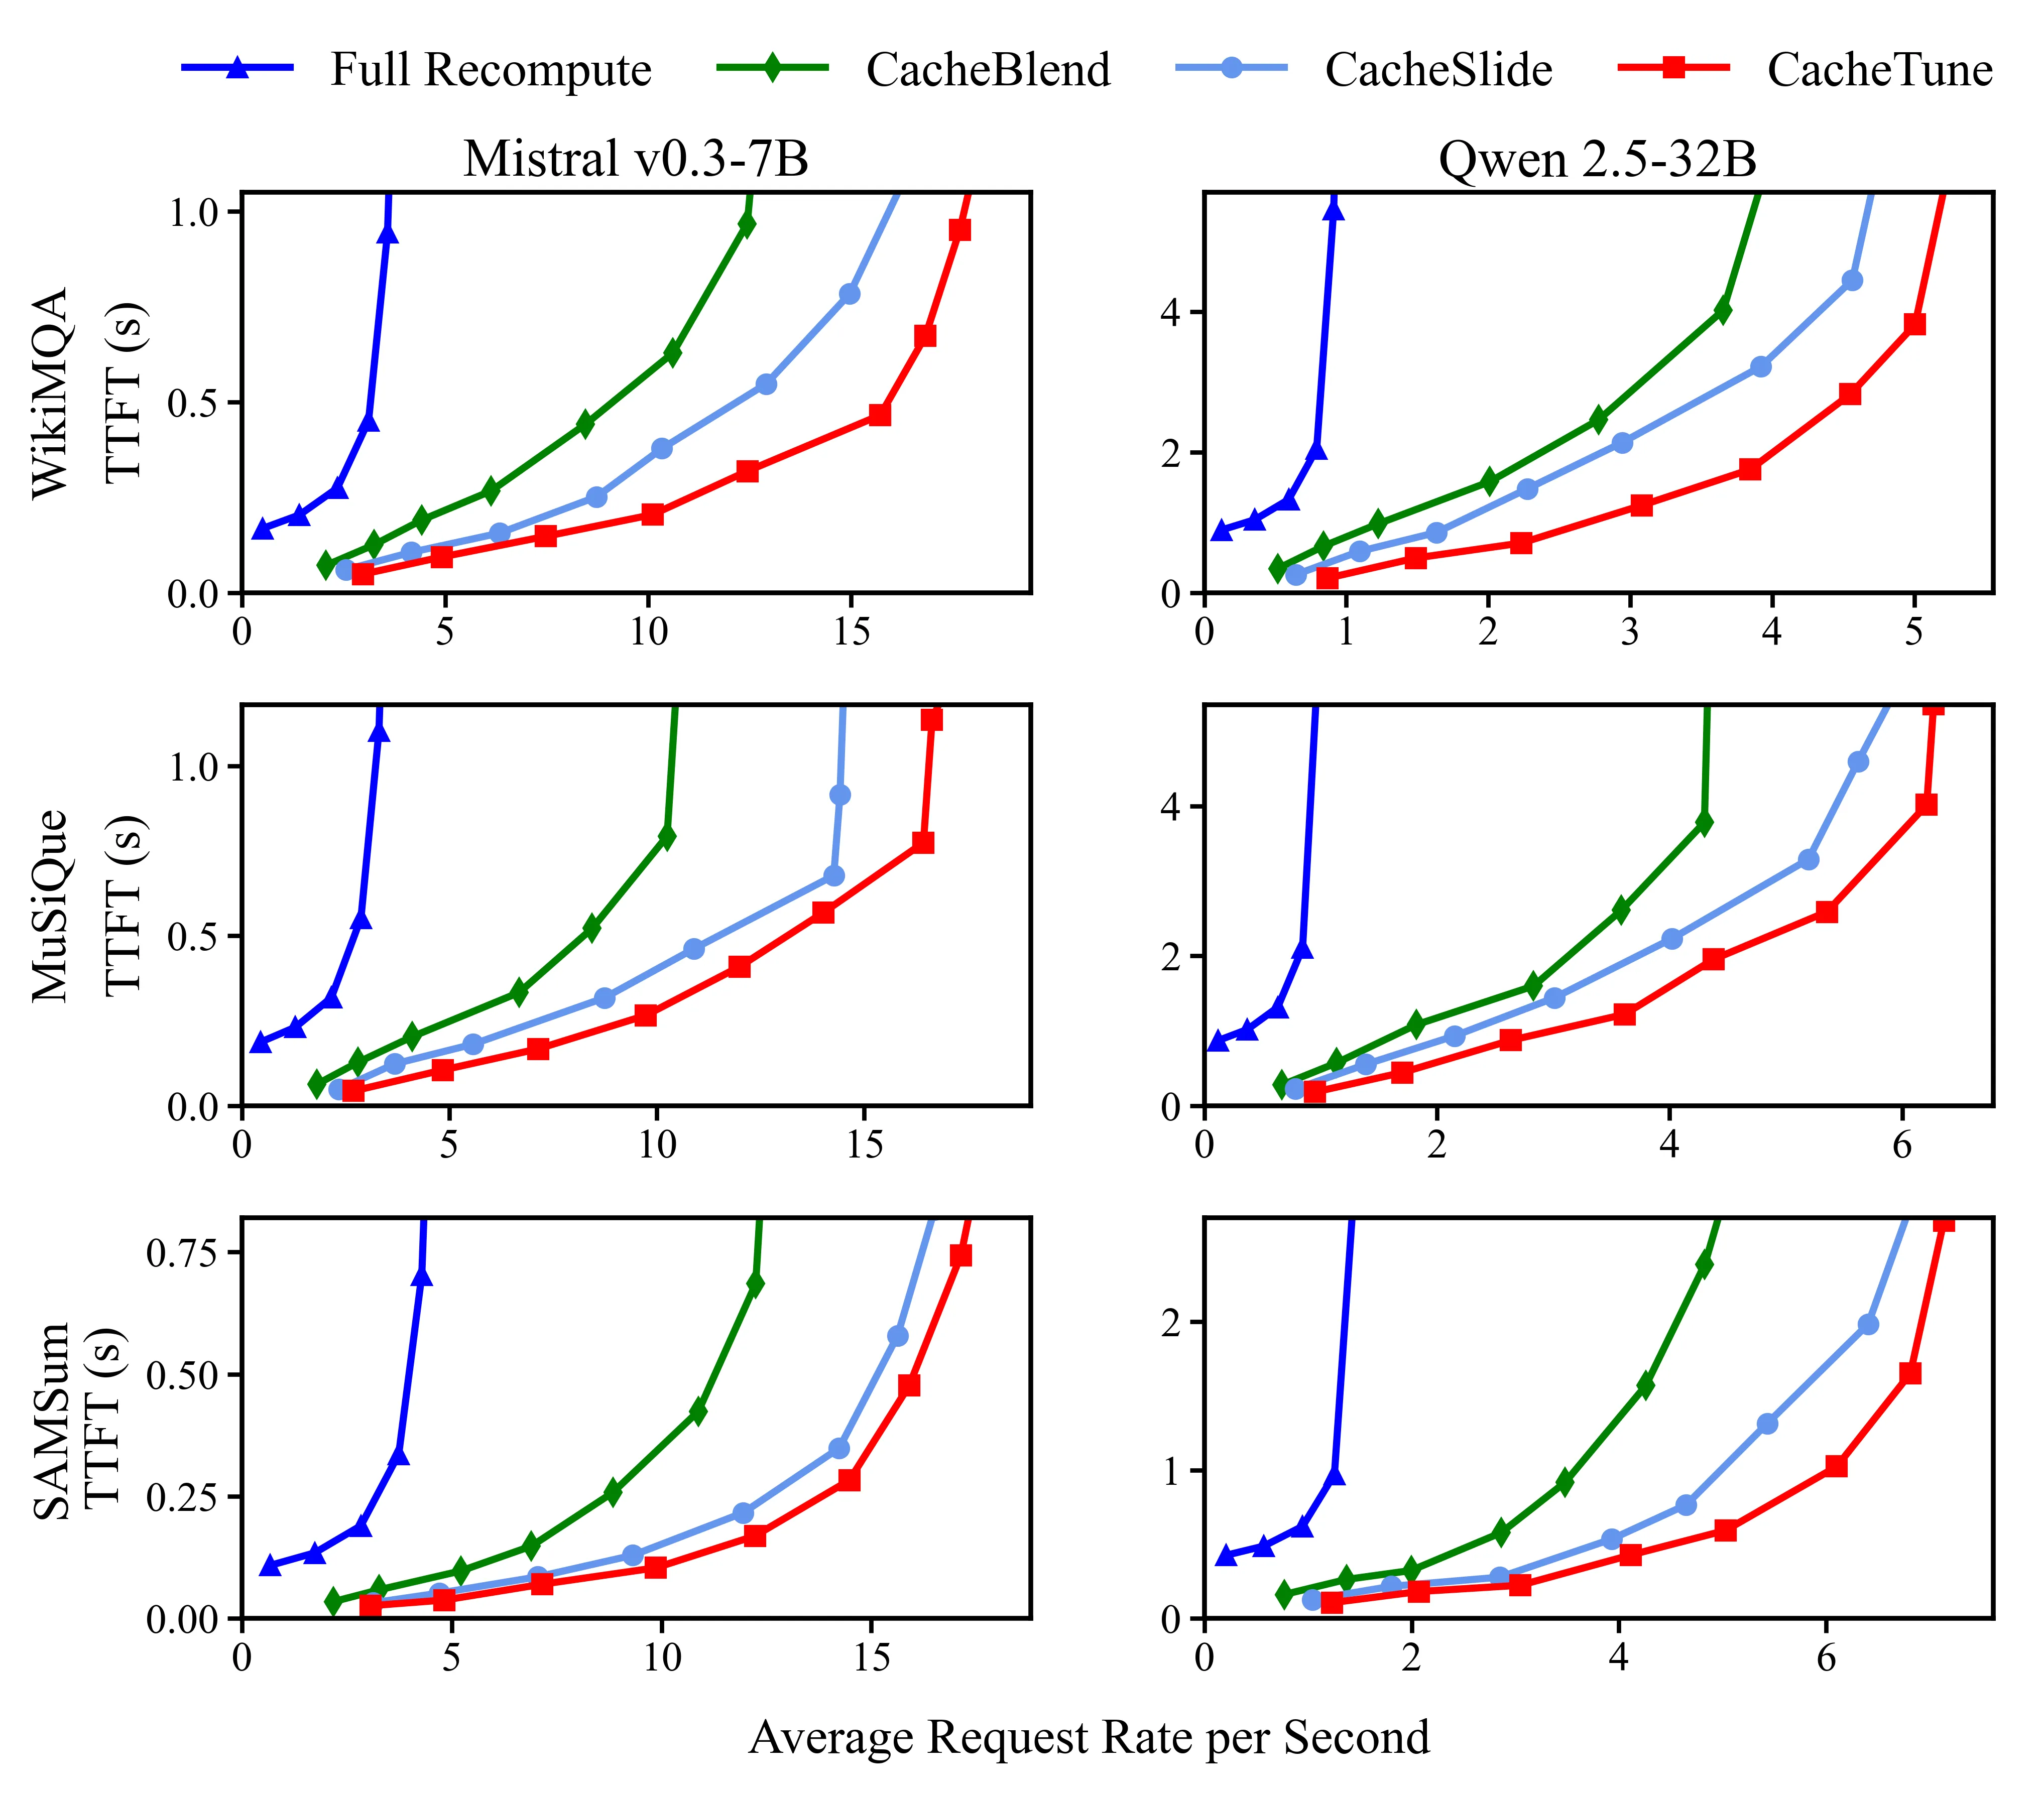
随着请求率增加,CacheTune 曲线向右延伸更远且 TTFT 更低,表明在低延迟服务下具有更高的有效吞吐量。
重计算比例影响
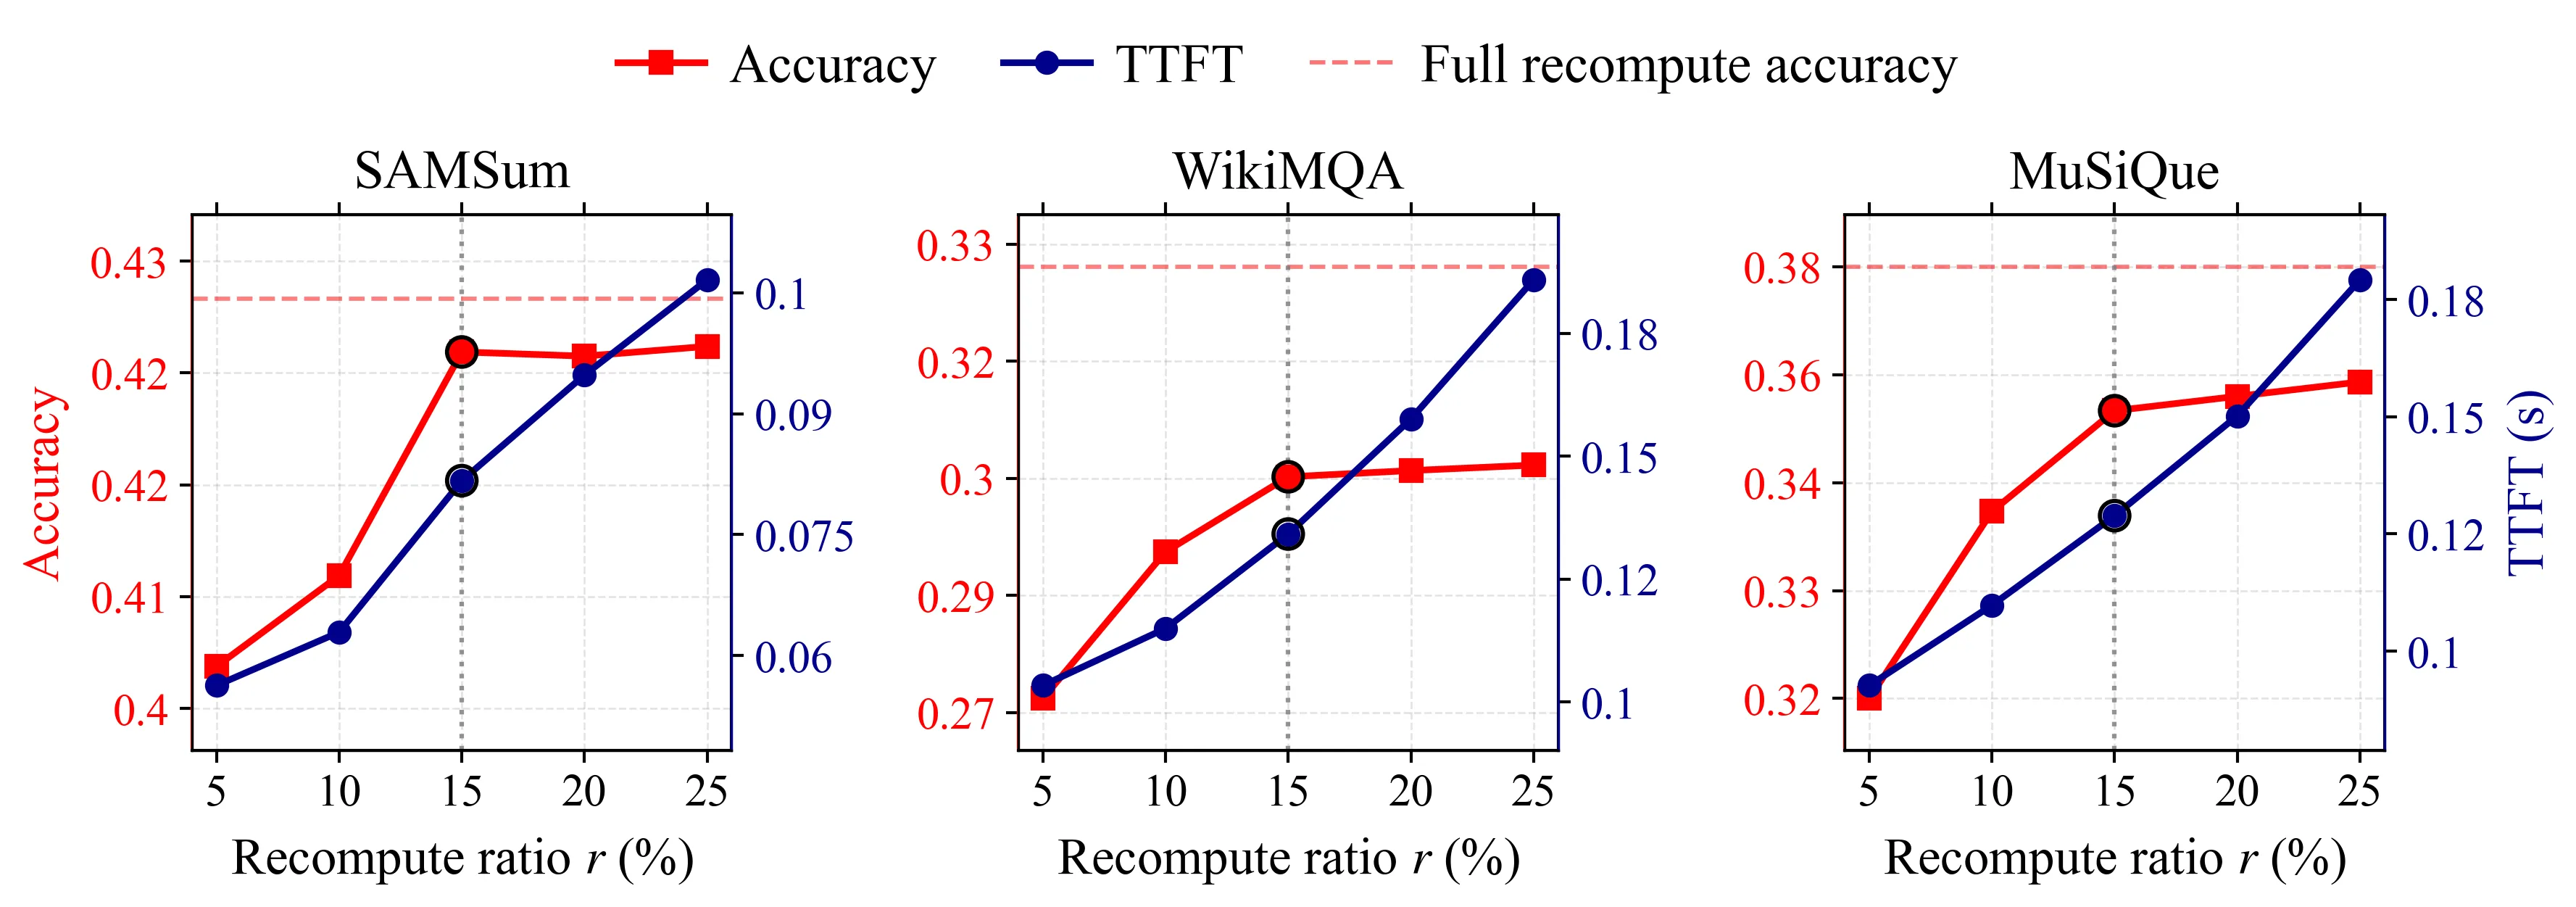
重计算比例 对准确率和 TTFT speedup 的影响:
- 较低时:TTFT speedup 高但准确率下降
- 较高时:准确率接近 full recompute 但 speedup 降低
- 存在最优 在 accuracy-speedup Pareto frontier 上
Token 选择策略对比
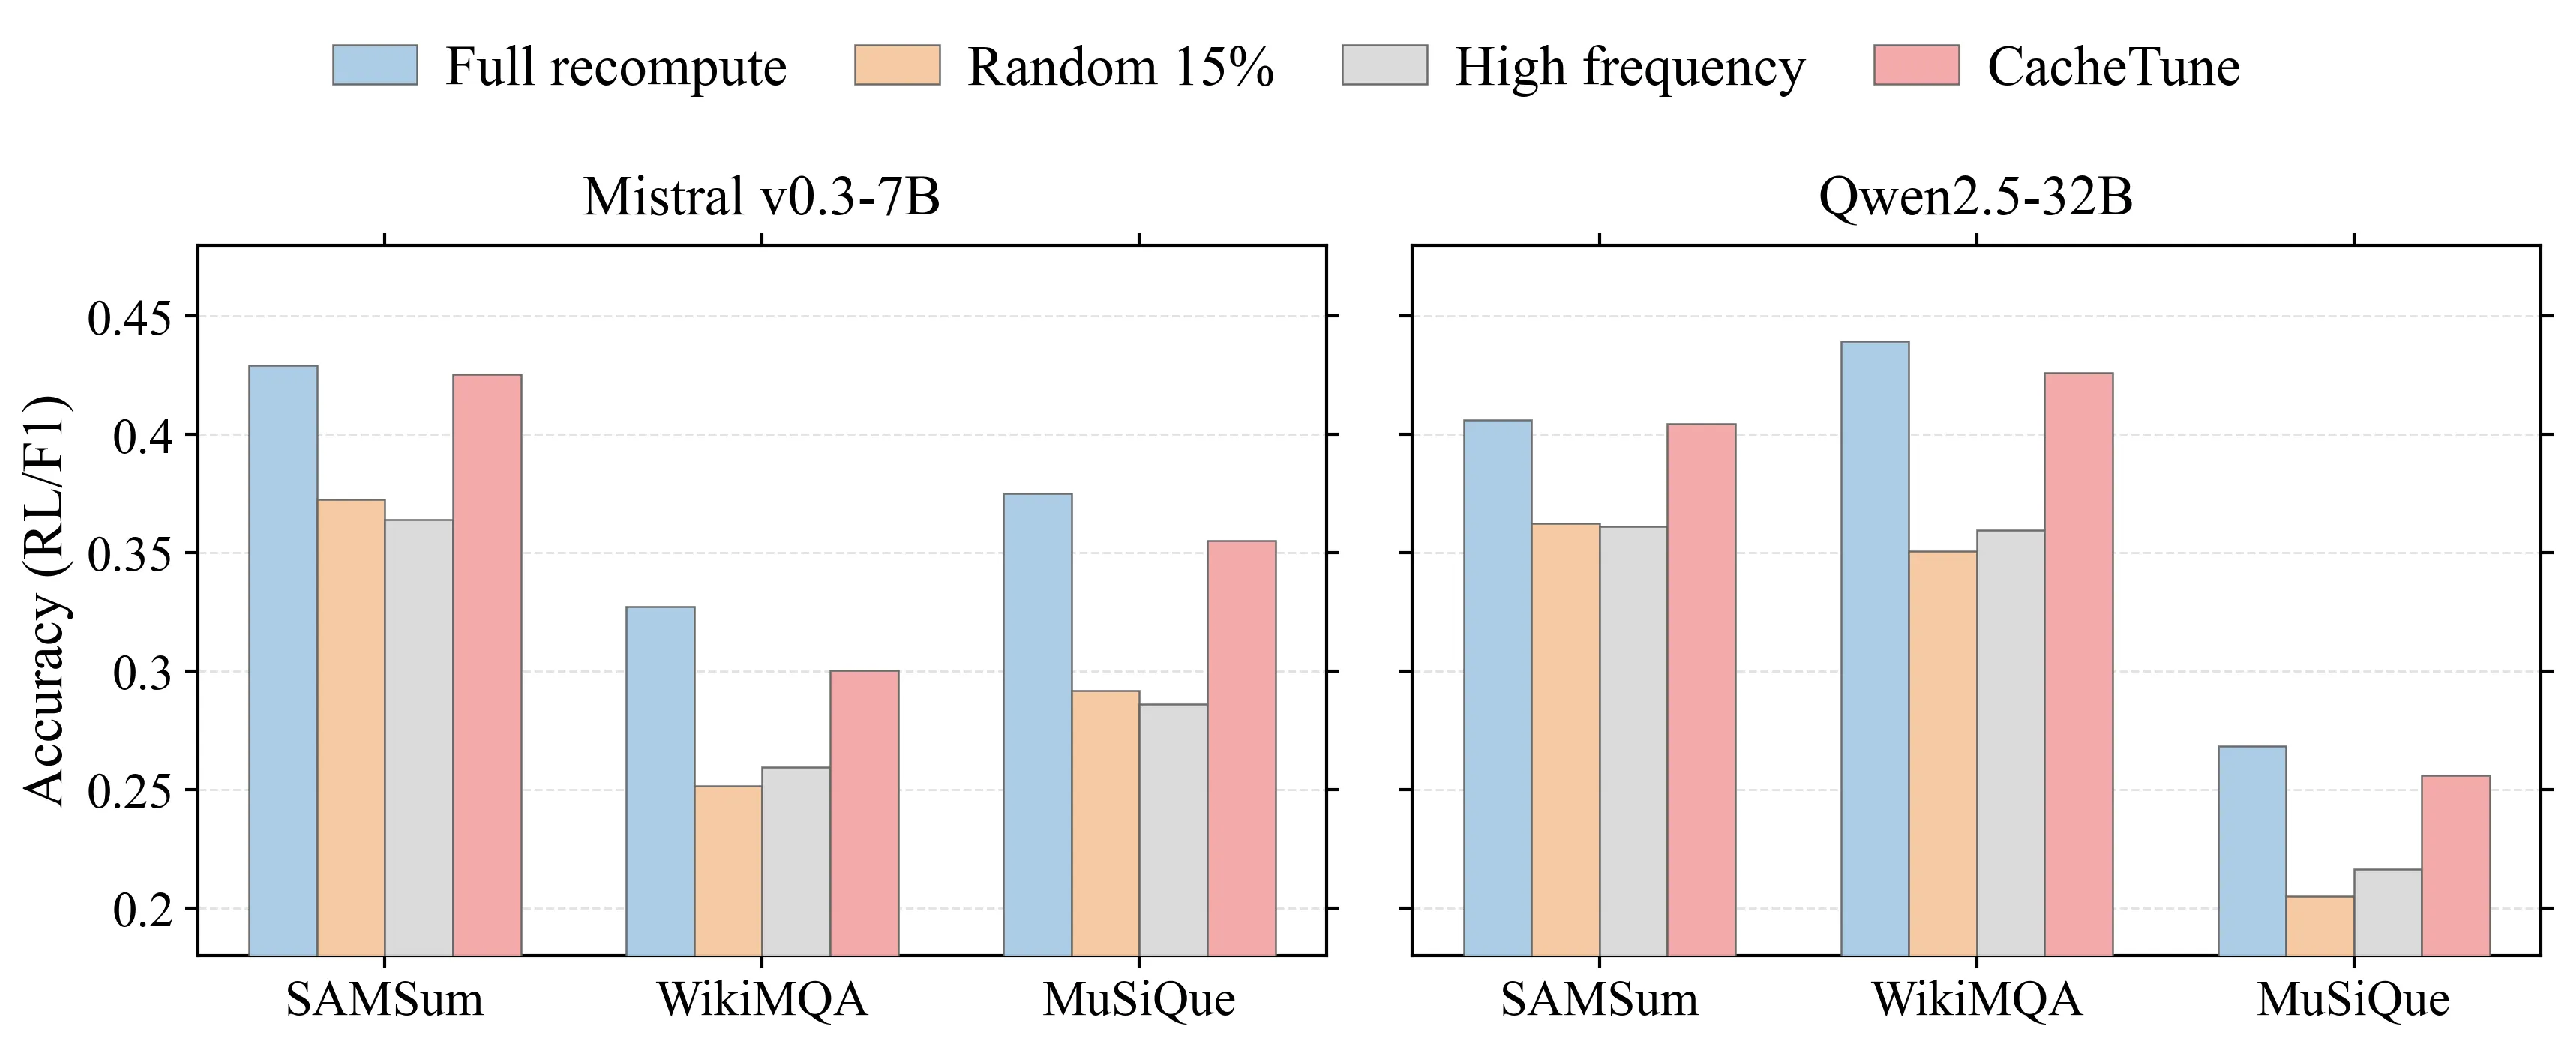
| 策略 | 效果 |
|---|---|
| 频域 low-freq (Ours) | 最佳 — 精准定位全局语义关键 token |
| Attention score | 次优 — 关注局部注意力而非全局语义 |
| Random | 较差 — 无差别选择 |
| High-freq | 最差 — 高频不携带全局语义信息 |
外部缓存介质对比
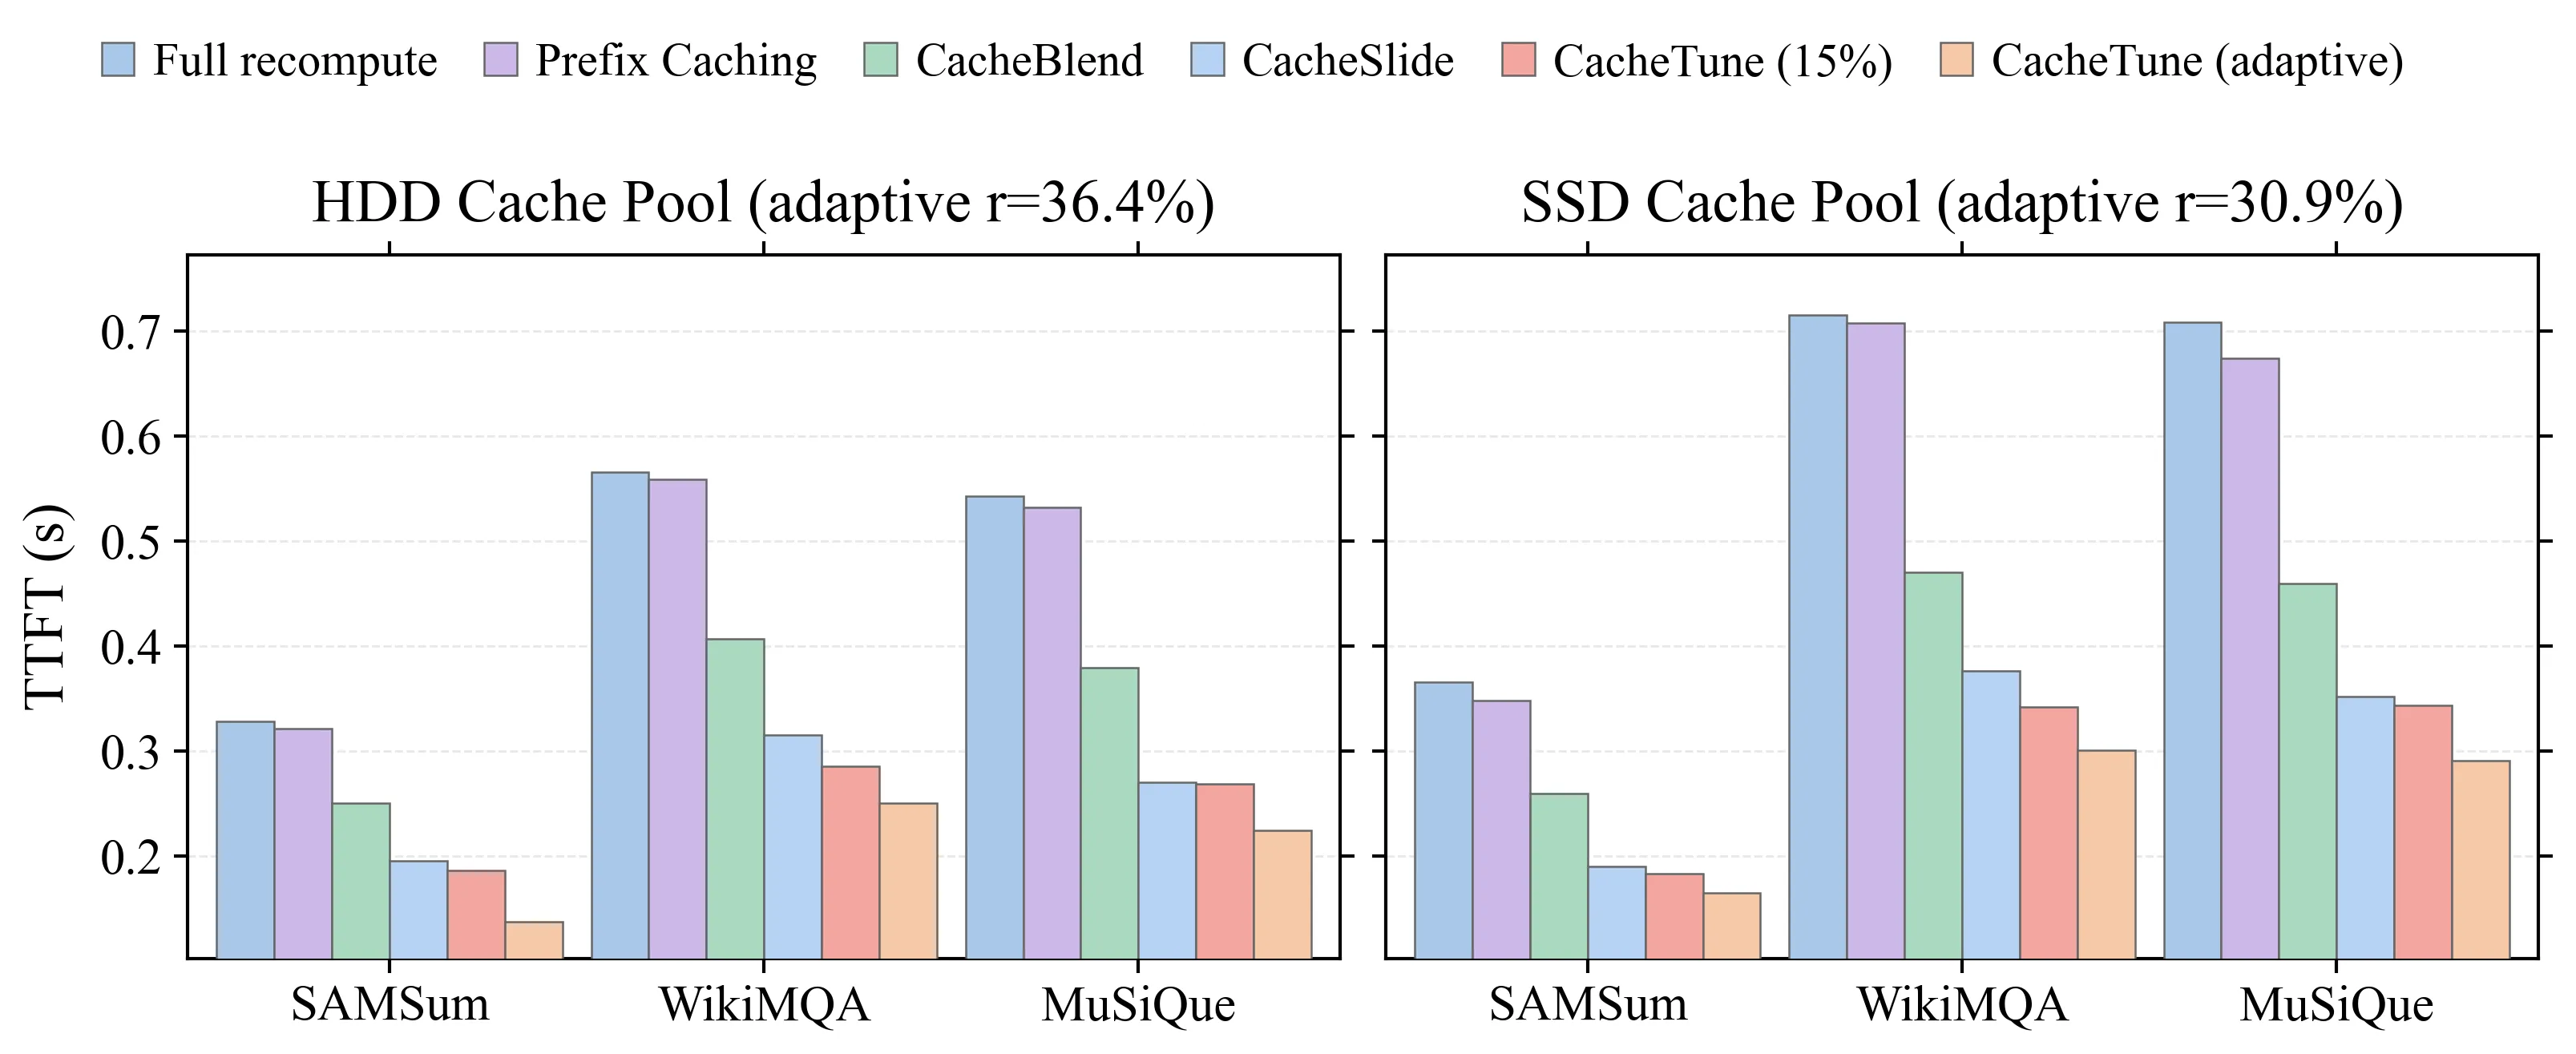
不同外部 KV Cache 介质和重计算策略下的 TTFT:
- GPU 内存:最低 TTFT,但容量有限
- CPU 内存:中等 TTFT,容量较大
- SSD:较高 TTFT,容量更大
- HDD:最高 TTFT,但 CacheTune 通过自适应重计算仍保持 2.34x+ speedup
六、相关工作
| 工作 | 关系 |
|---|---|
| Prefix Caching (Ye et al., 2024; Liu et al., 2023) | 仅适用于严格前缀场景,不适用于非 prefix 复用 |
| PagedAttention (vLLM, Kwon et al., 2023) | 改进 KV Cache 内存管理,但未解决非 prefix 复用问题 |
| KV Cache Offloading (Lee et al., 2024; Sheng et al., 2023) | 将 KV Cache 移到 CPU/磁盘,但未解决语义一致性问题 |
| Chunk-level KV Cache (Zheng et al., 2024) | 独立编码 chunks,缺少 cross-attention 恢复 |
| Positional Compensation (Yao et al., 2025; Hu et al., 2025) | 处理位置偏移但缺乏细粒度语义关键 token 识别 |
| Compute-I/O Co-design (Zhong et al., 2024; Ren et al., 2025) | 通用 compute-I/O 优化,未针对 KV Cache reuse 场景 |
七、总结
核心贡献
- 频率引导的 KV Cache 重要性建模:通过频域分析识别全局语义恢复最关键的 KV pairs,将粗粒度的重计算成本转化为精准的语义修复
- 索引感知的 KV 卸载和稀疏复用流水线:仅传输非重计算的 KVs,通过多 CUDA 流异步重叠稀疏传输、在线重计算和延迟位置编码恢复
- 硬件感知的自适应重计算比例模型:将在线重计算和外部缓存传输建模为两条可重叠的关键路径,结合硬件配置分析和经验校准搜索自适应确定最优比例
- 全面的实验评估:在多模型和长上下文任务上实现 3.72x-4.86x TTFT 加速和 3.93x-6.21x 吞吐提升,在 SSD/HDD 缓存下仍保持 2.34x-2.36x 加速
技术影响
- 为非 prefix KV Cache 复用提供了新范式:从粗粒度 chunk 级别细化到 token 级别的语义关键性判断
- 证明了频域分析在 LLM 系统中的价值:FFT 分析能有效识别全局语义关键 tokens
- 展示了算法-系统协同设计的威力:语义选择 + 硬件感知调度共同转化为端到端延迟收益
局限性
- 离线分析的假设:频域分析是一次性离线过程,可能无法适应模型更新后的新分布
- 重计算比例的搜索开销:硬件感知搜索需要一定的 profiling 时间
- 仅评估了特定 LLM 架构:主要面向 Transformer 架构,对 Mamba 等其他架构的适用性待验证
- 位置编码恢复的近似性:延迟恢复可能引入小幅精度损失
- 未评估多 GPU 场景:主要在单 GPU 设置下评估,多 GPU 分布式场景下的 I/O 耦合更复杂
八、参考资源
- arXiv: https://arxiv.org/abs/2605.24022
- HTML: https://arxiv.org/html/2605.24022v1
- vLLM: https://github.com/vllm-project/vllm (PagedAttention)
- 相关 KV Cache 工作: Prefix Caching, KV Offloading, Chunk-level Caching