Frontier: Towards Comprehensive and Accurate LLM Inference Simulation
面向现代 LLM 推理服务的离散事件模拟器,支持解耦架构、运行时优化和有状态工作负载,吞吐量误差低于 4%
Frontier: Towards Comprehensive and Accurate LLM Inference Simulation
论文信息: arXiv:2605.21312 [cs.DC] 13 Jun 2026
作者: Yicheng Feng, Xin Tan, Yangtao Deng, Yimin Jiang, Yibo Zhu, Hong Xu
机构: The Chinese University of Hong Kong, Anuttacon, StepFun
代码: https://github.com/NetX-lab/Frontier
许可: arXiv.org perpetual non-exclusive license
一、论文概述
1.1 研究背景
现代 LLM 服务系统已不再是同质化或单体化的架构。生产系统现在结合了解耦执行、复杂并行策略、运行时优化和有状态工作负载(如推理、Agent 和 RL rollout)。模拟是探索这一日益增长的设计空间的有效方法,但现有模拟器缺乏架构完整性和决策级保真度。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 架构不完整 | 现有模拟器假设同质单体复制集,不支持解耦架构 |
| 保真度不足 | 平均情况分析代理可能扭曲 SLA 预测,甚至反转优化结论 |
| 运行时优化缺失 | CUDA Graph、投机解码等优化未被正确建模 |
| 有状态工作负载 | 推理、Agent、RL rollout 等新兴工作负载的复杂性 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 解耦抽象 | 支持 PDD(Prefill-Decode 解耦)和 AFD(Attention-FFN 解耦)架构 |
| 运行时优化建模 | 正确建模 CUDA Graph、投机解码、前缀缓存等优化 |
| 高保真预测 | 吞吐量误差低于 4%,延迟误差从 44.9% 降至 6.4% |
| 可扩展性 | 支持超过 1K GPU 的模拟 |
二、核心思想
2.1 问题定义
现有 LLM 推理模拟器存在两个根本性缺陷:
1. 架构不完整:
- 大多数模拟器(如 Vidur、APEX)假设同质单体复制集
- 无法支持解耦架构(PDD、AFD)
- 运行时优化被视为分析补丁而非一等行为
2. 保真度不足:
- 平均情况分析代理无法捕捉批处理异质性
- 导致 SLA 预测错误,甚至优化结论反转
2.2 解决方案概述
Frontier 是一个面向现代 LLM 推理服务的离散事件模拟器,采用解耦抽象,将硬件感知预测与控制和执行平面分离。
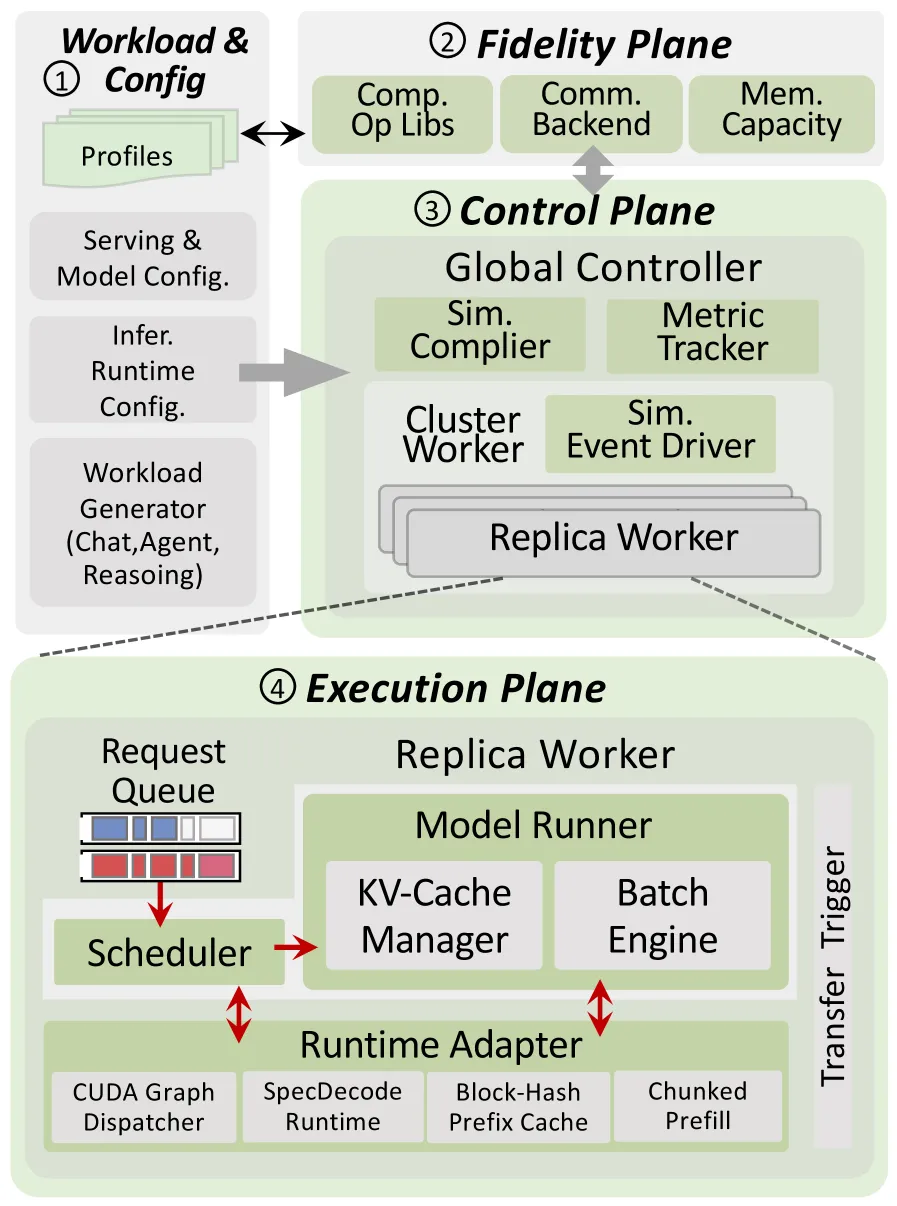 图 6:Frontier 系统架构。
三、技术架构
3.1 系统架构
Frontier 由四个模块组成:
| 模块 | 功能 |
|---|---|
| Workload and Config | 定义服务场景:模型、服务架构、并行策略、运行时选项、请求工作负载 |
| Fidelity Plan | 提供校准的每算子、通信和内存容量预测 |
| Control Plane | 提供解耦原语和基于依赖的控制流 |
| Execution Plane | 启用特性特定的执行流,推进请求通过调度、批处理、运行时适配和跨集群传输 |
3.2 解耦架构支持
Frontier 支持三种服务架构:
| 架构 | 说明 | 特点 |
|---|---|---|
| Co-location | Prefill 和 Decode 在同一集群 | 单调度器,KV 缓存共享 |
| PDD | Prefill-Decode 解耦 | 计算密集 Prefill 与内存密集 Decode 分离 |
| AFD | Attention-FFN 解耦 | Decode 阶段的 Attention 和 FFN 分离到不同硬件池 |
3.3 并行策略表达
Frontier 引入双域分解来表达并行策略:
- Replica 参数化:
- :Pipeline 并行度
- :Attention 张量并行度
- :Attention 数据并行度
- :FFN 张量并行度
- :FFN 专家并行度
3.4 保真度平面
保真度平面提供三类预测:
| 预测类型 | 说明 |
|---|---|
| 算子延迟 | 基于核函数级建模,支持 BF16/FP8 |
| 通信成本 | 建模跨集群 KV 缓存传输和激活传输 |
| 内存容量 | KV 缓存预算建模,考虑非 KV 缓存内存开销 |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 解耦抽象 | 支持 PDD 和 AFD 架构 | 系统架构设计 |
| 运行时优化建模 | CUDA Graph、投机解码、前缀缓存 | 事件级建模 |
| 有状态工作负载 | 支持推理、Agent、RL rollout | 多阶段推理调度 |
| 核函数级保真度 | 逐算子延迟预测 | 实验验证 |
4.2 CUDA Graph 建模
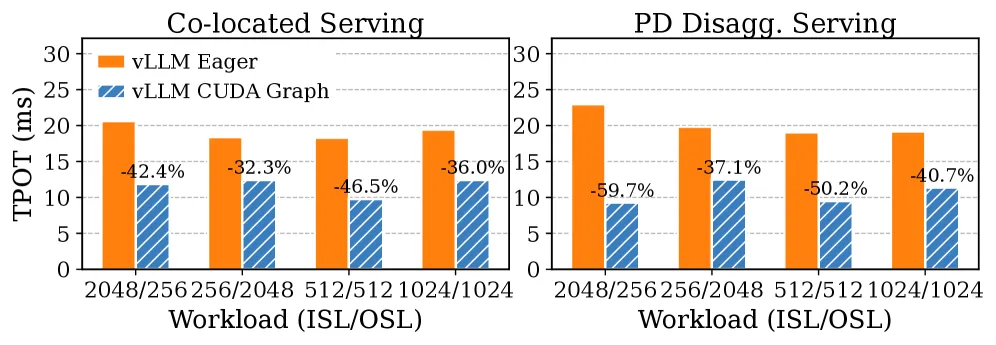 图 1:CUDA Graph 对 TPOT 的影响。
关键发现:
- Frontier 在 co-location 下匹配 vLLM 的解码加速(误差 1.7%)
- 在 PDD 下误差 6.1%,保持 2.86-3.05× 加速包络
- AIConfigurator 忽略图捕获建模,产生工作负载无关的 TPOT 表面
4.3 投机解码建模
事件级 MTP 建模:
- 追踪每个请求的计划、验证、接受和提交 token
- 将 MTP 建模为 draft→verify→commit 循环
- 保留批内每请求的投机深度和接受方差
结果:TTFT、TPOT、吞吐量和 E2E p95 误差均在 11.28% 以内。
五、代码实现分析
5.1 项目结构
| 组件 | 说明 |
|---|---|
| Control Plane | 仿真编译器、并行原语、依赖控制流 |
| Execution Plane | 调度器、批处理引擎、运行时适配器 |
| Fidelity Plane | 算子延迟预测、通信成本预测、内存容量预测 |
| Workload Generator | 请求到达事件生成 |
5.2 关键实现
- 事件驱动仿真循环:每个 Cluster Worker 由独立的离散事件引擎驱动
- 跨集群协调:通过集群间事件队列协调解耦架构
- 指标追踪:记录每个请求的完整生命周期
六、实验结果
6.1 算子保真度
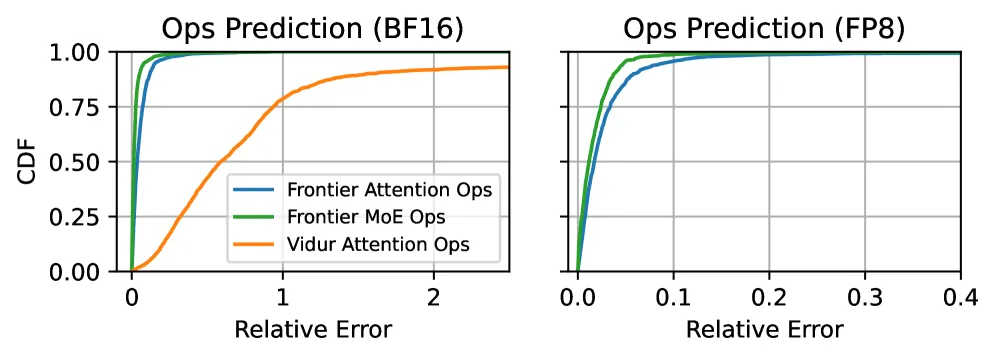 图 7:H800 上 attention 和 MoE 算子的相对误差 CDF。
BF16 结果:
| 算子 | p50 误差 | p95 误差 |
|---|---|---|
| Attention | 3.5% | 14.2% |
| Linear | 3.3% | 6.4% |
| GroupedGEMM | 1.4% | 5.3% |
FP8 结果:
- Attention p95 误差降至 8.8%
Vidur 对比:
- Attention p50/p95:55.4%/376.1%(token-only 预测器)
- GroupedGEMM:未定义
6.2 内存保真度(KV 缓存预算)
| 模式 | 并行配置 | vLLM | Frontier 误差 | 分析基线误差 |
|---|---|---|---|---|
| Co-loc | (1,8,1,8) | 31k | +0.02% | +14.10% |
| Co-loc | (4,2,1,2) | 58.0k | +1.76% | +21.38% |
| Disagg | (2,2,2,4) | 27.0k | +1.89% | +27.95% |
| Disagg | (1,4,1,4) | 12.0k | +0.01% | +39.73% |
关键发现:分析基线高估可用块数 14.10%-39.73%,因为忽略了运行时非 KV 缓存内存开销。
6.3 端到端保真度
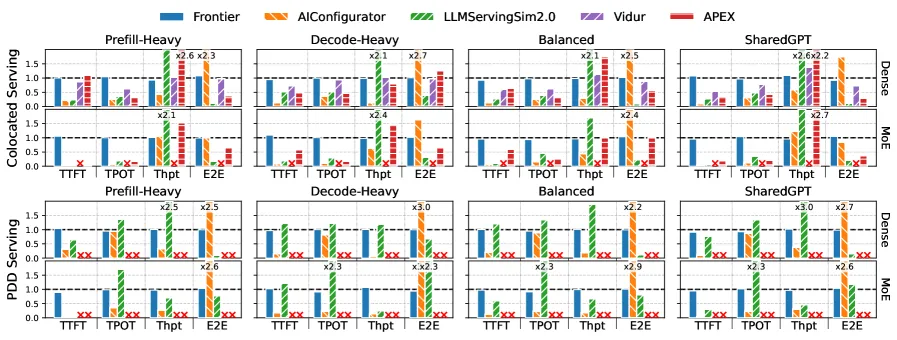 图 11:16 卡 H800 测试平台上的端到端保真度。
Co-location 结果:
- Frontier 在 32 个案例中跟踪 vLLM 误差在 9.37% 以内
- TPOT-p95 和 E2E makespan 在除一个案例外均在 6.4% 以内
- Vidur 误差范围:2.9%-45.5%
PDD 结果:
- Frontier 平均误差:TTFT 2.75%,TPOT 4.37%,吞吐量 0.80%,E2E 5.01%
6.4 与现有模拟器对比
| 模拟器 | 支持 PDD | 支持 AFD | 支持 MoE | 支持 CUDA Graph | 支持投机解码 |
|---|---|---|---|---|---|
| Frontier | ✓ | ✓ | ✓ | ✓ | ✓ |
| AIConfigurator | ✓ | ✗ | ✓ | ✗ | 有限 |
| Vidur | ✗ | ✗ | ✗ | ✗ | ✗ |
| LLMServingSim2.0 | ✗ | ✗ | ✓ | ✗ | ✗ |
| Apex | ✗ | ✗ | 有限 | ✗ | ✗ |
七、应用场景
7.1 SLA 依赖的 Pareto 前沿探索
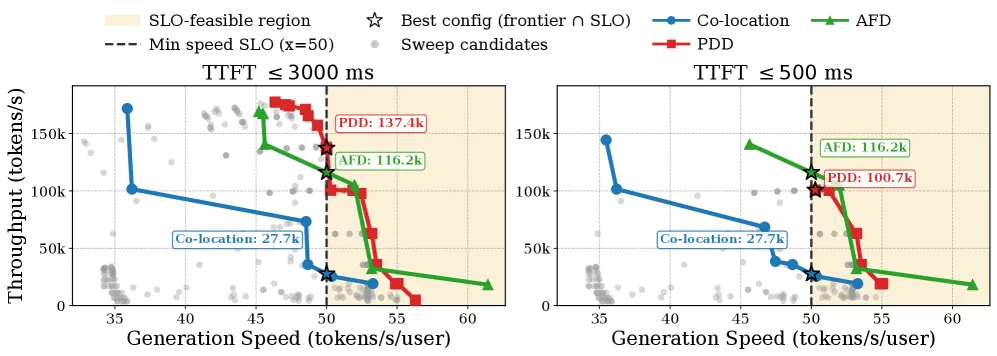 图 13:256×H800 GPU 上的吞吐量-生成速度 Pareto 前沿。
关键发现:
- 松弛 TTFT 约束(≤3000ms):PDD 最优,达 137.4K toks/s
- 严格 TTFT 约束(≤500ms):AFD 最优,达 116.2K toks/s
- Co-location 仅达 27.7K toks/s
7.2 异构 GPU 解耦服务
问题:在解耦架构中,异构 GPU 如何影响性能-成本权衡?
发现:
- PDD 和 AFD 可以将硬件折扣转化为成本效率
- 不同角色分配产生不同的性能-成本曲线
7.3 有状态推理调度验证
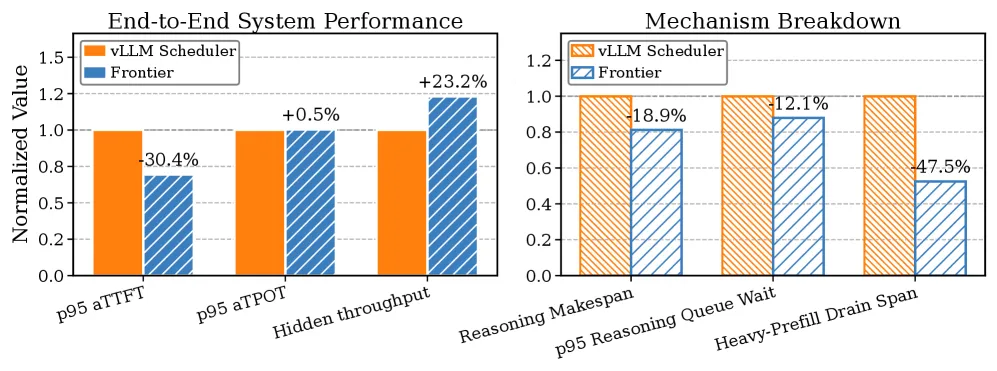 图 15:多轮推理的相位感知调度。
问题:现有调度器(如 vLLM)无法有效处理多阶段推理工作负载。
解决方案:提出 H2Q-BR(History-Aware Two-Queue Scheduling with Bounded Release)调度算法。
7.4 RL Rollout 动态并行重配置
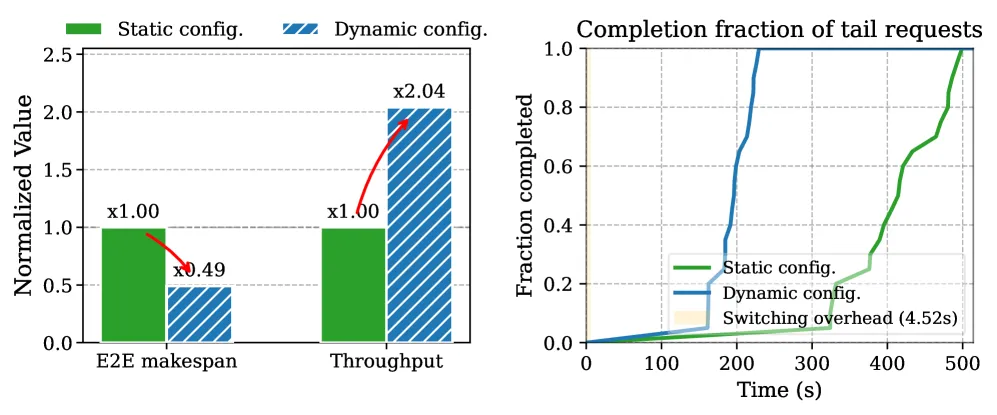 图 16:动态重配置的性能增益。
问题:RL 训练的 rollout 阶段需要动态调整并行策略。
发现:Frontier 可以验证动态并行重配置策略的有效性。
八、总结
8.1 核心贡献
- 解耦抽象:支持 PDD 和 AFD 架构,正确建模跨集群数据传输
- 运行时优化建模:CUDA Graph、投机解码、前缀缓存等优化的一等建模
- 高保真预测:吞吐量误差低于 4%,延迟误差显著降低
- 可扩展性:支持超过 1K GPU 的模拟
- 应用场景:SLA 优化、异构 GPU 分配、调度算法验证、RL 重配置
8.2 技术影响
- 系统设计:为解耦架构提供准确的性能建模工具
- 资源优化:支持 SLA 依赖的 Pareto 前沿探索
- 算法验证:为新兴调度算法和运行时优化提供验证平台
- 成本优化:支持异构 GPU 分配的成本效率分析
8.3 局限性
- AFD 实现:目前使用内部实现,缺乏公开的 AFD 实现
- 模型支持:主要验证了 MoE 和 dense 模型,其他架构需进一步验证
- 硬件覆盖:主要在 H800 上验证,其他 GPU 类型需进一步测试
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2605.21312
- PDF: https://arxiv.org/pdf/2605.21312
- 代码: https://github.com/NetX-lab/Frontier
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | CUDA Graph 影响 | figure-1-cuda-graph-impact.png |
| 图 6 | 系统架构 | figure-6-system-architecture.png |
| 图 7 | 算子误差 CDF | figure-7-operator-error-cdf.png |
| 图 11 | 端到端保真度 | figure-11-e2e-fidelity.png |
| 图 13 | Pareto 前沿 | figure-13-pareto-frontiers.png |
| 图 15 | 相位感知调度 | figure-15-phase-aware-scheduling.png |
| 图 16 | 动态重配置 | figure-16-dynamic-reconfiguration.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Vidur | Agrawal et al. | 2024 | 离散事件模拟器,缺乏解耦支持 |
| AIConfigurator | Xu et al. | 2026 | NVIDIA SOTA 模拟器,分析工作流 |
| vLLM | Kwon et al. | 2023 | 推理引擎,Ground Truth |
| SGLang | Zheng et al. | 2024 | 推理引擎,前缀缓存 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| Prefill-Decode 解耦 | Prefill-Decode Disaggregation (PDD) | 将计算密集 Prefill 与内存密集 Decode 分离 |
| Attention-FFN 解耦 | Attention-FFN Disaggregation (AFD) | 将 Decode 阶段的 Attention 和 FFN 分离 |
| 离散事件模拟 | Discrete-Event Simulation | 基于事件驱动的仿真方法 |
| CUDA Graph | CUDA Graph | 减少内核启动开销的优化技术 |
| 投机解码 | Speculative Decoding | 加速自回归生成的技术 |
| KV 缓存预算 | KV-cache Budget | 可用于存储 KV 缓存的内存容量 |
分析完成时间:2026年6月23日 分析工具:Claude Code + paper-analyzer skill