Towards Multi-Model LLM Schedulers: Empirical Insights into Offloading and Preemption
多模型LLM调度的实证研究,分析CPU-GPU卸载和抢占的性能影响,为下一代调度系统提供设计指导
Towards Multi-Model LLM Schedulers: Empirical Insights into Offloading and Preemption
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Towards Multi-Model LLM Schedulers: Empirical Insights into Offloading and Preemption |
| 作者 | Mert Yildiz, Pietro Spadaccino, Alexey Rolich, Francesca Cuomo, Andrea Baiocchi |
| 机构 | 未明确标注(EU RESTART项目资助) |
| 论文 | arXiv:2605.19593 |
| 会议 | 2026 Mediterranean AI and Networking Conference (MAIN 2026) |
| 发布 | 2026年5月19日 |
| 许可 | IEEE(个人使用许可) |
二、核心思想
本文对多模型LLM调度进行实证研究,重点分析CPU-GPU层卸载和作业级抢占的性能影响。核心发现包括:
- 非线性卸载退化:解码吞吐量随GPU层比例呈非线性退化,小模型对卸载更敏感
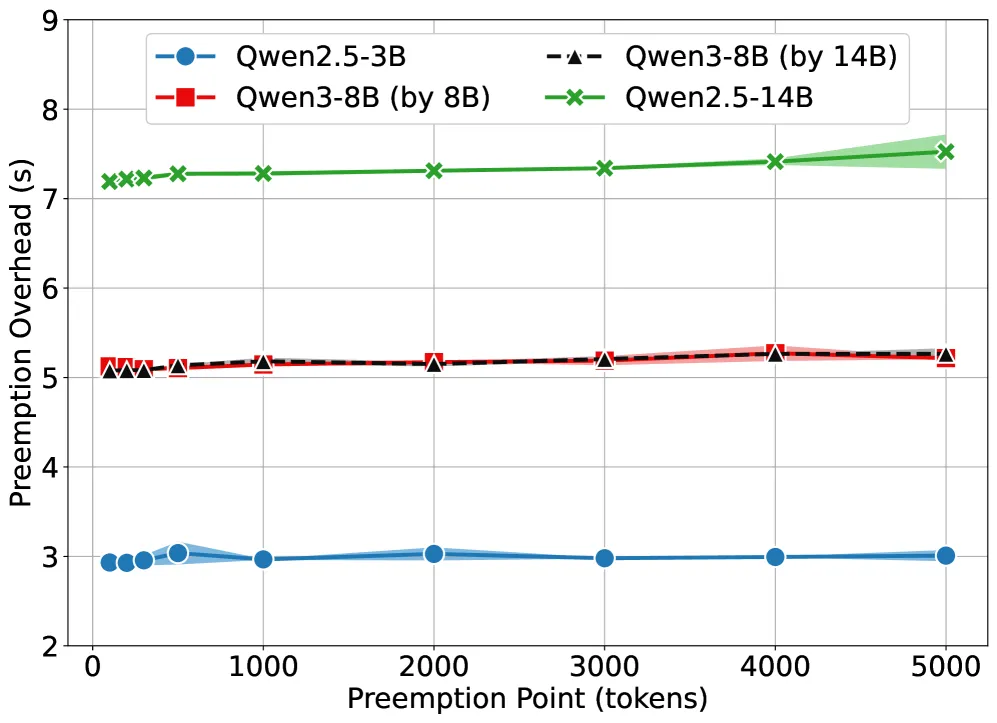
- 抢占开销恒定:抢占开销与被中断作业的进度无关,模型重载占99%以上开销
- KV缓存传输微小:KV缓存传输仅占抢占总开销的1-1.5%,但随序列长度线性增长
- 硬件感知必要性:不同GPU的性能差距影响卸载惩罚和抢占成本
问题定义
当前LLM服务系统的核心挑战:
- 多模型部署:实际部署涉及多个异构模型,而非单一模型
- 资源竞争:多个模型在共享异构硬件上竞争GPU内存和计算资源
- 现有系统局限:vLLM等主要优化单模型吞吐量,未解决多模型调度问题
解决方案概述
本文通过系统实证研究识别下一代调度器必须考虑的关键特征:
- 模型特定的卸载敏感性
- 工作负载特征(序列长度、输出长度)
- 抢占和数据传输的成本结构
- 硬件特性(GPU能力、CPU吞吐量、互连带宽)
三、技术架构
实验设置
硬件平台:
- Server 1:AMD Threadripper PRO 5995WX + 2× NVIDIA RTX 5000 Ada (32GB VRAM, PCIe Gen4 x16)
- Server 2:同CPU + 2× NVIDIA RTX A6000 (48GB VRAM, PCIe Gen4 x16)
- 共享CPU子系统,差异仅在GPU硬件
模型配置:
| 实验 | 模型 | 参数量 | FP16大小 | 量化格式 |
|---|---|---|---|---|
| 卸载 | Llama 3 8B | 8B | - | Q4 |
| Qwen3-32B | 32B | - | Q4 | |
| Llama 2 70B | 70B | - | Q4 | |
| 抢占 | Qwen2.5-3B | 3B | 5.9 GB | FP16 |
| Qwen3-8B | 8B | 15.6 GB | FP16 | |
| Qwen2.5-14B | 14B | 28.3 GB | FP16 |
卸载实验设计
通过Ollama v0.17.7控制GPU层比例,从0%(全CPU)到100%,以10%为步长,附加92%/94%/96%/98%细粒度点:
- 3模型 × 13-15唯一GPU放置 × 6输出长度(50/150/300/500/1000/5000 token) × 3重复
- 每次调用前卸载并重载模型以确保干净的层放置
抢占实验设计
生成7000 token的Job A,在9个检查点(N∈{100,200,300,500,1000,2000,3000,4000,5000})中断:
- 4种模型配对:Qwen2.5-3B→Qwen3-8B, Qwen3-8B→Qwen3-8B, Qwen3-8B→Qwen2.5-14B, Qwen2.5-14B→Qwen3-8B
- 每种配对2次重复,对比不间断基线
- Job A使用贪婪解码
核心公式
解码吞吐量:
归一化吞吐量:
抢占开销占比:
KV缓存增长率:
- Qwen2.5-3B: 0.035 MB/token
- Qwen3-8B: 0.14 MB/token
- Qwen2.5-14B: 0.19 MB/token
四、核心发现
卸载性能分析
发现1:非线性退化
- 吞吐量随GPU层比例呈非线性关系,显著偏离线性参考
- 小模型(Llama3-8B)对卸载更敏感,中等CPU卸载导致显著性能下降
- 大模型(Llama2-70B)展现更平缓的退化曲线,对异构执行更宽容
发现2:模型大小依赖
- 小模型:接近100% GPU时吞吐量急剧上升,部分卸载惩罚大
- 大模型:随GPU分配增加,吞吐量近似线性改善
- 这一趋势在所有GPU架构上一致
发现3:硬件敏感性
- RTX 5000上归一化吞吐量始终高于RTX A6000
- 原因:RTX 5000与CPU性能差距较小,CPU卸载的相对惩罚较低
- 高端GPU可能遭受更严重的卸载惩罚
抢占开销分析
发现4:开销恒定
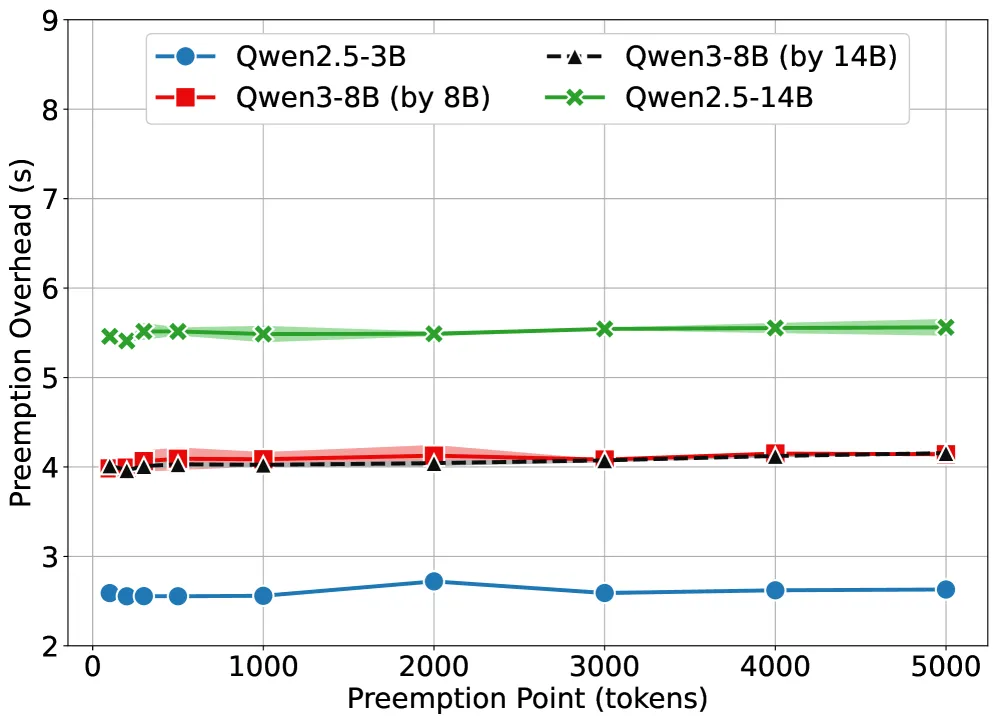
- 抢占开销与被中断作业的进度几乎无关(曲线平坦)
- 原因:模型重载占总开销99%以上
发现5:模型大小主导
- RTX 5000:Qwen2.5-3B约3s,Qwen3-8B约5.1s,Qwen2.5-14B约7.3s
- RTX A6000:对应2.6s、4s、5.7s(更低绝对开销)
- 抢占模型大小对开销无影响
发现6:相对开销小
- 单次抢占仅增加1.7-2%端到端完成时间
- Qwen2.5-3B:147.5s→150s(+2%)
- Qwen3-8B:244s→249s(+2%)
- Qwen2.5-14B:417s→424s(+1.7%)
KV缓存传输分析
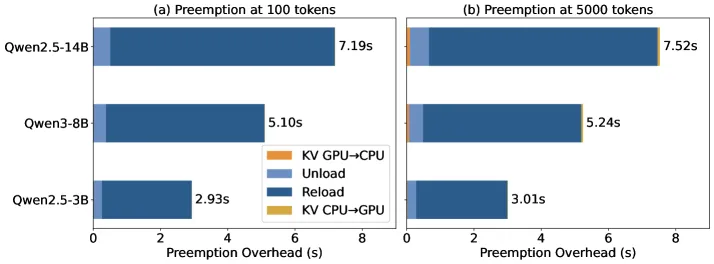
发现7:KV传输微小但增长
- KV缓存传输仅占总抢占开销1-1.5%
- 但这是唯一随作业长度增长的组件
- 5000 token时缓存达178MB(3B)、713MB(8B)、951MB(14B)
- 传输时间:GPU→CPU最长90ms,CPU→GPU最长63ms(RTX 5000)
发现8:PCIe带宽利用
- 实测PCIe带宽表明互连限制可能成为瓶颈
- 在频繁抢占或激进卸载场景下尤为重要
五、关键特征识别
基于实证发现,识别下一代调度器必须考虑的6个关键特征:
| 特征 | 说明 | 实验证据 |
|---|---|---|
| 非线性卸载敏感性 | 调度器必须考虑模型特定的卸载敏感性 | 小模型退化更陡峭,大模型更平缓 |
| 模型架构依赖 | 类似规模模型(Qwen vs Llama)表现不同 | 架构选择影响计算和内存分布 |
| 序列长度交互 | 长序列放大卸载影响 | 解码阶段低效随时间累积 |
| 抢占开销分解 | 模型重载占99%+,KV传输<1.5% | 开销与抢占点无关 |
| KV缓存与数据移动 | KV传输是唯一增长组件 | 0.035-0.19 MB/token线性增长 |
| 硬件特性 | GPU能力、CPU吞吐量、互连带宽 | RTX 5000 vs A6000差异显著 |
调度器设计指导
整体方法:有效调度需要整合模型感知、工作负载感知和硬件感知特征
具体建议:
- 模型感知:为每个模型-硬件对建立卸载曲线,而非通用策略
- 工作负载感知:考虑请求特征(预期输出长度)决定放置和资源分配
- 硬件感知:将交换成本视为模型-硬件对的已知常量
- 抢占策略:基于模型重载成本而非KV传输成本决策
- 混合执行:平衡GPU能力和CPU吞吐量,避免高端GPU的过度卸载惩罚
六、相关工作
| 方向 | 代表工作 | 本文贡献 |
|---|---|---|
| 卸载系统 | FlexGen, LIA, PowerInfer | 量化连续卸载曲线,发现非线性退化 |
| KV缓存管理 | vLLM, FastServe | 分离KV传输与模型重载成本 |
| 多模型服务 | MuxServe | 识别多模型调度的关键特征 |
| 预测调度 | S3, Zheng et al. | 提供实证抢占成本而非模拟 |
| 连续批处理 | Orca, Sarathi | 识别单请求执行的局限性 |
七、总结
核心贡献
- 系统实证研究多模型LLM调度中的CPU-GPU卸载和抢占性能
- 量化非线性卸载退化,发现小模型更敏感、大模型更平缓
- 分离抢占开销,发现模型重载占99%+,KV传输仅1-1.5%
- 识别6个关键特征为下一代调度器提供设计指导
- 强调硬件感知调度的必要性
技术影响
- 为多模型LLM服务系统设计提供实证基础
- 指导资源分配、请求调度和抢占策略的优化
- 推动异构硬件环境下的高效LLM推理
局限性
- 仅使用单请求执行,未扩展到连续批处理场景
- 每个作业仅分析一次抢占,多次抢占的累积成本未研究
- 需要工作负载级研究估计典型作业的抢占频率
- 未比较抢占策略与完全非抢占策略的性能