DashAttention: Differentiable and Adaptive Sparse Hierarchical Attention
用可微、自适应稀疏的 α-entmax 变换替代分层稀疏注意力中的 top-k 路由,让第一阶段按 query 自适应选择可变数量的 KV 块并为第二阶段 softmax 提供 prior,使整个层级端到端可微且非弥散(non-dispersive)。75% 稀疏度下精度媲美 full attention,Pareto 前沿优于 NSA/InfLLMv2,推理较 FlashAttention-3 最高 3.36x 加速
DashAttention: Differentiable and Adaptive Sparse Hierarchical Attention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DashAttention: Differentiable and Adaptive Sparse Hierarchical Attention |
| 作者 | Yuxiang Huang, Nuno M. T. Gonçalves, Federico Alvetreti, Lei Li, Xu Han, Edoardo M. Ponti, André F. T. Martins, Marcos V. Treviso |
| 机构 | Tsinghua University、University of Edinburgh、Instituto de Telecomunicações / SARDINE Lab(葡萄牙)等 |
| 论文 | arXiv:2605.18753(NeurIPS 2026 preprint) |
| 发布 | 2026 年 5 月 18 日 |
| 实现 | Triton(三个融合 kernel),Stage 1 用 AdaSplash-2,Stage 2 用 FlashAttention |
| 基座模型 | MiniCPM-4 的 1B / 3B / 8B 变体(长上下文续训 + SFT) |
二、核心思想
问题定义
长上下文任务的难度取决于待检索信息的数量、混淆度(能否与噪声区分)、以及在上下文中的分布(分散或集中)。要在这类任务上表现好,模型必须:
- 足够选择性(selective):忽略无关 token;
- 足够灵活(flexible):无论相关 token 的数量、位置、与其他内容的相似度如何,都能恢复对当前 query 重要的位置。
现有方法无法同时满足两点:
- Dense softmax attention:满足灵活性(每个可见 token 都有非零权重),但违反选择性——所有 token 都分到概率质量,在长上下文中导致弥散(dispersion)(注意力分布的香农熵随序列长度 增长,)。
- 硬稀疏路由(top-k 块选择,如 NSA、InfLLMv2):满足选择性,但通过固定预算 实现,牺牲了灵活性;且 top-k 操作切断了粗粒度路由决策与细粒度 token 注意力之间的可微路径(梯度无法直接指导路由分数如何改变块成员)。
核心矛盾:同时实现 query 相关的灵活性 + 严格的 token 级选择性,仍是开放挑战。
解决方案概述
DashAttention(DA) 的关键创新:粗粒度路由器本身就是一个稀疏注意力机制——用 α-entmax(一个自适应稀疏分布,其 support 从输入本身学习、非零质量保持可微)替代对 dense 分数施加的 top-k 截断。
三阶段层级设计(图 1):
- Stage 0(局部块摘要):用可学习的 summary head 对每个 chunk 做局部 SDPA 生成紧凑摘要;
- Stage 1(Entmax 块路由):query 用 α-entmax 注意 chunk 摘要,产生稀疏路由分布,support 大小由分数几何自适应决定(信息丰富的 query 路由到多个 chunk,尖锐的 query 路由到极少),实现跨 token / head / layer 的动态稀疏分配;
- Stage 2(prior 诱导的稀疏 softmax):仅对路由到的 chunk 展开回 token 分辨率,用一个 logits 被 Stage 1 路由权重偏置的 softmax 精炼。
由此模型粗粒度地学习「看哪里」「看多少」,精细地读「读什么」,且整个层级端到端可微。这一设计同时受理论(sparse alternatives 保持集中度、改善长上下文能力)与系统(分层分解,避免直接对全部注意力分数选 token 的昂贵 QK 乘法)双重驱动。
核心结果:75% 稀疏度下精度媲美 full attention,Pareto 前沿全面优于 NSA/InfLLMv2(尤其高稀疏区间);推理较 FlashAttention-3 最高 3.36× 加速,较 InfLLMv2 1.35×。
三、技术架构
整体框架图
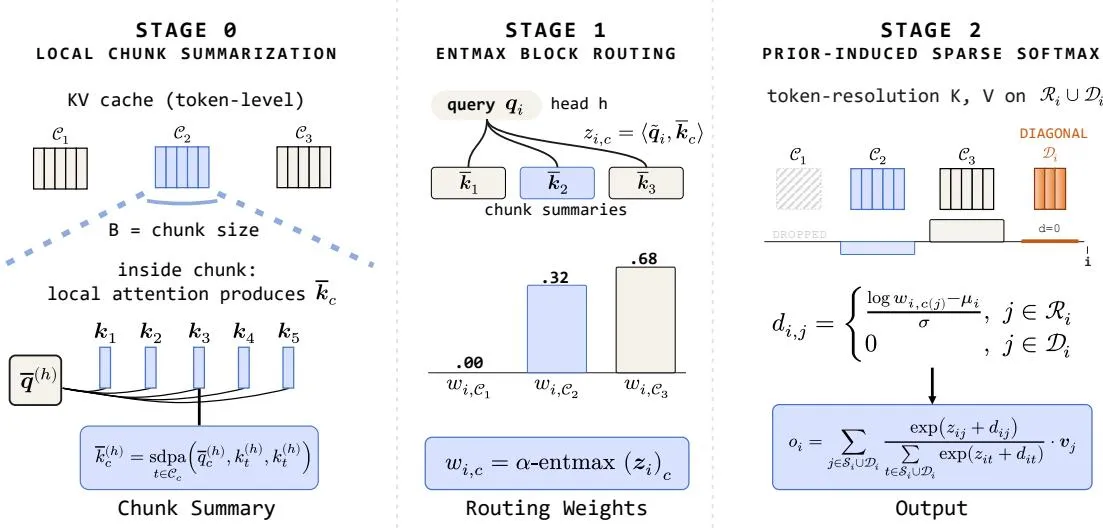
图 1:DashAttention 高层总览。Stage 0 用局部 SDPA 构建 chunk 摘要;Stage 1 用 α-entmax 路由得到自适应稀疏 support;Stage 2 在 token 分辨率精炼,其 logits 被从路由权重导出的 偏置,保持全可微与 FlashAttention 兼容。
背景公式
标准缩放点积注意力(SDPA):给定 ,
其中 逐行映射 logits 到概率单纯形,softmax 最常用。
α-entmax 变换(可微稀疏替代):
- 为 ReLU, 为使输出为有效概率分布的唯一归一化常数;
- 恢复 softmax, 得 sparsemax,稀疏度随 单调递增;
- 的坐标精确置零,故 entmax 产生动态稀疏——零的模式与数量都取决于输入 。
核心公式(三阶段)
Stage 0 — 局部块摘要(Eq. 4):引入初始化为零的可学习 query 向量 ,对每个 chunk 做局部 SDPA:
初始化为零使内积为零 → 局部 softmax 退化为均匀 mean pooling,随训练平滑过渡到加权平均。比 MoBA/InfLLMv2 的 mean pooling 更具表达力,比 NSA 的 MLP 更易从预训练 softmax 模型适配。chunk 摘要一旦 chunk 生成完毕即固定,推理无需重算。
Stage 1 — Entmax 块路由(Eq. 6):query head 关联 KV head ,计算 chunk 级 logits ,用缩放因子 做 entmax:
support 决定保留的 chunk。GQA 处理:对每组 内成员 head ,平均 head 级概率 ,support 为并集 。
Stage 2 — Prior 诱导的稀疏 softmax(Eq. 9):从 softmax 的变分形式出发,将 KL 项的参考分布从均匀 换为由 Stage 1 分数导出的 :
当 (即 )时, 自动 mask,softmax 天然稀疏;同时动态稀疏与全可微性通过 entmax 分数 保持。最终输出:
该形式对 和 prior 全可微,梯度可回传至 Stage 1 的 entmax 分数、进而使 Stage 0 摘要可训练。
Prior 强度控制与对角块处理(Eq. 11-12):对角/近对角区域可能不足 token(无块摘要)。将 的质量分为 routed 分支 与 diagonal 分支 ,引入超参 构造强度削弱的 prior 。 时 prior 在 routed support 上趋于均匀(仅对选中 token 做 softmax,无额外 prior)。分配因子:
直觉:路由器接近均匀(KL≈0)时按 分配;路由器高度信息化(大 KL)时给 routed 分支更多质量。
Proposition 4.1(等价注意力偏置形式):上述计算等价于先算 ,再加偏置:
即 prior 折叠为对注意力 logits 的简单加性偏置 ,与 FlashAttention kernel 完全兼容。
GPU-Aware 实现(三个融合 Triton kernel)
| Kernel | 作用 | 关键优化 |
|---|---|---|
| Stage 0 | 可学习 summary token 对其 keys 做 online softmax | keys 同时作 values,同一 tile 一次读取双用,无额外 HBM 往返;chunk 完成即写回 chunk-representation cache 复用 |
| Stage 1 | 注意缓存的 chunk 表示形成 chunk logits | chunk 数 小(16K/B=64→256),整行常驻寄存器;AdaSplash-2 就地解 entmax 阈值 ;GQA 组内平均后剪枝;support 存为 bitpacked block mask (32 列/int32) |
| Stage 2 | masked FlashAttention 遍历 中 active chunk | 每选中 chunk 加 per-chunk 路由偏置 后 online softmax,单次融合;decoding 用 split-KV 变体沿 KV 维切分暴露并行;训练反向复用 (entmax 稀疏 Jacobian) |
四、理论分析:非弥散性(Non-Dispersion)
弥散问题:softmax 长上下文注意力的香农熵满足 ,使长程依赖建模愈发困难。top-k 稀疏将熵界定在 ,缓解弥散。
但现有分层方法(NSA/InfLLMv2)在 top-k 选择前用 post-softmax head 聚合,使弥散在聚合阶段重新出现。
定义 4.1(Head aggregation):给定 、 个有界序列 与聚合权重 :
定理 4.2(非正式):任意有限 与 下:
- softmax head 聚合是弥散的(构造上如此);
- 若 且 (),则 entmax head 聚合非弥散。
结论:softmax head 聚合会破坏 top-k 稀疏的非弥散性、导致噪声选择;DashAttention 直接在稀疏 entmax 分数上做 head 聚合,规避此问题,在 MK1–MK3 等困难检索任务上表现更好。
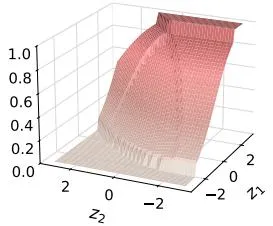
图 4:不同 α 值的映射与 top-k softmax (k=1,2) 可视化——展示 entmax 如何随输入自适应产生稀疏 support,区别于固定预算的 top-k。
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 路由器即稀疏注意力 | 用 α-entmax 替代 top-k 截断,support 从数据学习、可变大小 | Eq. 6;端到端可微 |
| 全可微层级 | Stage 2 的 prior 诱导 softmax 让梯度回传至 Stage 1/0 | Eq. 9-10;Proposition 4.1 |
| 动态稀疏分配 | 跨 token/head/layer 自适应稀疏,摆脱固定预算 | 图 3 层稀疏度;RULER MK 任务 |
| 非弥散性 | entmax head 聚合非弥散,优于 softmax 聚合的 top-k | 定理 4.2;MK1-MK3 提升 |
| 可学习块摘要 | 零初始化 summary head,mean-pooling→加权平均平滑过渡 | Eq. 4;比 MLP 易适配预训练模型 |
| 偏置等价形式 | prior 折叠为加性 logits 偏置 ,兼容 FlashAttention | Proposition 4.1 |
| GPU-aware 实现 | 三融合 kernel + bitpacked mask + AdaSplash-2 | 最高 3.36× vs FA-3 |
六、实验结果
6.1 长上下文性能(RULER 16K,75% 稀疏度)
| 模型 | 方法 | Avg (%) | Sparsity | MK2 | MK3 |
|---|---|---|---|---|---|
| 1B | FullAttn | 66.6 | 0 | 78.0 | 48.0 |
| NSA | 48.3 | 75.0 | 20.0 | 6.0 | |
| InfLLMv2 | 62.4 | 75.0 | 52.0 | 16.0 | |
| DashAttention | 64.9 | 75.7 | 70.0 | 26.0 | |
| 3B | FullAttn | 69.2 | 0 | 94.0 | 60.0 |
| NSA | 49.0 | 75.0 | 24.0 | 10.0 | |
| InfLLMv2 | 62.8 | 75.0 | 56.0 | 28.0 | |
| DashAttention | 67.7 | 75.4 | 88.0 | 40.0 | |
| 8B | FullAttn | 85.3 | 0 | 100.0 | 96.0 |
| NSA | 55.0 | 75.0 | 34.0 | 12.0 | |
| InfLLMv2 | 78.9 | 75.0 | 82.0 | 52.0 | |
| DashAttention | 83.6 | 75.7 | 96.0 | 86.0 |
DA 在所有模型尺寸上全面超越 NSA/InfLLMv2,尤其在困难多键检索(MK2/MK3)上大幅领先,逼近 full attention。
HELMET 16K(Overall %):1B 31.2(vs Full 32.5 / Iv2 29.5)、3B 34.3(vs 37.4/34.2)、8B 46.9(vs 47.7/45.9);Recall 子任务领先明显(8B DA 88.3 vs Iv2 81.4)。
6.2 效率基准(较 FullAttn+FlashAttention 的 wall-clock 加速)
chunk size 64,稀疏度 。Prefill batch=1,Decoding batch=24。
| 场景 | 上下文 | 稀疏 | NSA | InfLLMv2 | DashAttn |
|---|---|---|---|---|---|
| Prefill | 16K | 75% | 0.71 | 0.96 | 1.34 |
| 96K | 93.7% | 2.32 | 3.06 | 3.09 | |
| Decoding | 96K | 75% | 0.80 | 1.73 | 1.96 |
| 96K | 93.7% | 1.34 | 3.10 | 3.36 |
- Prefill:DA 在每个操作点均最快,较 dense FA 加速 1.34×–3.09×,最密设置下相对 InfLLMv2/NSA 优势最大(其 top-k 开销未被摊薄)。
- Decoding(内存受限):DA 在 96K、93.75% 稀疏下达 3.36×(vs InfLLMv2 3.10×);优势随上下文与稀疏度单调增长——Stage 2 单次遍历 bitpacked mask,避免 InfLLMv2 在评分与注意力阶段间的显式 top-k 与 per-query 索引物化。
6.3 Cost-Effectiveness / Pareto 前沿
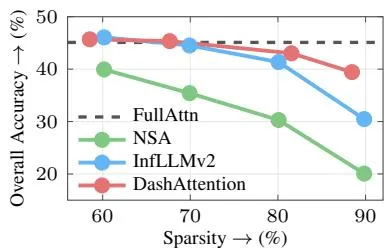
图 2:HELMET 上精度-稀疏度 Pareto 前沿(8B)。DashAttention 全程支配 NSA/InfLLMv2,低-中稀疏度下略超 full attention。
8B 模型扫描稀疏度(DA 调温度 ,NSA/InfLLMv2 调 ):DA 全程支配基线;~90% 稀疏度下 DA 保持 39.4% overall accuracy,超 InfLLMv2 约 9%、超 NSA 约 19%。凸显自适应性——固定 top-k 会过度分配简单 query 或欠分配困难 query,而 entmax 自适应重塑 support。
6.4 动态稀疏分析
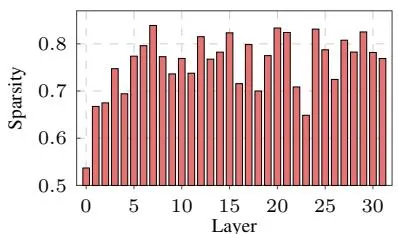
图 3:逐层注意力稀疏度(16K RULER-SG1 输入)。早期层更密集,中间层更稀疏,自动产生类似预算分配策略(PyramidKV/PyramidInfer/MoBA)的效果——但无需人工设计。
6.5 其他结果
- General tasks(8B 短上下文):DA Avg 59.4,与 FullAttn 59.5 持平,略超 NSA(59.2)/InfLLMv2(59.1),验证不损短上下文能力。
- DA + softmax 推理(DA+FA):DA 训练的模型用 full softmax 推理,甚至优于 FA 训练模型(1B RULER 66.6→70.4,8B 85.3→86.7),说明可无缝回退到 vLLM/SGLang 的高度优化 softmax 内核。
- Chunk size:减小 chunk size 提升精度但降低效率(chunk=1 时退化为 entmax+softmax,承担两者成本)。
七、相关工作
- 注意力稀疏化:静态模式(attention sinks、sliding window)→ 随机(BigBird)/动态(H2O、MInference、block sparsity)→ head 异构稀疏。DA 通过训练消除 train-inference mismatch。
- KV cache 优化(正交方向):eviction(H2O/SnapKV)、offloading(InfLLM/ShadowKV)、量化(KVQuant/KIVI)——压缩 KV 而非优化注意力稀疏。
- 可训练稀疏注意力:SeerAttn / NSA / MoBA 用 top-k 选压缩块;InfLLMv2 统一末阶段 kernel;FSA 扩展到更小 GQA 组;HSA 用 local encoder 但加参数多。这些方法受固定 top-k 限制,无动态性。DA 将 entmax 引入分层稀疏注意力,桥接「可训练稀疏」与「entmax 加速」两方向,且易从预训练 softmax 模型适配。
八、总结
核心贡献
- 分析 top-k 稀疏注意力的局限,提出 DashAttention——端到端可微、跨 head 自适应分配稀疏的方法;
- 集成到长上下文续训,在匹配稀疏度下超越现有分层稀疏方法(NSA/InfLLMv2),并媲美 full attention 精度;
- 高效 GPU-aware Triton 实现,较 FlashAttention-3 加速 3.36×、较 InfLLMv2 1.35×。
技术影响
- 首次将**可微自适应稀疏(α-entmax)**引入分层稀疏注意力的路由阶段,打破 top-k 固定预算范式;
- 非弥散性理论为长上下文稀疏注意力设计提供新视角——head 聚合方式(softmax vs entmax)直接影响长程建模能力;
- 提供从预训练 softmax 模型平滑适配的路径(零初始化 summary head、prior 强度可调),且训练后可回退 full softmax 推理。
局限性
- DashAttention 的 kernel 尚未集成到 vLLM/SGLang 等现代 LLM serving 框架(future work);
- 未探索应用于其他架构(如混合模型 Nemotron 等);
- chunk size 与效率/精度权衡需针对场景调优。
九、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.18753
- 依赖实现:AdaSplash / AdaSplash-2(entmax GPU kernel)、FlashAttention(Stage 2)、Triton
- 基线方法:NSA、InfLLMv2、MoBA、SeerAttention、FSA、HSA
- 评测基准:RULER、HELMET、MMLU、GSM8K、MATH、HumanEval 等