Full Attention Strikes Back: Transferring Full Attention into Sparse within Hundred Training Steps
RTPurbo: 将全注意力 LLM 转化为稀疏模型,仅需数百步训练
Full Attention Strikes Back: Transferring Full Attention into Sparse within Hundred Training Steps
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Full Attention Strikes Back: Transferring Full Attention into Sparse within Hundred Training Steps |
| 作者 | Yanke Zhou, Yiduo Li, Hanlin Tang, Maohua Li, Kan Liu, Tao Lan, Lin Qu, Yuan Yao, Xiaoxing Ma |
| 机构 | Nanjing University, Alibaba Group |
| 论文 | arXiv:2605.16928 |
| 发布 | 2026年5月16日 (v1), 2026年6月8日 (v2) |
| 主题 | cs.CL, cs.AI |
二、核心思想
问题定义
长上下文推理是大语言模型的核心能力,但全注意力的二次成本成为主要瓶颈。现有高效替代方案通常依赖原生稀疏训练或启发式 token 淘汰,在效率、训练成本和精度之间存在不可取的权衡。
核心观察
本文发现全注意力 LLM 天然具有稀疏性,仅需最小化适配即可转化为高度稀疏模型。三个关键观察:
- 只有少量注意力头真正需要全长上下文处理(检索头 vs 局部头)
- 长程检索主要由低维子空间控制,仅需 16 维索引器即可高效检索相关 token
- 有用的 token 预算强烈依赖于查询,动态 top-p 选择优于固定 top-k
解决方案概述
RTPurbo 提出基于头级别的注意力稀疏框架:
- 仅为检索头保留完整 KV 缓存
- 引入轻量级 token 索引器进行稀疏注意力
- 利用模型内在稀疏性,仅需数百步训练即可完成稀疏化
核心性能
| 指标 | 数值 |
|---|---|
| Prefill 加速 | 最高 9.36× (1M 上下文) |
| Decode 加速 | 最高 2.01× (1M 上下文) |
| 训练步数 | 仅需 ~600 步 (~1M 标签 token) |
| 精度保持 | 近无损(AIME 完美匹配 86.67) |
| 稀疏率 | 64K 上下文达 89.2%,512K 达 97.1% |
三、技术架构
整体架构
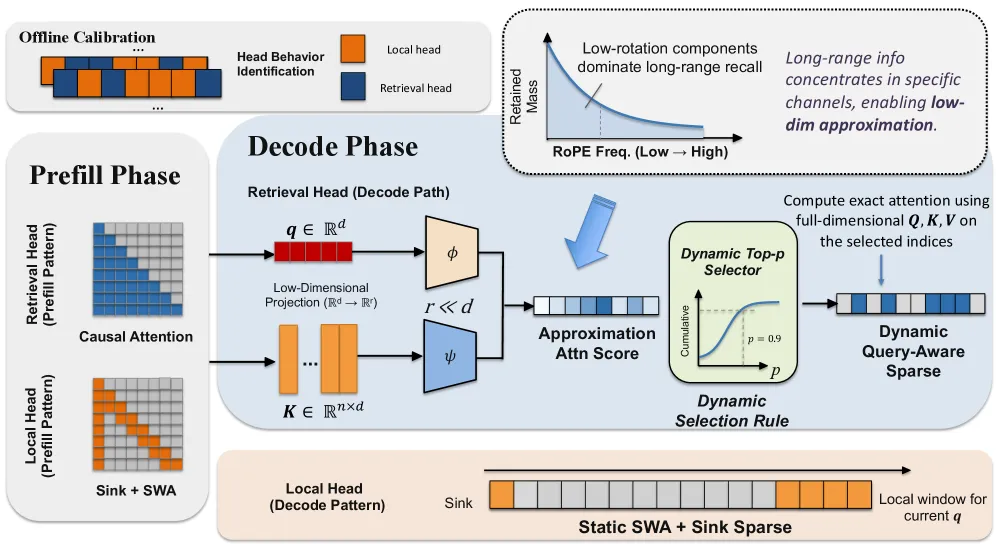
Figure 4: RTPurbo 整体架构。
核心洞察
洞察 1: 头级别功能特化
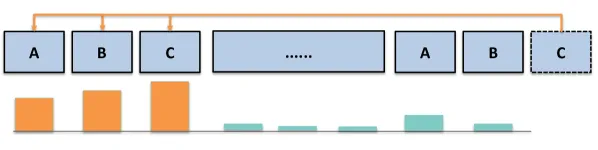
Figure 2: 与主要关注局部信息的大多数注意力头不同,检索头会关注与当前查询 token 语义相关的区域,即使这些区域在上下文中距离很远。
- 检索头 (Retrieval Heads): 负责远距离内容检索,具有信息检索模式
- 局部头 (Local Heads): 主要处理局部信息,天然稀疏
- 离线校准: 仅需一次校准即可稳定划分所有头
洞察 2: RoPE 诱导的可压缩几何
RoPE 通过旋转矩阵注入位置信息:
查询-键分数仅依赖相对偏移 :
关键发现: 高频分量在长距离上变得距离敏感,低频分量平滑变化且更好地保留检索信号。因此可以在低维空间中重建检索头注意力。
洞察 3: 动态 Top-P 选择
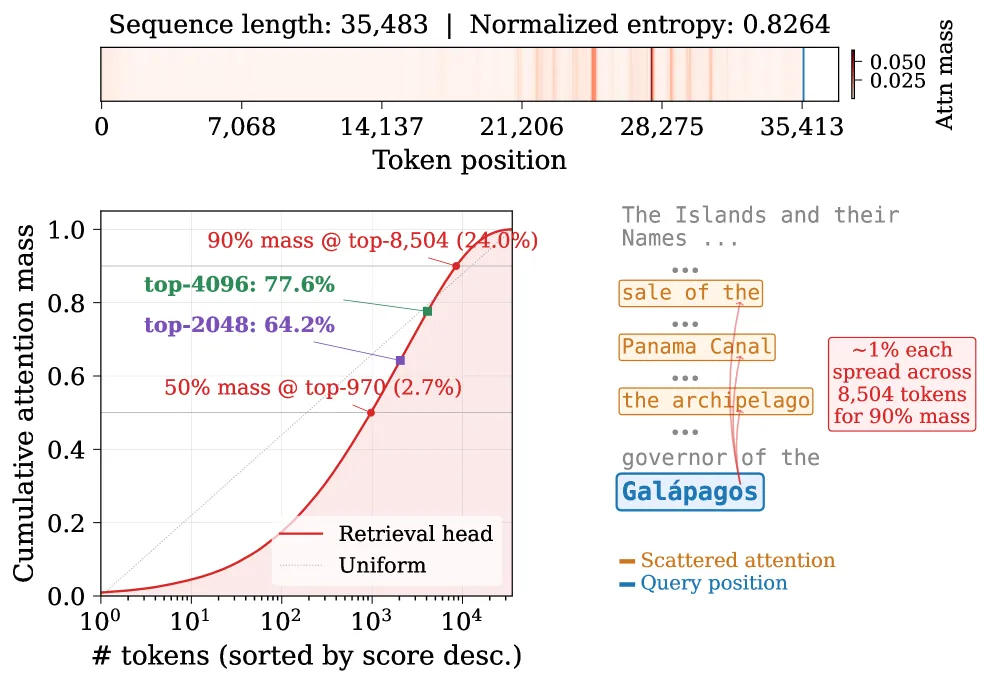
Figure 3(a): 查询 token “Galápagos” 诱导广泛的语义检索,需要 ~8k token 恢复 90%+ 注意力质量。
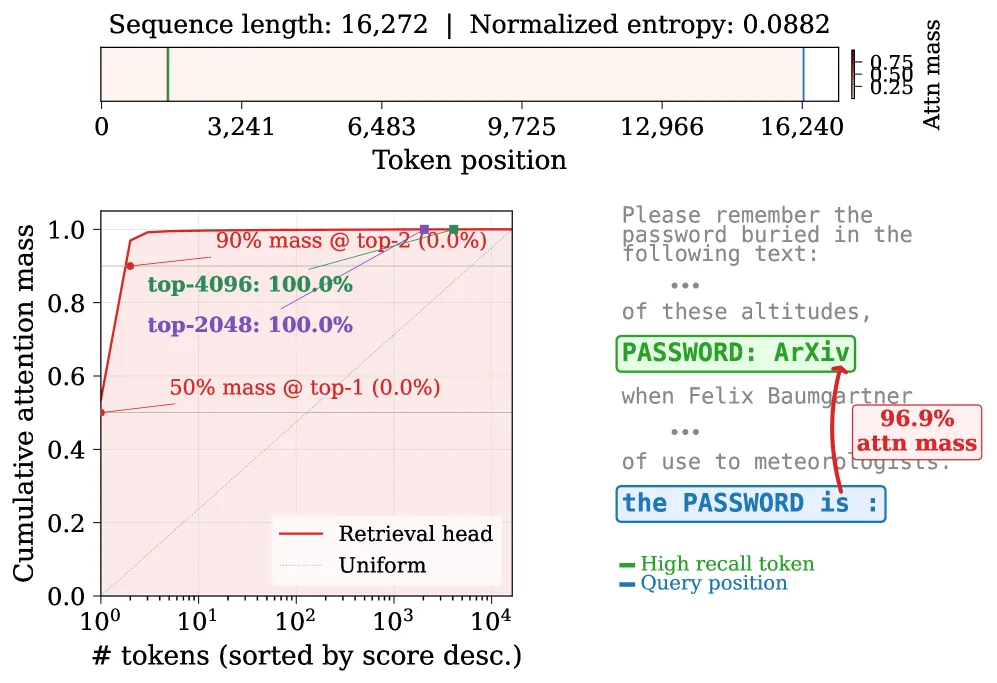
Figure 3(b): NIAH 查询高度集中,仅需 2 个 token 即可恢复 96.6% 注意力质量。
Top-K vs Top-P 对比:
| 方法 | Token 数 | 注意力质量 |
|---|---|---|
| top-2k | 2048 | 64.2% |
| top-4k | 4096 | 77.6% |
| top-16k | 16384 | 93.8% |
| top-p 0.9 | 8504 | 90.0% |
| Full Attn | 35483 | 100% |
Top-16k 比 top-p 多计算 ~8k token,但仅多恢复 3.8% 注意力质量。
核心公式
离线头校准
检索分数定义:
其中 和 分别是前后 needle span 的 token 索引。
自适应稀疏注意力
使用低秩投影估计查询-键相关性(在 RoPE 注入之前):
稀疏注意力计算:
其中 。
两阶段训练
Stage 1: 冻结 LLM 主干,训练低维投影权重,最小化 KL 散度:
Stage 2: 端到端自蒸馏,仅对齐 top-10 logits:
硬件感知解码内核
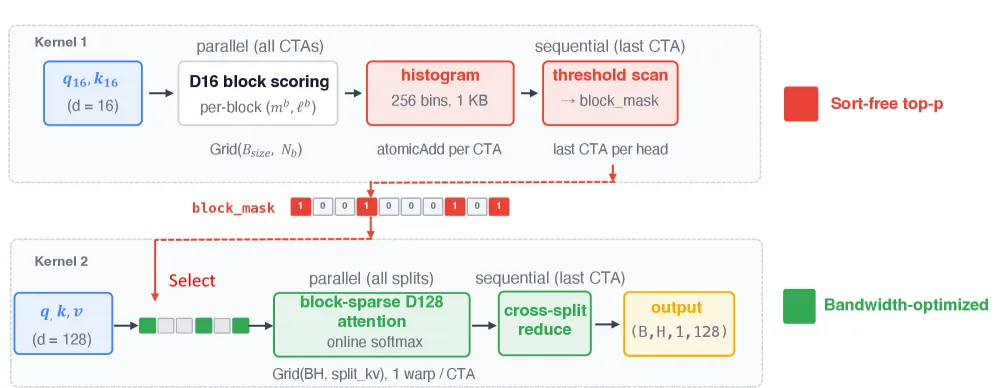
Figure 5: RTPurbo 硬件感知解码内核概览。
无排序 Top-P: 使用 256-bin 直方图,每个 head 仅需 1KB 内存,与序列长度无关。融合评分和选择为单次内核启动。
带宽优化稀疏解码: 单 warp CTA,无共享内存,所有状态保存在寄存器中。内层循环 2-token 展开,向量化 half2 指令。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 内在稀疏性发现 | 全注意力 LLM 天然具有稀疏性 | 仅 15% 头需要全长上下文 |
| 低维检索索引 | 16 维投影即可实现 90%+ 召回率 | RoPE 高频分量可压缩 |
| 动态 Top-P 选择 | 查询依赖的自适应 token 预算 | 比固定 Top-K 节省 ~8k token |
| 数百步稀疏化 | 仅需 ~600 步训练 | 自蒸馏避免过拟合 |
| 无排序 Top-P 内核 | O(1) 内存开销的硬件感知实现 | 256-bin 直方图 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 检索头比例 | 15% |
| 滑动窗口大小 | 8192 |
| Sink tokens | 4 |
| 低维大小 | 16 |
| Top-p | 0.9 |
| 内核块大小 | 64 |
| 硬件 | NVIDIA H20 GPU |
| 训练数据 | FineWeb, Dolma 3 Longmimo Mix |
| 训练长度 | 32K-80K tokens, 平均 48K |
LongBench 结果
| 方法 | 平均精度 |
|---|---|
| Full Attention | 53.80% |
| RazorAttn | 52.98% |
| Minference | 48.39% |
| FlexPrefill | 49.42% |
| Quest | 50.69% |
| SnapKV | 50.74% |
| RTPurbo (top-p) | 54.24% |
关键发现: RTPurbo 甚至超越全注意力基线 0.44%,证明近无损稀疏化的可行性。
RULER 结果
32K 上下文:
| 方法 | 平均精度 |
|---|---|
| Full Attention | 89.65% |
| RazorAttn | 88.69% |
| RTPurbo (top-p) | 90.06% |
64K 上下文:
| 方法 | 平均精度 |
|---|---|
| Full Attention | 86.23% |
| RazorAttn | 85.11% |
| RTPurbo (top-p) | 85.49% |
推理任务结果
| 方法 | AIME24 | AIME25 |
|---|---|---|
| Full Attention | 86.67 | 86.67 |
| Quest | 46.67 | 46.67 |
| SnapKV | 43.33 | 46.67 |
| RTPurbo (top-p) | 86.67 | 86.67 |
关键发现: RTPurbo 在 AIME 上完美匹配全注意力基线。
超长上下文结果
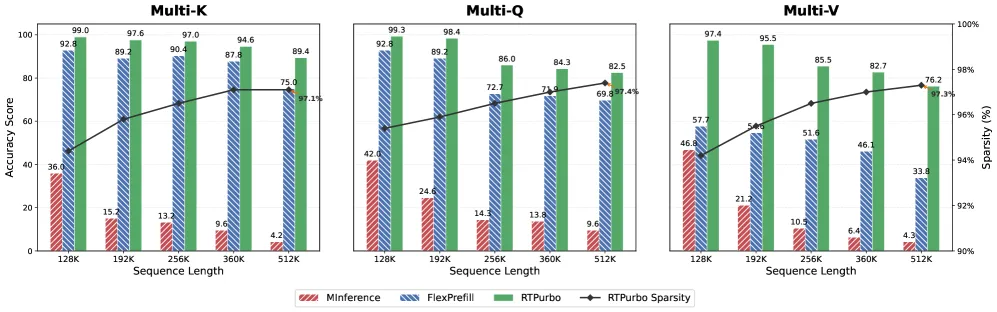
Figure 6: 128K-512K 超长多跳任务的精度和稀疏率。基线方法在极端长度下崩溃,RTPurbo 保持鲁棒精度。
效率评估
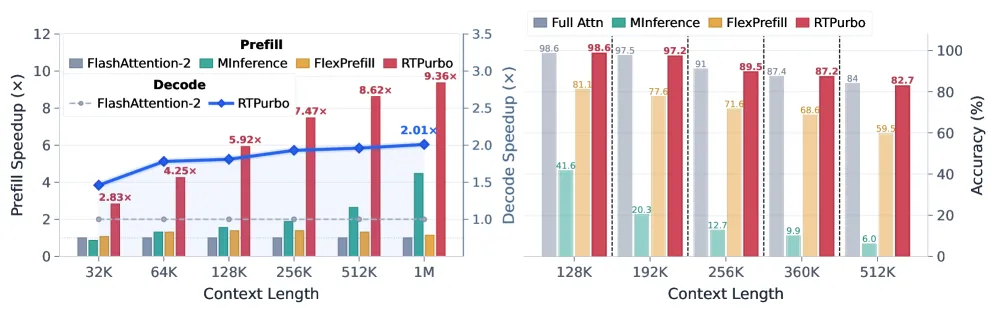
Figure 1: RTPurbo 的效率和精度增益。
Prefill 加速 (vs FlashAttention-2):
| 上下文长度 | 加速比 |
|---|---|
| 32K | 2.83× |
| 64K | 4.5× |
| 128K | 6.2× |
| 256K | 7.8× |
| 1M | 9.36× |
Decode 加速 (vs FlashAttention-2):
| 上下文长度 | 加速比 |
|---|---|
| 32K | 1.47× |
| 64K | 1.6× |
| 128K | 1.8× |
| 1M | 2.01× |
动态稀疏性分析
Layer 25, Qwen3-Coder-30B-A3B:
| 上下文 | 任务 | 计算稀疏率 | 内存稀疏率 | 活跃 Token | 注意力质量 |
|---|---|---|---|---|---|
| 32K | niah-S | 78.7% | 76.2% | 468.8 | >0.95 |
| 32K | multi-K | 77.8% | 74.4% | 2462.1 | >0.96 |
| 64K | niah-S | 89.2% | 87.7% | 1126.8 | >0.93 |
| 64K | multi-K | 88.7% | 85.2% | 3316.1 | >0.94 |
关键发现: 活跃 token 预算随任务复杂度自适应缩放,niah-S 仅需 468.8 token,multi-K 需要 2462.1 token(5× 方差)。
消融实验
检索头比例:
| 比例 | MMLU-PRO Math | RULER multi-K |
|---|---|---|
| 10% | 79.3 | 97.4 |
| 15% | 88.2 | 98.8 |
| 30% | 88.2 | 98.6 |
15% 是最优平衡点,30% 无额外收益但增加训练成本。
低维大小:
| 维度 | MMLU-PRO Math | RULER niah-S |
|---|---|---|
| 4 | 89.1 | 100 |
| 16 | 88.2 | 99.9 |
| 32 | 88.2 | 99.9 |
16 维已足够,进一步增加维度无收益。
六、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| RazorAttn | 同样划分检索/局部头,但 RTPurbo 引入低维索引和动态 Top-P |
| DuoAttention | 头级别划分的先驱工作 |
| DSA | 使用轻量级学习索引器,但无动态阈值 |
| SnapKV | 压缩 KV 缓存,但依赖局部查询 |
| Quest | 块级稀疏,但粒度较粗 |
| MInference | 离线发现稀疏模式,但无训练 |
七、总结
核心贡献
- 发现全注意力 LLM 的内在稀疏性: 仅 15% 头需要全长上下文处理
- 低维检索索引: 16 维投影实现 90%+ 召回率,利用 RoPE 频率结构
- 动态 Top-P 选择: 查询依赖的自适应 token 预算,优于固定 Top-K
- 数百步稀疏化: 自蒸馏仅需 ~600 步训练
- 硬件感知内核: 无排序 Top-P 实现,O(1) 内存开销
技术影响
- 全注意力仍是实用选择: 无需昂贵的原生稀疏预训练
- 最小化手术: 仅需数百步即可完成稀疏化
- 可解释性: 头级别划分和动态阈值高度可解释
- 实际部署: 9.36× prefill 加速和 2.01× decode 加速
局限性
- 依赖于预训练模型的内在稀疏性(不同模型可能需要不同配置)
- 检索头比例和低维大小需要针对特定模型调优
- 仅在 Qwen3 系列模型上验证
八、参考资源
- 论文: arXiv:2605.16928
- 主题: cs.CL (Computation and Language), cs.AI (Artificial Intelligence)
- 页数: 20 页, 9 图