CompactAttention: Accelerating Chunked Prefill with Block-Union KV Selection
面向 chunked prefill 的稀疏注意力机制,将 2D 块稀疏掩码视为「KV 选择信号」而非「稀疏内核执行计划」,通过 Q-block union + intra-group union 构造 GQA 感知的 per-group KV 块表,实现零拷贝分页注意力执行,在 LLaMA-3.1-8B 上 128K 上下文取得 2.72x 注意力加速且精度接近 dense
CompactAttention: Accelerating Chunked Prefill with Block-Union KV Selection
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CompactAttention: Accelerating Chunked Prefill with Block-Union KV Selection |
| 作者 | Jiwon Song, Dongwon Jo, Beomseok Kang, Jae-Joon Kim |
| 论文 | arXiv:2605.16839 |
| 发布 | 2026 年 5 月 16 日 |
| 执行后端 | FlashInfer 0.6.9(FlashAttention-2/3) |
| 评测模型 | LLaMA-3.1-8B-Instruct(dense,128K)、Qwen3-30B-A3B-Instruct-2507(MoE,256K) |
二、核心思想
问题定义
Chunked prefill(分块预填充) 已成为长上下文 LLM 服务的主流策略:将长 prompt 切成固定大小的 chunk(如 512/1024 token)逐块处理,与 decode 请求交织调度以提升吞吐。但该模式下 attention 计算面临独特困境——每个 chunk 的 query 长度 Q 被 chunk size 限制,而 KV 缓存持续累积,形成 Q ≪ KV 的极端不对称。
现有稀疏注意力方法主要为 one-shot prefill(整条 prompt 一次性处理)设计,无法高效迁移到 chunked prefill:
- 块稀疏内核在 Q ≪ KV 下失效:block-sparse kernel 依赖足够多的 query block 来摊薄开销。chunk size 限制了 Q block 数量,导致内核效率远低于 one-shot 甚至理想加速比(图 1b)。
- 细粒度 pattern search 重复开销累积:每处理一个新 chunk 都要对累积的整个 KV 缓存重做一次 pattern search,开销随 chunk 数线性累加(图 1c,XAttention 尤为严重)。这使得轻量级选择器(SeerAttention、FlashPrefill)更受青睐。
QUOKA(最新专门面向 chunked prefill 的方法)用 dense 内核规避了稀疏内核开销,但依赖 query-subsampled、token 级 KV 选择:仅用采样的部分 query 位置为整批 query 评分选 KV,会漏掉对未采样 query 重要的 KV(coverage 缺失),且需将选中 token 显式 gather 到连续 buffer,引入拷贝开销。
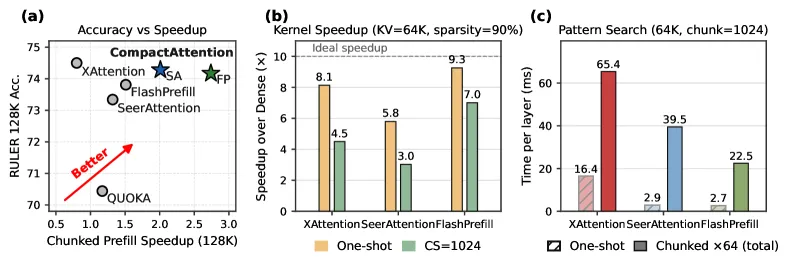
图 1:(a) CompactAttention 取得最佳精度-加速权衡;(b) chunked prefill(Q≪KV)下块稀疏内核加速远低于 one-shot 与理想值;(c) pattern search 开销随 chunk 累积,XAttention 开销最高。
解决方案概述
CompactAttention 的核心洞察:稀疏注意力在 chunked prefill 下的瓶颈不仅是「选哪些 KV 块」,更是「选中的块如何执行」。因此将 稀疏 KV 选择与执行解耦:
- 把 2D 块稀疏掩码当作**「KV 选择信号」,而非直接的「稀疏内核执行计划」**;
- 通过 Q-block union + intra-group union 两次并操作,将 per-head 2D 掩码转换为 GQA 感知的 per-group KV 块表;
- 用 零拷贝分页注意力(zero-copy paged attention) 就地访问选中的 KV 页,复用高度优化的 dense paged-attention 内核,避免 token 级方法的拷贝开销。
核心结果:LLaMA-3.1-8B-Instruct 上,RULER 精度接近 dense,128K 上下文在 H200 上取得 2.72× 注意力加速、1.96× 端到端加速。
三、动机分析(Motivation)
3.1 块稀疏注意力的局限(§2.1)
- 块稀疏内核需要足够的 query block 来摊薄启动/调度开销。chunked prefill 下 Q 受限于 chunk size(如 512),Q block 稀少,内核效率崩塌,常常比 dense 还慢。
- pattern search 需在每个 chunk 对累积 KV 重复执行,开销跨 chunk 累加 → 偏好轻量级 pattern search(SeerAttention 学习式预测、FlashPrefill 训练无关的 max-threshold 动态阈值)。
3.2 QUOKA 的覆盖率局限(§2.2)
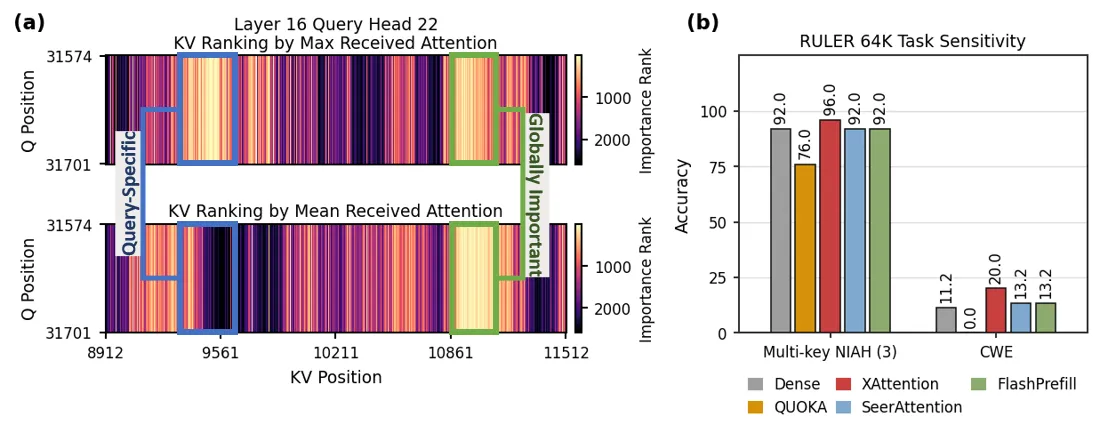
图 2:(a) 按 KV 位置从 query 收到的注意力聚合得到的排名。mean received attention(跨所有 query 平均)与 max received attention(取单一 query 最大)给出不同排名——存在只被特定 query 高度关注的 query-specific KV 位置。QUOKA 的 query 子采样评分会漏掉这些位置,在 Multi-key NIAH-3、CWE 等需分布式信息访问的任务上退化。
关键区分:block 级选择器(评估所有 query block)比 QUOKA 的 query 子采样更能保留相关注意力计算。且 token 级选择需显式 gather KV → 拷贝开销随上下文长度、batch、选中块数增长。这促成 CompactAttention 采用保留全 query block 覆盖的块级 KV 选择 + 就地执行。
四、技术架构
4.1 整体框架(§3.1)
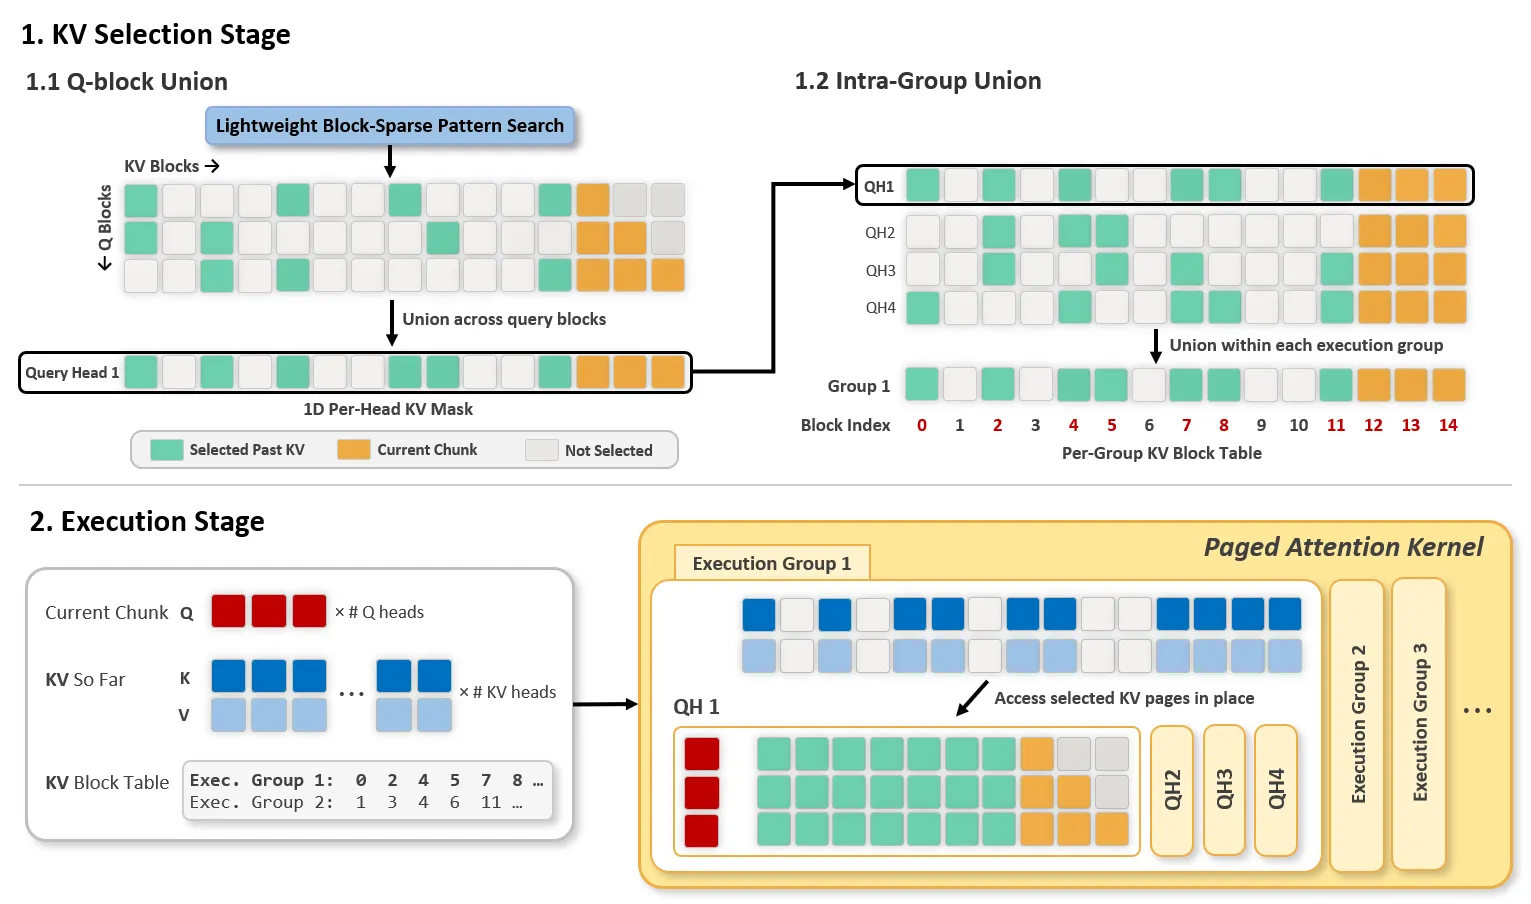
图 3:CompactAttention 总览。选择阶段将 2D per-head 块掩码经 Q-block union 与 intra-group union 转为 per-group KV 块表;执行阶段将块表传给分页注意力内核,就地访问选中 KV 页而无需显式 KV 压缩。
CompactAttention 是chunked prefill 感知的注意力机制,将稀疏 KV 选择与执行解耦,可与任何提供块级重要性估计且 per-chunk 开销低的轻量 pattern search 方法结合。两阶段:
【选择阶段 Selection】§3.2
  轻量 pattern search(SeerAttention / FlashPrefill)
      → 2D per-head 块稀疏掩码 M[b,h,i,j]
      → Q-block union(跨 chunk 内 query block 求并)→ 1D per-head KV 掩码
      → intra-group union(跨同组 query head 求并)→ per-group KV 块表 T[b,g]
                              │
                              ▼
【执行阶段 Execution】§3.3
  KV-head-major 布局 + ragged page list(kv_indptr / kv_indices 元数据)
      → 零拷贝分页 dense attention,就地访问选中 KV 页
      → 当前 chunk 始终全开(保持因果语义)
4.2 KV 选择:Block-Union 块表构造(§3.2)
设 pattern search 产出的 2D 块稀疏掩码为 (batch 、query head 、query block 、KV block )。现有方法直接把它当稀疏内核执行计划;CompactAttention 则转成 dense paged attention 可消费的 KV 块表。
① Q-block union(跨 query block 求并):
得到每个 query head 一个 1D KV 块掩码。因为 dense paged attention 对一起执行的 query block 只消费单一 KV 块列表,而非为每个 (Q-block, KV-block) tile 单独决策。
② Intra-group union(跨共享 KV 块表的 query head 求并):
其中 为执行组 (默认为一个 KV group)内的 query head 集合。最终 per-group 页表:
关键性质——覆盖率保持(coverage-preserving)且最小:组内任一 query block、任一 query head 选中的 KV 块都保留在页表中;且在「组内所有 query block 与 query head 共享单一 KV 块表」约束下, 是保持该覆盖率的最小块表。两次 union 不是简单后处理,而是将 per-query-block、per-head 稀疏掩码下降(lower)为 GQA 感知的分页 KV 表这一可执行表示。
稀疏度权衡:union 会降低稀疏度(只要组内任一 query 选中即保留)。但可用更激进的初始 pattern search 补偿:union 后仍保精度。实验证明 zero-copy paged 执行优势超过稀疏度损失。
大 GQA 组处理:对大 KV group,全组 intra-group union 会导致稀疏度损失过大。故将每个 KV group 切分为更小的执行组(实现中用 4 个 query head 的子组)独立做 union,平衡稀疏保持与内核效率。
4.3 执行:零拷贝分页注意力(§3.3)
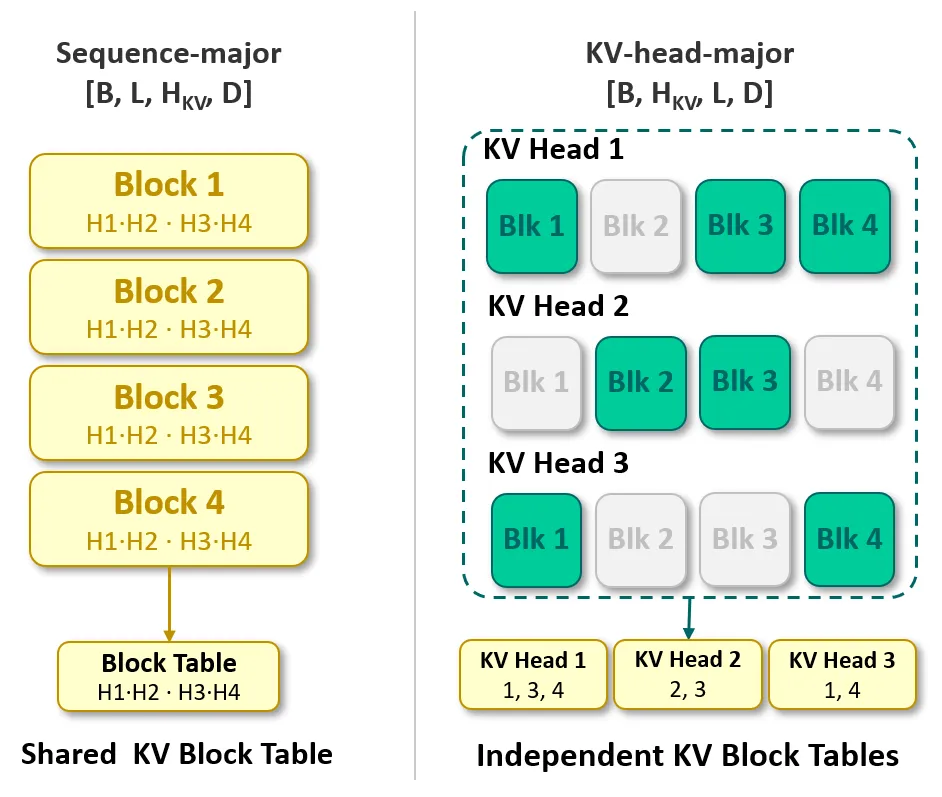
图 4:KV 缓存布局对比。sequence-major 布局迫使所有 KV head 共享单一块表,无法独立选块;KV-head-major 布局将每个 KV-head 块暴露为独立页,支持独立 KV 块表且无需拷贝 K/V 载荷。
核心要求:将 block-union 表表示为原始 KV 缓存上的元数据,而非重新物化的紧凑 KV 张量。
- sequence-major 布局 强制所有 KV head 共享同一块表,不满足 CompactAttention 的 group 相关块表需求。
- KV-head-major 布局 :每个 (batch, KV head, block) 三元组对应连续 内存区,将选中 KV 块变为元数据可寻址的页。
- CompactAttention 为每个 (batch, group) 行独立构造 ragged page list,仅传
kv_indptr与kv_indices元数据给分页内核,就地复用原始 K/V 载荷。
零拷贝优势:避免显式压缩到新分配的 dense buffer(其内存带宽开销随上下文、batch、选中块数增长)。且因用标准 dense paged-attention 后端,dense 内核的改进可直接采纳而无需改动选择阶段。
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 选择与执行解耦 | 2D 块稀疏掩码作「KV 选择信号」而非「稀疏内核执行计划」 | 图 3;瓶颈 = 选块 + 执行方式 |
| Q-block union | 跨 query block 求并 → 单一 1D KV 掩码,适配 dense paged attention | |
| Intra-group union | 跨组内 query head 求并 → GQA 感知 per-group 块表 | 覆盖率保持且最小 |
| 零拷贝分页执行 | KV-head-major 布局 + ragged page list 元数据,就地访问 | 图 4;避免 QUOKA 拷贝开销 |
| 激进 pattern search 补偿 | 用更激进初始掩码抵消 union 稀疏度损失 | §4.4 图 7a |
| 子组切分 | 大 GQA 组切为 4-head 子组独立 union | 平衡稀疏保持与内核效率 |
六、实验结果
6.1 实验设置(§4.1)
| 项目 | 配置 |
|---|---|
| 模型 | LLaMA-3.1-8B-Instruct(dense,128K)、Qwen3-30B-A3B-Instruct-2507(MoE,256K),均用 GQA |
| 精度基准 | RULER、LongBench V2 |
| Baseline | Dense(FlashInfer + FA2/FA3)、SeerAttention(block 64)、XAttention(block 128)、FlashPrefill(block 128)、QUOKA(固定 25% KV 预算) |
| 本方法实例 | CompactAttention-SA(用 LLaMA 预训练 SeerAttention gate)、CompactAttention-FP(FlashPrefill 训练无关阈值,两模型通用) |
| 硬件 | RTX PRO 6000(96GB GDDR7,Blackwell SM120,FA2)、H200 SXM(141GB HBM3e,Hopper SM90,FA3) |
注:Qwen3 无可用预训练 SeerAttention gate,故 SeerAttention 与 CompactAttention-SA 仅在 LLaMA 上评测。
6.2 加速比(§4.2)
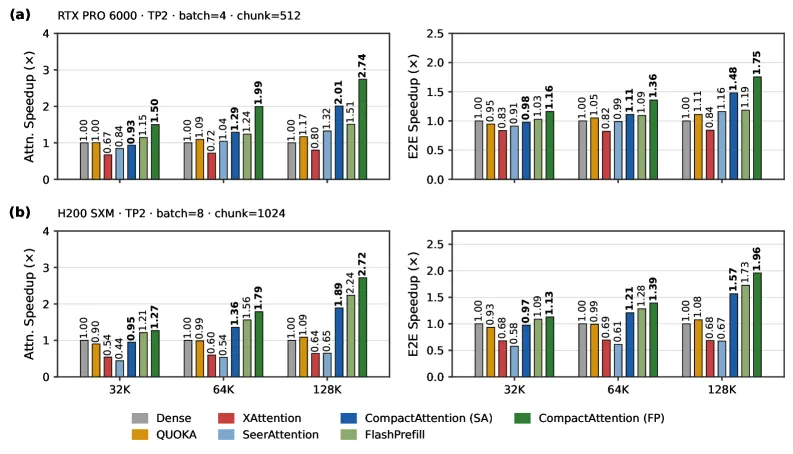
图 5:chunked prefill 下 LLaMA-3.1-8B 的注意力与端到端加速。(a) RTX PRO 6000,TP=2,batch 4,chunk 512;(b) H200,TP=2,batch 8,chunk 1024。CompactAttention 在长上下文增益最大,且注意力级改进转化为端到端延迟下降。
- QUOKA:长上下文加速有限,token 级 gather-and-pack 开销抵消了少算 token 的收益。
- XAttention / SeerAttention:常慢于 dense,反映重复 pattern search 开销 + Q≪KV 下块稀疏执行低效。
- FlashPrefill:最强块稀疏 baseline(轻量 pattern search + 优化块稀疏执行)。
- CompactAttention-SA/FP:加速随上下文增长;H200 @128K,CompactAttention-FP 达 2.72× 注意力加速、1.96× 端到端加速。两变体在长上下文均超越对应块稀疏 baseline,证明 zero-copy paged 执行胜过 union 的稀疏度损失。
6.3 精度(§4.3)
RULER 精度(Table 1,chunk 1024)
| 方法 | LLaMA-3.1-8B Avg | Qwen3-30B-A3B Avg |
|---|---|---|
| Dense | 82.78 | 90.46 |
| QUOKA | 77.98 | 80.19 |
| XAttention | 82.31 | 89.78 |
| SeerAttention | 82.46 | – |
| CompactAttention-SA | 82.44 | – |
| FlashPrefill | 82.35 | 88.68 |
| CompactAttention-FP | 82.30 | 89.29 |
- QUOKA 一致低于 dense(两模型、各上下文),印证 §2.2 覆盖率局限:query 子采样漏掉未采样 query 重要的 KV。
- 块稀疏方法(XAttention/SeerAttention/FlashPrefill)接近 dense,说明评估所有 query block 的块级选择器更好保留相关计算。
- CompactAttention 复用同一块级 pattern search 并经 union 保留选中块,精度贴近对应块稀疏 baseline,同时规避其稀疏内核低效。
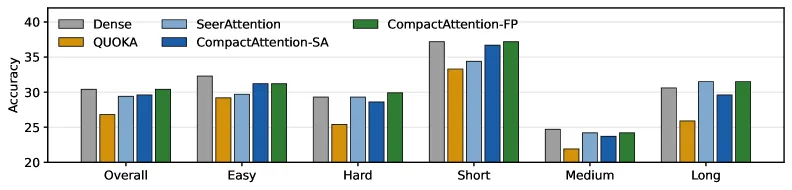
图 6:LLaMA-3.1-8B 上 LongBench V2 精度(chunk 1024)。CompactAttention 各变体跨难度与上下文长度组接近 dense,QUOKA 明显退化(尤其 Hard 样本)。
6.4 消融实验(§4.4,聚焦 CompactAttention-FP)
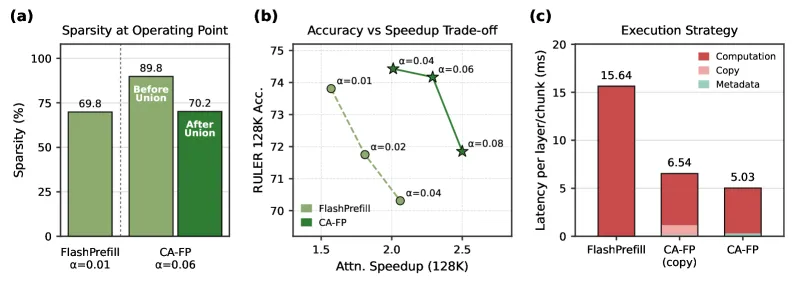
图 7:(a) 选定工作点的稀疏度;(b) RULER 128K 上 α 扫描的精度-加速权衡;(c) 相同 union 掩码、匹配稀疏度下的纯执行策略消融。
- (a) 稀疏度分析:FlashPrefill() 达 69.8% 稀疏度;CompactAttention-FP 用更激进初始掩码(,89.8% 稀疏度),经两次 union 后降至 70.2%——与 FlashPrefill 相当的执行稀疏度,同时保留 block-union 表所需的选中块。
- (b) pattern search 激进度:α 扫描下,CompactAttention-FP 在高精度工作区始终优于 FlashPrefill(同等或更高精度下更高注意力加速)。
- (c) 执行策略(相同 union 掩码、匹配稀疏度,隔离执行影响):
- block-sparse 变体:直接用块稀疏内核执行
- CompactAttention-FP (Copy):先 gather 选中 KV 到连续 buffer 再调 dense attention(拷贝开销)
- CompactAttention-FP:块表作分页元数据就地访问(仅元数据开销)
- 结论:尽管有元数据成本,CompactAttention-FP 延迟最低——就地分页执行优于稀疏内核执行与显式 KV 压缩。
七、局限性与总结
局限性(§5)
- 继承底层 pattern search 质量:初始掩码漏掉的块无法由 block-union 恢复。
- 以稀疏度换覆盖率:Q-block/intra-group union 保留组内任一 query 选中的块。dense paged 执行在评测设置下胜过此稀疏损失,但权衡随模型架构、上下文长度、chunk size、稀疏超参、执行组划分而变。
- 需足够大的累积 KV 来摊薄 pattern search 与元数据构造开销——故端到端增益随上下文增长而更显著。
核心贡献(§6)
- 重新定义瓶颈:chunked prefill 下稀疏注意力的瓶颈不仅是「选哪些 KV 块」,更是「选中块如何执行」。
- Block-Union KV Selection:2D 块稀疏掩码 → 经 Q-block union + intra-group union → per-group KV 块表(覆盖率保持且最小)。
- 零拷贝分页执行:KV-head-major 布局 + 元数据寻址,就地复用 K/V 载荷,使稀疏选择与高效 dense paged attention 内核兼容。
- 实验验证:RULER/LongBench V2 精度接近 dense,H200 @128K 达 2.72× 注意力加速,为长上下文 LLM 服务提供实用加速路径。
八、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.16839
- HTML 版本:https://arxiv.org/html/2605.16839v1
- 执行后端:FlashInfer 0.6.9(FlashAttention-2/3)
- 相关方法:QUOKA、SeerAttention、FlashPrefill、XAttention、RULER、LongBench V2