DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers
基于 PCA 旋转的 DiT 4-bit 后训练量化框架
DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers |
| 作者 | Sayeh Sharify, Mahsa Salmani, Hesham Mostafa |
| 机构 | d-Matrix |
| 论文 | arXiv:2605.16732 |
| 代码 | GitHub |
| 发布 | 2026年5月16日 |
| 主题 | cs.CV, cs.AI |
二、核心思想
问题定义
Diffusion Transformers (DiTs) 在图像生成中达到 SOTA 质量,但推理时内存和计算成本巨大。将模型激进量化到 4-bit 精度可带来显著效率提升,但通常导致严重的质量退化。现有方法(平滑、混合精度、旋转、低秩残差)部分缓解了这个问题,但与 FP16/BF16 性能仍有明显差距。
核心观察
DiT 激活存在显著的时间步依赖和通道级异常值:
- 时间步变化: 激活幅度随去噪时间步剧烈变化
- 通道级异常值: 原始激活的 max/median 比高达 83×
- PCA 可有效隔离异常值: PCA 将异常值能量集中到少量高方差子空间
- 旋转进一步均衡化: 随机正交旋转将残差子空间的 max/median 比降至 2×
解决方案概述
DiRotQ 提出 PCA 引导的旋转感知 W4A4 后训练量化框架:
- 通过 PCA 识别捕获主导激活方差的低秩子空间
- 保留该子空间的系数为高精度(16-bit)
- 将剩余分量量化到 4-bit
- 使用随机正交旋转进一步均衡化低精度子空间
- 结合 GPTQ 权重量化
核心性能
| 指标 | 数值 |
|---|---|
| PixArt-Σ INT W4A4 FID | 15.9 (vs SVDQuant 18.9) |
| PixArt-Σ INT W4A4 PSNR | 19.1 dB (vs SVDQuant 17.6 dB) |
| FLUX.1-dev 内存节省 | 2.1× |
| FLUX.1-dev 加速 (batch=1) | 2.3× |
| FLUX.1-dev 加速 (batch=2) | 9.2× (避免 CPU offload) |
三、技术架构
核心洞察
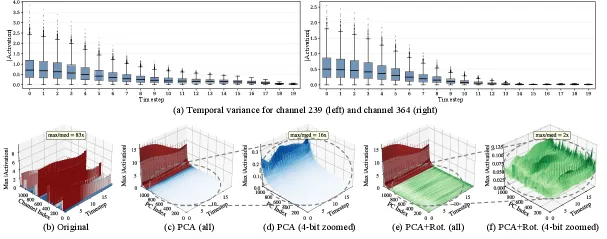
Figure 1: PixArt-Σ Block 2 自注意力输入激活分布。(a) 通道 239 和 364 的时间方差。(b) 原始激活显示严重通道级方差(max/median=83×)。(c,d) PCA 将异常值隔离到 16-bit 子空间(红色),剩余 4-bit 通道(蓝色)比值降至 16×。(e,f) 旋转进一步均衡化 4-bit 子空间(绿色),比值降至 2×。
核心公式
基础量化
给定全精度张量 ,-bit 量化:
\hat{X} = Q(X) = \lfloor \frac{X - z}{s} \rceil \cdot s + z \tag{1}
其中 为 round-and-clip 操作, 为缩放因子, 为零点。
层级量化目标
\min_{Q(W^{(l)}), Q(X^{(l)})} \sum_{l}^{L} \left( \underbrace{\|W^{(l)} - Q(W^{(l)})\|_F^2}_{\text{weight quantization error}} + \underbrace{\|X^{(l)} - Q(X^{(l)})\|_F^2}_{\text{activation quantization error}} \right) \tag{2}
PCA 引导的旋转量化
Step 1: PCA 旋转
将激活 旋转到 PCA 基 :
\hat{X} = XU, \quad U = [U_h \quad U_l], \quad U \in \mathbb{R}^{m \times m} \tag{3}
其中:
- : 对应最大特征值的 top- 特征向量,捕获高方差分量
- : 残差低方差子空间
- ,(经验最优)
Step 2: 随机正交旋转
对低精度残差子空间应用随机正交旋转 :
进一步均衡化方差,改善共享量化缩放因子的效率。
Step 3: 组合旋转
组合旋转矩阵 ,前向计算:
Y = XW = XVV^T W = [XU_h \quad \tilde{X}_l] \begin{bmatrix} U_h^T W \\ (U_l R)^T W \end{bmatrix} \tag{4}
Step 4: 离线权重融合
逆旋转 和 可离线融合到权重中:
前向计算简化为:
Y = [XU_h \quad \tilde{X}_l] \begin{bmatrix} \tilde{W}_h \\ \tilde{W}_l \end{bmatrix} \approx [XU_h \quad Q(\tilde{X}_l)] \begin{bmatrix} \tilde{W}_h \\ Q(\tilde{W}_l) \end{bmatrix} \tag{5}
关键设计
| 设计选择 | 说明 |
|---|---|
| PCA 基共享 | 每层跨所有时间步聚合校准激活计算 PCA,避免权重内存膨胀 |
| 随机旋转复用 | 对相同残差维度 的所有层共享同一随机正交矩阵(固定种子) |
| 前向旋转在线 | 因 AdaLN、softmax、GELU 等非线性层阻止融合到前序权重 |
| 逆旋转离线 | 融合到同层权重,零推理开销 |
| 高精度尾部比例 | ,QSNR 在此饱和,每增加 5% 增益 <0.5 dB |
激活 QSNR 提升
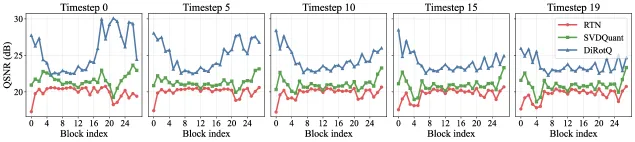
Figure 2: PixArt-Σ 28 个 Transformer 块在 5 个时间步的自注意力输出投影逐块激活 QSNR。DiRotQ 在所有块和时间步上一致超越 RTN 和 SVDQuant 5-10 dB。
量化格式
| 格式 | 权重 | 激活 | 缩放因子 | 分组大小 |
|---|---|---|---|---|
| INT W4A4 | 4-bit INT | 4-bit INT (非对称) | 16-bit | 64 |
| NVFP W4A4 | NVFP4 | NVFP4 | FP8 | 16 |
| W4A8 | 4-bit INT | 8-bit 动态 | - | per-token/channel |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| PCA 旋转感知量化 | 在激活空间而非权重空间操作,直接捕获激活统计 | max/median 比从 83× 降至 16× |
| 混合精度子空间 | 高方差子空间保留 16-bit,低方差子空间 4-bit | 即可,QSNR 提升 5-10 dB |
| 随机正交旋转均衡化 | 进一步均衡低精度子空间方差 | max/median 比从 16× 降至 2× |
| 离线权重融合 | 逆旋转融合到权重,零推理开销 | 仅前向旋转在线 |
| VLM-as-a-Judge 评估 | 首次将 VLM 评估引入扩散模型量化 | InternVL2-8B / Qwen2-VL-7B 评估一致性 |
| Triton 旋转内核 | 高效端到端推理实现 | 2.1× 内存节省,2.3× 加速 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 模型 | PixArt-Σ (600M), FLUX.1-dev (12B), SANA-1.6B |
| 校准 | 128 COCO Captions prompts |
| 评估数据集 | MJHQ-30K (5K), sDCI (5K) |
| 硬件 | NVIDIA RTX 4090 (24 GB) |
| 指标 | FID↓, IR↑, LPIPS↓, PSNR↑ |
| VLM 评估 | InternVL2-8B, Qwen2-VL-7B-Instruct |
精度对比 (PixArt-Σ, MJHQ-30K)
| 方法 | 精度 | FID↓ | IR↑ | LPIPS↓ | PSNR↑ |
|---|---|---|---|---|---|
| FP16 Baseline | FP16 | 16.6 | 0.952 | - | - |
| PTQ4DiT | INT W4A8 | 39.8 | 0.572 | 0.531 | 12.8 |
| Q-DiT | INT W4A8 | 19.6 | 0.874 | 0.500 | 13.8 |
| ViDiT-Q | INT W4A4 | 21.1 | 0.896 | 0.698 | 10.0 |
| SVDQuant | INT W4A4 | 18.9 | 0.871 | 0.319 | 17.6 |
| DiRotQ | INT W4A4 | 15.9 | 0.941 | 0.236 | 19.1 |
| SVDQuant | NVFP W4A4 | 16.8 | 0.933 | 0.264 | 18.6 |
| DiRotQ | NVFP W4A4 | 16.0 | 0.946 | 0.224 | 19.6 |
关键发现: DiRotQ INT W4A4 甚至超越 FP16 baseline(FID 15.9 vs 16.6),且显著优于 SVDQuant。
跨模型泛化
| 模型 | 精度 | DiRotQ FID | SVDQuant FID | DiRotQ PSNR | SVDQuant PSNR |
|---|---|---|---|---|---|
| PixArt-Σ | INT W4A4 | 15.9 | 18.9 | 19.1 | 17.6 |
| FLUX.1-dev | INT W4A4 | 19.8 | 19.7 | 24.6 | 21.0 |
| SANA-1.6B | INT W4A4 | 16.0 | 16.1 | 23.5 | 18.1 |
消融实验 (PixArt-Σ, MJHQ-30K)
| PCA | Rotation | GPTQ | 精度 | FID↓ | IR↑ | PSNR↑ |
|---|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | INT W4A4 | 40.3 | 0.512 | 13.0 |
| ✓ | ✗ | ✗ | INT W4A4 | 19.7 | 0.892 | 14.6 |
| ✓ | ✓ | ✗ | INT W4A4 | 19.2 | 0.904 | 14.8 |
| ✓ | ✓ | ✓ | INT W4A4 | 15.9 | 0.941 | 19.1 |
| ✗ | ✗ | ✗ | NVFP W4A4 | 27.7 | 0.710 | 14.7 |
| ✓ | ✗ | ✗ | NVFP W4A4 | 16.7 | 0.899 | 17.1 |
| ✓ | ✓ | ✗ | NVFP W4A4 | 16.7 | 0.912 | 17.3 |
| ✓ | ✓ | ✓ | NVFP W4A4 | 16.0 | 0.946 | 19.6 |
关键发现:
- PCA 旋转是最关键组件:FID 从 40.3 降至 19.7
- 随机旋转提供额外一致增益
- GPTQ 与旋转协同,将 DiRotQ 推近 FP16 质量
高精度尾部比例
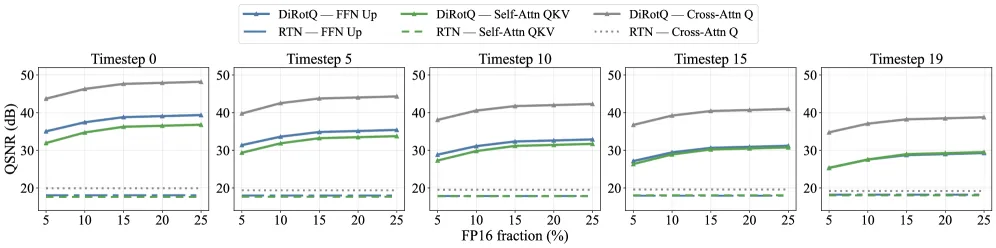
Figure 7: PixArt-Σ 激活 QSNR 随 FP16 尾部比例 的变化。QSNR 在 前急剧提升,之后饱和(每增加 5% 增益 <0.5 dB)。
效率评估
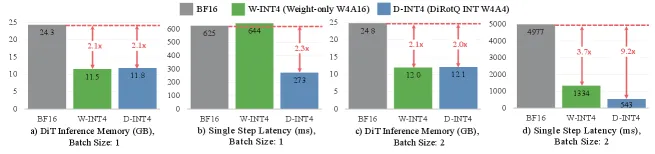
Figure 4: FLUX.1-dev 在 batch size 1 和 2 下的内存使用和单步延迟。
| 指标 | BF16 | DiRotQ INT W4A4 | 提升 |
|---|---|---|---|
| 内存 (batch=1) | ~24 GB | ~11.4 GB | 2.1× 节省 |
| 延迟 (batch=1) | 基准 | - | 2.3× 加速 |
| 延迟 (batch=2) | 需 CPU offload | GPU 内 | 9.2× 加速 |
关键发现: batch=2 时 BF16 需要 CPU offload,DiRotQ 完全在 GPU 内存中运行,避免了 offload 开销。
VLM-as-a-Judge 评估
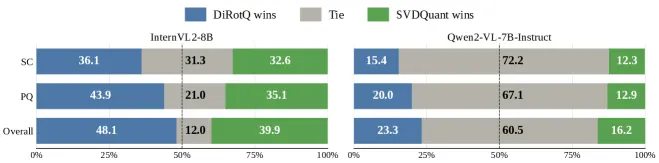
Figure 5(a): INT4 量化下 DiRotQ vs SVDQuant 的 VLM 评估对比。InternVL2-8B 在 Overall 分数上偏好 DiRotQ 48.1% vs SVDQuant 39.9%。
逐块激活 QSNR
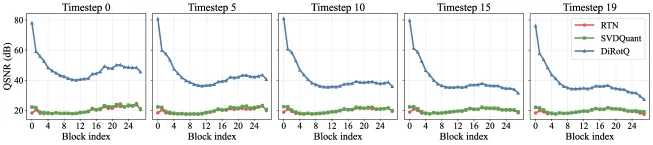
Figure 6: PixArt-Σ 各层类型的逐块激活 QSNR 对比。DiRotQ 在所有层类型上一致超越 RTN 和 SVDQuant。
六、与 SVDQuant 的关键区别
| 方面 | SVDQuant | DiRotQ |
|---|---|---|
| 操作空间 | 权重空间 | 激活空间 |
| 异常值处理 | SVD 低秩分解 | PCA 子空间分离 |
| 旋转 | 无 | PCA + 随机正交旋转 |
| 时间步处理 | 平滑 | 跨时间步共享 PCA 基 |
| PixArt-Σ INT W4A4 FID | 18.9 | 15.9 |
| PixArt-Σ INT W4A4 PSNR | 17.6 dB | 19.1 dB |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| QuaRot | LLM 旋转量化,但不适用于 DiT 的时间步变化 |
| ResQ | PCA 旋转用于 LLM,DiRotQ 扩展到 DiT |
| SpinQuant | 学习旋转矩阵,DiRotQ 使用数据驱动 PCA |
| SVDQuant | 权重空间低秩分解,DiRotQ 在激活空间操作 |
| PTQ4DiT | W4A8 方法,DiRotQ 达到 W4A4 |
| ViDiT-Q | 旋转+平滑,DiRotQ 更精细的子空间分离 |
| Q-DiT | 动态量化粒度,DiRotQ 通过旋转解决 |
八、总结
核心贡献
- PCA 旋转感知 W4A4 PTQ: 首个在激活空间使用 PCA 旋转的 DiT 4-bit 量化框架
- 混合精度子空间: 高方差子空间 16-bit + 低方差子空间 4-bit, 即可
- VLM-as-a-Judge 评估: 首次将 VLM 评估引入扩散模型量化领域
- 高效 Triton 实现: 2.1× 内存节省,2.3× 加速(RTX 4090)
- 超越 FP16: PixArt-Σ INT W4A4 FID 15.9 vs FP16 16.6
技术影响
- 激活空间是 DiT 量化的正确方向: 相比权重空间方法,直接捕获激活统计更有效
- PCA 是处理 DiT 异常值的有效工具: 集中异常值能量到少量主成分
- 旋转量化可扩展到 DiT: 解决了 AdaLN 和时间步变化的挑战
- W4A4 可达到甚至超越 FP16 质量: 在 PixArt-Σ 上实现
局限性
- 前向旋转仍需在线计算(因非线性层阻止融合)
- PCA 基跨时间步共享,无法适应单个时间步的特殊统计
- 仅在 text-to-image 任务验证,未扩展到视频生成
- 需要 128 个校准样本
九、参考资源
- 论文: arXiv:2605.16732
- 代码: GitHub - d-Matrix/dirotq
- 主题: cs.CV, cs.AI