Seed3D 2.0: Advancing High-Fidelity Simulation-Ready 3D Content Generation
高保真仿真就绪3D内容生成系统,支持场景布局、部件分解和铰接生成
Seed3D 2.0: Advancing High-Fidelity Simulation-Ready 3D Content Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Seed3D 2.0: Advancing High-Fidelity Simulation-Ready 3D Content Generation |
| 作者 | ByteDance Seed, Jianfeng Zhang 等 |
| 机构 | ByteDance Seed |
| 论文 | arXiv:2605.13862 |
| 主页 | seed.bytedance.com/seed3d_2_0 |
| 发布 | 2026年4月22日 |
| 领域 | cs.GR, cs.CV |
二、核心思想
问题定义
高质量3D资产在XR内容创建、3D打印和机器人模拟等领域有广泛需求,每个领域对几何精度、材料保真度、物理引擎兼容性以及复杂资产结构和交互支持都有不同要求。Seed3D 1.0建立了从单图像生成仿真就绪3D资产的基础,但存在两个明显差距:
-
质量差距:生产环境需要几何规整性(锐利边缘、结构一致的表面)和基于物理的材料(在不同光照下保持视觉一致性)。现有模型生成的形状看似合理,但在这些细粒度标准上始终不足。
-
能力差距:随着应用需求增长,静态整体网格已不够:下游用例越来越多地需要连贯的多对象场景、功能分解的资产和支持部件级物理交互的资产。
解决方案概述
Seed3D 2.0 是一个全面的高保真仿真就绪3D内容生成系统,包含三个核心创新:
-
增强几何生成:粗到细两阶段生成管道,将全局结构学习与高频细节恢复解耦;局部感知VAE实现更高空间压缩和更高效解码。
-
统一PBR纹理生成:用统一的PBR模型替代Seed3D 1.0的级联管道,直接生成多视角albedo和metallic-roughness贴图;MoE扩展和VLM语义条件化提升材料精度和视觉保真度。
-
仿真就绪模型套件:场景布局规划、部件感知分解、免训练铰接生成,支持跨物理和图形引擎的连贯场景构建和部件级物理交互。
核心成果:
- 人类偏好研究中,相比5个商业模型,端到端纹理资产生成胜率 69.0% - 89.9%
- 仅形状生成胜率 55.2% - 98.3%
三、技术架构
整体框架图
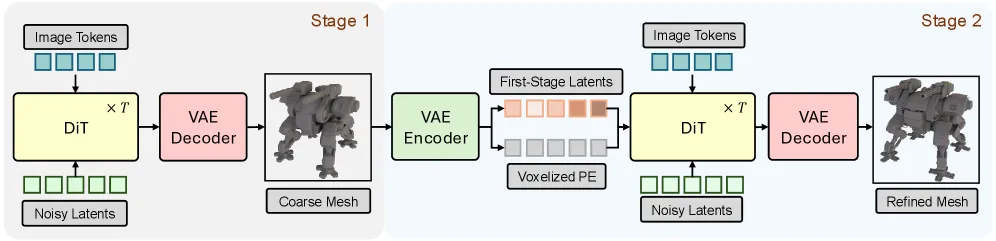
Figure 2: Seed3D 2.0几何生成管道概览。Stage 1学习生成粗略几何结构,Stage 2细化粗略几何并产生高频细节。
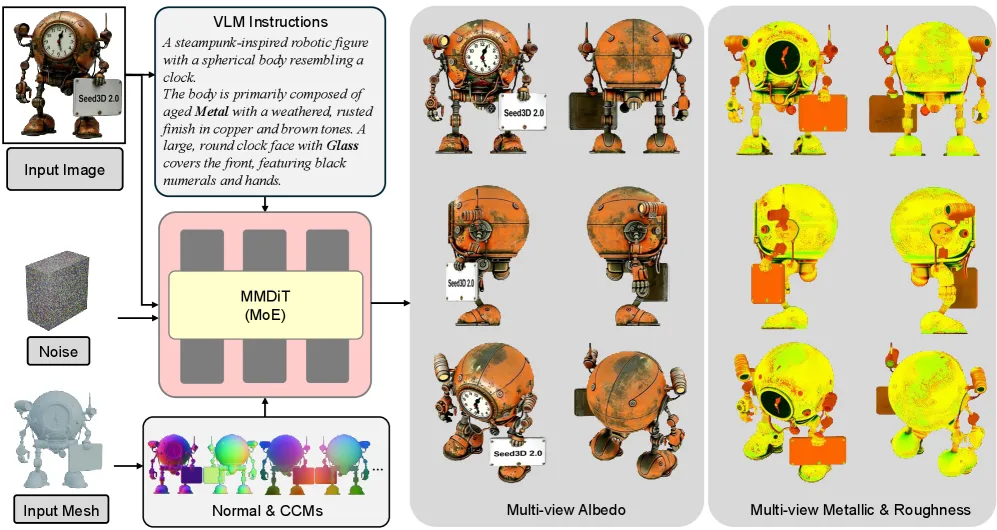
Figure 3: Seed3D 2.0纹理生成管道概览。统一模型在VLM先验指导下生成多视角albedo和材质。
核心公式
Seed3D-VAE(局部感知VAE)
编码过程:
局部感知聚合:
利用VecSet表示的结构特性:同一空间邻域内的token编码冗余几何信息,在编码期间跨空间邻域合并token,将表示能力集中在几何复杂区域。
SDF解码:
内容自适应稀疏路由:
将密集注意力替换为内容自适应稀疏路由机制,将每个空间查询限制在紧凑、空间一致的token子集上。
Seed3D-DiT(两阶段扩散变换器)
Rectified Flow扩散框架:
Stage 1: 粗结构生成:
Stage 2: 细节细化:
粗形状先验:Stage 1的latents被部分扩散并纳入Stage 2扩散过程作为粗几何参考。
体素化位置编码:Stage 1产生的粗几何提供体素化空间坐标,注入Stage 2扩散过程作为位置编码。
统一PBR纹理模型
双流MMDiT架构:
MoE扩展:
其中 是门控函数, 是专家网络。稀疏专家路由在保持较低计算开销的同时扩展网络容量。
VLM先验条件化:
部件级生成
Seed3D-PartSeg:
使用原生3D骨干网络从随机采样点提取几何特征,然后通过分割头产生部件掩码。
Seed3D-PartDiT:
使用修改的注意力设计在去噪过程中强制部件间和部件内交互。
铰接生成
免训练管道:
- VLM语义先验:组织分解部件,识别关节类型
- 几何先验:基于部件几何生成关节轴候选
- 动态先验:使用图像到视频生成模型推断运动范围
运动范围估计:
通过可微渲染拟合生成的运动序列来估计关节范围。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Seed3D-VAE | 局部感知3D VAE | VecSet表示,双分支感知器编码器-解码器 |
| Seed3D-DiT | 两阶段扩散变换器 | Rectified Flow,从Stage 1检查点初始化 |
| 统一PBR模型 | MoE双流MMDiT | 直接生成albedo和MR贴图 |
| Seed3D-PartSeg | 部件分割模型 | 原生3D骨干,稀疏点提示 |
| Seed3D-PartDiT | 部件补全模型 | 部件间/内注意力,全局形状注入 |
| 场景布局规划 | LLM空间推理 | 视觉/文本输入,自动组合管道 |
| 铰接生成 | 免训练铰接推断 | VLM + 几何 + 图像到视频先验 |
训练流程
几何生成训练:
Stage 1(基础训练):
- 预训练(PT):256 latent tokens,256分辨率图像,从头开始训练
- 继续训练(CT):渐进增加到4096 tokens,512分辨率图像
- 监督微调(SFT):高质量策划子集,降低学习率
Stage 2(精度细化训练):
- 初始化:从Stage 1检查点初始化
- 继续训练(CT):加入体素化位置编码和部分扩散的Stage 1 latents
- 高级SFT:精心策划的高质量样本,提升锐利度和几何规整性
纹理生成训练:
- 预训练:MoE架构在大规模数据集上训练,学习多视角albedo和MR生成
- 监督微调(SFT):高质量子集微调,引入VLM生成的材料描述作为条件信号
数据管道
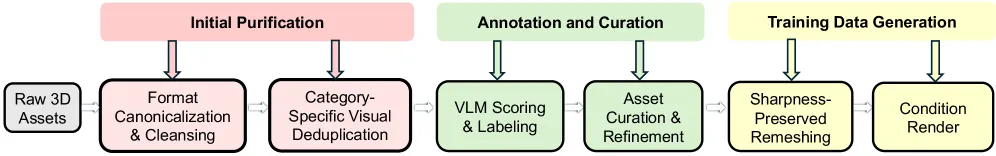
Figure 5: Seed3D 2.0数据预处理框架概览。六阶段数据预处理管道确保训练数据集质量。
六阶段数据处理:
- 格式规范化和清洗:统一表示(网格几何+多通道PBR纹理),几何净化去除伪3D广告牌伪影
- 类别特定视觉去重:基于2D特征的动态阈值,防止视觉同质类别过度过滤
- 高级VLM评分和描述:微调VLM评估6个维度(语义、结构、感知),LLM作为仲裁器
- 资产策划和细化:VLM标签过滤低质量候选,引导目标细化(规范方向对齐、实例解耦)
- 锐利度保持水密重网格:GPU加速管道,度量保持二面角和边缘不连续性,分辨率重建在15秒内完成
- 条件渲染:生成扩散过程的高质量条件信号(视角一致几何渲染、多通道PBR纹理渲染)
推理优化
渐进蒸馏管道:
- CFG蒸馏:学生模型在单次前向传播中预测CFG组合输出,将每步计算减半
- 渐进步数蒸馏:迭代减半采样步数,每轮学生学习在单步中匹配教师的两步输出
蒸馏模型在视觉保真度、多视角一致性和参考图像对齐三个维度上达到与全步CFG引导模型相当的性能。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 粗到细两阶段生成 | 将全局结构学习与高频细节恢复解耦 | 消除单阶段生成的固有张力 |
| 局部感知VAE | 更高空间压缩比,内容自适应稀疏路由 | 更少latent tokens实现更高重建质量 |
| 统一PBR模型 | 直接生成albedo和MR贴图,消除中间误差累积 | 替代Seed3D 1.0的级联管道 |
| MoE扩展 | 稀疏专家路由扩展网络容量 | 更高分辨率生成,计算开销成比例 |
| VLM语义条件化 | 解决未知光照下PBR估计的不适定性 | 消除颜色偏移、镜面高光误分类等失败模式 |
| 场景布局规划 | 视觉/文本输入的自动场景构建 | 从实例级生成扩展到场景级组合 |
| 部件感知分解 | 语义和功能一致的部件分割 | 支持细粒度资产控制 |
| 免训练铰接生成 | VLM + 几何 + 视频先验推断运动学结构 | 无需大规模铰接3D监督数据 |
| 渐进蒸馏 | 两阶段蒸馏降低推理成本 | 保持质量的同时大幅减少采样步数 |
与Seed3D 1.0对比
| 特性 | Seed3D 1.0 | Seed3D 2.0 |
|---|---|---|
| 几何生成 | 单阶段 | 粗到细两阶段 |
| VAE | 标准 | 局部感知,更高压缩 |
| 纹理管道 | 级联(MV RGB + PBR估计) | 统一PBR直接生成 |
| 分辨率 | 低 | MoE扩展的高分辨率 |
| 材料条件化 | 无 | VLM语义先验 |
| 场景生成 | 有限 | 完整场景布局规划 |
| 部件分解 | 无 | PartSeg + PartDiT |
| 铰接生成 | 无 | 免训练管道 |
五、实验结果
人类偏好研究
实验设置:
- 60名有3D建模背景的人类评估者
- 15名评估者随机分配评估每个对比的200+图像提示
- 盲配对比较,评估者判断哪个结果更好或两者相当
对比基线:
- Hunyuan3D-2.5
- Hunyuan3D-3.1
- Tripo 3.0
- Rodin Gen2 v1.9
- HiTem v2.0
- Seed3D 1.0
仅形状生成结果:
| 对比基线 | 胜率 |
|---|---|
| vs Seed3D 1.0 | 98.3% |
| vs Tripo 3.0 | 92.8% |
| vs Rodin Gen2 v1.9 | 89.6% |
| vs HiTem v2.0 | 79.2% |
| vs Hunyuan3D-3.1 | 55.2% |
端到端纹理资产生成结果:
| 对比基线 | 胜率 |
|---|---|
| vs Rodin Gen2 v1.9 | 89.9% |
| vs Tripo 3.0 | 85.7% |
| vs HiTem v2.0 | 82.4% |
| vs Hunyuan3D-2.5 | 78.3% |
| vs Hunyuan3D-3.1 | 69.0% |
定性比较
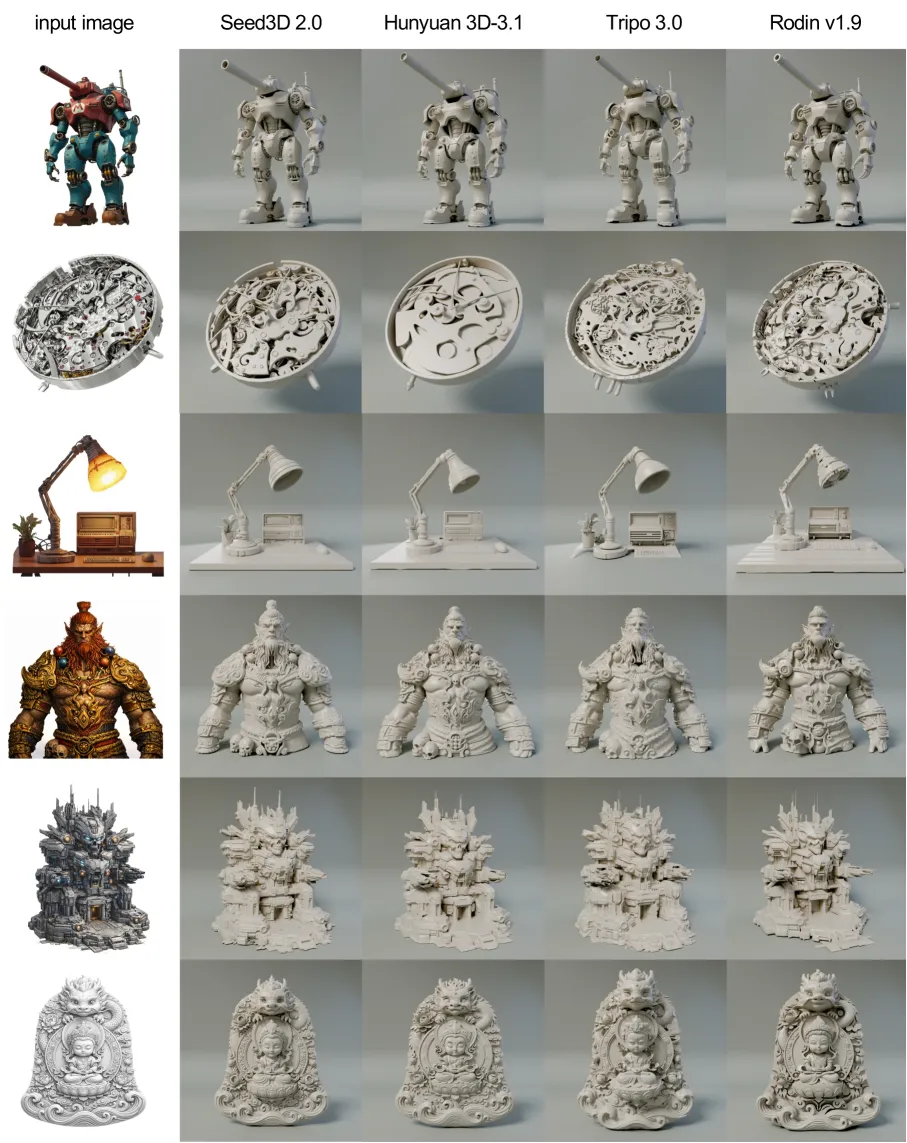
Figure 6: Seed3D 2.0与基线在3D形状生成方面的定性比较。Seed3D 2.0产生高精度几何,具有锐利结构细节和对输入图像的强忠实度。
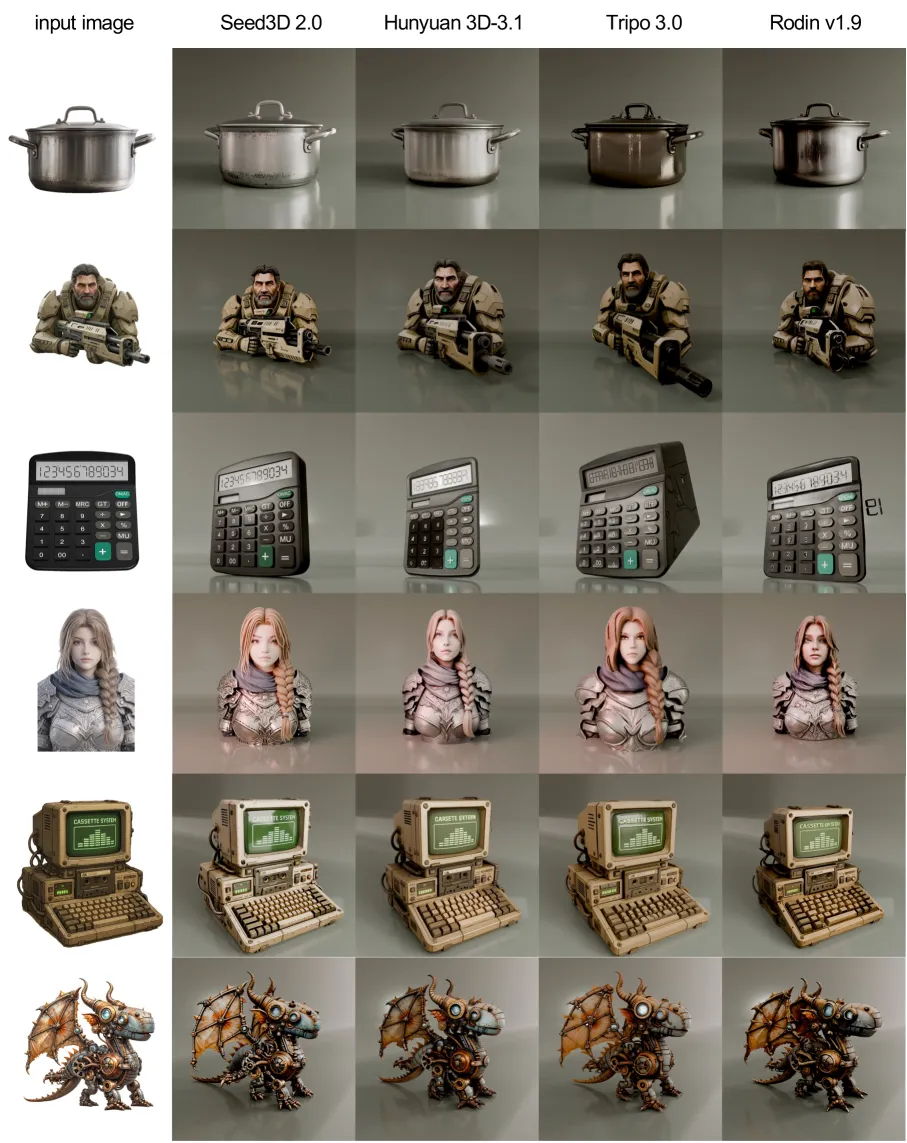
Figure 7: Seed3D 2.0与基线在纹理资产生成方面的定性比较。纹理质量和视觉保真度方面具有明显优势,包括准确的纹理分解和可靠的文本渲染。
关键发现
-
几何质量:
- 两阶段生成显著提升锐利边缘和细节恢复
- 局部感知VAE以更少latent tokens实现更高重建质量
-
纹理保真度:
- 统一PBR模型消除级联管道的误差累积
- VLM先验有效解决材料估计的歧义性
- 文本渲染保真度显著提升
-
仿真就绪能力:
- 部件分解支持功能级交互
- 铰接生成实现物理引擎中的部件级物理交互
- 场景布局规划支持连贯的多对象环境构建
六、相关工作
3D生成方法
- Seed3D 1.0:本文的基础,单阶段几何生成,级联纹理管道
- Hunyuan3D-2.5/3.1:腾讯的3D生成模型
- Tripo 3.0:商业3D生成服务
- Rodin Gen2 v1.9:微软的3D生成模型
- HiTem v2.0:高精度纹理生成模型
- TriposG:大规模rectified flow形状生成
- LATTICE:高保真3D生成
部件级方法
- AutoPartGen:自回归3D部件生成和发现
- PartCrafter:结构化3D网格生成
- PARIS:铰接物体的部件级重建和运动分析
- DragAPart:铰接物体的部件级运动先验
七、总结
核心贡献
-
增强几何生成:
- 粗到细两阶段DiT,解耦全局结构和高频细节
- 局部感知VAE,更高空间压缩和更高效解码
- 体素化位置编码和粗形状先验
-
统一PBR纹理生成:
- 直接生成多视角albedo和MR贴图
- MoE扩展实现更高分辨率生成
- VLM语义条件化解决材料估计歧义
-
仿真就绪模型套件:
- 场景布局规划(视觉/文本输入)
- 部件感知分解(PartSeg + PartDiT)
- 免训练铰接生成(VLM + 几何 + 视频先验)
-
数据和效率:
- 六阶段数据预处理管道
- 渐进蒸馏降低推理成本
- 分辨率重建15秒
技术影响
- 3D内容创建:从资产生成到场景构建的完整管道
- 仿真应用:支持物理引擎中的部件级物理交互
- 生产部署:渐进蒸馏支持大规模部署
- XR/具身AI:为具身AI和XR提供高质量3D资产
局限性
- 物理属性:目前仅估计基本物理属性(质量、摩擦),更丰富属性有待扩展
- 场景规模:场景生成规模有限,更大更复杂环境有待探索
- 下游集成:与下游管道的更深度集成有待实现
- 评估范围:主要通过人类偏好研究评估,自动化指标有限
未来工作
- 更丰富的物理属性估计
- 扩展场景生成到更大更复杂环境
- 与下游管道的更深度集成
- 支持更多交互类型和物理约束
八、参考资源
- 论文: arXiv:2605.13862
- PDF: arxiv.org/pdf/2605.13862
- HTML版本: arxiv.org/html/2605.13862v1
- 主页: seed.bytedance.com/seed3d_2_0
- API: Volcano Engine
引用
@article{seed3d2026,
  title={Seed3D 2.0: Advancing High-Fidelity Simulation-Ready 3D Content Generation},
  author={ByteDance Seed and Jianfeng Zhang and others},
  journal={arXiv preprint arXiv:2605.13862},
  year={2026}
}