KVServe: Service-Aware KV Cache Compression for Communication-Efficient Disaggregated LLM Serving
首个面向解耦式 LLM 服务的服务感知自适应 KV 缓存压缩框架,通过统一压缩策略空间 + 贝叶斯剖析引擎 + 服务感知在线控制器,PD 分离场景 JCT 加速最高 9.13x,KV 解耦场景 TTFT 降低最高 32.8x
KVServe: Service-Aware KV Cache Compression for Communication-Efficient Disaggregated LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | KVServe: Service-Aware KV Cache Compression for Communication-Efficient Disaggregated LLM Serving |
| 作者 | Zedong Liu, Xinyang Ma, Dejun Luo, Hairui Zhao, Bing Lu, Wenjing Huang, Yida Gu, Xingchen Liu, Zheng Wei, Jinyang Liu, Dingwen Tao, Guangming Tan |
| 论文 | arXiv:2605.13734 |
| 发布 | 2026 年 5 月 13 日 |
| 分类 | cs.DC / cs.LG |
| 基座系统 | vLLM 0.10.1 |
二、核心思想
问题定义
LLM 自回归生成需要维护并反复访问 KV 缓存(Key-Value Cache)。为提升吞吐、支持长上下文并降低成本,生产级服务系统正转向解耦式(disaggregated)推理架构:
- PD 分离(Prefill/Decode Separation):prefill 与 decode 运行在不同 GPU 节点,减少共置竞争、支持分阶段独立扩展。
- KV 状态解耦(KV State Disaggregation):KV 缓存卸载到存储层级或远程 KV 池,支持长上下文与跨请求复用(RAG、agent)。
核心痛点:在解耦架构下,KV 从「GPU 内部状态」变为必须跨网络/存储边界传输的显式载荷(explicit payload),成为端到端瓶颈。
- Llama-3.1-70B 在 128K token 时生成 39.06 GB KV
- 用 Qwen3-235B 服务 32K token 请求、64 节点 prefill 集群需要 2.1 Tbps 的 KV 出口带宽
- 而云端跨集群带宽常 <100 Gbps,远程存储/KV 池吞吐常 <10 Gbps
- 端到端实验中,KV 通信时间占 JCT 高达 60%(PD 分离)、高达 66%(状态卸载)
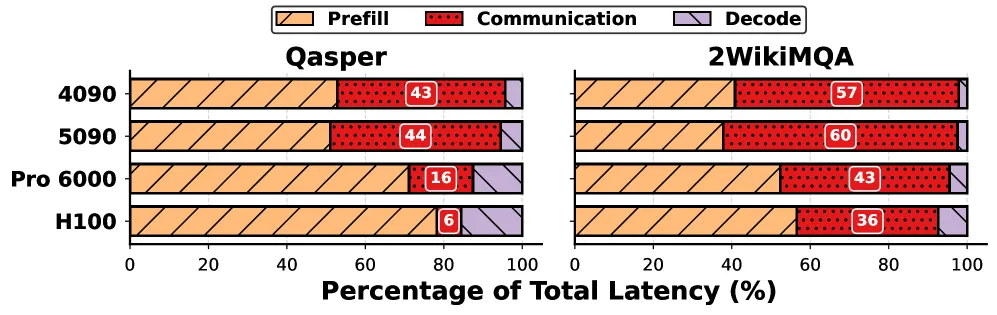
图 1:PD 分离服务下的时间拆解。10–50 Gbps 时通信占 JCT 的 16%–60%。
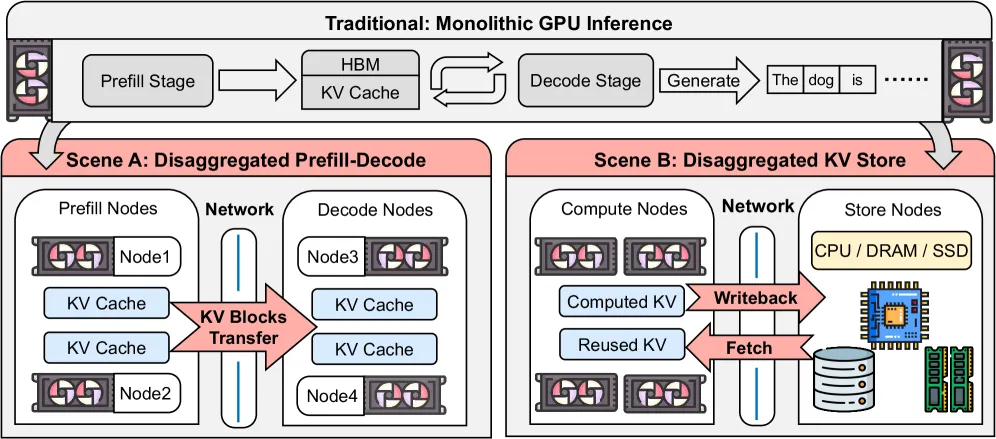
图 2:解耦式服务系统架构。KV 缓存从 GPU 内部状态变为需跨网络传输的 I/O 载荷,进入端到端延迟关键路径。
关键洞察:现有 KV 压缩方法(CacheGen、KIVI、KVQuant 等)均为静态运行时配置(固定 transform、量化粒度、编解码器)。但生产服务上下文随时间动态变化(工作负载类型、有效带宽、SLO/质量预算),固定选择可能次优,甚至增加延迟(负优化)。
因此,KV 压缩不是固定算法选择,而是一个受约束的、依赖服务状态的策略选择问题。
解决方案概述
KVServe 是首个面向解耦式 LLM 服务的服务感知(service-aware)自适应 KV 通信压缩框架,三大核心设计:
- 统一模块化策略空间:将 KV 压缩解耦为可插拔组件,支持跨方法重组,形成可枚举、可扩展的策略空间。
- 贝叶斯剖析引擎(Bayesian Profiling Engine):高效搜索该空间,蒸馏出 3D Pareto 候选集,离线搜索开销降低 50×(1000 小时 → 20 小时)。
- 服务感知在线控制器(Service-Aware Online Controller):结合解析式延迟模型 + 轻量 bandit,在约束下选择 profile 并修正离线到在线的失配。
核心结果:集成到 vLLM,PD 分离场景 JCT 加速最高 9.13×,KV 解耦场景 TTFT 降低最高 32.8×。
三、两大关键动机(Motivation)
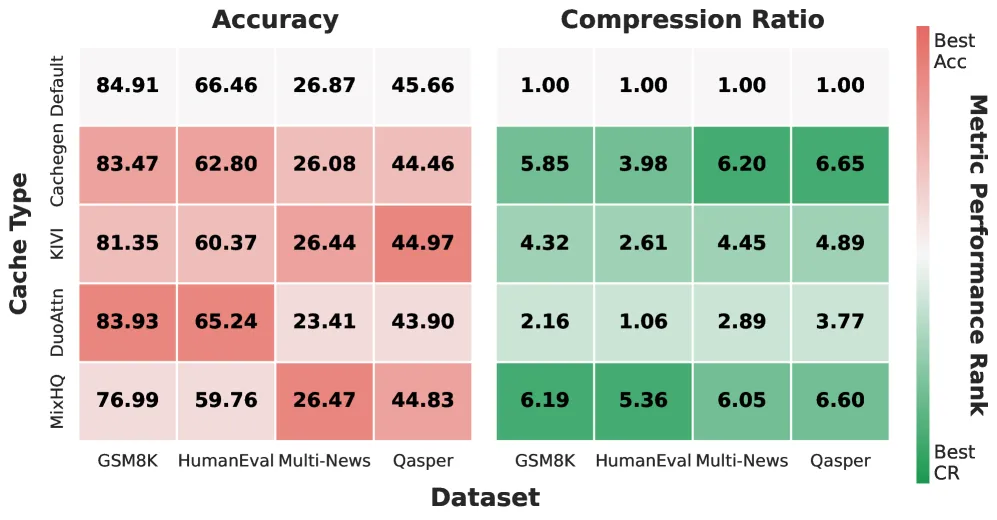
图 3:不同工作负载下的精度与压缩比。同一压缩策略在不同任务上表现差异巨大。
动机 1:最优 KV 压缩策略随服务工作负载而变
- KIVI 在 Qasper 上精度最佳,但在 GSM8K/HumanEval 上垫底
- DuoAttention 在 GSM8K/HumanEval 上最佳,但在 Multi-News/Qasper 上最差
- CacheGen 在 Multi-News 上压缩比 6.20×,但在 HumanEval 上仅 3.98×(低于 MixHQ 的 5.36×)
- TAKEAWAY-1:不存在跨工作负载通用的最优 KV 压缩策略,系统必须在多个候选策略间推理。
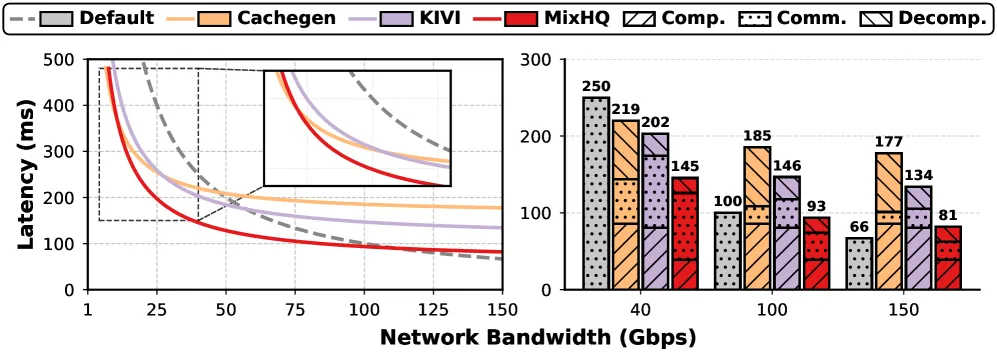
图 4:不同有效带宽下的 KV 延迟(左)与时间拆解(右)。最优策略随带宽切换。
动机 2:最优策略还依赖带宽——甚至可能损害性能
- KV 延迟 = 压缩后 KV 通信 + 压缩/解压。最优策略随带宽切换:极低带宽时 CacheGen 最优,带宽升高后被 MixHQ、KIVI 超越
- 每个 profile 仅在特定带宽区间内有益:一旦带宽超过阈值(三方法分别为 50/55/110 Gbps),通信节省无法抵消(解)压缩开销,导致延迟比不压缩更差
- TAKEAWAY-2:最优策略依赖动态服务条件,静态固定策略在实践中不安全,KV 压缩必须运行时自适应且服务感知。
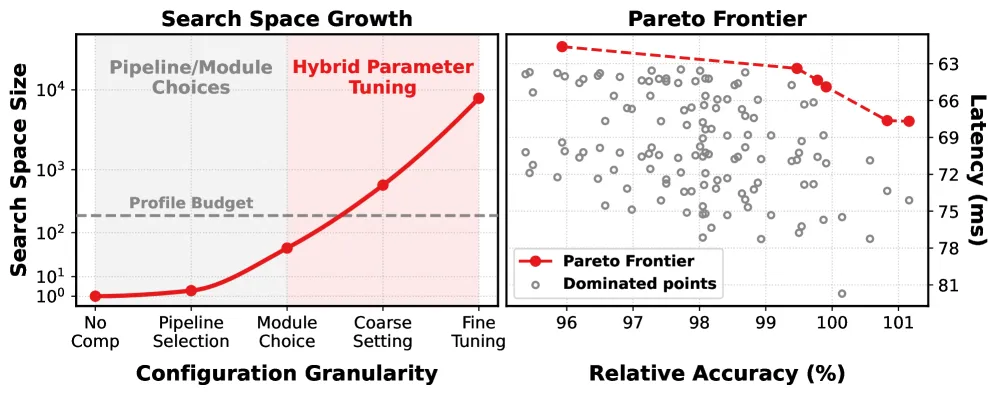
图 5:左:不同粒度下搜索空间大小(细粒度调优使空间迅速膨胀到近 10⁴ 候选);右:代表性 pipeline 的 131 个 profile 呈高度分散的延迟-精度权衡。
两大挑战:
- 挑战 1:策略空间组合爆炸。细粒度调优使候选数近 10⁴,每个需约 15 分钟端到端剖析,穷举需数十到数百 GPU 小时。
- 挑战 2:延迟-质量权衡缺乏明确决策原则。131 个候选高度分散,需在 SLO 与精度预算约束下选择可行且最优的策略。
四、问题形式化(Problem Formulation)
服务上下文抽象
服务上下文抽象为四元组:
- :会话段的工作负载类别(由上层 router/classifier 提供)
- :当前可用有效带宽(网络或 I/O goodput 的统一抽象)
- :延迟预算
- :最低质量要求
压缩策略(profile)参数化
- 压缩比 (=未压缩 KV 字节数,=压缩后大小)
- 有效(解)压缩吞吐 (编码与解码吞吐的调和平均):
故总编解码时间 =
- 质量指标 (工作负载 下的任务精度)
约束优化(核心 JCT 模型)
段级 JCT 分解为「与压缩策略无关的模型执行代价」+「KV 解压与移动的额外代价」:
可行策略集:
段级策略选择的约束优化问题:
该式显式刻画四因素联合作用:有效带宽 (时间节省上界)、有效吞吐 (额外开销)、压缩比 (压缩后 KV 量)、(质量代价)。
五、技术架构
整体框架
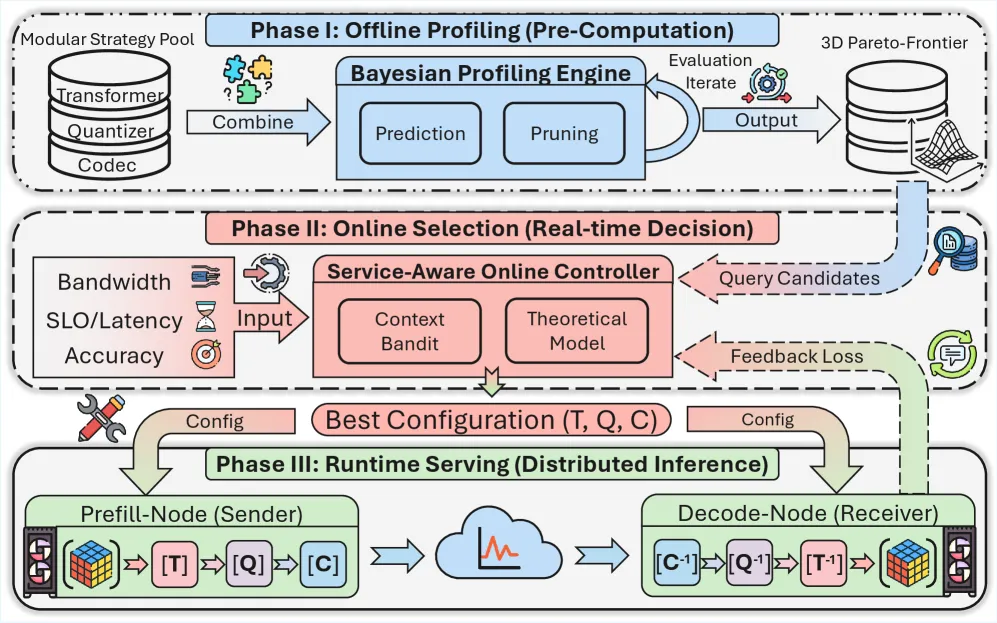
图 6:KVServe 总体架构。离线贝叶斯剖析引擎 + 在线服务感知控制器。
【离线】 Bayesian Profiling Engine (§5)
  统一压缩 pipeline → 贝叶斯优化搜索 → 3D Pareto 候选集(查找表)
                                              │
                                              ▼
【在线】 Service-Aware Online Controller (§6)
  感知服务上下文 (w, B, T_SLO, q_min)
    ├─ 解析模型:带宽阈值过滤(定理6.1) + 分段最优策略(定理6.2),O(1) 决策
    └─ 残差修正 bandit:EWMA 残差 + ε-greedy,修正离线-在线漂移
离线:统一压缩 Pipeline(§5.1)
将 KV 压缩生命周期形式化为三阶段顺序组合:
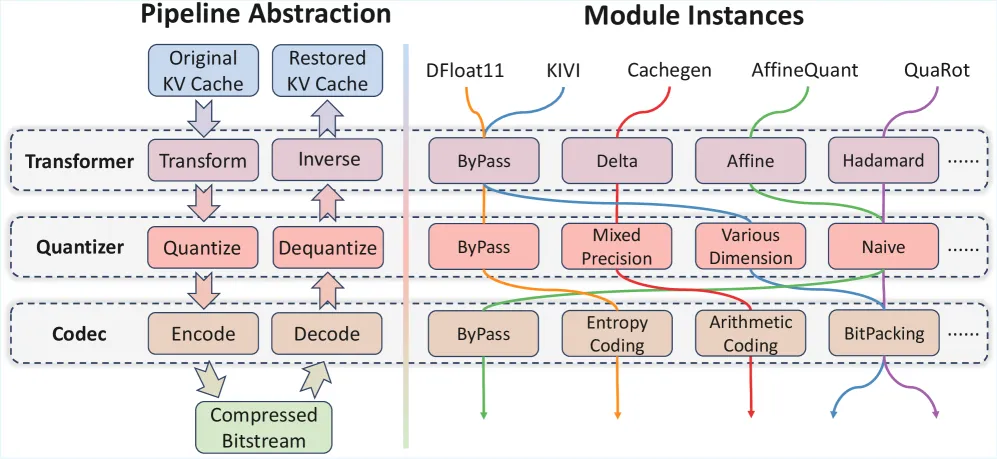
图 7:统一 KV 缓存压缩 Pipeline。三阶段可插拔组件。
| 阶段 | 符号 | 作用 | 可选模块 |
|---|---|---|---|
| ❶ Transformer | 预处理,重塑分布以利于下游压缩 | Delta、Hadamard、Affine | |
| ❷ Quantizer | 主要降位阶段,支持多维量化 | 支持 layer-wise / head-wise 混合精度 | |
| ❸ Codec | 编码数据流最小化 footprint | 集成 nvCOMP 高性能库 |
通过将 SOTA 方法分解为原子组件,KVServe 可探索其笛卡尔积(如 QuaRot transformer + CacheGen quantizer 组合),发现优于孤立基线的协同配置。
新组件 MixHQ(Mixed-Precision Head-Wise Quantization):
- 将范式从「二元剪枝」转向「可变精度分配」
- 区分 Retrieval Heads(高精度保留,保护长程依赖)与 Streaming Heads(激进超低位量化,而非丢弃)
- 与重要性估计粒度正交,可推广到 layer 维度(如 PyramidKV)与 token 维度(如 SnapKV),将离散剪枝决策转化为连续精度分配谱
离线:贝叶斯剖析引擎(§5.2)
两个关键观察:
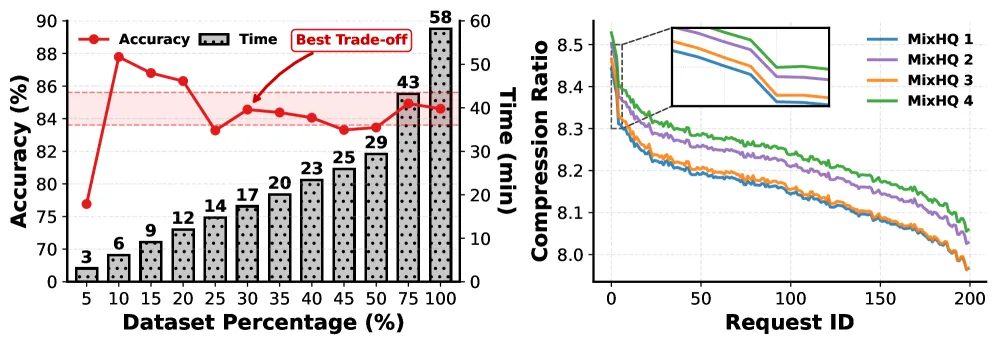
图 8:剖析效率(左)与排名一致性(右)。
- 观察 1(精度评估代价高):全量数据集推理代价高昂,但均匀采样子集上的精度快速稳定,可作可靠代理加速剖析。
- 观察 2(压缩比相对排名稳定):绝对压缩比随内容波动,但配置间的相对排名严格不变,保证离线最优配置可靠迁移到在线。
约束黑盒优化(选用带高斯过程的贝叶斯优化 BO-GP,因样本高效 + 不确定性建模):
采集函数(Acquisition Function)——平衡开发与探索:
其中 由 GP 后验推得, 为随迭代衰减的探索权重。
Algorithm 1(约束感知贝叶斯优化)核心步骤:
- 异构参数编码(Line 1):类别变量 One-Hot + 数值变量 Min-Max,统一嵌入 ,确保 GP kernel 正确度量结构相似性
- 探索-开发策略(Lines 5-6): 指数衰减,从全局探索过渡到快速开发
- 双向剪枝(Lines 9-13):利用 CR-Acc 单调权衡,可行时剪除低 CR 候选、不可行时剪除高 CR 候选
- 早停机制(Lines 14-16):连续失败 超限或搜索空间耗尽时终止
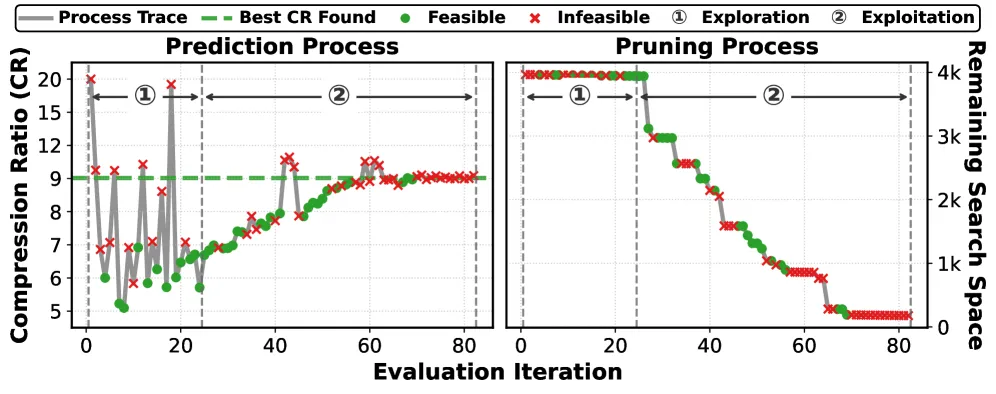
图 9:预测(左)与剪枝(右)过程可视化。
效果:穷举 4000+ 候选需约 1000 小时,本算法在 <80 次迭代(约 20 小时)内收敛,剖析开销降低 50×。
离线产出:3D Pareto 前沿(§5.2.3)
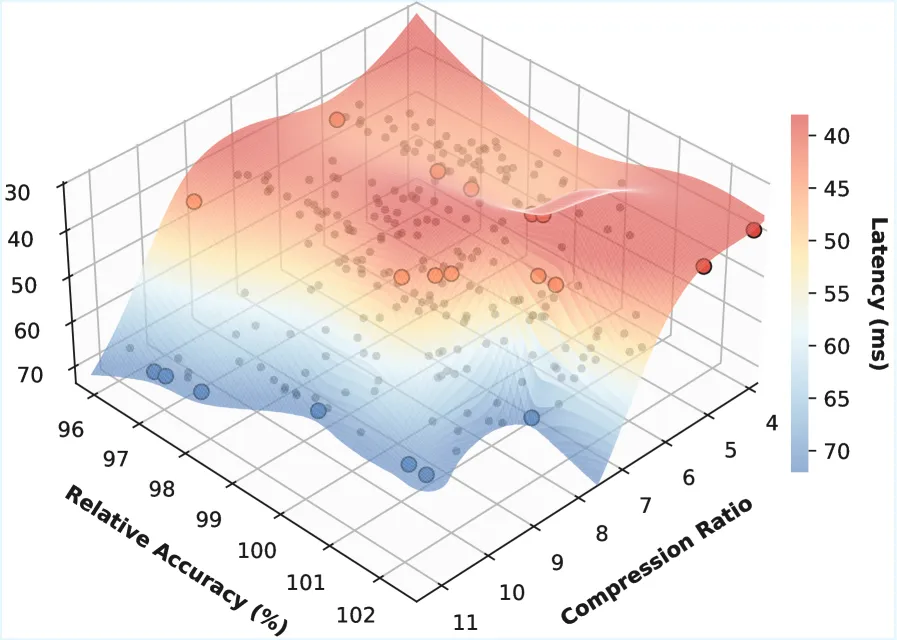
图 10:策略空间的 3D Pareto 前沿(Acc-CR-Latency)。
将可行历史 投影到 Acc-CR-Latency 三维空间,保留非支配点。该 3D Pareto 前沿作为静态运行时查找表,为在线选择提供候选集。(引入 Latency 作第三维至关重要,因计算开销可能抵消通信收益。)
在线:服务感知控制器(§6)
① 解析模型(§6.1)——两条定理
先按精度损失将 profile 分桶,限制在匹配质量预算的桶内选择。
定理 6.1(收益条件:带宽阈值):定义
该条件独立于 KV 体积 ,仅依赖压缩比与吞吐,坍缩为带宽阈值。profile 在 时有益,否则可在线过滤,大幅收缩候选集。
定理 6.2(分段最优策略):令 ,将 改写为 的线性函数:
最小化即取直线族 的下包络(lower envelope)。最优 profile 在 上分段常数:存在断点 ,在每个区间 内最优 profile 为 。
两定理结合:离线构建每个质量桶的下包络得分段策略表;在线给定测量带宽 ,先用定理 6.1 过滤非有益 profile,再用定理 6.2 查表返回最优 profile,实现 O(1) 决策代价。
② 残差修正 Bandit(§6.2)
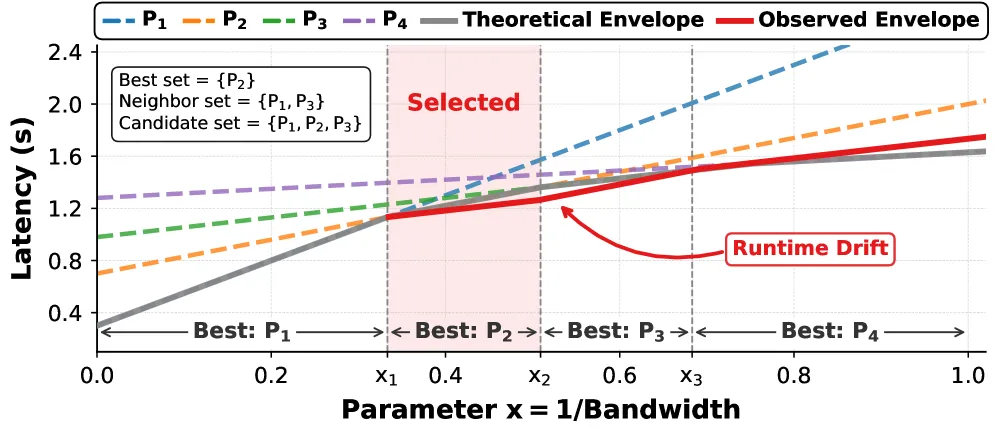
图 11:下包络上的候选集生成与基于 bandit 的残差修正。
离线参数常偏离在线实况(GPU 负载、队列竞争改变实际吞吐)。在解析模型上加极轻量在线学习层做残差修正:
- 以模型最优 profile 为中心构建微型候选集(含 1–2 个下包络邻居),通常 2–3 个 profile
- 残差定义 ,维护 EWMA 残差估计:
- 修正后有效延迟:
- ε-greedy 选择:1−ε 概率选满足约束且最小化 的 profile,ε 概率随机探索
- 安全护栏:用 作保守可行性过滤(空则回退默认保守配置);冷却机制——若某 profile 在最近 M 次使用中违反 SLO 超 K 次,则在冷却窗内暂时移出候选集
- 每请求仅评估 2–3 候选、更新常数状态,开销可忽略
六、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 统一模块化策略空间 | 三阶段可插拔,支持跨方法重组 | 图 7;SOTA 方法笛卡尔积 |
| MixHQ 混合精度头级量化 | Retrieval/Streaming Heads 差异化精度,取代二元剪枝 | Table 1:平均 CR 8.28×,相对精度 100.35% |
| 贝叶斯剖析引擎 | BO-GP + 异构编码 + 双向剪枝 + 早停 | 离线开销降 50×(1000h→20h) |
| 3D Pareto 前沿 | Acc-CR-Latency 三维非支配集作查找表 | 图 10 |
| 带宽阈值收益条件(定理 6.1) | ,独立于 KV 体积 | 在线过滤非有益 profile |
| 分段最优策略(定理 6.2) | 下包络 → O(1) 查表决策 | 图 11 |
| 残差修正 Bandit | EWMA + ε-greedy 修正离线-在线漂移 | 消融图 16 右 |
七、实验结果
实验设置(§7.1)
| 项目 | 配置 |
|---|---|
| 基座系统 | vLLM 0.10.1,支持解耦 PD 执行 |
| 模型 | Qwen2.5-7B/32B-Instruct、Llama-3.1-8B-Instruct |
| 剖析数据集 | GSM8K(数学)、HumanEval(代码)、Multi-News(摘要)、Qasper(QA) |
| 未见数据集 | 2WikiMQA、HotpotQA(验证泛化) |
| Baseline | CacheGen、KIVI、DuoAttention |
| 测试床 | 离线剖析 4× A100(40GB),decode 用 H100;prefill 三档:消费级 10Gbps(RTX 4090/5090)、工作站级 50Gbps(RTX Pro 6000)、数据中心级 100Gbps(H100) |
端到端性能(§7.2)
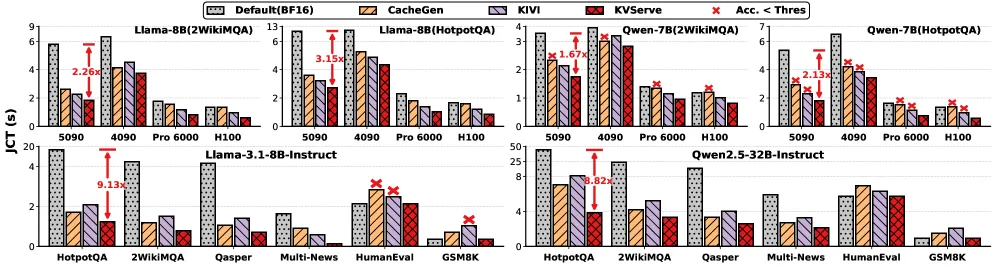
图 12:跨硬件与工作负载的端到端性能。上排:JCT 跨硬件档扩展性;下排:多数据集基准。叉号(×)表示未通过 97% 相对精度阈值的配置。
- 跨硬件:KVServe 始终最低 JCT,带宽受限设备上最高 3.15× 加速;静态基线(CacheGen/KIVI)频繁违反 97% 精度阈值,KVServe 严格保精度
- 跨数据集:长上下文任务最高 9.13× 加速(HotpotQA);短上下文任务(GSM8K/HumanEval)中,基线因(解)压缩开销超过通信节省而负优化(JCT 高于 Default),KVServe 通过理论建模过滤非有益 profile,收敛到未压缩基线而非劣化
- PD 分离(图 13):5–100 Gbps 范围,5 Gbps 时最高 9.2× 加速;带宽升高时动态选低开销策略,避免静态基线的负优化
- Prefix Caching(图 14):5–15 Gbps 范围严格满足 SLO,峰值 32.8× 加速(对比 CacheGen 在 5-6 Gbps 无法找到有效配置而退化到重计算)
精度与压缩比(§7.3,Table 1,Qwen2.5-7B)
| 方法 | 平均 (相对精度 / CR) | 备注 |
|---|---|---|
| Default (BF16) | 100.00% / 1.00× | 基线 |
| CacheGen | 65.76% / 6.17× | 精度大幅崩塌(HumanEval 57.32%),Qwen2.5 含 KV bias 项不适合均匀量化 |
| KIVI | 97.43% / 4.40× | 稳定但压缩天花板约 5.33×(元数据开销) |
| DuoAttention | 95.48% / 3.10× | 剪枝丢 token 损害长上下文检索 |
| KVServe-Unified | 98.20% / 7.42× | 混合数据集搜的鲁棒默认配置,泛化好 |
| KVServe-Aware | 100.35% / 8.28× | 按工作负载独立搜索,Multi-News 峰值 10.12× |
KVServe-Aware 平均相对精度 100.35%(超过 Default 基线),归功于 MixHQ 自适应混合精度选择性保留重要特征、过滤噪声。
延迟拆解(§7.4,图 15)
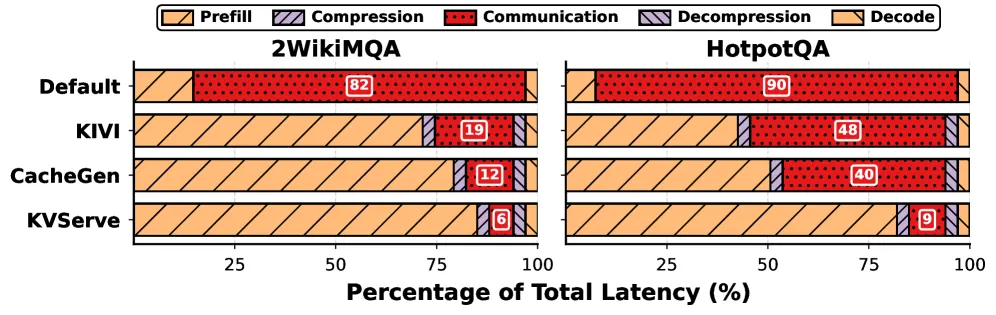
图 15:各推理阶段延迟拆解(Prefill/Compression/Communication/Decompression/Decode)。
- Default 基线严重网络受限,通信占 82–90%
- KVServe 将通信占比压至 6–9%,成功将系统从网络受限转回计算受限
- 在线控制开销可忽略:每次决策 <1 ms
消融实验(§7.4,图 16)
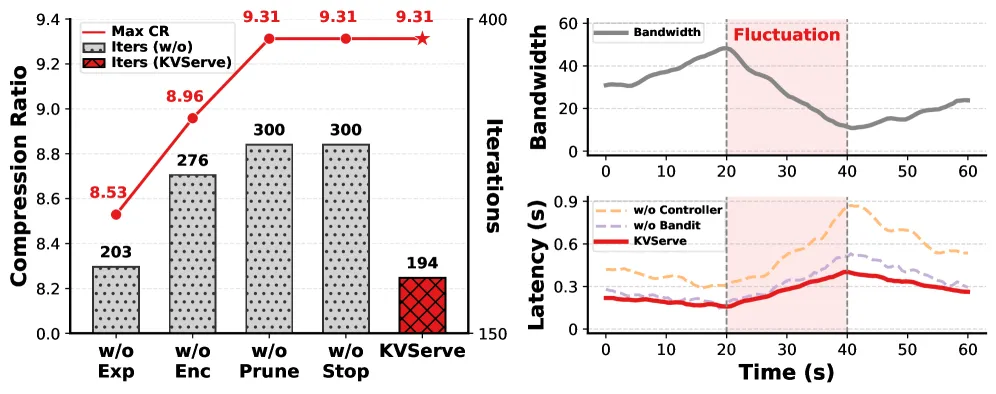
图 16:离线(左)与在线(右)消融研究。
离线剖析效率:完整 KVServe 在 194 次迭代收敛到全局最优 9.31× CR。
- w/o Enc(异构编码):陷局部最优,8.96×
- w/o Exp(探索-开发):8.53×
- w/o Prune(双向剪枝)/ w/o Stop(早停):能找到最优但耗尽 300 次迭代预算
在线选择鲁棒性(带宽波动 0–60s):
- w/o Controller(无下包络模型):带宽骤降(20-40s)时延迟尖峰达近 0.9s(选到非有益策略)
- w/o Bandit:无法修正运行时漂移,延迟持续偏高
- 完整 KVServe:结合解析建模 + bandit 学习,延迟最低(稳定约 0.3s)
八、相关工作与总结
相关工作(§8):KV 压缩方法(CacheGen、KIVI、KVQuant、混合精度量化、Hadamard/Affine 变换预处理)、解耦式服务(PD 分离、KV 状态解耦)。KVServe 的独特之处在于将这些孤立静态方法统一为可搜索、服务感知的自适应框架。
核心贡献
- 统一模块化 pipeline:将代表性 KV 压缩方法解耦为可插拔组件,引入自研 MixHQ 量化组件,通过跨方法组合形成可枚举、可扩展的策略空间。
- 高效贝叶斯剖析引擎:用 BO 大幅减少昂贵的端到端剖析,离线搜索从 1000 小时降到 20 小时级(50× 降低)。
- 服务感知在线控制器:运行时感知服务上下文,结合解析延迟模型(两定理)+ 轻量 bandit 快速选最优 profile 并修正离线-在线失配。
- 系统集成与全面评测:集成 vLLM,跨数据集/模型/GPU/网络验证,PD 分离 JCT 加速 9.13×,KV 解耦 TTFT 降低 32.8×。
技术影响
- 首次将 KV 压缩从「固定算法选择」提升为「受约束的服务状态依赖策略选择」,为解耦式 LLM 服务的通信瓶颈提供系统性解决方案。
- 带宽阈值收益条件(定理 6.1)与分段最优策略(定理 6.2)提供了可解释、O(1) 的在线决策理论基础。
局限性
- 工作负载类别 假设由上层 router/classifier 提供,未研究其实现。
- 依赖离线剖析构建 Pareto 前沿,新模型/新硬件需重新剖析。
- 在线 bandit 探索存在 SLO 违规风险,虽有护栏但仍需谨慎配置。
九、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.13734
- HTML 版本:https://arxiv.org/html/2605.13734v1
- 基座系统:vLLM 0.10.1
- 相关方法:CacheGen、KIVI、KVQuant、DuoAttention、PyramidKV、SnapKV、QuaRot、nvCOMP