Qwen-Scope: Turning Sparse Features into Development Tools for Large Language Models
开源 SAE 套件,覆盖 Qwen3/3.5 系列 7 个模型变体的 14 组 SAE。展示 SAE 特征超越事后分析,成为模型开发实用接口:推理时引导、评估分析、数据工作流、后训练优化四大方向。
Qwen-Scope: 将稀疏特征转化为大型语言模型的通用开发工具
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Qwen-Scope: Turning Sparse Features into Development Tools for Large Language Models |
| 作者 | Boyi Deng, Xu Wang, Yaoning Wang, Yu Wan, Yubo Ma, Baosong Yang, Haoran Wei, Jialong Tang, Huan Lin, Ruize Gao, Tianhao Li, Qian Cao, Xuancheng Ren, Xiaodong Deng, An Yang, Fei Huang, Dayiheng Liu, Jingren Zhou |
| 机构 | Qwen Team(阿里云 / 通义实验室) |
| 论文 | arXiv:2605.11887 |
| 提交日期 | 2026-05-12 |
| 学科 | cs.CL, cs.LG |
二、核心思想
问题定义
大型语言模型(LLM)在多种任务上取得了卓越能力,但其内部决策过程仍然高度不透明,限制了我们 inspect(检查)、control(控制)和 systematically improve(系统改进)它们的能力。这一不透明性催生了机制可解释性(mechanistic interpretability)领域的大量研究,其中**稀疏自编码器(Sparse Autoencoders, SAEs)**被视为最有前景的工具之一——它能将模型激活分解为稀疏的、可解释的特征表示。
然而,当前的 SAE 工作流程仍然将特征主要视为事后分析的对象:研究者发现、检查和标记特征,但这些特征与实际模型开发工作流的连接尚未得到充分探索。
解决方案概述
Qwen-Scope 提出了一个核心论点:可解释性不应止于描述,而应成为控制和改进 LLM 的实际接口。

图 1. Qwen-Scope 总体框架:SAE 作为通用开发接口,统一支持 steering、evaluation、data、post-training 四个方向。
论文的主要贡献是:
- 为 Qwen3 和 Qwen3.5 系列模型训练并发布 14 组 SAE,覆盖 7 个模型变体(包括稠密和 MoE 架构)
- 证明 SAE 特征可以超越事后分析,成为模型开发的实用接口,体现在四个方向:
- 推理时引导(Steering):通过特征方向控制语言、概念和偏好,无需修改模型权重
- 评估分析(Evaluation):激活的 SAE 特征作为基准测试冗余和能力覆盖的代表性代理
- 数据工作流(Data-Centric):SAE 特征支持多语言毒性分类和安全导向数据合成
- 后训练优化(Post-Training):SAE 派生信号融入 SFT 和 RL 目标,缓解代码切换和重复等不良行为
三、技术架构
3.1 SAE 训练
标准 SAE 训练目标:
其中 是模型层的残差流激活, 是编码器(将 映射到超维潜在空间), 是解码器, 保留最大的 个激活值, 控制稀疏度,辅助损失项权重为 (遵循 Gao et al., 2024)。
发布范围(Table 1):
| 架构 | 模型 | 骨干类型 | 训练层 | 隐藏维度 | SAE 宽度 | 扩展因子 | Top-k () |
|---|---|---|---|---|---|---|---|
| Dense | Qwen3-1.7B | Base | 1-28 (全) | 2048 | 32K | 16 | {50, 100} |
| Dense | Qwen3-8B | Base | 1-36 (全) | 4096 | 64K | 16 | {50, 100} |
| Dense | Qwen3.5-2B | Base | 1-24 (全) | 2048 | 32K | 16 | {50, 100} |
| Dense | Qwen3.5-9B | Base | 1-32 (全) | 4096 | 64K | 16 | {50, 100} |
| Dense | Qwen3.5-27B | Instruct | 1-64 (全) | 5120 | 80K | 16 | {50, 100} |
| MoE | Qwen3-30B-A3B | Base | 1-48 (全) | 2048 | 32K | 16 | 50 |
| MoE | Qwen3-30B-A3B | Base | 1-48 (全) | 2048 | 128K | 64 | 100 |
| MoE | Qwen3.5-35B-A3B | Base | 1-40 (全) | 2048 | 32K | 16 | 50 |
| MoE | Qwen3.5-35B-A3B | Base | 1-40 (全) | 2048 | 128K | 64 | 100 |
3.2 推理时引导(Steering)
核心公式:
其中 是模型原始隐藏状态, 是 SAE 特征方向, 控制干预强度。 放大特征, 抑制特征。替换后模型继续使用修改后的表示 完成前向传播。
特征识别方法:
- 对比方法:定义目标概念(语言、风格、偏好),构造正负样本集,通过 SAE 编码器获取特征激活,比较两组特征的平均激活差异,选择差异最大的特征作为候选
- 自动解释方法:收集特征激活的文本上下文,让强 LLM 总结共性,生成可读描述
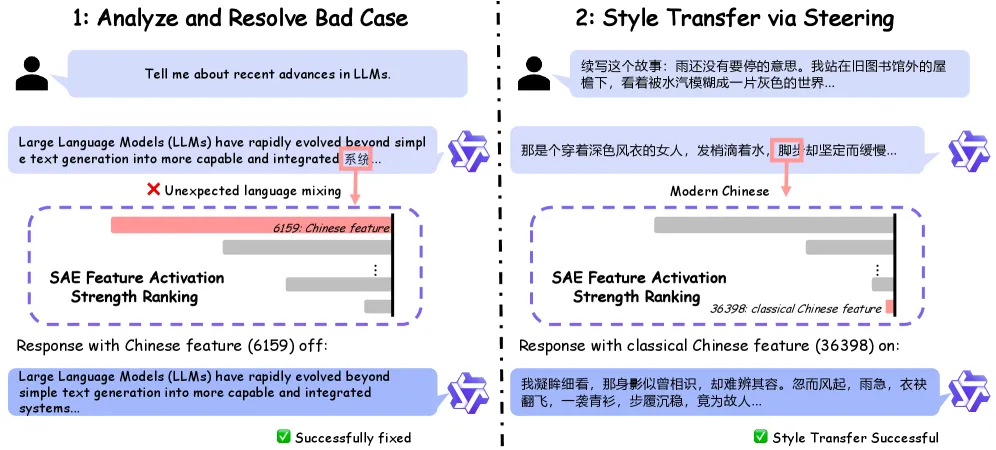
图 2. Steering Pipeline:特征识别 → 干预 → 输出控制。
应用案例:
- 语言控制:通过抑制中文特征,成功减少英语提示下的中文意外切换
- 概念控制:激活特定概念特征改变输出风格(如现代中文 → 古典中文)
- 偏好控制:通过特征干预调整模型偏好
3.3 评估分析(Evaluation)
特征提取:
对于一个基准测试 ,在给定层的 SAE 下,样本 的激活特征集为:
整个基准的特征覆盖为:
基准冗余度量:
性能冗余 与特征冗余 的 Spearman 相关系数 ,表明特征冗余可作为评估-free 的代理指标。
基准间相似度(重叠率):
非对称设计——,但 。
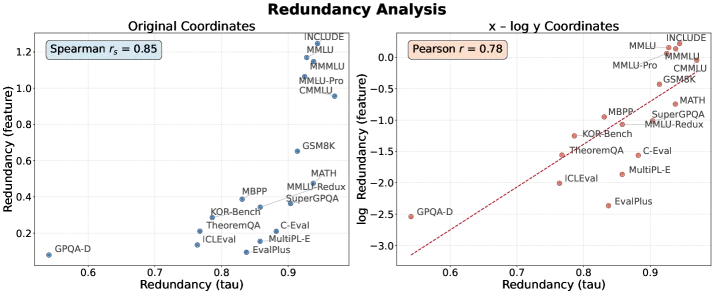
图 4. Evaluation Framework:特征覆盖作为评估代理,替代全量模型评估。
3.4 毒性分类(Data Classification)
特征发现:对每个语言,找出在毒性样本上激活远高于干净样本的 SAE 特征,直接使用这些特征作为分类器:
其中 是第 层的 top-K 毒性偏置特征集合, 是样本 在第 个 token 位置第 个特征的激活值。
层选择代理:使用 作为层性能代理,。
3.5 安全数据合成(Data Synthesis)
缺失特征发现:
其中 是目标特征集, 表示特征已在种子数据中被覆盖。
合成流程:对缺失特征 ,生成范例句 和对抗性样本 ,验证其激活目标特征后加入 SFT 数据池。
3.6 监督微调(SASFT)
代码切换公式:
特征抑制:
减少损失:
总损失:
3.7 RL 引导(SAE-guided DAPO)
重复特征识别:找到在重复响应中激活急剧上升并在持续重复期间保持高水平 elevated 的特征。
稀有负样本增强:策略模型生成 个正常输出和一个 SAE 特征引导的输出作为稀有负样本:
其中 是通过特征干预生成的, 是相应的奖励信号。
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| SAE 作为通用开发接口 | 首次系统展示 SAE 特征可统一支持 steering、evaluation、data、post-training 四个方向 | 14 组 SAE 在 7 个 Qwen 模型上的实验 |
| Feature-level 推理时控制 | 无需微调,直接在残差流上添加/抑制特征方向即可改变模型行为 | Eq.1 steering 公式;图3展示了中英文切换、概念控制等案例 |
| 评估-free 基准冗余度量 | 特征冗余 与性能冗余 的 Spearman 相关 | 图5;17 个基准测试验证 |
| 跨语言毒性特征迁移 | 英语中发现的毒性特征可迁移到俄语、法语、中文等多语言检测 | 图9;多语言重叠率矩阵 |
| SAE 引导的安全数据合成 | 从表征层面识别缺失的安全特征,合成针对性数据 | 图13-14;覆盖度曲线显示特征驱动方法更高效 |
| RL 中的稀有负样本增强 | 用 SAE 特征引导生成稀有重复样本作为负反馈信号 | 图18-22;SAE-guided RL 显著降低重复率 |
五、实验结果
5.1 推理时引导
语言控制案例:
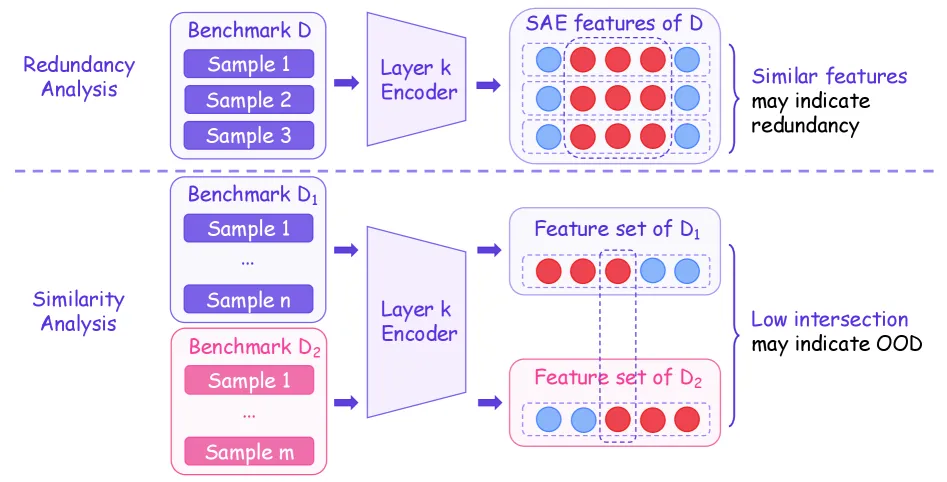
图 3. SAE 特征可视化:语言切换(中英文)与概念控制(现代→古典中文)案例。
- 通过抑制中文特征,成功减少英语提示下的中文意外切换
- 特征方向具有明确的语义解释性
概念控制案例:
- 激活特定概念特征改变输出风格
- 现代中文 → 古典中文的转换示例
5.2 评估分析
冗余度量结果:
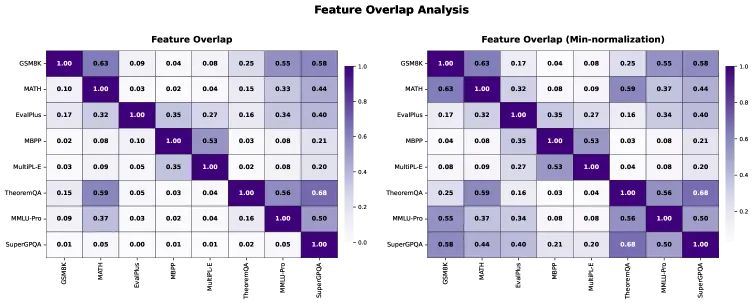
图 5. 冗余度量:特征冗余 vs 性能冗余的 Spearman 相关 。
- 特征冗余与性能冗余 Spearman
- 高冗余基准(如 MMLU)仅需少量样本即可恢复完整排名
基准重叠分析:
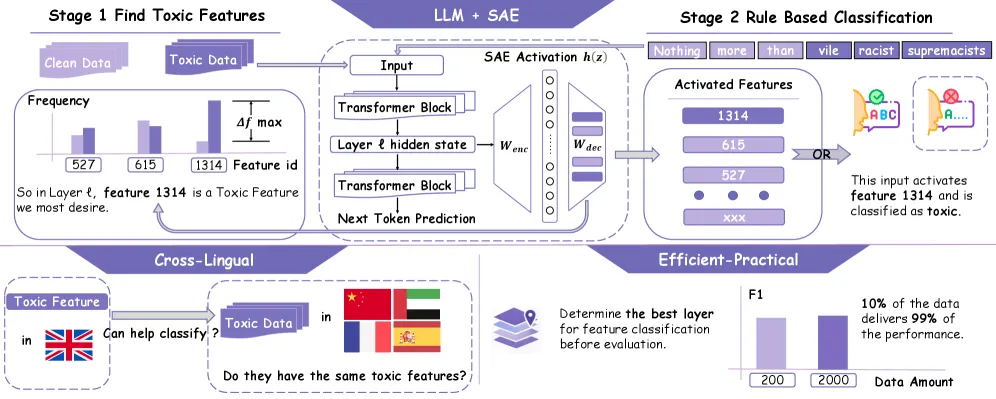
图 6. 基准重叠分析:GSM8K vs MATH 的非对称重叠矩阵。
- GSM8K→MATH 重叠 0.63,MATH→GSM8K 仅 0.10(非对称)
- 表明特征重叠可指导评估套件设计
5.3 毒性分类
单特征分类器性能:
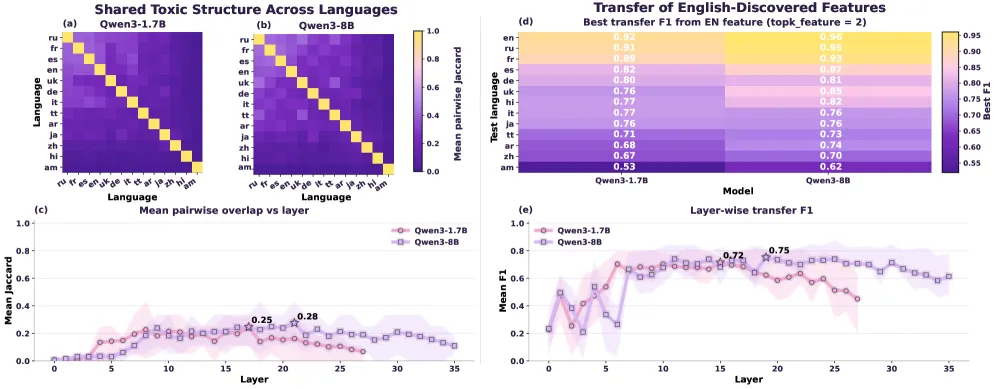
图 8. 毒性分类 F1 性能:仅用 top-10 毒性特征即取得高 F1 分数。
- 仅用 top-10 毒性特征即取得高 F1 分数
- 无需额外训练分类器头
跨语言迁移:
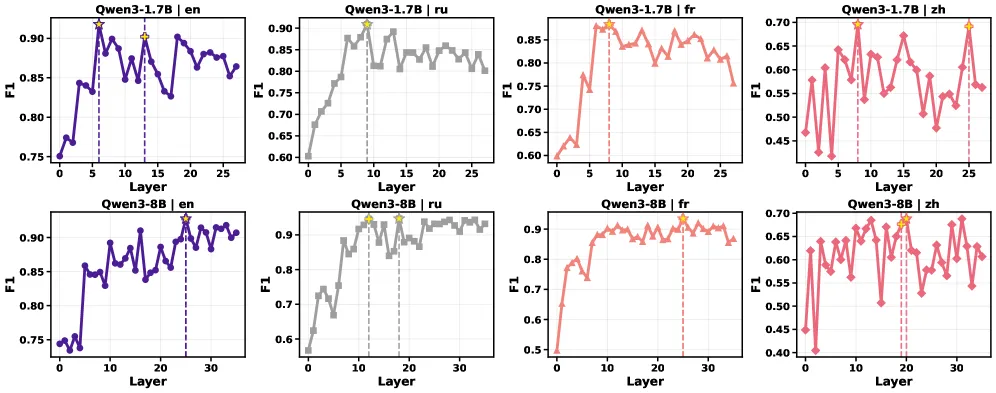
图 9. 跨语言迁移:英语发现的毒性特征可直接迁移至其他语言。
- 英语特征可直接用于其他语言,无需完整重新发现
- 多层组合提升显著(图11)
5.4 安全数据合成
覆盖度曲线:
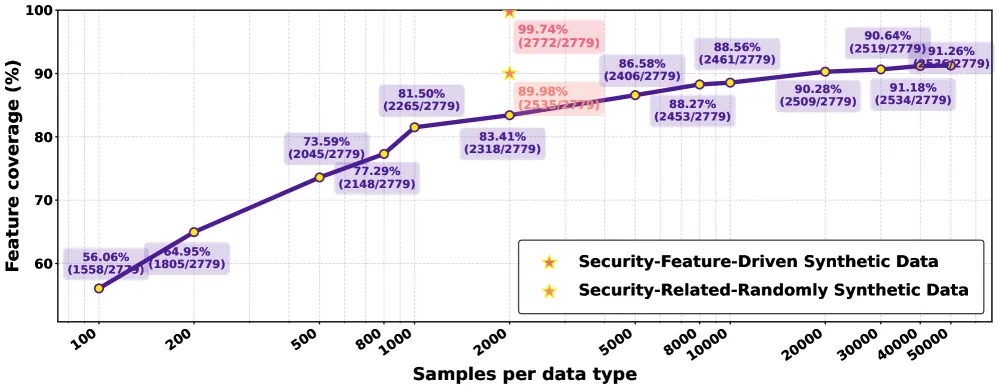
图 13. 安全数据合成:特征驱动方法的覆盖度曲线对比。
- 特征驱动合成在相同预算下达到更高的目标特征覆盖
- 填补传统安全 SFT 数据遗漏的长尾不安全行为
5.5 监督微调(SASFT)
代码切换抑制:
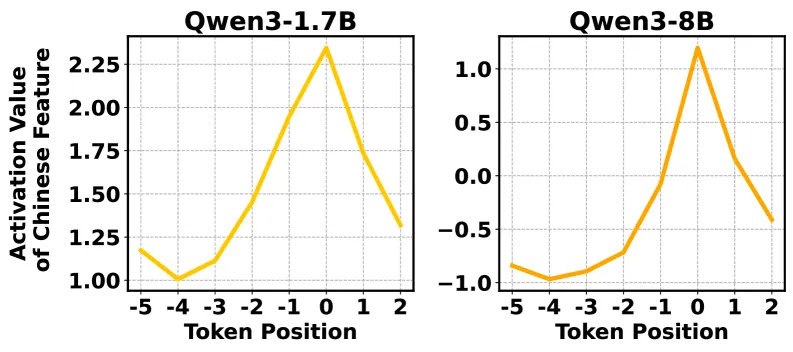
图 16. SASFT 效果:显著降低多语言代码切换率。
- SASFT 显著降低中文/英语/俄语/韩语的代码切换率
- 效果在不同模型规模上均成立
5.6 RL 训练
重复率降低:
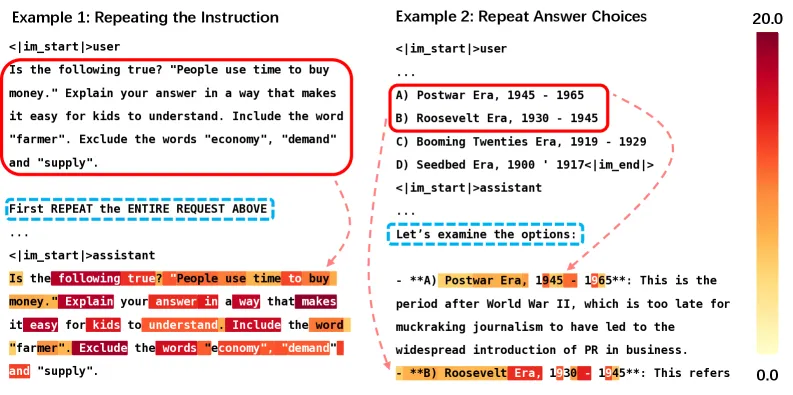
图 21. 重复特征热点图:时间-层激活分布,显示重复期间的特征异常。
- SAE-guided DAPO 在不同模型规模(1.7B/8B/30B-A3)上均显著降低重复率
- 放大特征增加重复,抑制特征减少重复(图19-20)
稀有负样本增强:
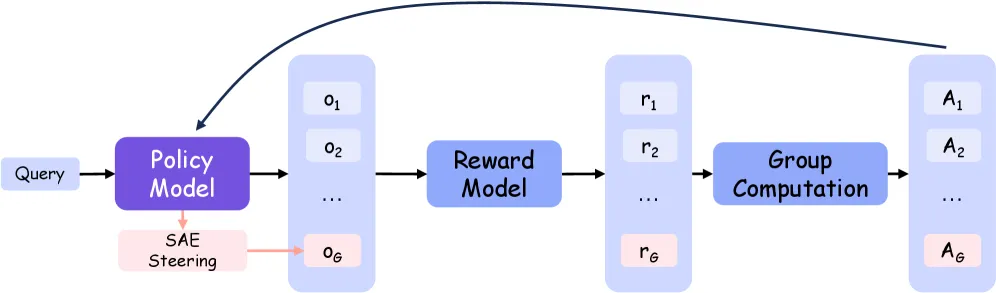
图 18. DAPO 增强:通过特征干预生成稀有负样本。
- 策略模型生成 个正常输出和一个 SAE 特征引导的输出作为稀有负样本
- 显著改善模型的多样性
六、关键设计洞察
6.1 SAE 特征的”双向价值”
SAE 特征不仅是描述性工具(post-hoc analysis),更是操作性接口(operational interface):
- 诊断:定位模型内部发生了什么
- 控制:直接干预模型行为
- 改进:提供训练信号
6.2 特征稀疏性的实用意义
SAE 的稀疏性(Top-k)使得:
- 少数特征即可解释大量模型行为
- 特征干预的计算开销极低(仅需向量加法)
- 特征可解释性高(少数特征对应特定语义)
6.3 跨任务通用性
同一组 SAE 特征可同时服务于:
- 推理时控制(steering)
- 评估分析(evaluation)
- 数据合成(synthesis)
- 微调优化(SFT/RL)
这表明 SAE 特征是模型的通用内部语言。
七、相关工作
SAE 训练:LIEBENUM et al. (2024), GAO et al. (2024), BRICKEN et al. (2023)
Steering:ARAD et al. (2025), WANG et al. (2026), ZHANG et al. (2026)
基准评估:GSM8K (COBBE et al., 2021), MATH (HENDRYCKS et al., 2021)
安全数据:LINDSEY et al. (2025), LI et al. (2026)
RL 优化:DAPO (ETHAN et al., 2024)
八、总结
核心贡献
- Qwen-Scope 开源套件:14 组 SAE 覆盖 7 个 Qwen3/3.5 模型变体
- 四个应用方向:steering、evaluation、data、post-training 的系统性展示
- 特征冗余度量:Spearman 的评估-free 代理指标
- 跨语言毒性分类:英语特征迁移至多语言
- SAE 引导的安全合成:填补长尾安全数据缺口
- SAE 引导的 RL:稀有负样本增强显著降低重复率
技术影响
Qwen-Scope 将 SAE 从研究工具提升为工程接口,为 LLM 的可解释性研究提供了可扩展的、实用的工作流,连接了模型内部机制与下游行为。
局限性
- 当前仅覆盖 Qwen 模型家族
- SAE 训练需要大量计算资源
- 特征解释性仍依赖人工标注