Transforming the Use of Earth Observation Data: Exascale Training of a Generative
利用历史先验的生成式压缩模型实现高达10000倍地球观测数据压缩
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Transforming the Use of Earth Observation Data: Exascale Training of a Generative Compression Model with Historical Priors for up to 10,000x Data Reduction |
| 作者 | Jinxiao Zhang, Runmin Dong, Xiyong Wu, Xihan Huang, Shenggan Cheng, Yunkai Yang, Zheng Zhou, Yunpu Xu, Zhaoyang Luo, Miao Yang, Fan Wei, Mengxuan Chen, Yang You, Juepeng Zheng, Weijia Li, Yutong Lu, Haohuan Fu |
| 机构 | 清华大学等 |
| 论文 | https://arxiv.org/abs/2605.08633 |
| 发布 | 2026-05-09 |
| 页数 | ACM Gordon Bell Prize提名论文 |
| 类别 | cs.DC (分布式计算), cs.CV (计算机视觉) |
核心亮点
- 100x到100,000x数据压缩:基于历史先验的生成式压缩框架
- Exascale训练:在LineShine Armv9 CPU超算上达到1.54 EFLOP/s持续性能,峰值2.16 EFLOP/s
- D2AR框架:Dual-Decoupled Asymmetric Compression and Reconstruction
- 10.3x单节点加速:通过SME内核、HBM感知内存管理和异步运行时实现
二、核心思想
问题定义
地球观测(Earth Observation)是科学中最大的数据产生活动之一,但当前的数据管道仍将压缩视为存储和传输工具,而非数据使用的新方式。传统压缩方法面临以下挑战:
- 数据规模巨大:全球历史观测档案的规模与实用性之间存在极端不平衡
- 传感器异质性:多源卫星平台导致非标准化执行流和大量I/O开销
- 重建困难:极端压缩比下的信息恢复面临理论和实践限制
解决方案概述
本文提出历史先验生成式压缩框架,通过在历史地球观测档案上训练大型生成模型,使长期地理和时空先验可直接用于任务自适应数据压缩。
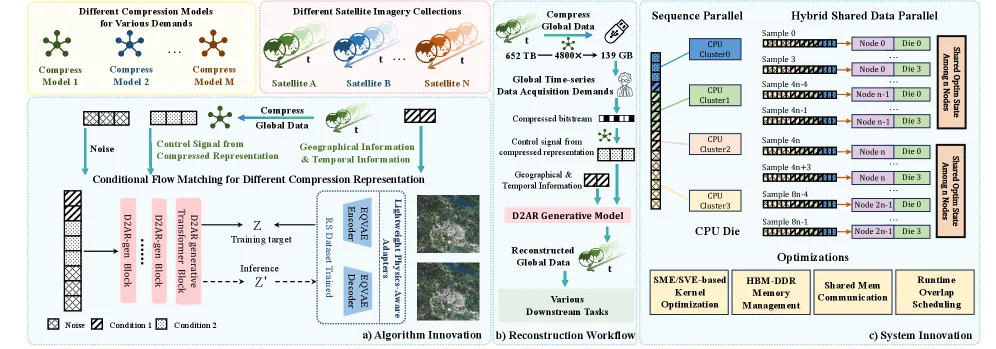
Figure 2: 历史先验生成式压缩框架概述。(a) 将全球历史档案压缩为具有地理和时间条件的生成先验的算法设计。(b) 从压缩表示按需恢复以供下游使用的重建工作流。(c) 在LineShine Armv9 CPU超算上进行exascle训练的系统设计。
核心创新视角:
- 框架层面:重新组织数据的压缩、传输和重建方式
- 模型层面:将海量历史档案转化为可控重建能力
- 系统层面:在Armv9 CPU平台上实现实用的大规模训练
三、技术架构
3.1 D2AR框架:Dual-Decoupled Asymmetric Compression and Reconstruction
D2AR引入系统性的任务解耦,将工作流分为两个高度专业化的执行阶段:
| 阶段 | 组件 | 功能 |
|---|---|---|
| 在轨阶段 | D2AR-comp | 轻量级前端,灵活利用任意现有压缩模型将多源遥感输入转换为高度压缩的中间比特流 |
| 地面阶段 | D2AR-rec | 轻量级预训练特征映射器和生成重建模型,从压缩表示恢复信息 |
关键设计:
- 前端D2AR-comp可使用任意现有压缩模型(HL-CompNet、LIC-TCM、MLIC++等)
- D2AR-rec不是重建像素,而是重建物理一致的语义表示
- 科学家选择合适的压缩级别,调用相应的D2AR-rec模型进行重建和分析
3.2 模型架构
| 模型 | 参数量 | 层数 | Hidden-Size | Heads |
|---|---|---|---|---|
| D2AR-rec-3B | 3B | 17 | 3840 | 30 |
| D2AR-rec-6B | 6B | 36 | 3840 | 30 |
| D2AR-rec-8B | 8B | 46 | 4096 | 32 |
模型级创新:
-
物理感知适配器:使用预训练的EQ-VAE编码器和解码器作为轻量级物理感知适配器,将特定传感器(如SAR、多光谱平台)的独特成像物理和光谱特性封装在适配器中
-
全球地理先验注入:
- 将全球时空先验编码为连续地理嵌入
- 动态注入到潜在Flow Matching过程中作为全局控制
- 建立当前压缩观测与历史先验之间的深层语义关联
3.3 核心公式
Flow Matching过程:
D2AR-rec使用条件Flow Matching进行生成重建,其中地理先验 作为条件:
其中 是压缩表示的编码, 是目标重建, 是时间步。
地理先验编码:
其中 是纬度, 是经度, 是时间戳。
3.4 系统级创新
SME-GEMM优化
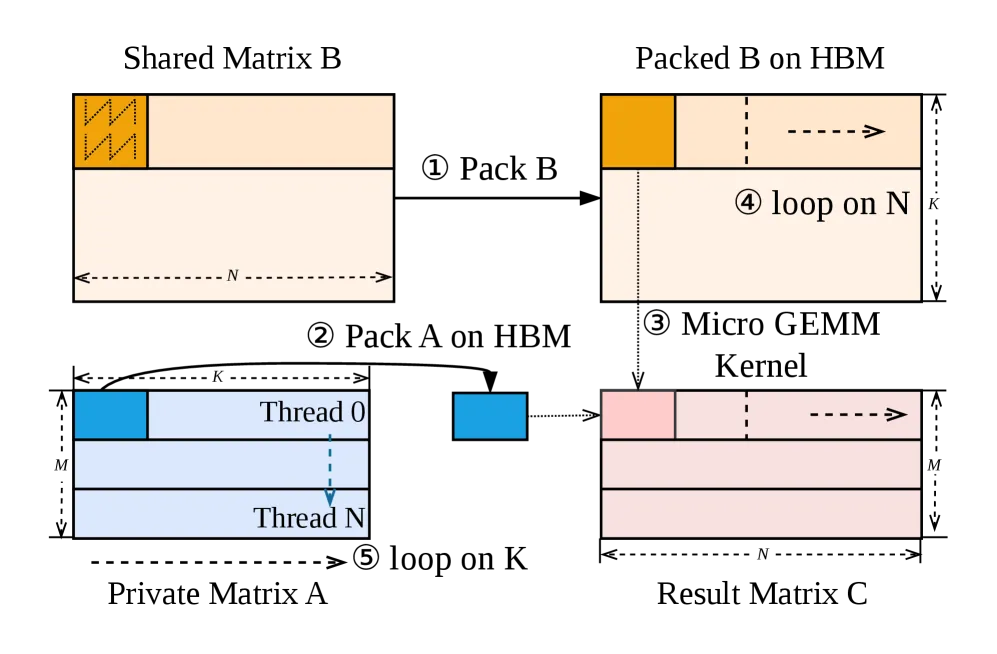
Figure 3: GEMM工作流。线程协作地将共享矩阵B打包到HBM中。计算组织为K维度的tiled循环:每个线程将其局部tile of A打包到HBM,遍历共享维度,并执行micro-kernel计算以累积结果到矩阵C。
双Micro-kernel设计:
- 64×K by K×16:M-major reuse
- 16×K by K×64:N-major reuse
运行时根据M和N的相对大小选择内核,最大化数据复用。
关键参数:
magic_k:基于L2缓存容量推导,而非经验调优- K-aware累积策略:当K < magic_k时直接写回,否则在HBM中累积FP32部分和
HBM感知内存管理
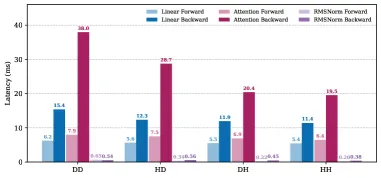
Figure 4: 不同内存配置下核心算子的前向和反向延迟(ms)。H表示HBM,D表示DDR。两字母列头分别表示输入和输出张量的内存放置。
策略:
- 前向传播:仅将注意力算子的输出激活放置在HBM,其他中间结果放置在DDR
- 反向传播:所有反向分配放置在HBM(梯度和中间结果短生命周期)
- 参数梯度:SP通信期间卸载到DDR,释放HBM空间
异步执行运行时
- 引入专用launch线程,重叠框架开销(算子调度、内存分配、张量视图操作)与内核执行
- 效果:PyTorch默认运行时开销24.2% → 异步运行时1.9%
并行化策略
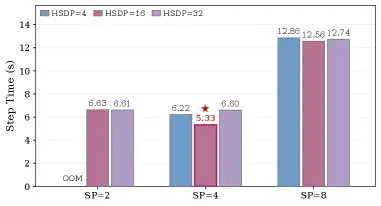
Figure 5: 128节点上D2AR-rec-6B不同并行配置的性能比较,包括Hybrid Shared Data Parallelism (HSDP)和Sequence Parallelism (SP)。
层次化并行方案:
- 每个MPI进程绑定到一个CPU集群(38核,37核可用,32GB DDR,4GB HBM)
- Die内4个进程在不同NUMA域中可通过SHM通信
- Die间通过CCL通信
- 序列并行(SP)和混合数据并行(HSDP)与硬件拓扑共同设计
四、实验结果
4.1 单节点性能
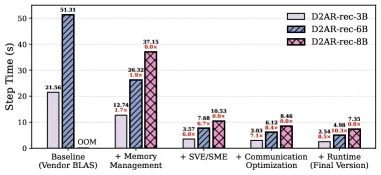
Figure 6: 不同优化阶段下三种模型尺寸的单节点运行时。
D2AR-rec-6B优化效果:
| 阶段 | 运行时 | 加速比 |
|---|---|---|
| Vendor-BLAS baseline | 51.31s | 1.0x |
| HBM-aware内存管理 | 26.32s | 1.95x |
| SVE/SME内核优化 | 7.68s | 6.68x |
| 通信优化 | 6.12s | 8.38x |
| 异步运行时 | 4.98s | 10.3x |
D2AR-rec-3B:从21.56s降至2.54s(8.49x加速)
D2AR-rec-8B:baseline配置下OOM,优化后可在单节点运行
4.2 弱扩展性能
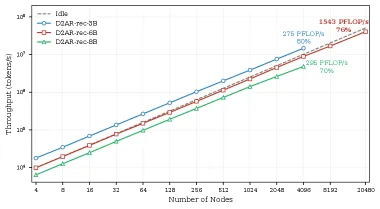
Figure 7: 三种模型尺寸的弱扩展性能。在所有情况下,全局工作负载与节点数成比例增加,同时保持每节点工作负载固定。
| 模型 | 节点范围 | 持续性能 | 峰值性能 | 弱扩展效率 |
|---|---|---|---|---|
| D2AR-rec-6B | 1 → 20,480 | 1.54 EFLOP/s | 2.16 EFLOP/s | 76.0% |
| D2AR-rec-3B | 1 → 4,096 | 275 PFLOP/s | - | - |
| D2AR-rec-8B | 1 → 4,096 | 295 PFLOP/s | - | - |
关键发现:
- 6B模型在全机器规模(20,480节点=40,960 CPU)上保持高效
- 弱扩展设计使更大机器规模转化为更广泛的档案覆盖,而非简单加速固定任务
- MFU(Model FLOPs Utilization)达到15.7%
4.3 重建性能
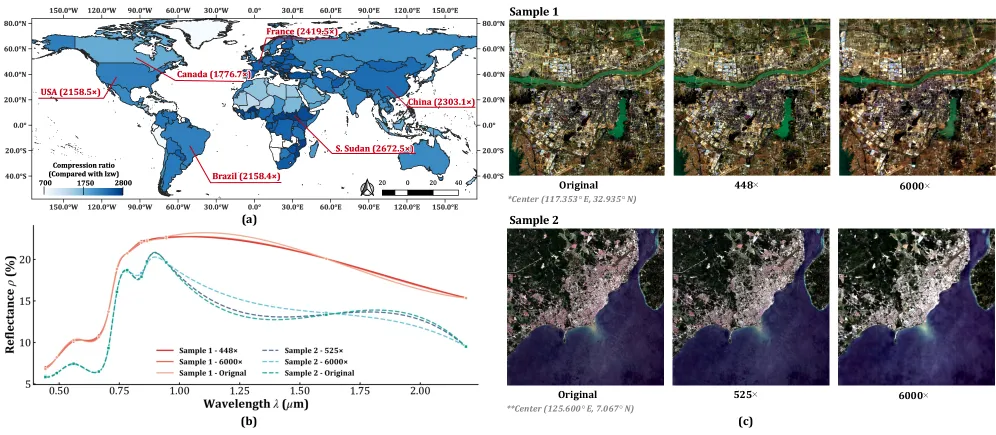
Figure 8: 不同压缩比下的视觉比较及对应光谱曲线。
不同压缩比下的重建性能 (Table 3):
| 方法 | 压缩比 | PSNR↑ | LPIPS↓ | MS-SSIM↑ | NDVI↓ |
|---|---|---|---|---|---|
| Case 1 (HL-CompNet) | 6104x | 13.23 | 0.650 | 0.592 | 0.098 |
| +D2AR-rec | 6104x | 14.95 | 0.107 | 0.924 | 0.092 |
| Case 2 (LIC-TCM) | 6295x | 15.38 | 0.450 | 0.909 | 0.078 |
| +D2AR-rec | 6295x | 16.60 | 0.122 | 0.954 | 0.082 |
| Case 3 (MLIC++) | 17777x | 13.10 | 0.619 | 0.842 | 0.098 |
| +D2AR-rec | 17777x | 14.13 | 0.119 | 0.902 | 0.089 |
关键发现:
- D2AR-rec在所有压缩比下显著提升重建质量
- LPIPS(感知质量)提升最为显著(从0.65降至0.11)
- 在极端17777x压缩比下仍保持可用的重建质量
4.4 全球先验覆盖消融实验 (Table 4)
| 数据规模 | PSNR↑ | LPIPS↓ | MS-SSIM↑ | NDVI↓ |
|---|---|---|---|---|
| 900城市 | 12.15 | 0.327 | 0.847 | 0.093 |
| 1000城市 | 12.47 | 0.299 | 0.859 | 0.091 |
发现:更广泛的地理覆盖(1000城市 vs 900城市)一致提升重建质量,验证了全球数据对有效先验学习的必要性。
4.5 下游任务验证 (Table 5)
土地覆盖场景分类任务(DynamicEarthNet Sentinel-2数据集):
| 方法 | 指标 | Case 1原始 | Case 1+D2AR | Case 2原始 | Case 2+D2AR | Case 3原始 | Case 3+D2AR |
|---|---|---|---|---|---|---|---|
| Exact Acc | 0.500 | 0.479 | 0.469 | 0.500 | 0.500 | 0.479 | |
| Macro F1 | 0.754 | 0.754 | 0.754 | 0.754 | 0.754 | 0.755 | |
| mAP | 0.854 | 0.847 | 0.876 | 0.837 | 0.854 | 0.831 |
关键发现:
- 即使在极端压缩比下,下游分类性能仅有有限下降
- Macro F1保持不变或略有提升
- 验证了重建管道保留了下游任务所需的语义和结构信息
五、与现有工作对比 (Table 1)
| 应用领域 | 模型尺寸 | 硬件 | 规模 | MFU | 持续PFLOP/s |
|---|---|---|---|---|---|
| 语言 (Narayanan et al.) | 1000B | A100 | 3,072 GPU | 52% | 502 |
| 语言 (MegaScale) | 175B | A100 | 12,288 GPU | 55% | 2166.3 |
| 气候 (ORBIT-2) | 10B | MI250X | 65,536 GPU | ~16% | 4100 |
| 遥感 (SkySense V2) | 0.67B | H20 | 128 GPU | - | - |
| 遥感 (Prithvi-EO-2.0) | 0.6B | A100 | 240 GPU | - | - |
| 本文 (D2AR) | 6.3B | Armv9 LX2 CPU | 40,960 CPU | 15.7% | 1543 |
独特之处:
- 唯一在CPU超算上训练的大型生成模型
- 唯一针对地球观测数据的exascle训练
- 实现了与GPU训练可比的MFU(15.7%)
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| D2AR框架 | 解耦在轨压缩和地面重建 | 灵活支持多种压缩基线 |
| 历史先验学习 | 从全球历史档案学习生成先验 | 100x-10000x压缩比下高质量重建 |
| 地理先验注入 | 将时空先验编码为连续嵌入并注入Flow Matching | 保持物理一致性和语义布局 |
| SME-GEMM优化 | 双micro-kernel设计,自适应选择 | 最大化数据复用和缓存局部性 |
| HBM感知内存管理 | 基于算子敏感性和张量生命周期的全局放置 | 前向注意力放HBM,反向全放HBM |
| 异步运行时 | 专用launch线程重叠框架开销 | 运行时开销从24.2%降至1.9% |
| 层次化并行 | 与Armv9 CPU拓扑共同设计的SP+HSDP | 1.54 EFLOP/s持续性能 |
七、总结
核心贡献
- 历史先验生成式压缩范式:首次将地球观测数据压缩从被动存储工具转变为主动知识提取
- D2AR框架:解耦压缩和重建,支持任务自适应数据减少
- Exascle CPU训练:在Armv9 CPU超算上实现1.54 EFLOP/s,展示CPU训练大型生成模型的可行性
- 系统级协同优化:从内核到内存到并行的全面优化,实现10.3x单节点加速
- 实际应用验证:在下游分类任务中验证极端压缩的实用性
技术影响
- 地球观测:将压缩从成本中心转变为数据使用的新范式
- HPC:展示Armv9 CPU训练大型模型的可行性,拓宽硬件选择
- 生成模型:历史先验学习方法可推广到其他具有时间序列特性的视觉数据
- 数据服务:超算中心可将压缩观测信息作为新的数据服务层
实际应用
- 全球Sentinel-2数据压缩:1000城市、8年数据的千倍压缩
- 按需重建:科学家选择压缩级别,调用D2AR-rec进行重建
- 下游任务:土地覆盖分类、变化检测等
局限性
- 训练成本:需要exascle计算资源
- 传感器覆盖:目前主要验证于Sentinel-2多光谱数据
- 压缩比-质量权衡:极端压缩(>10000x)下微观纹理不可避免地平滑
- 实时性:D2AR-rec重建需要一定计算时间
八、参考资源
- 论文: https://arxiv.org/abs/2605.08633
- LineShine超算: Armv9 CPU supercomputer
- 压缩基线: HL-CompNet, LIC-TCM, MLIC++