Unleashing Scalable Context Parallelism for Foundation Models Pre-Training via FCP
块级粒度的灵活上下文并行范式,通过任意点对点通信 + bin-packing 调度,在 256 张 NVIDIA GPU 上实现近线性扩展,attention MFU 提升 1.13x–2.21x
Unleashing Scalable Context Parallelism for Foundation Models Pre-Training via FCP
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Unleashing Scalable Context Parallelism for Foundation Models Pre-Training via FCP |
| 作者 | Yilong Zhao, Xiaonan Nie, Kan Zhu, Shuang Ma, Zhichao Lai, Hongxiang Hao, Yang Zhou, Baris Kasikci, Ion Stoica |
| 机构 | UC Berkeley、华盛顿大学(University of Washington)、工业界合作方(GPU 型号与集群规模因保密而匿名) |
| 论文 | arXiv:2605.08524 |
| 发布 | 2026 年 5 月 8 日 |
| 分类 | cs.DC (Distributed, Parallel, and Cluster Computing) |
说明:本文 FCP 与另一篇 arXiv:2602.21788(Yifan Niu 等,Ascend 910C NPU)同名但属不同工作。本文由 UC Berkeley / UW 团队完成,在 256 张 NVIDIA GPU 上评测,核心贡献是块级(block-level)任意点对点调度 + 无拥塞通信规划器。
二、核心思想
问题定义
在基础模型预训练中,上下文并行(Context Parallelism, CP) 被广泛用于支持不断增长的上下文长度(4K → 1M+ token)。ring attention 等方法将单条序列切分到多张 GPU 上并行计算 attention。
然而,真实语料的序列长度呈严重长尾分布(近似对数正态,最长可达 512K token),加上多模态输入(一分钟视频 = 百万 token),使得现有 CP 设计面临两大挑战:
- 计算低效(Compute Inefficiency):短序列被过度切分成很小的块(block),无法喂饱 TensorCore;而这些小块仍需跨 GPU 传输,造成冗余通信。
- 负载不均衡(Workload Imbalance):attention 计算量随上下文长度二次方增长。即使每张 GPU 分到相同 token 数,长短序列分布不均也会导致部分 GPU 过载、其余空闲。
最优 CP 调度需要在巨大搜索空间中同时决定:每条序列切多少块、每块如何映射到 worker。该问题是 NP-complete,现有方法通过简化假设牺牲了「计算效率」或「负载均衡」之一,导致次优。
解决方案概述
FCP(Flexible Context Parallelism)提出一种块级粒度的灵活上下文并行范式:
- 固定大小分块(block-wise sharding):无论序列多长,都切成固定大小的块(如 1K/4K token),作为调度与计算的基本单元。块足够大以喂饱硬件,同时避免短序列的冗余通信。
- 任意点对点分配(arbitrary P2P assignment):抛弃刚性的 ring 拓扑,允许任意两张 GPU 间通信,使序列块可放置于任意 worker。
- bin-packing 负载均衡:将长短序列的块混合装箱,用 LPT(Longest Processing Time)调度算法迭代地把块分给最空闲的 worker,逼近最优负载均衡。
- 无拥塞通信规划:将块间通信建模为二部图,通过极大匹配(maximal matching)导出无拥塞的通信顺序。
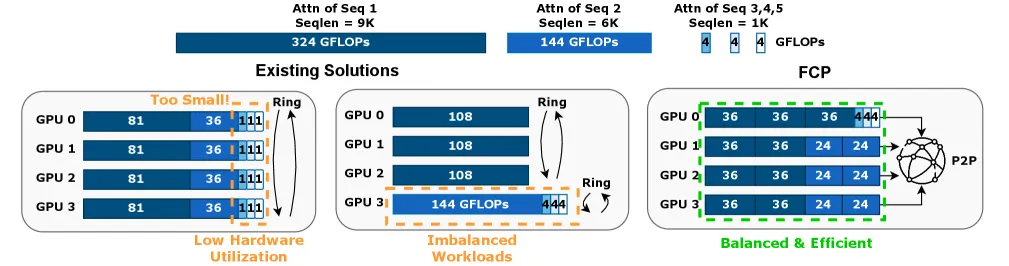
图 1:FCP 与现有设计对比。左:计算低效(所有序列被均匀切分);中:负载不均衡(按长度分组,组内用 ring attention);右:FCP 采用块级调度 + 任意点对点通信。
三、技术架构
整体框架图
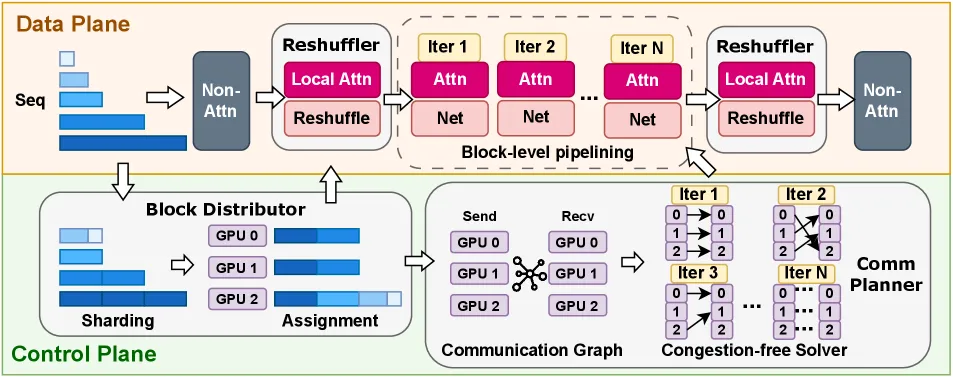
图 6:FCP 系统概览。
FCP 由三大组件构成:
输入序列 batch
      │
      ▼
┌─────────────────────┐
│  Block Distributor   │  ← §4.1  切块 + 分配(兼顾计算效率与负载均衡)
│  (块分发器)          │      LPT 贪心:块分给最空闲 worker
└──────────┬──────────┘
           │ 块分配方案
           ▼
┌─────────────────────┐
│ Communication Planner│  ← §4.2  基于数据依赖构建二部图
│  (通信规划器)        │      无拥塞求解器 → 极大匹配 → 最优通信顺序
│                      │      块级流水线 + bottom-up coalescer
└──────────┬──────────┘
           │ 通信计划
           ▼
┌─────────────────────┐
│ Transparent Reshuffler│ ← §4.3  透明重排:用户布局 ↔ 负载感知布局
│  (透明重排器)        │      与本地计算重叠,开销可忽略
└─────────────────────┘
核心公式与建模
Attention 计算(§2.2):
其中 形状为 (=头数,=序列长度,=头维度)。
- 计算复杂度:(随 二次方增长)
- 空间复杂度:(随 线性增长)
正是「计算二次、内存线性」的差异,导致在长度多样的 batch 下难以同时平衡计算与内存。
最优 CP 调度问题定义(§3.3):
给定 条序列 和 个 worker ,每种调度由:
- 切分函数 (决定每条序列切多少块、每块多大)
- 分配函数 (每块映射到哪个 worker)
worker 的计算负载:
其中 同时考虑 FLOPs 与计算效率(§3.1), 为指示函数。
引入网络重叠因子 (完美重叠时 ),端到端时间:
最优调度:
该问题为 NP-complete,指数级复杂度,实际不可解 → 现有方法均通过简化假设近似。
无拥塞通信的两条引理(§4.2):
Lemma 1:单阶段无拥塞通信 ⟺ 二部通信图上的一个匹配(matching)。
Lemma 2:最大度为 的二部图,至少划分为 个不相交匹配。
结合两引理:最优无拥塞子阶段数 = 二部图最大度 。用 Hopcroft–Karp 算法求解,复杂度 ( 为 CP 组大小,通常数百)。
关键分析发现
1. 计算效率(§3.1)—— 块不能太小
现代 Hopper GPU:989 TFLOPs BF16 TensorCore + 4.8 TB/s 带宽 → 每个加载元素须复用 412 次()才能喂饱算力。
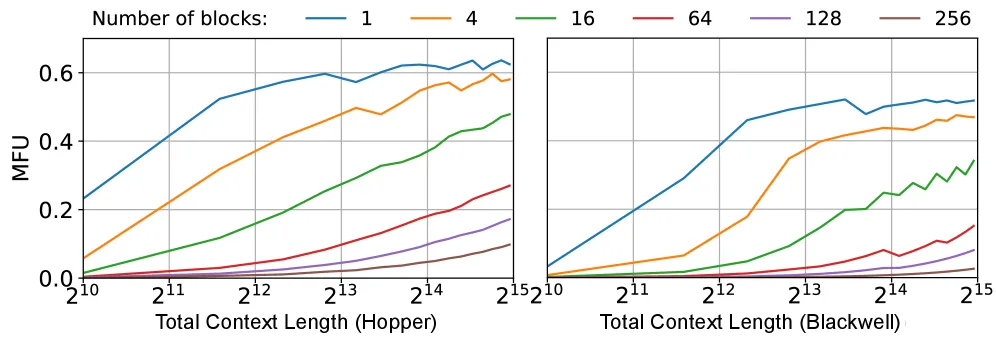
图 3:不同硬件上的 attention MFU(8 KV 头、64 QO 头、head_dim=128)。块大小 <2K 时 MFU 极低,>4K 才饱和。例如 32K 上下文切成 64 块(每块 512 token)仅 25% 利用率。
同时,短序列(<4K)本可放进单 worker 无需通信,但 ring attention 强制切分导致约 50% 的通信量是冗余的(图 2)。
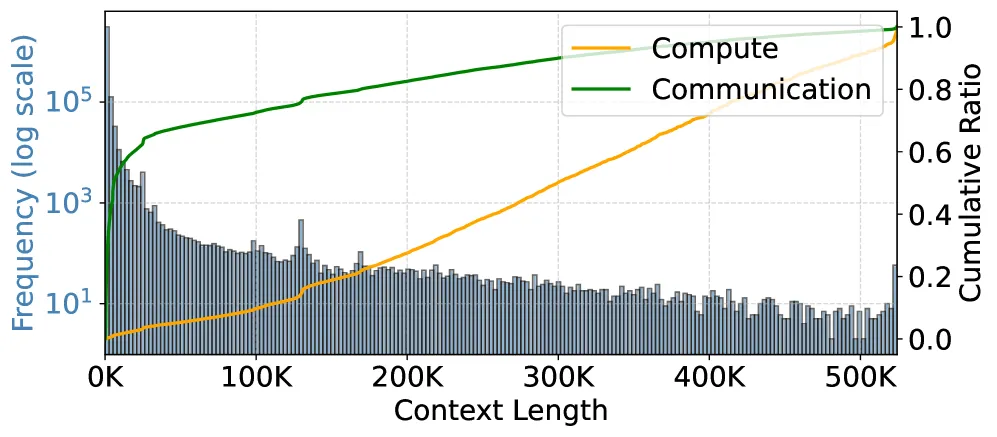
图 2:内部训练任务的上下文长度分布(长尾至 512K,近似对数正态)及累积计算/通信占比。长短序列计算量同量级,但短序列主导通信量。
2. 负载均衡(§3.2)—— 需兼顾三种资源
| 资源 | 说明 | 均衡策略 |
|---|---|---|
| Memory(内存) | worker 内存 = | 严格限制每 worker 总 token 数,避免 OOM,也影响 FFN 等非 attention 模块的均衡 |
| Compute(计算) | 随上下文长度二次方增长 | 需考虑**序列间(inter-sequence)**长度差异,而非仅序列内 |
| Communication(通信) | 网络热点导致拥塞 | Zig-Zag 排序下可归约为计算均衡 |
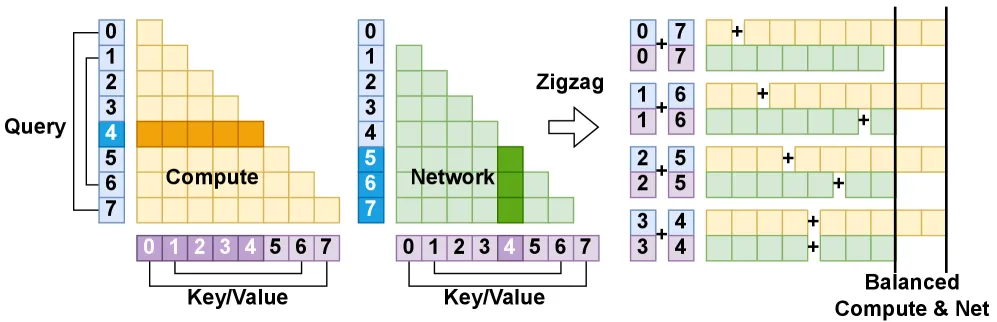
图 4:8-token 序列的 Zig-Zag 打包,实现因果掩码下的序列内计算/通信均衡。将第 块与第 块配对,可完美均衡计算与通信。
3. Ring 拓扑是「镀金的牢笼」(§3.5 A Gilded Cage)
现有 CP 均采用 ring 拓扑(单环或异构子环),因其对称、每 worker 只与邻居通信、易重叠。但 ring 强制序列在固定 worker 环上对称切分,极大限制搜索空间,使调度根本次优。
关键洞察:以 Hopper GPU + 50GB/s ConnectX-7 InfiniBand 为例,只需 22GB/s(44% 线速率)即可完全重叠通信与计算()。增大块 会降低带宽需求(计算二次方增长、通信线性增长),因此 ring 拓扑并非高效通信的唯一途径。
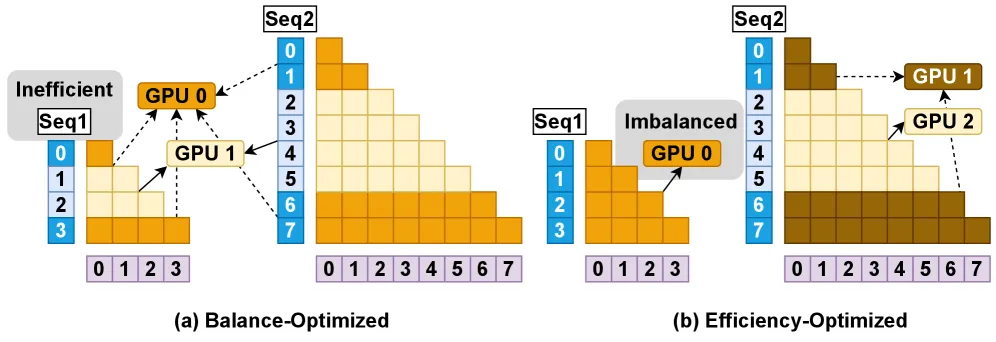
图 5:现有两类 CP 设计。(a) 均衡优化:每序列切成 2×2=4 块 + Zig-Zag,完美均衡但过度切分短序列;(b) 效率优化:按长度将序列空间划分到不同 worker,组内用 ring,但离群长序列破坏均衡。
三大核心组件详解
① Block Distributor(块分发器,§4.1)
- 切分策略:每条序列切成固定大小块。优势:(1) 大幅缩小搜索空间且不失表达力(长序列多块、短序列少块);(2) 块间共享相同的通信/计算量,便于系统化建模。对短于块大小的序列,打包成最少块并用 attention kernel 的 varlen API。
- 块大小选择:由硬件、模型、网络配置共同决定,是「调度粒度 vs 运行效率」的权衡。
- 分配策略:目标 = 在每 worker 最大内存约束下,最小化最大计算负载。采用 LPT 变体贪心地把块分给最空闲 worker。复杂度 ( 块、 GPU),延迟可忽略。
② Communication Planner(通信规划器,§4.2)
三项技术:
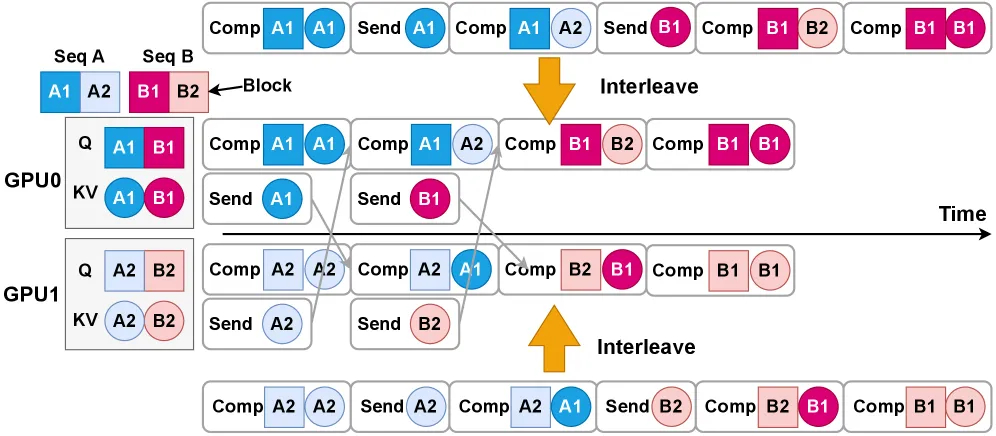
图 7:块级流水线示例。将端到端执行分解为块的计算与通信,块块交错执行,实现重叠。
- 块级流水线(Block-level pipelining):CP 三阶段 = 拉取远程块 → 计算 attention 块 → 推送本地块。FCP 将每阶段分解为块级子阶段并逐块交错。每 worker 一次只拉/推一块,同时计算前一块。
- 无拥塞求解器(Congestion-free solver):随机顺序会导致多 worker 同时从同一 worker 拉块 → 拥塞。FCP 将 worker 数据流建模为二部图( 发送节点 + 接收节点),迭代计算极大匹配,每个匹配 = 一个无拥塞通信轮次。
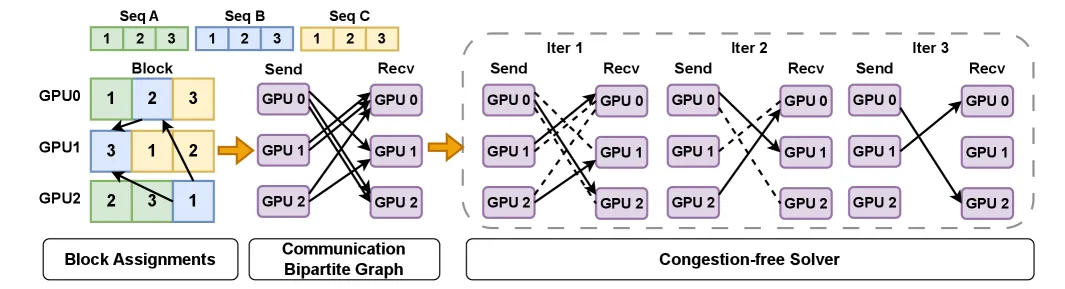
图 8:三条序列(因果掩码)上的无拥塞求解器示例。根据跨 GPU 数据依赖构建二部图,求最小迭代数的极大匹配,给出最优无拥塞通信顺序。
- 自底向上合并器(Bottom-up coalescer):将细粒度子阶段合并为粗粒度阶段而不破坏无拥塞性。如合并度 4,则连续 4 个子阶段合并,每 worker 单阶段发/收/算 4 块。解耦调度粒度(块大小)与执行粒度(合并块大小),提升 kernel 效率。
③ Transparent Reshuffler(透明重排器,§4.3)
CP 部署难点在于需侵入式修改框架(dataloader、RoPE 位置编码等)。FCP 在进入 attention 模块时即时重排用户序列布局为负载感知布局,退出时还原。通过在 attention 前后插入两次 all-to-all,并将其与本地计算(不依赖远程块的计算)重叠,开销可忽略。因通信量以总上下文长度为界(每序列仅一份拷贝),而计算二次方增长,故必可重叠。
模块化集成:FCP 可透明集成 FSDP、TP、EP、SP 等并行方式,非 attention 操作无需修改。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 块级抽象(block-wise abstraction) | 固定大小块作为调度/计算基本单元,缩小搜索空间且保持表达力 | 长序列多块、短序列少块;块间共享通信/计算量 |
| 任意点对点分配 | 打破 ring 拓扑的刚性约束,块可放任意 worker | 图 5 分析 + 图 9 负载均衡 <5% |
| LPT bin-packing 负载均衡 | 混合装箱长短序列块,贪心分给最空闲 worker | ,图 9 计算/通信不均衡 <5% |
| 无拥塞通信规划器 | 二部图极大匹配保证最优无拥塞顺序(子阶段数 = ) | Lemma 1+2,Hopcroft–Karp |
| 块级流水线 + 合并器 | 计算通信重叠,解耦调度粒度与执行粒度 | 消融 Table 2:流水线 +64%、合并器 +10% |
| 透明重排器 | 无侵入集成 FSDP/TP/EP/SP,重排与计算重叠 | 消融 Table 2:+7% |
五、实验结果
实验设置(§6.1)
| 项目 | 配置 |
|---|---|
| 硬件 | 两类集群(工业界 + 学术界),两种 GPU:GPU-X、GPU-Y(型号匿名) |
| 模型 | Llama-3-70B 配置:8 KV 头、64 QO 头、head_dim=128 |
| 数据 | 内部训练 trace 采样,最大序列 512K,因果掩码 |
| 每 GPU token 数 | 32K(大规模预训练常用值) |
| 块大小 | GPU-X/GPU-Y 均用 4K,合并度默认 16 |
| 通信 SM 数 | GPU-X 用 6 个,GPU-Y 用 8 个 SM |
GPU 计算/通信比(Table 1):GPU-X = 5920,GPU-Y = 2500(BFloat16 TensorOp 吞吐 ÷ 网络带宽)
Baseline:① Ring Attention(均衡优化)② ByteScale(效率优化,长短序列分不同 GPU)③ WLB-LLM(在线估计器自适应切换两者)④ MagiAttention(并发开源工作)
主要结果
1. 负载均衡(§6.2)
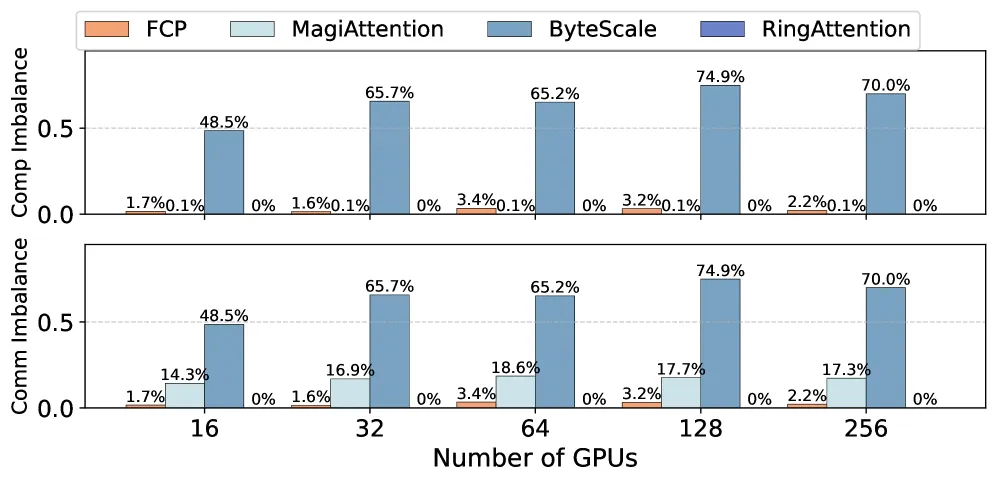
图 9:扩展 GPU 数时的计算(上)与通信(下)不均衡比率。
不均衡比率定义:
- FCP:始终 <5% 不均衡(得益于块级细粒度分配)
- MagiAttention:仅优化计算,通信量不均衡高达 17%
- ByteScale:按长度空间划分, 计算仅分到 张 GPU,不均衡高达 70%
2. 计算效率(§6.3)
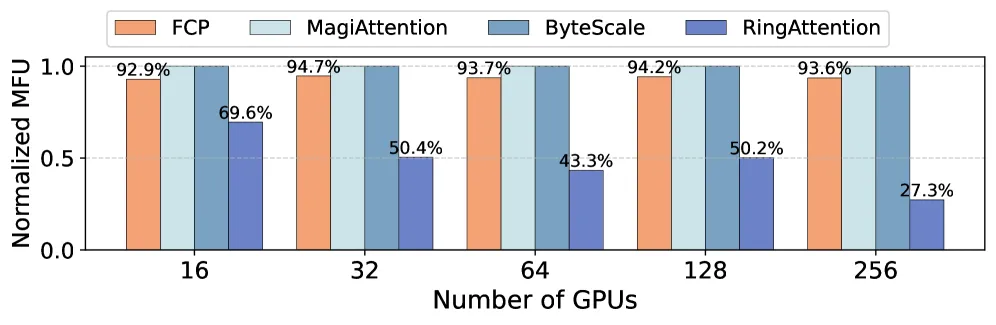
图 10:完美负载均衡下的归一化 attention MFU。
假设所有序列等于平均长度以排除负载不均衡影响,MFU 以单 GPU FlashAttention 归一化:
- FCP:始终 >90% MFU(仅因通信专用 SM 有微小下降)
- Ring Attention:因短序列过度切分,MFU 大幅下降
3. 模块级 MFU 扩展性(§6.4)
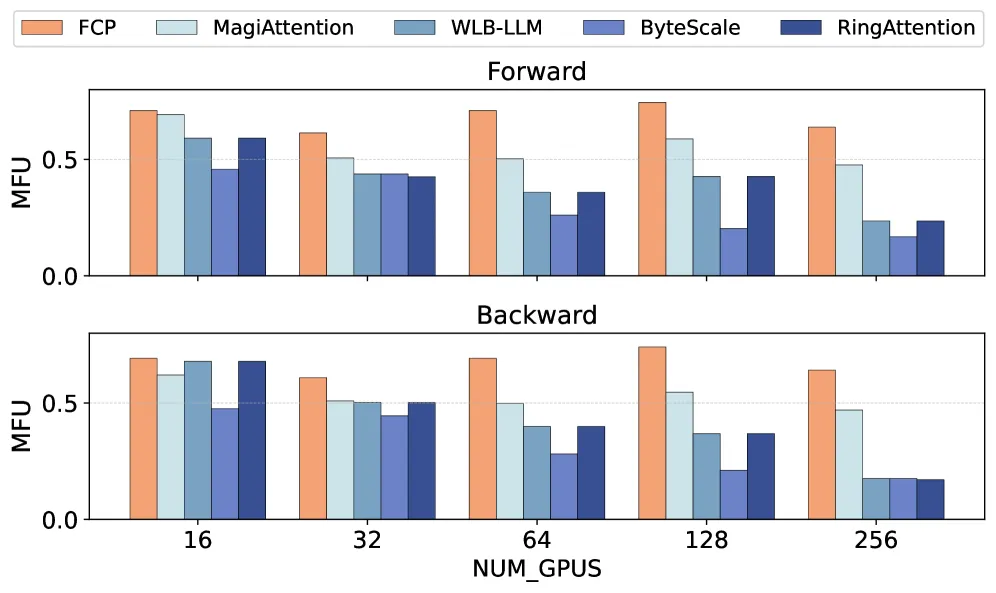
图 11:真实数据集上模块级 attention MFU 的弱扩展(每 GPU 固定 32K token)。
- 16 GPU 时各方法接近(小规模优化空间小)
- CP 度增大后:Ring Attention 因计算效率下降而落后;ByteScale 因长尾分布下负载严重不均衡而更差
- FCP 在所有配置下均超越全部 baseline
总体结论:跨三种不同上下文长度分布,FCP 一致实现近线性扩展,在 attention MFU 上超越 baseline 1.13x–2.21x,最高扩展至 256 张 NVIDIA GPU。
消融实验(§6.5,Table 2,128× GPU-X)
逐一叠加组件:#1 块级流水线、#2 无拥塞求解器、#3 自底向上合并器、#4 透明重排器。
| 阶段 | Base | #1 流水线 | #2 求解器 | #3 合并器 | #4 重排器 |
|---|---|---|---|---|---|
| Fwd(前向) | 0.29 | 0.48 (+64%) | 0.62 (+29%) | 0.70 (+10%) | 0.75 (+7%) |
| Bwd(反向) | 0.37 | 0.46 (+24%) | 0.59 (+28%) | 0.69 (+17%) | 0.74 (+7%) |
每个组件都带来可观的利用率提升,其中块级流水线贡献最大。
敏感性测试(§6.6)
- 块大小(图 12,128× GPU-X):4K 块取得最佳 MFU(均衡与计算效率的甜点)
- 每 GPU token 数(图 13):不同 token 数下 FCP 均超越 baseline
- GPU 类型(图 14,GPU-Y + FlashAttention-4):FCP 达单 GPU FA4 的 >70% MFU(差距主要来自通信占用的 SM 及更高算术强度需求);因 MagiAttention 依赖定制 kernel 而被排除
六、相关工作与讨论
相关工作(§8):Ring attention 及其变体、DeepSpeed-Ulysses(SP)、ByteScale、WLB-LLM 等。SP 与 CP 正交,可组合。SP 受限于注意力头数(如 Qwen3-235B 仅 4 KV 头),无法扩展到数千 worker,故 FCP 聚焦 CP。
讨论与局限(§7):
- 本文聚焦因果与非因果掩码,不规则掩码模式留待未来工作
- FCP 引入比 ring 拓扑更复杂的流量——这是换取块级细粒度调度灵活性的权衡,但保证可与计算重叠,不成为系统瓶颈
七、总结
核心贡献
- 问题分析:系统分析现有 CP 设计的低效根源(计算低效 + 负载不均衡)及实现最优解的挑战,指出 ring 拓扑是「镀金的牢笼」。
- 块级抽象:提出细粒度块级抽象,实现灵活的负载划分。
- 模块化框架:FCP 作为模块化 CP 框架,可透明集成 FSDP、TP、EP、SP。
- 高效实现与评测:块级流水线 + 无拥塞求解器 + 合并器 + 透明重排器,在 256× NVIDIA GPU 上验证通用性与可行性。
技术影响
- 为长尾/多模态数据下的长上下文预训练提供了近线性扩展的 CP 方案,attention MFU 提升 1.13x–2.21x。
- 将 CP 调度从「ring 拓扑约束」解放为「任意 P2P + bin-packing」,为后续 CP 系统设计开辟新方向。
- 无拥塞通信规划(二部图匹配)与块级流水线可迁移至其他分布式通信密集型场景。
局限性
- 仅支持因果/非因果掩码,不支持不规则注意力模式(如稀疏、滑窗等特殊 mask)。
- 相比 ring,通信流量更复杂,依赖性能模型保证重叠。
- GPU 型号与集群规模因保密而匿名,可复现性受一定限制。
八、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.08524
- HTML 版本:https://arxiv.org/html/2605.08524v1
- 相关工作:Ring Attention (Liu et al. 2023)、ByteScale (Ge et al. 2025)、WLB-LLM (Wang et al. 2025b)、MagiAttention (Zewei & Yunpeng 2025)、FlashAttention-3/4 (Shah et al. 2024)
- 同名不同工作:arXiv:2602.21788(FCP on Ascend 910C NPU,Yifan Niu 等)