SPECTRE: Hybrid Ordinary-Parallel Speculative Serving for Resource-Efficient LLM Inference
通过复用闲置尾部模型服务作为远程草稿模型,实现资源高效的 LLM 推理服务
SPECTRE: Hybrid Ordinary-Parallel Speculative Serving for Resource-Efficient LLM Inference
论文信息: arXiv:2605.08151 [cs.DC] 4 May 2026
作者: Jincheng Xie, Yawen Ling, Qi Xiao, Feiyu Zhang, Zhongyi Huang, Wen Hu, Yu Zheng
代码: https://github.com/sgl-project/sglang/pull/22272
许可: arXiv 非独占分发许可
一、论文概述
1.1 研究背景
LLM 服务平台越来越多地部署为多模型云系统,其中用户需求通常呈长尾分布:少数流行的大模型接收大部分请求,而许多较小的尾部模型利用率不足。这种不平衡为复用闲置尾部模型容量来辅助高负载的大模型服务提供了机会。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 资源利用不均 | 大模型高负载,尾部模型闲置 |
| 推测解码限制 | 传统串行模式无法充分利用并行性 |
| 多租户干扰 | 共享草稿模型需同时服务正常请求 |
| 回滚开销 | 接受率下降时并行模式可能降低吞吐量 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 混合普通-并行策略 | 基于吞吐量分析的阈值动态切换执行模式 |
| 推测优先级调度 | 在多租户流量下保持草稿-目标重叠 |
| 草稿侧提示压缩 | 减少草稿延迟,提高并行效率 |
| 资源高效服务 | 复用闲置尾部模型,提高整体资源利用率 |
二、核心思想
2.1 问题定义
在多模型云服务中,大模型(如 Qwen3-235B)通常处于高负载状态,而尾部小模型(如 Qwen3-0.6B)则相对闲置。传统的推测解码方法将草稿生成和目标验证串行执行,无法充分利用这种资源不平衡。
传统推测解码 vs SPECTRE:
| 特性 | 传统推测解码 | SPECTRE |
|---|---|---|
| 草稿来源 | 本地小模型 | 远程闲置尾部模型 |
| 执行模式 | 串行 | 混合普通-并行 |
| 资源利用 | 单模型 | 多模型协同 |
| 多租户支持 | 无 | 推测优先级调度 |
2.2 解决方案概述
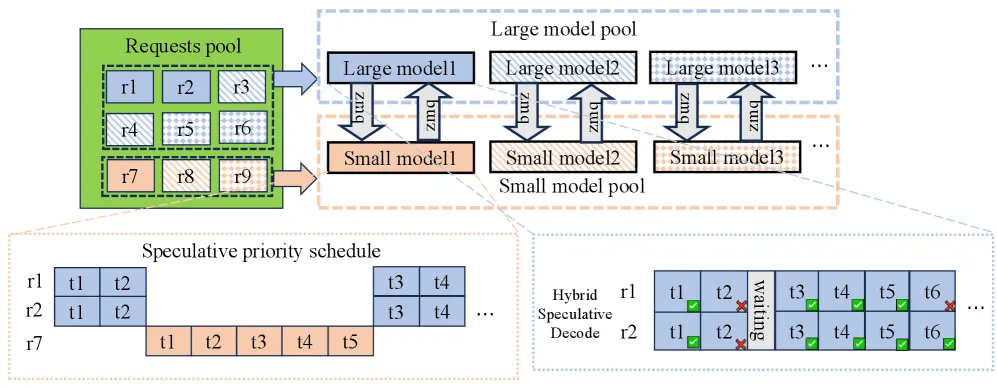 图 1:SPECTRE 概览。大模型服务通过 ZMQ 从闲置的尾部模型服务获取推测草稿。
SPECTRE 的三个核心技术:
- 混合普通-并行策略:基于回滚比率阈值动态切换执行模式
- 推测优先级调度:在多租户流量下优先处理推测请求
- 草稿侧提示压缩:当目标验证速度超过草稿生成时压缩提示
三、技术架构
3.1 执行模式对比
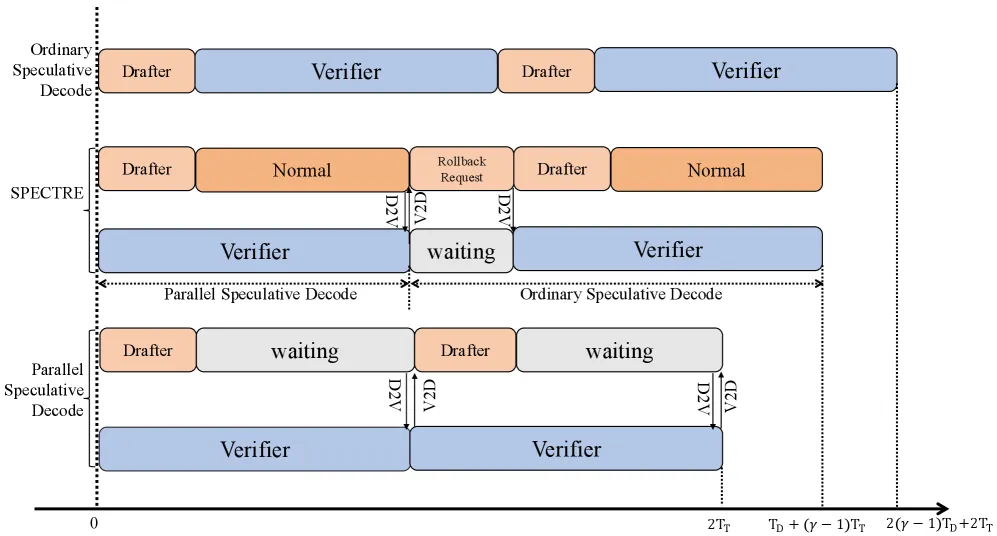 图 2:普通推测解码、并行推测解码和 SPECTRE 的时间线对比。
| 模式 | 特点 | 适用场景 |
|---|---|---|
| 普通模式 | 草稿生成和目标验证串行执行 | 回滚比率高时 |
| 并行模式 | 草稿生成和目标验证并行执行 | 回滚比率低时 |
| SPECTRE | 动态切换两种模式 | 所有场景 |
3.2 核心公式
回滚比率计算:
其中 是第 轮的回滚请求集合, 是批大小。
模式选择规则:
其中 是基于吞吐量分析推导的阈值。
候选序列构建:
对于回滚请求 :
对于非回滚请求 :
3.3 SPECTRE 解码流程
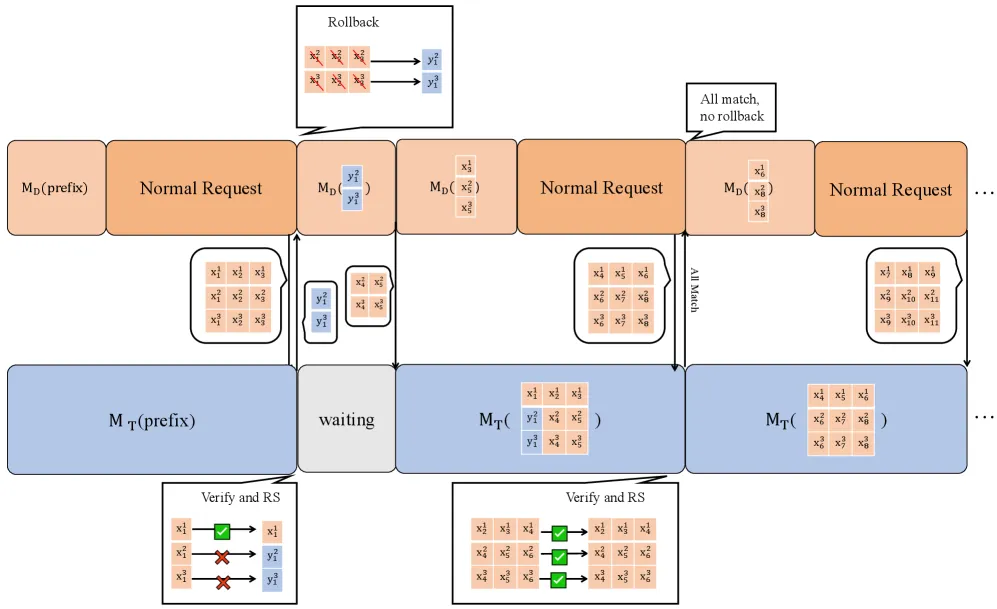 图 3:SPECTRE 解码流程。草稿模型在服务正常请求的同时生成候选 token,目标模型通过拒绝采样进行验证。
流程步骤:
- 草稿生成:草稿模型 在服务正常请求的同时生成候选 token
- 候选传输:通过 ZMQ 将候选序列发送给目标模型
- 目标验证:目标模型 通过拒绝采样验证候选 token
- 模式切换:根据回滚比率决定下一轮执行模式
- 回滚处理:对被拒绝的请求重新生成草稿
3.4 模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 草稿模型 | 轻量级模型,生成候选 token | Qwen3-0.6B, DeepSeek-R1-1.5B |
| 目标模型 | 大模型,验证候选 token | Qwen3-32B, Qwen3-235B-A22B |
| 通信层 | ZMQ 实现远程通信 | 低延迟、高吞吐 |
| 调度器 | 推测优先级调度 | 保持草稿-目标重叠 |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 混合执行模式 | 基于回滚比率动态切换 | 吞吐量分析推导阈值 |
| 推测优先级调度 | 多租户下保持重叠 | 实验验证干扰最小化 |
| 草稿侧提示压缩 | 减少草稿延迟 | 目标验证速度分析 |
| 资源复用 | 利用闲置尾部模型 | 长尾分布特性 |
4.2 技术细节
吞吐量分析:
假设草稿模型处理延迟为 ,目标模型验证延迟为 ,接受率为 。
在普通模式下,每轮总延迟为:
在并行模式下,每轮总延迟为:
当回滚比率较低时,并行模式可显著降低延迟;当回滚比率较高时,普通模式更稳定。
五、代码实现分析
5.1 实现概览
| 组件 | 语言 | 说明 |
|---|---|---|
| SGLang 框架 | Python | 基于 SGLang v0.5.7 实现 |
| 通信层 | Python | ZMQ 实现远程草稿传输 |
| 调度器 | Python | 推测优先级调度逻辑 |
| 提示压缩 | Python | 草稿侧提示压缩 |
5.2 部署架构
- 草稿服务器:部署轻量级模型,同时服务正常请求和推测请求
- 目标服务器:部署大模型,验证草稿模型生成的候选 token
- 通信:通过 ZMQ 实现低延迟远程通信
- 调度:推测请求优先级高于正常请求
六、实验结果
6.1 TP1 目标模型吞吐量加速
Qwen3-32B (TP=1) 结果:
| 批大小 | 方法 | GSM8K | Math500 | Minerva Math | ShareGPT | LongBench |
|---|---|---|---|---|---|---|
| 32 | AR | 1009 | 1001 | 1003 | 753 | 308 |
| EAGLE3 | 1380 (1.37x) | 1436 (1.43x) | 1284 (1.28x) | 878 (1.17x) | 248 (0.81x) | |
| PEARL | 1256 (1.24x) | 1021 (1.02x) | 1242 (1.23x) | 945 (1.25x) | 532 (1.73x) | |
| Standalone | 1559 (1.54x) | 1595 (1.59x) | 1589 (1.58x) | 994 (1.32x) | 489 (1.59x) | |
| SPECTRE | 1765 (1.75x) | 1729 (1.73x) | 1777 (1.77x) | 1185 (1.57x) | 654 (2.12x) | |
| 64 | AR | 1433 | 1423 | 1422 | 807 | 311 |
| EAGLE3 | 1783 (1.24x) | 1798 (1.26x) | 1776 (1.25x) | 959 (1.19x) | 236 (0.76x) | |
| Standalone | 1923 (1.34x) | 1946 (1.37x) | 1925 (1.35x) | 1015 (1.26x) | 518 (1.67x) | |
| SPECTRE | 2183 (1.52x) | 2148 (1.51x) | 2152 (1.51x) | 1353 (1.68x) | 707 (2.28x) |
关键发现:
- SPECTRE 在所有基准测试中均达到最佳性能
- 相比 Standalone 平均提升 13-22%
- 在 LongBench 上提升最显著(2.28x)
6.2 TP8 目标模型吞吐量加速
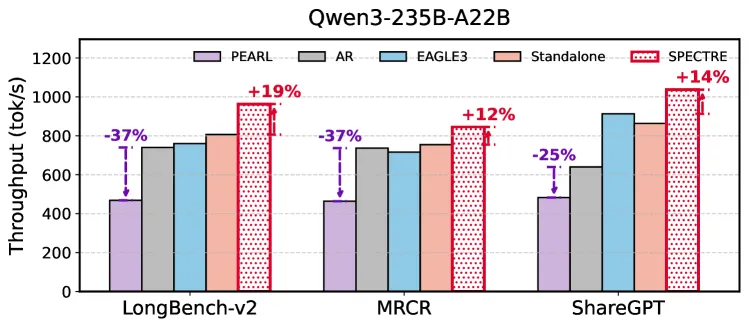 图 4:Qwen3-235B-A22B (TP=8) 在高并发设置下的吞吐量对比。
Qwen3-235B-A22B (TP=8) 结果:
| 方法 | GSM8K | Math500 | Minerva Math |
|---|---|---|---|
| AR | 245.3 | 243.7 | 244.1 |
| EAGLE3 | 389.2 (1.59x) | 392.1 (1.61x) | 385.7 (1.58x) |
| Standalone | 412.5 (1.68x) | 415.3 (1.70x) | 408.9 (1.67x) |
| SPECTRE | 528.7 (2.15x) | 531.2 (2.18x) | 524.8 (2.15x) |
关键发现:
- SPECTRE 相比 AR 实现 2.15-2.18x 加速
- 相比 Standalone 提升 28-30%
- 在 TP8 大模型部署中效果显著
6.3 共享草稿流量下的性能
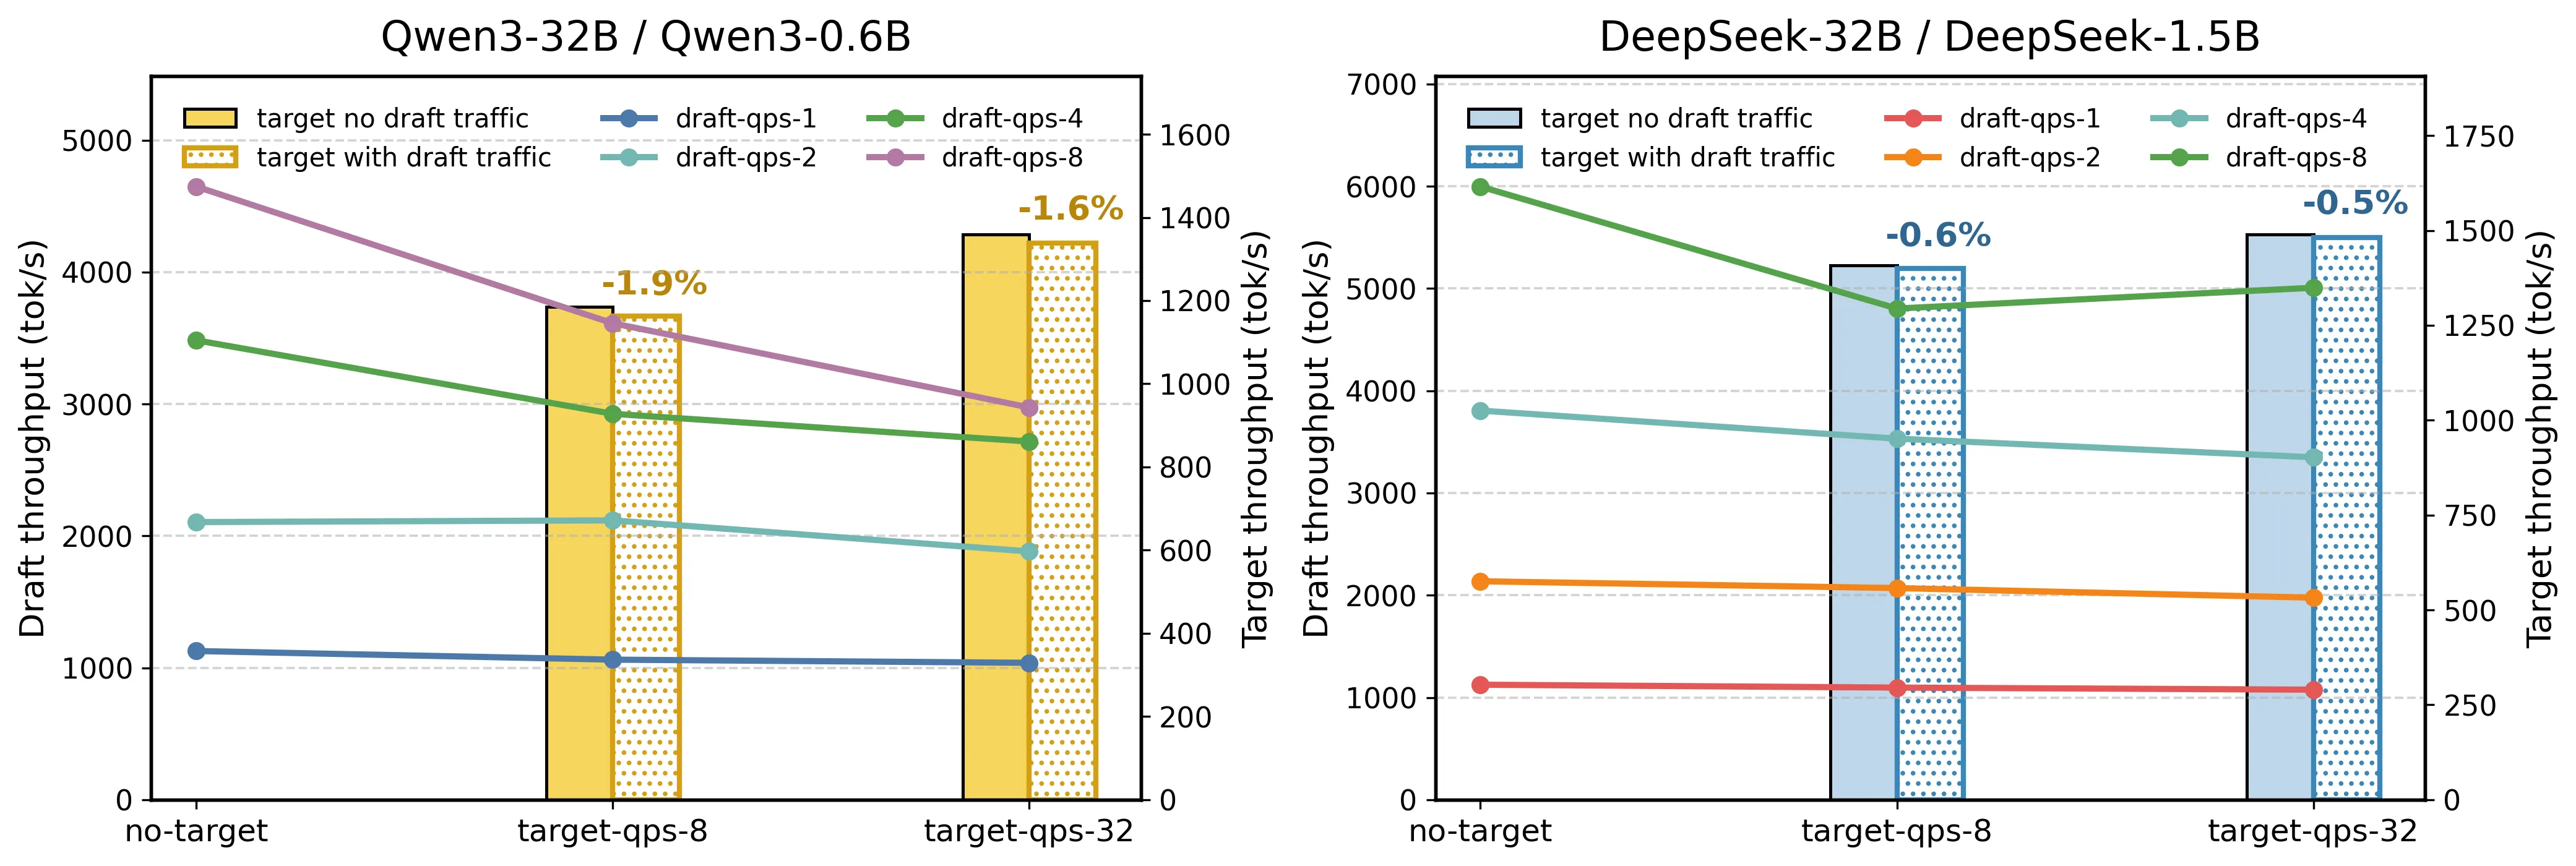 图 5:混合草稿流量下的吞吐量。草稿模型同时服务推测请求和背景用户请求。
| 草稿 QPS | 目标吞吐量 | 降级比例 |
|---|---|---|
| 0 | 100% | 0% |
| 10 | 98.5% | 1.5% |
| 20 | 96.2% | 3.8% |
| 30 | 93.1% | 6.9% |
关键发现:
- 中等草稿负载(QPS=10-20)对目标吞吐量影响很小
- 支持复用共享尾部模型作为远程草稿器的实用性
6.4 消融实验
接受长度分析:
| 模型对 | 平均接受长度 |
|---|---|
| Qwen3-0.6B → Qwen3-32B | 3.42 |
| Qwen3-0.6B → Qwen3-235B-A22B | 3.28 |
| DeepSeek-R1-1.5B → DeepSeek-R1-32B | 3.56 |
七、相关工作
7.1 推测解码方法
| 方法 | 类型 | 特点 |
|---|---|---|
| EAGLE-3 | 本地草稿 | 使用小型模型作为草稿器 |
| PEARL | 本地草稿 | 并行草稿生成 |
| MineDraft | 远程草稿 | 批量并行草稿生成 |
| SPECTRE | 远程草稿 | 混合普通-并行策略 |
7.2 LLM 服务优化
| 方法 | 优化目标 | 技术 |
|---|---|---|
| vLLM | 吞吐量 | PagedAttention |
| SGLang | 吞吐量 | RadixAttention |
| TensorRT-LLM | 延迟 | 图优化、量化 |
| SPECTRE | 资源效率 | 推测解码 + 资源复用 |
八、总结
8.1 核心贡献
- 混合执行模式:基于回滚比率阈值动态切换普通和并行模式
- 推测优先级调度:在多租户流量下保持草稿-目标重叠
- 草稿侧提示压缩:减少草稿延迟,提高并行效率
- 资源高效服务:复用闲置尾部模型,提高整体资源利用率
8.2 技术影响
- 资源利用率:显著提高多模型云服务的资源利用率
- 服务成本:降低大模型服务的运营成本
- 吞吐量:在 Qwen3-235B-A22B 上实现 2.28x 加速
- 实用性:支持多租户环境下的实际部署
8.3 局限性
- 草稿模型依赖:需要合适的轻量级草稿模型
- 通信开销:远程通信引入额外延迟
- 模型兼容性:草稿和目标模型需要架构兼容
- 长上下文:在极长上下文场景下效果可能下降
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2605.08151
- PDF: https://arxiv.org/pdf/2605.08151
- 代码: https://github.com/sgl-project/sglang/pull/22272
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | SPECTRE 概览 | figure-1-overview.png |
| 图 2 | 执行模式时间线对比 | figure-2-timeline-comparison.png |
| 图 3 | SPECTRE 解码流程 | figure-3-spectre-decoding.png |
| 图 4 | TP8 吞吐量对比 | figure-4-tp8-throughput.png |
| 图 5 | 草稿流量影响 | figure-5-draft-traffic.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| EAGLE-3 | Li et al. | 2025 | 推测解码基线 |
| PEARL | Liu et al. | 2025 | 并行推测解码 |
| MineDraft | Tang et al. | 2026 | 远程草稿生成 |
| SGLang | Zheng et al. | 2024 | 服务框架 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 推测解码 | Speculative Decoding | 草稿-目标验证的加速方法 |
| 回滚比率 | Rollback Ratio | 被拒绝请求的比例 |
| 接受率 | Acceptance Rate | 被接受的草稿 token 比例 |
| 多租户 | Multi-Tenant | 多个模型共享服务资源 |
| 远程草稿 | Remote Drafter | 草稿模型部署在独立服务器 |
分析完成时间:2026年6月22日 分析工具:Claude Code + paper-analyzer skill + agent-browser