RateQuant: Optimal Mixed-Precision KV Cache Quantization via Rate-Distortion Theory
RateQuant用率失真理论把KV cache按注意力头分配bit宽度:假设量化MSE满足$D(b)=\alpha\beta^{-b}$,用reverse waterfilling闭式求最优分配,并识别distortion model mismatch这一失效模式——不同量化器$\beta$从3.6到5.3变化,套错模型比uniform更差。校准per-quantizer $\beta$并对K/V单独分配预算后,Qwen3-8B在KIVI 2.5bit的PPL从49.3降到14.9(−70%),QuaRot改善6.6 PPL;全流程校准仅1.6秒,推理零开销。
RateQuant: Optimal Mixed-Precision KV Cache Quantization via Rate-Distortion Theory
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2605.06675 |
| 标题 | RateQuant: Optimal Mixed-Precision KV Cache Quantization via Rate-Distortion Theory |
| 作者 | Fei Zuo, Zikang Zhou, Hao Cong, Xiaoyan Xi, Ho Fai Leung |
| 提交日期 | 2026-04-22(v1),2026-06-26(v2) |
| 学科分类 | cs.LG, cs.CL, cs.IT |
| 评测 | Qwen3-4B/8B/32B,WikiText-2 PPL + ARC/HellaSwag/PIQA/WinoGrande |
二、核心思想
问题定义:LLM 生成时缓存所有 KV pair,规模随 seq len × batch × 层数线性增长;一个 32B 模型 4k seq FP16 已占 >1GB,往往超过权重本身。KV cache 量化能降低此成本,但现有量化器(KIVI、QuaRot、TurboQuant、Hooper 2024 等)都给每个注意力头分配相同 bit-width,忽略头重要性异质性。自然想法是按头分配不同 bit,但作者发现一个隐藏陷阱:不同 quantizer 的失真曲线 的衰减率 差异从 3.6 到 5.3,把一个 quantizer 的 distortion model 套到另一个 quantizer,会翻转 marginal gain 排序,让 mixed-precision 比 uniform 更差——distortion model mismatch。
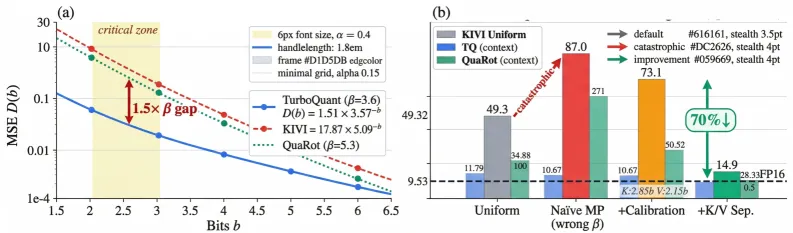
解决方案:RateQuant 把 per-head KV cache bit 分配形式化成率失真优化问题,用 reverse waterfilling 闭式求最优连续解,用贪心 求最优整数解,并通过per-quantizer 校准 消除 mismatch。进一步把 K/V 视为 独立组件、允许它们拿到不同预算,得到”quantizer-agnostic”分配层。
三、技术架构/方法
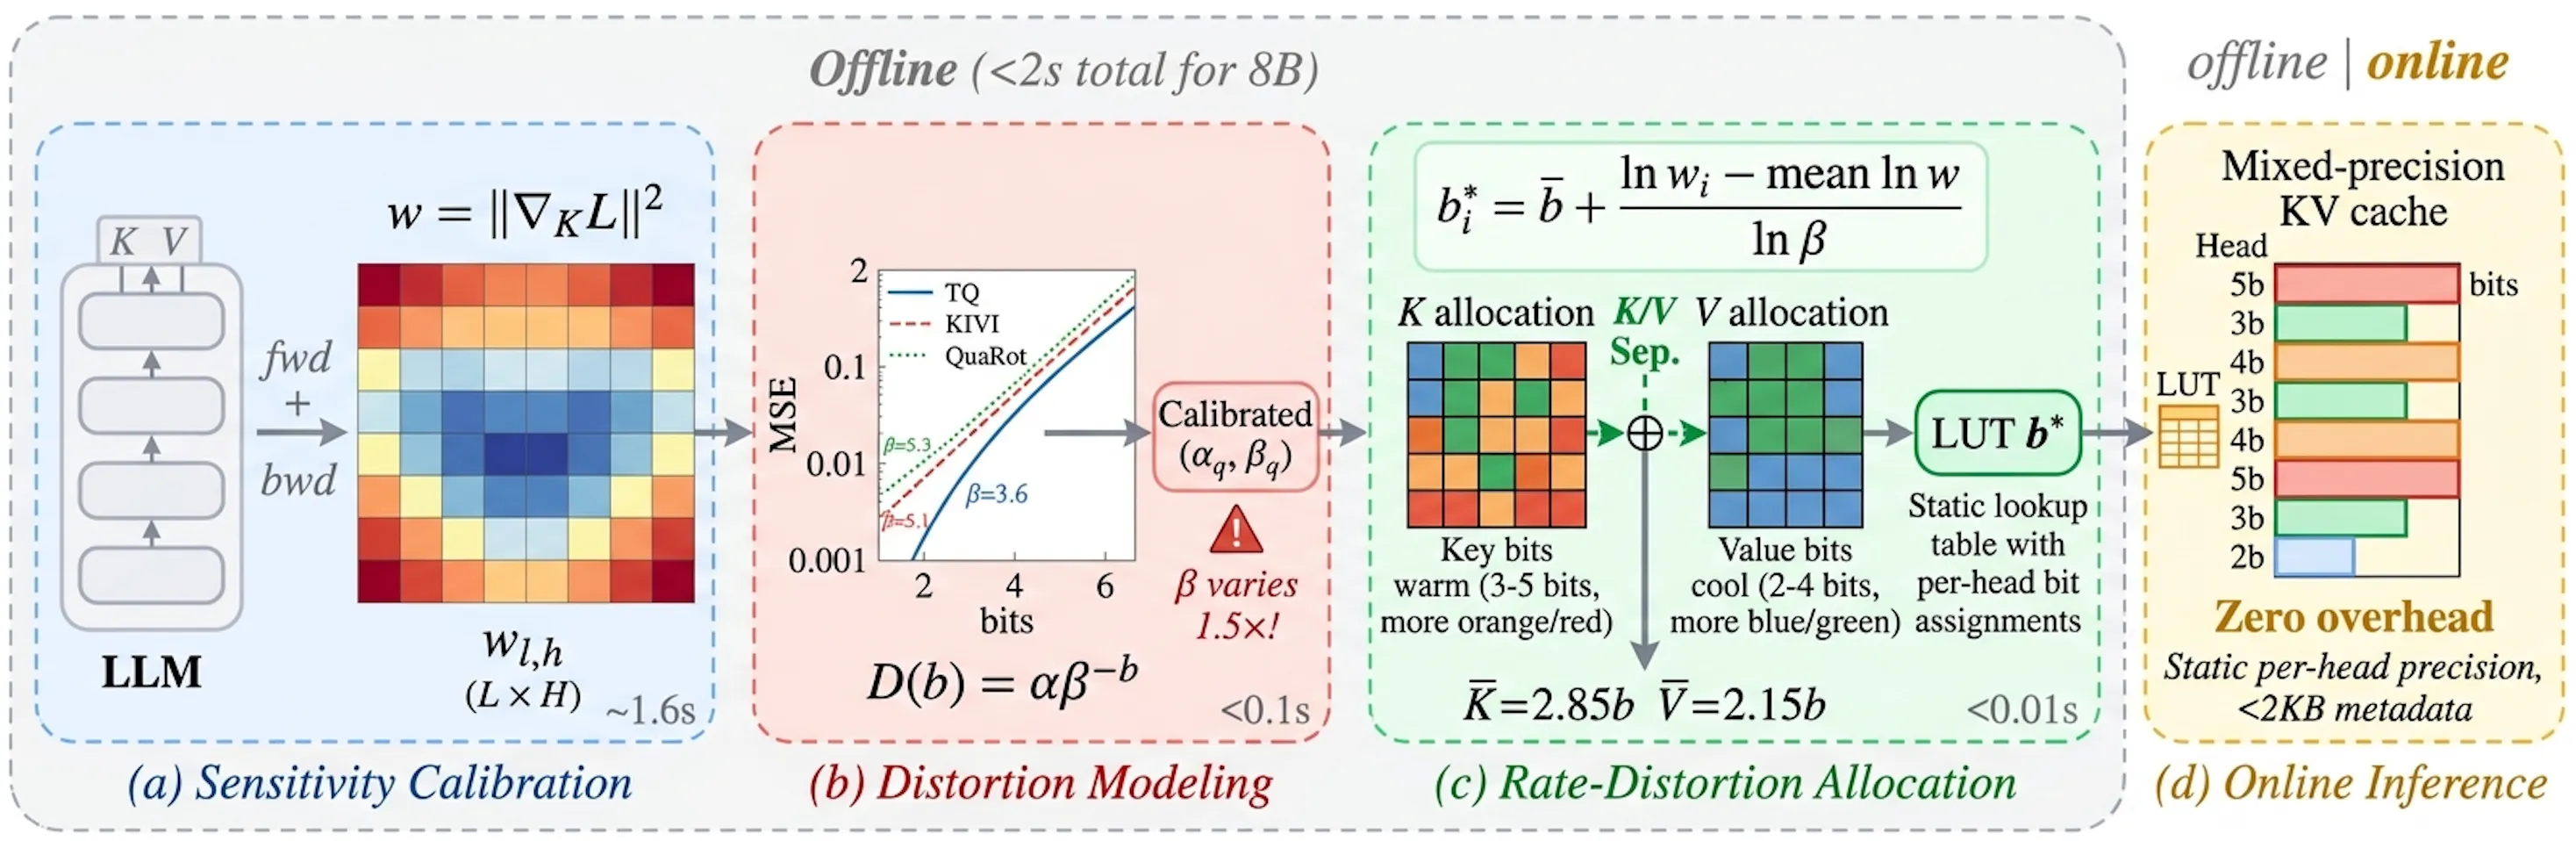
RateQuant 分四阶段(图 2):
3.1 问题建模
层 × KV heads = 组。每组 sensitivity 。假设:
Assumption 1(指数失真–率):。作者用 TurboQuant Lloyd-Max MSE()拟合 。
优化:
3.2 Reverse Waterfilling(Theorem 2)
连续解:
其中 。关键洞察: 越小,同样的 sensitivity ratio 分到越多额外 bit。TurboQuant 时,某头 sensitivity 是均值 倍会分到 额外 bit。
Gain ratio(Theorem 3):
是算术均值, 是几何均值。AM/GM 比可在不量化的情况下预测混合精度潜在收益;Qwen3 上经验 ,说明有可观空间。
Corollary 4:若 ,则 。
3.3 Sensitivity Estimation
用 KV 投影输出的平方梯度范数:
类似。:16 sequences × 512 tokens。
Proposition 5(Loss–distortion connection,2 阶 Taylor + diagonal Fisher):
梯度型 sensitivity 直接出现在 loss 展开中,activation-based 只 bound 前向误差放大——这解释了后者 1.07 PPL 劣化。
3.4 整数贪心分配(Algorithm 1)
对每个组从 起,每次选 ,,直到消耗完预算 。Proposition 6: 凸时贪心即最优(polymatroid 结构)。
3.5 Quantizer-Agnostic 扩展
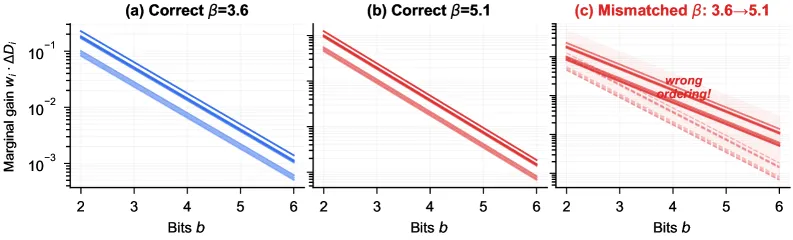
Empirical distortion calibration:TurboQuant ,KIVI/QuaRot –5.3。测 MSE, vs 做最小二乘拟合 。至关重要:错的 反转 marginal gain 排序(图 3),KIVI 2.5bit 从 49.3 恶化到 87.0。
Separate K/V allocation:K 和 V 用不同量化 schema(per-channel key vs per-token value)时,令它们成为 独立组件,允许 。
Pipeline summary:(1) 16 forward+backward 做 sensitivity(8B on H200 ~1.6s);(2) 5 个 bit 上 distortion 建模(<0.1s);(3) 贪心分配 组件(<0.01s);(4) 推理侧使用静态 2KB lookup table,零 runtime 开销。
3.6 Per-head 分配可视化
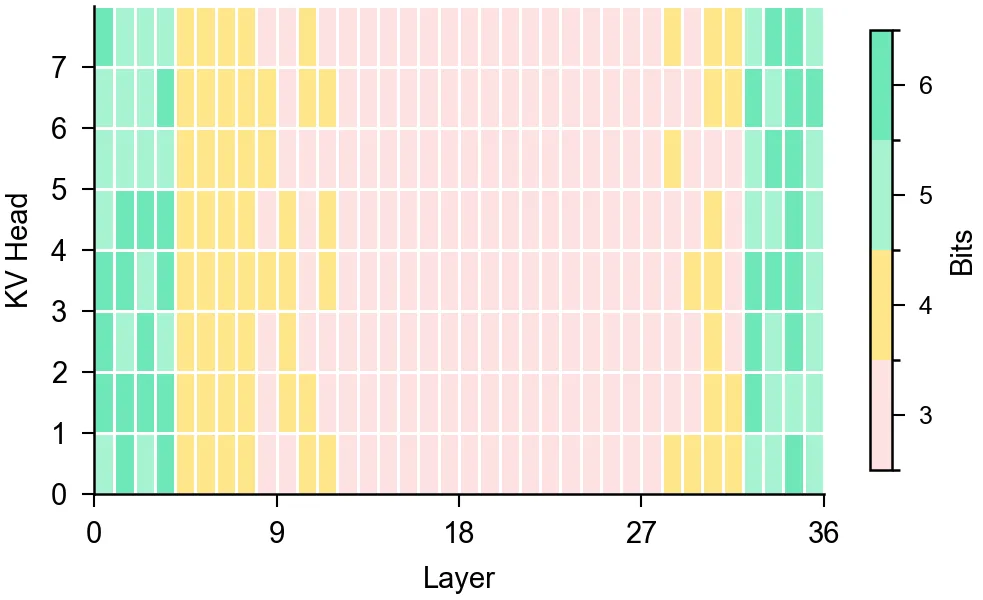
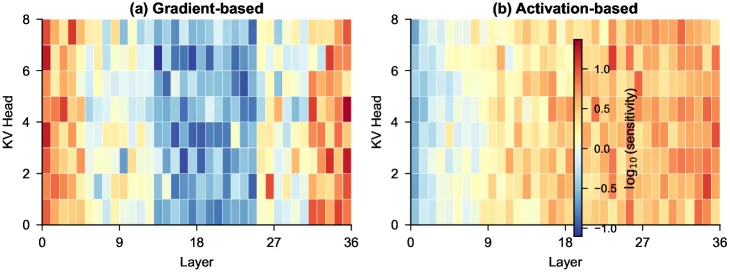
Qwen3-8B ():高敏感度头(早/晚层)拿 5–6 bit,低敏感度中间层拿 3 bit。梯度型 sensitivity 呈 U 型(早+晚层高),activation-based 单调递增(图4)。
四、核心创新
| 创新点 | 说明 |
|---|---|
| 率失真优化框架 | 首次把 per-head KV bit 分配写成 ,闭式 reverse waterfilling 求解 |
| Distortion model mismatch 概念 | 识别并解决”用错 quantizer 的 反而更差”的失效模式 |
| Per-quantizer 校准 | 5 bit-width MSE + 最小二乘拟合,让方法 quantizer-agnostic |
| Separate K/V allocation | K/V 独立预算,可差异化到 2.85/2.15 bit |
| Gradient-based sensitivity + Prop 5 | 理论证明梯度型是 loss-preserving 分配的正确 proxy |
| AM/GM 预算收益预测器 | 无需量化即可预判混合精度潜在收益 |
五、实验结果
5.1 主结果:Uniform vs RateQuant(TurboQuant)
WikiText-2 PPL(seed 42;8B 3 seeds 均值), = PPL 改善:
| Model | Uniform | RateQuant | FP16 | ||
|---|---|---|---|---|---|
| Qwen3-4B | 3.5 | 13.89 | 13.70 | +0.20 | 13.19 |
| 4.0 | 13.92 | 13.47 | +0.45 | ||
| Qwen3-8B | 3.5 | 10.00 | 9.76 | +0.24 | 9.53 |
| 4.0 | 9.94 | 9.67 | +0.27 | ||
| Qwen3-32B | 3.5 | 7.70 | 7.64 | +0.06 | 7.50 |
Qwen3-8B @ 4.0 bit:恢复 66% headroom;Qwen3-4B @ 4.0 bit:恢复 62%。sweet spot 在 3.5–4.0 bit。
5.2 跨量化器校准(Qwen3-8B)
Table 3()四策略对比——Theo=用 TurboQuant 的 ;Cal=校准;+Sep=K/V 分离:
| Quant | Uniform | Theo | Cal | Cal+Sep | ||
|---|---|---|---|---|---|---|
| KIVI | 2.5 | 49.32 | 86.95 | 73.12 | 14.86 (−70%) | 2.85/2.15 |
| KIVI | 3.0 | 10.81 | 12.43 | 11.30 | 10.97 | 3.07/2.93 |
| QuaRot | 2.5 | 34.88 | 271.9 | 50.52 | 28.33 (+6.6) | 2.61/2.39 |
| QuaRot | 3.0 | 11.90 | 12.27 | 10.84 | 10.58 (+1.3) | 3.04/2.96 |
| TurboQuant | 3.0 | 10.92 | 9.96 | 9.96 | 9.88 (+1.0) | 3.06/2.94 |
| FP16 | 9.53 |
- mismatch 会灾难化:KIVI 从 49.3 → 87.0,QuaRot 从 34.9 → 271.9;
- calibration 部分恢复,但 K/V separation 是关键:KIVI 2.5bit 从 73.1 降到 14.9,靠”K 2.85bit, V 2.15bit” 的差异化预算(per-channel key 更 error-prone,per-token value 较容忍);
- TurboQuant + RateQuant 3.0bit(9.88) 击败 KIVI uniform 3.0(10.81)与 QuaRot uniform 3.0(11.90)——在弱 quantizer 上做好分配可以超过强 quantizer + uniform。
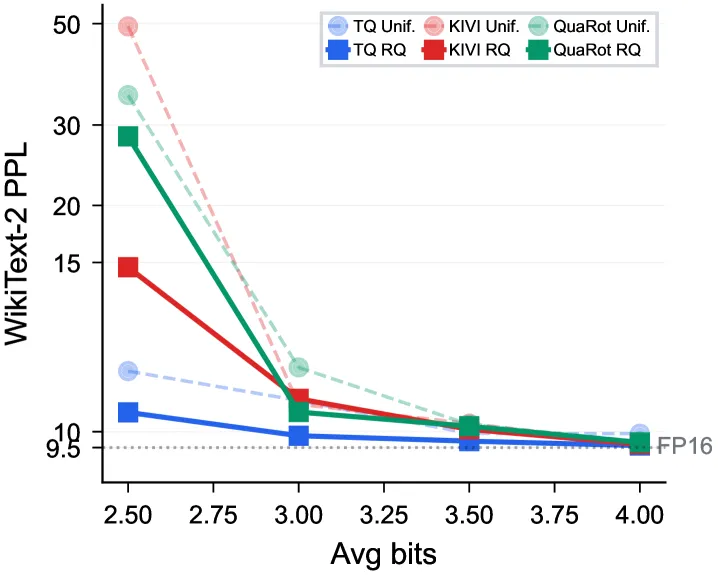
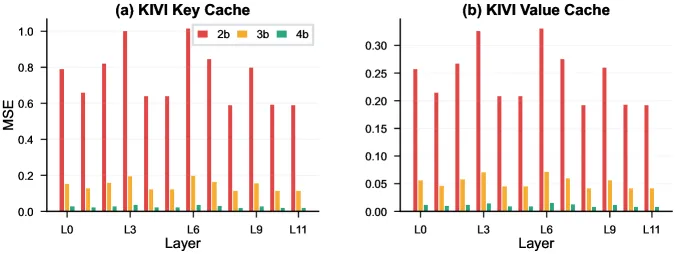
图 6:KIVI key cache 失真远高于 value cache(~4× MSE),驱动 K/V 拆分(2.85/2.15 @ 2.5bit)。
5.3 Sensitivity proxy 消融(Qwen3-8B, )
| Uniform | Gradient | Activation | Swing | |
|---|---|---|---|---|
| 3.5 | 9.95 | 9.76 (+0.19) | 10.83 (−0.88) | 1.07 |
| 4.0 | 9.94 | 9.59 (+0.35) | 10.02 (−0.08) | 0.43 |
| 4.5 | 9.62 | 9.58 (+0.05) | 9.85 (−0.22) | 0.27 |
3.5bit 处 swing 1.07 PPL 超过 uniform→FP16 的 gap,说明 proxy 选择比分配算法更关键。梯度型呈 U 形(早/晚层敏感),activation-based 单调递增(图 4)。
5.4 下游 & 吞吐(Qwen3-8B @ 4.0 bit, TurboQuant)
| 指标 | FP16 | Uniform | RateQuant |
|---|---|---|---|
| ARC-C | 55.8 | 52.5 | 54.1 |
| HellaSwag | 57.1 | 55.2 | 56.6 |
| PIQA | 76.9 | 74.4 | 76.4 |
| WinoGrande | 67.6 | 66.9 | 69.5 |
| Avg | 64.4 | 62.2 | 64.2 (恢复 89.8% gap) |
| tok/s | 37.7 | 38.1 | 38.0 |
吞吐等价(38.0 vs 38.1 tok/s),推理零开销。
5.5 与 mixed-precision 基线对比(KIVI 2.5bit)
- Layer-level 方法:PPL ↓ ~25%;
- 全局 K>V split:↓ 37%;
- RateQuant:↓ 70%。
六、总结
核心贡献
- 首次把 mixed-precision KV cache 分配放入率失真理论框架,reverse waterfilling 给出最优解与 gain ratio;
- 识别并解决 distortion model mismatch——per-quantizer 校准是必需的;
- Separate K/V allocation 把 K/V 视为 独立组件,为不同 schema(per-channel key vs per-token value)差异化预算;
- 校准仅 1.6s(Qwen3-8B on H200),推理零开销, 提供先验收益预测器。
技术影响
- KIVI 2.5bit PPL 从 49.3 → 14.9(−70%),QuaRot 2.5bit −6.6 PPL;
- Qwen3-8B @ 4.0bit 达到 FP16 89.8% 精度差恢复率、平价吞吐;
- 为长上下文 / 高 batch 服务提供了理论基础扎实、部署零成本的 KV 压缩层;
- 建立”AM/GM 预测 mixed-precision 是否值得做”的通用判据。
局限性
- 静态 per-head 分配,未捕获 input-dependent sensitivity 变化(长上下文里可能进一步波动);
- 时头room 快速消失,主要收益在激进 bit 区间();
- 需要基础 quantizer 支持 per-head 或 per-group bit-width(非所有工程实现都开放此接口);
- 未与 KV eviction / token merging 等 orthogonal 压缩协同评测。
七、参考资源
- 论文原文:https://arxiv.org/abs/2605.06675
- HTML 版本:https://arxiv.org/html/2605.06675v1
- 相关工作:KIVI (Liu 2024)、QuaRot (Ashkboos 2024)、TurboQuant、KVQuant (Hooper 2024)、HAWQ (Dong 2019)、Cover & Thomas Elements of Information Theory(reverse waterfilling)