Federation of Experts: Communication Efficient Distributed Inference for Large Language Models
通过将 MoE 架构重构为多个独立的专家集群,消除 all-to-all 通信瓶颈,实现高效的分布式推理
Federation of Experts: Communication Efficient Distributed Inference for Large Language Models
论文信息: arXiv:2605.06206 [cs.LG] 7 May 2026
作者: Muhammad Shahir Abdurrahman, Chun Deng, Azalia Mirhoseini, Philip Levis
机构: Stanford University
许可: arXiv 非独占分发许可
一、论文概述
1.1 研究背景
混合专家(MoE)已成为使大语言模型(LLM)计算高效的首要机制。然而,在分布式设置中,专家之间的 token 嵌入通信是一个显著瓶颈。标准 MoE 的 all-to-all 通信在分布式推理中占端到端延迟的 68% 以上。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 通信瓶颈 | All-to-all 通信占端到端延迟 68%+ |
| 扩展性问题 | 随 GPU 数量增加,通信开销恶化 |
| 跨节点差距 | NVLink (900 GB/s) vs InfiniBand (400 Gb/s),差距 18x |
| 本地激活率下降 | 标准 MoE 随集群增大,LAR 降低 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| FoE 架构 | 将 MoE 重构为多个独立的专家集群 |
| 消除 all-to-all | 单节点设置完全消除 all-to-all 通信 |
| 本地激活率保证 | 通过设计保证高 LAR |
| 显著性能提升 | 端到端延迟降低 5.2x,TTFT 降低 3.62x |
二、核心思想
2.1 问题定义
在标准 MoE 架构中,当 token 被路由到位于不同 GPU 上的专家时,必须通过网络进行调度,依赖昂贵的带宽受限通信原语。随着 GPU 数量增加,这个问题更加严重。
标准 MoE vs Federation of Experts:
| 特性 | 标准 MoE | Federation of Experts |
|---|---|---|
| 专家分组 | 全局单一组 | H 个独立组 |
| 路由方式 | 全局 top-k | 每组 top-k/H |
| 通信模式 | 全局 all-to-all | 组内 all-to-all + 组间 all-reduce |
| 本地激活率 | 随集群增大降低 | 通过设计保证高 LAR |
2.2 解决方案概述
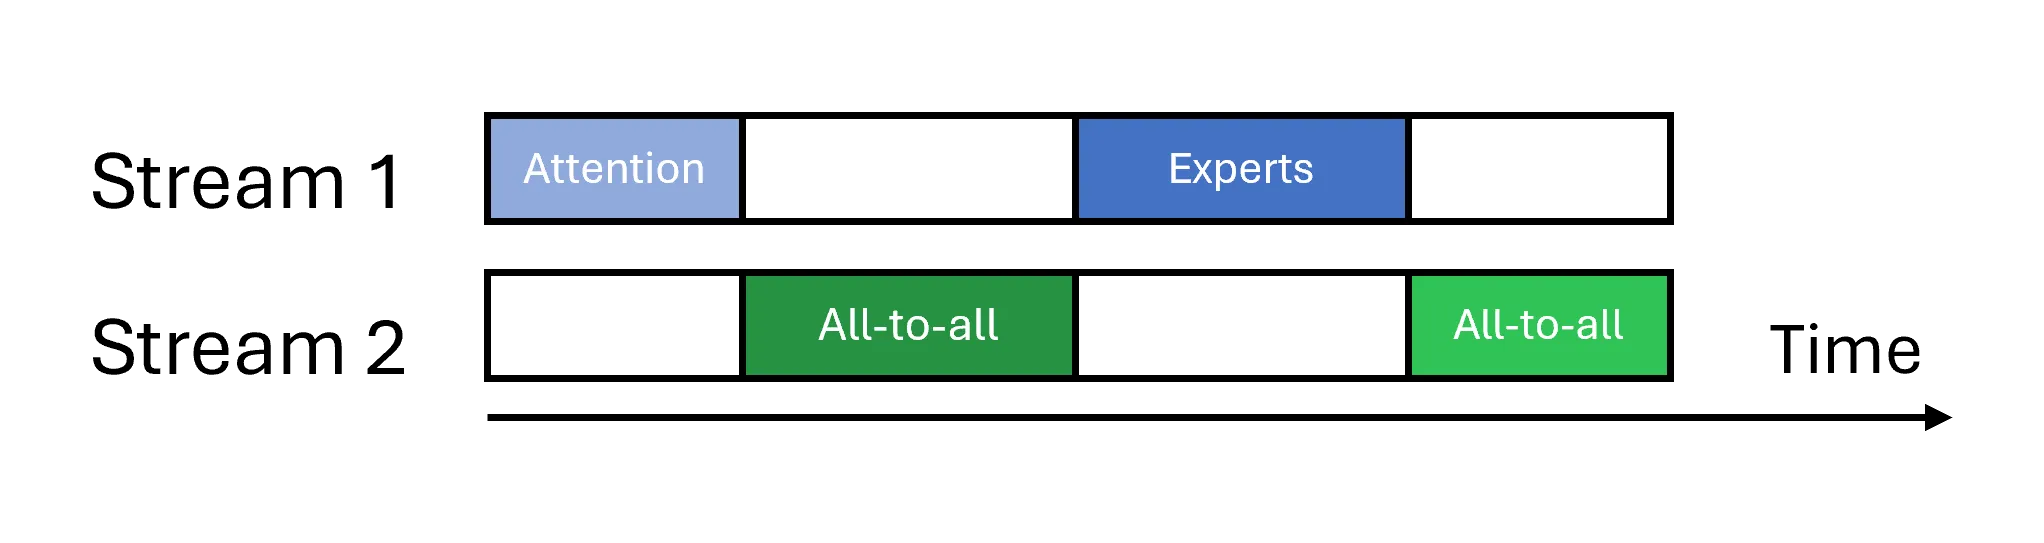 图 1(a):标准 MoE 时间线
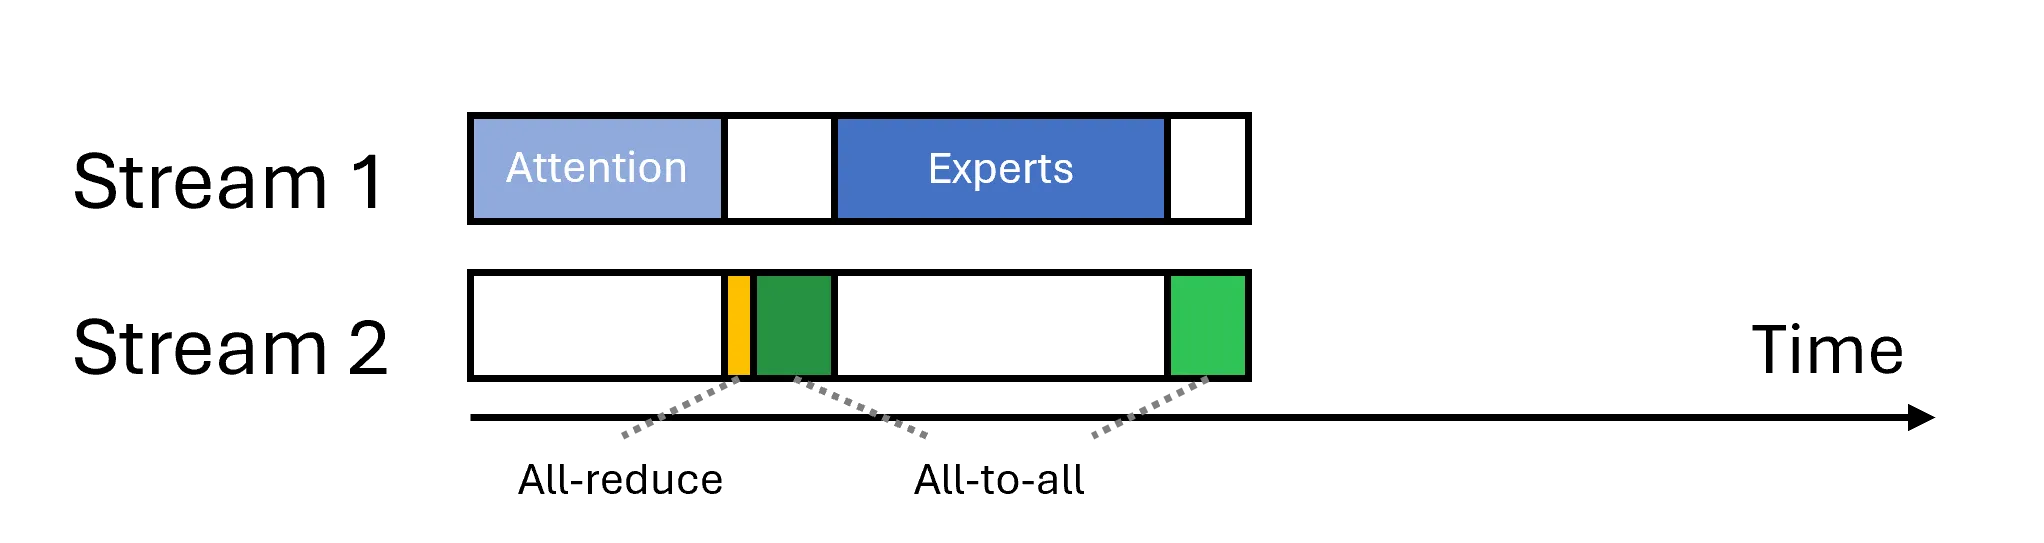 图 1(b):FoE 时间线,将 all-to-all 通信限制在本地集群内
FoE 的核心思想:
- 重构专家分组:将单一全局 MoE 块重构为 H 个独立的专家组
- 每组路由:每个 token 从每个组选择 k/H 个专家
- 组内通信:dispatch 和 combine all-to-all 严格限制在组内
- 组间同步:通过轻量级 cross-group all-reduce 同步后注意力残差
三、技术架构
3.1 架构对比
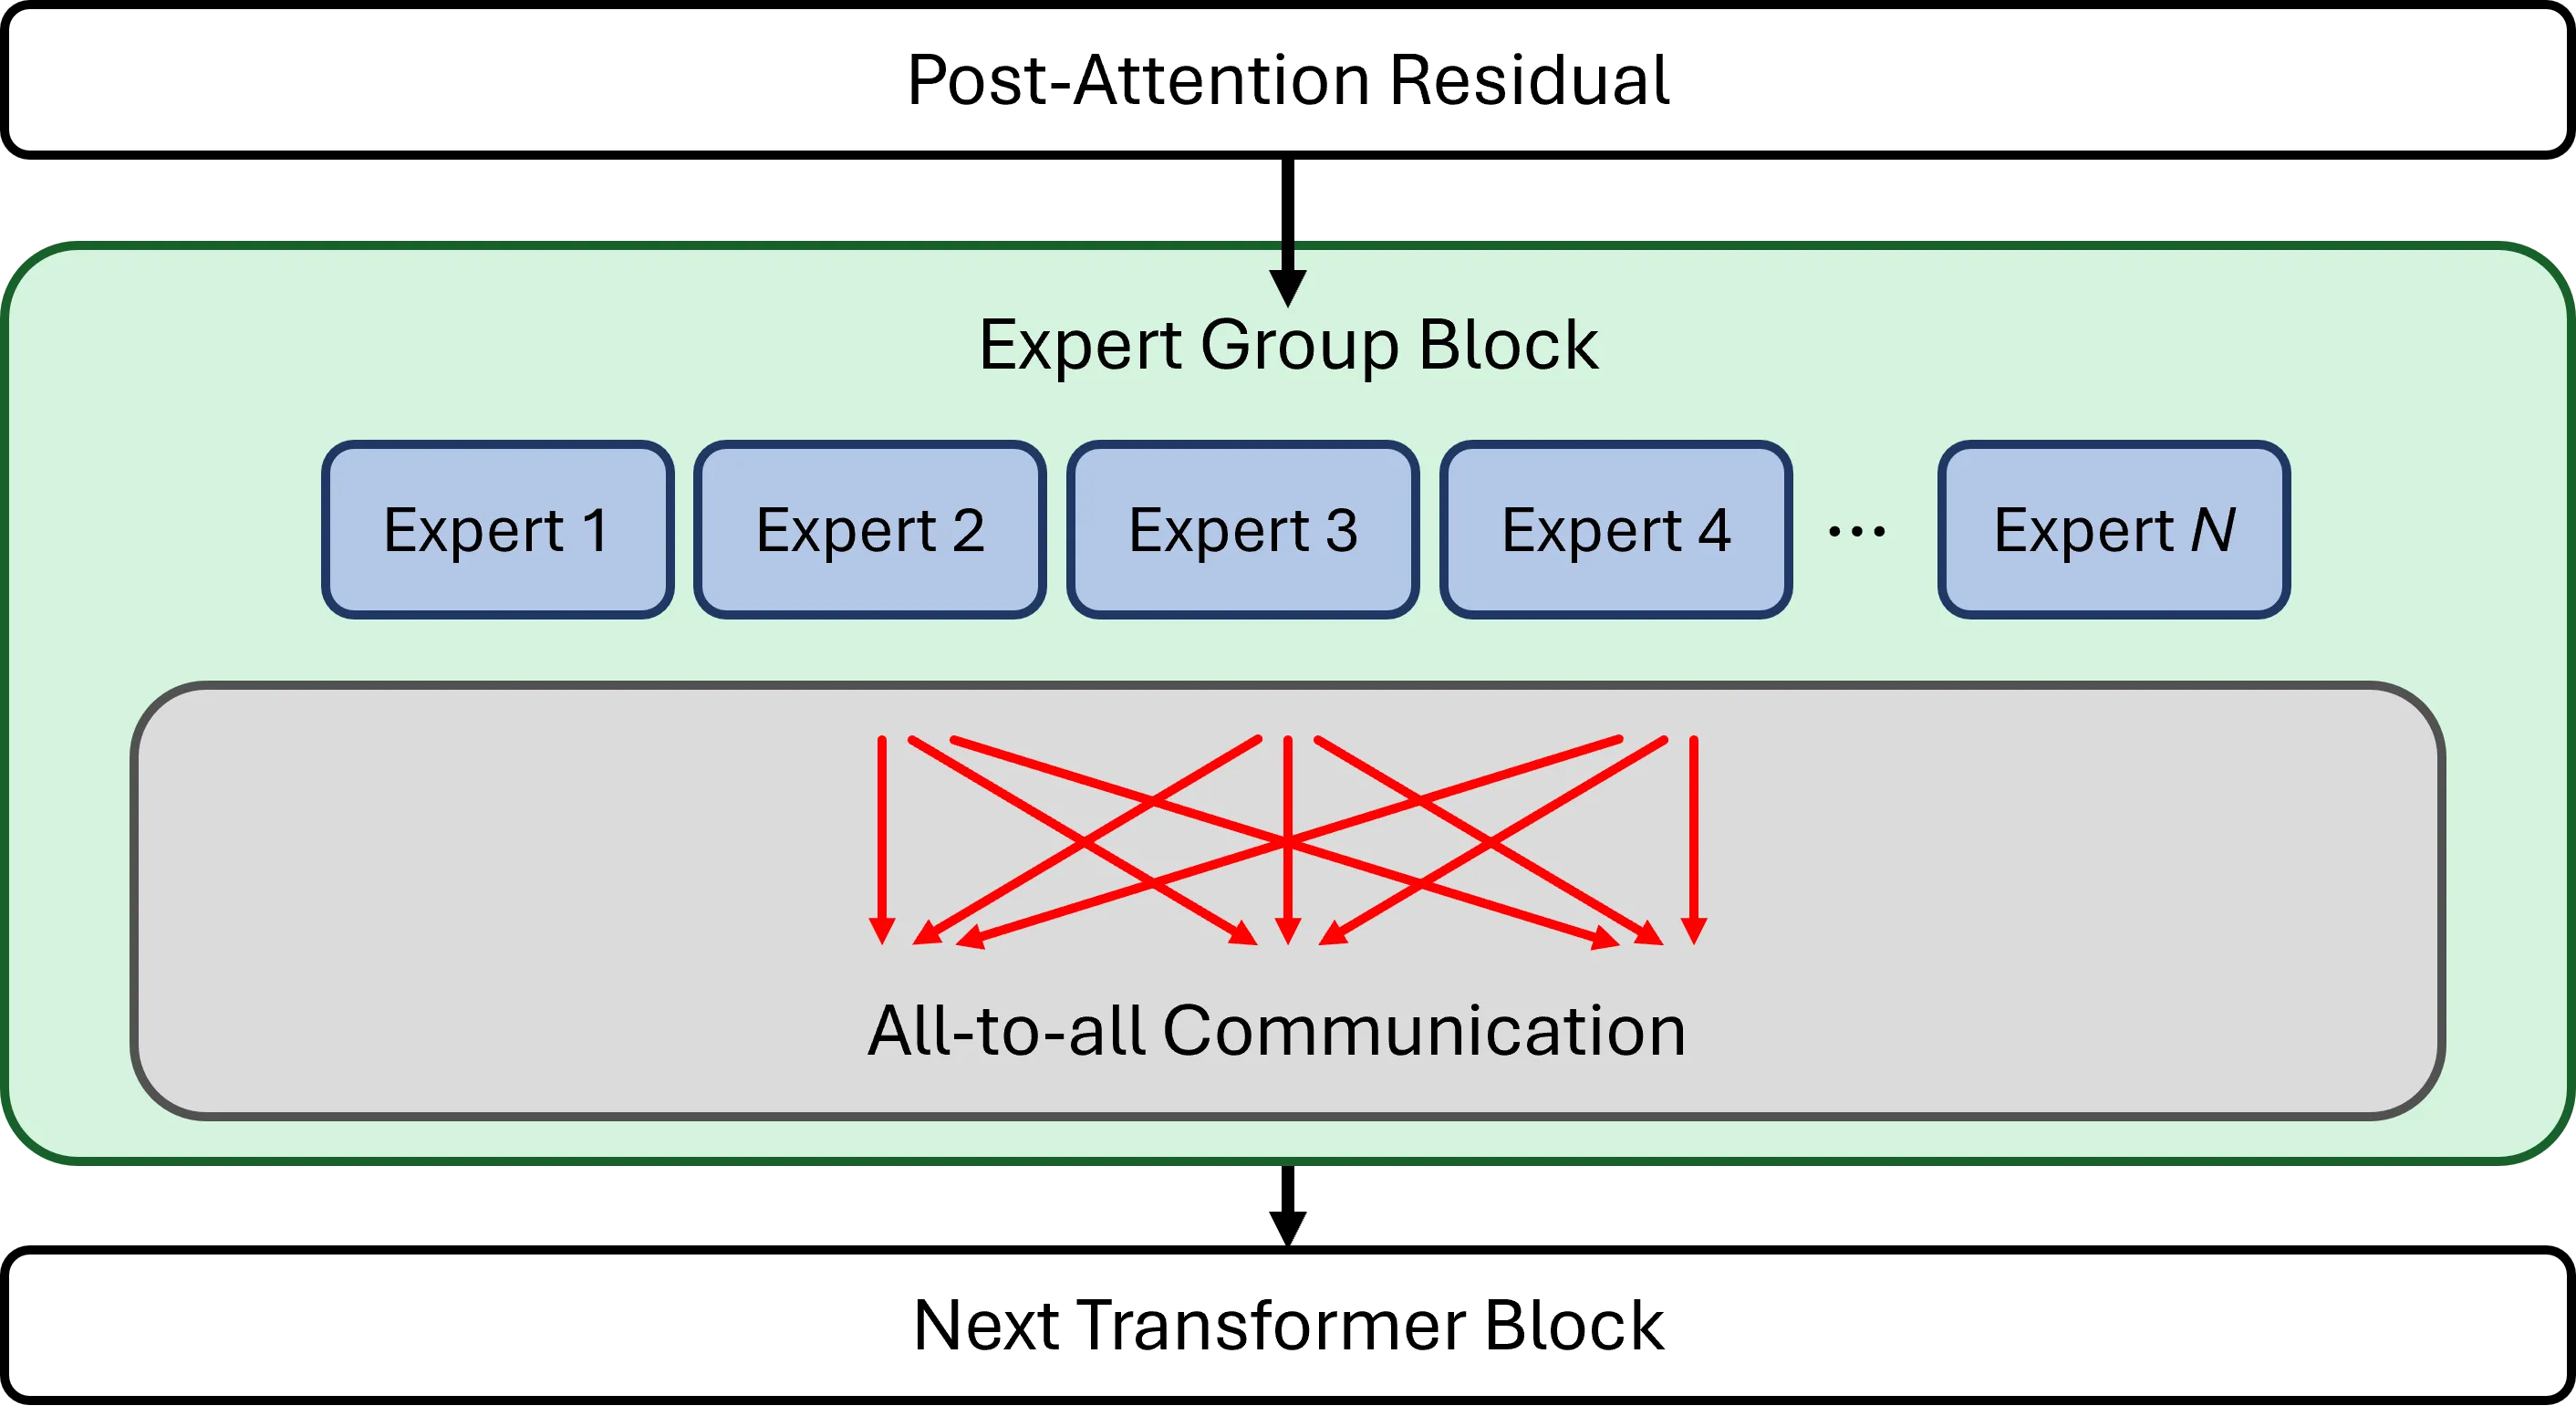 图 2(a):标准 MoE 架构,全局 all-to-all 通信
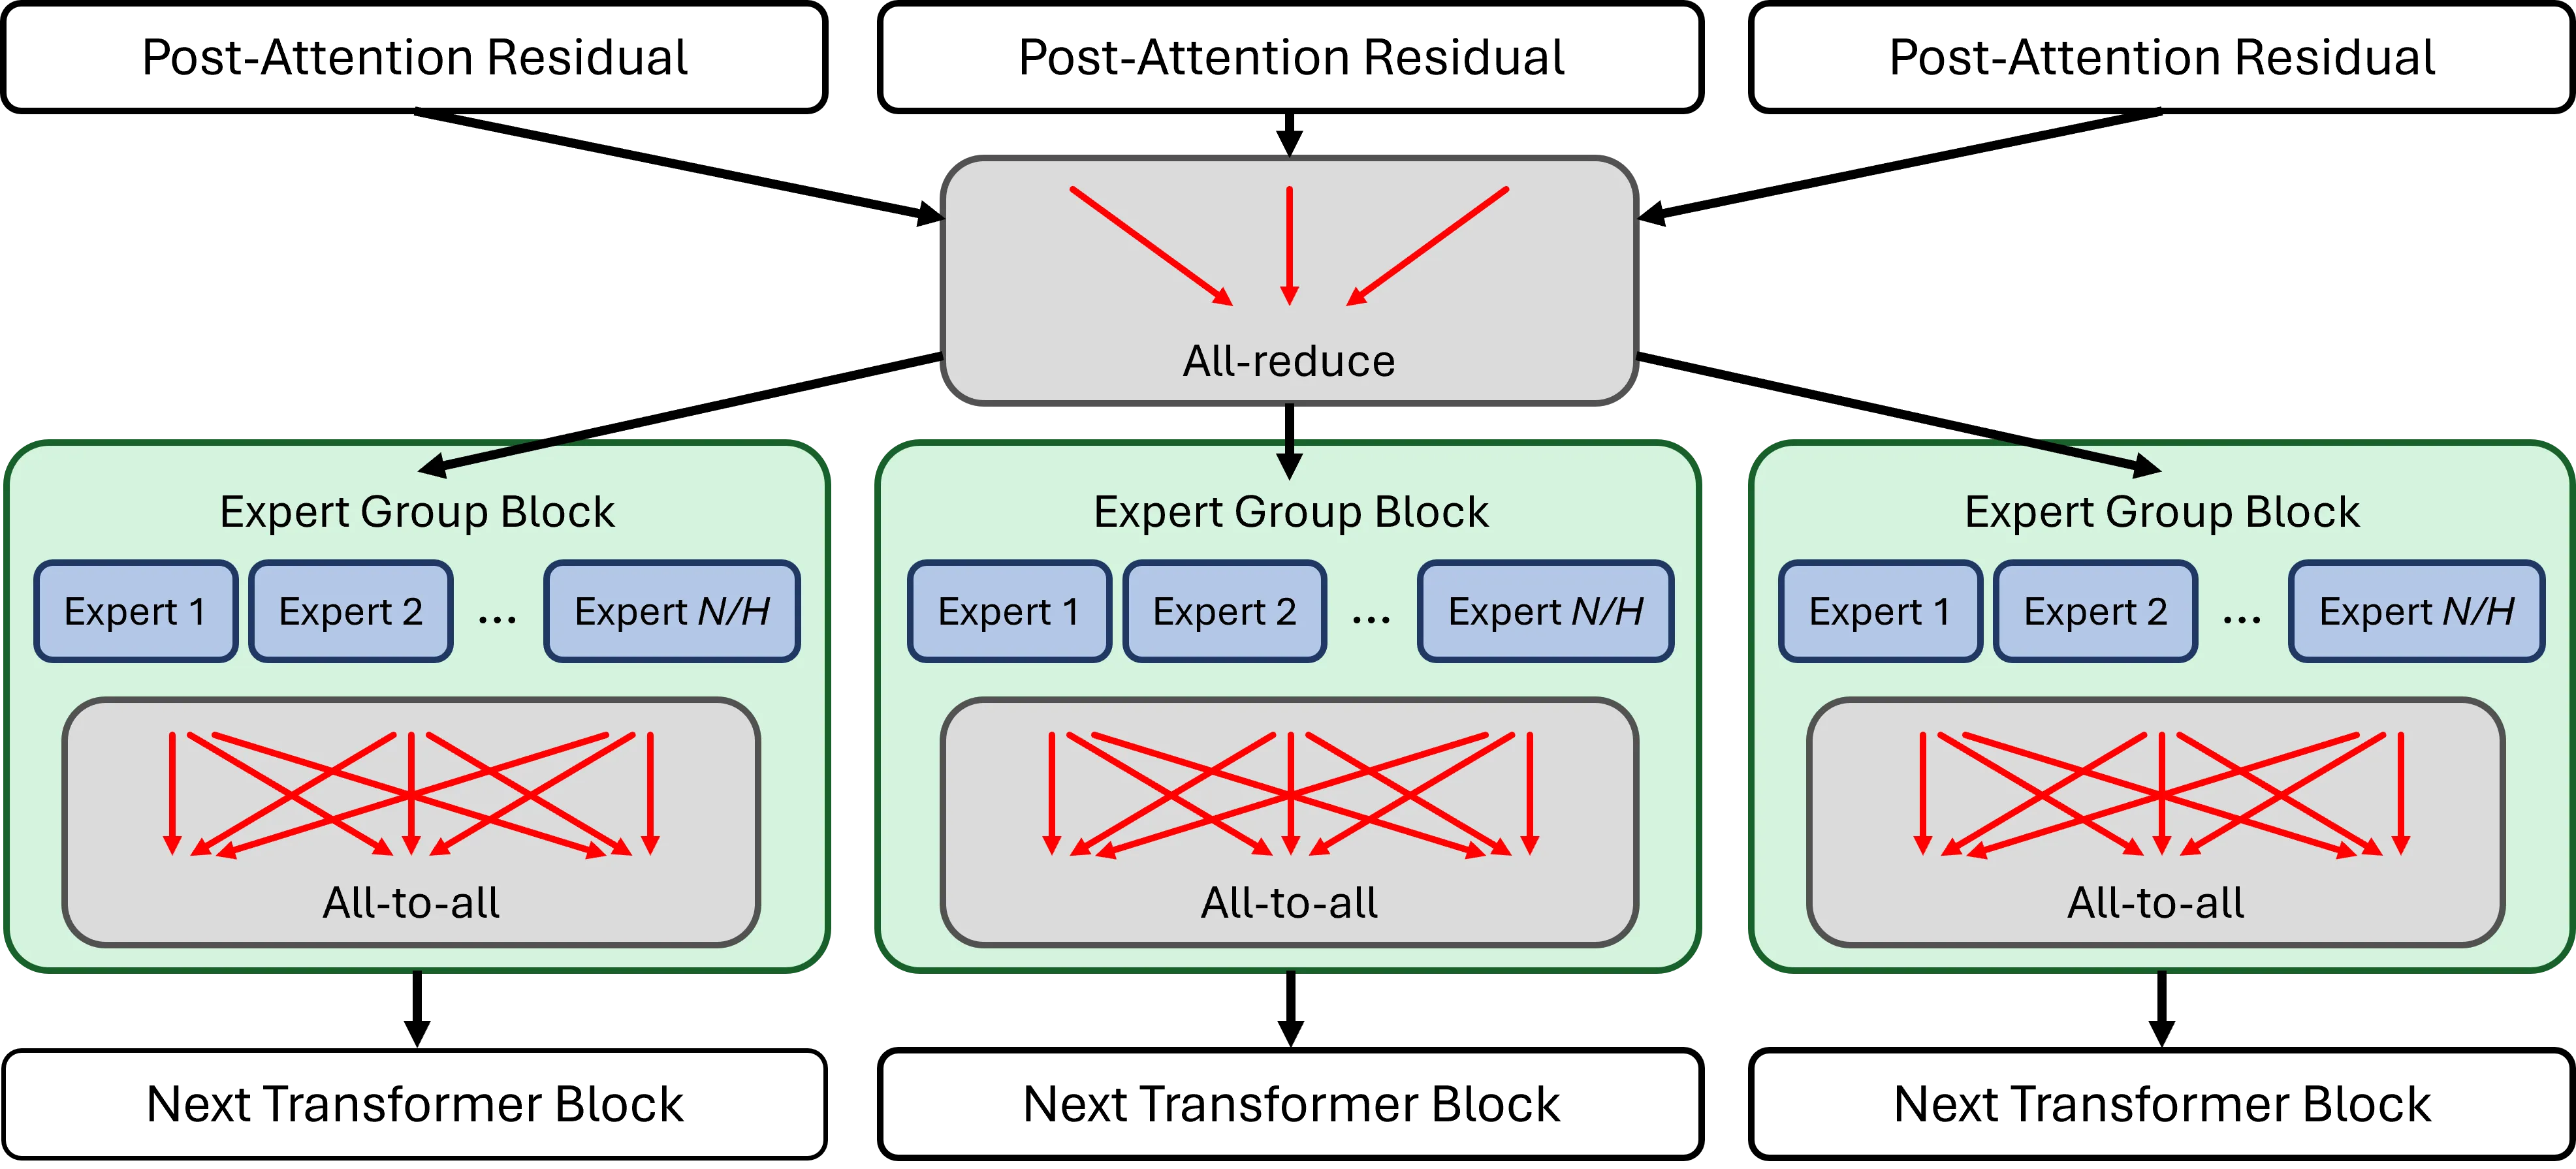 图 2(b):FoE 架构,组内 all-to-all + 组间 all-reduce
架构组件:
| 组件 | MoE | FoE |
|---|---|---|
| KV 头 | 全局共享 | 每组 1/H |
| 专家 | 全局分布 | 每组 1/H |
| GPU | 全局分布 | 每组 1/H |
| 路由 | 全局 top-k | 每组 top-k/H |
| 通信 | 全局 all-to-all | 组内 all-to-all + 组间 all-reduce |
3.2 核心公式
本地激活率(LAR):
标准 MoE 的可行性条件:
其中 是 top-k 专家数, 是总专家数, 是 GPU 数。
FoE 的可行性条件:
FoE 将条件放宽了 倍。
通信量对比:
| 部署 | MoE | FoE |
|---|---|---|
| 单节点 | ||
| 多节点 |
其中 是节点内/节点间带宽比。
3.3 符号说明
| 符号 | 含义 |
|---|---|
| 部署中的总 GPU 数 | |
| 节点数,每节点 GPU 数 | |
| FoE 中的专家组数(等于模型 KV 头数) | |
| MoE 层数,总路由专家数,每 token top-k 数 | |
| 批大小中的 token 数,隐藏维度 | |
| 本地激活率 |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 架构重构 | 将 MoE 重构为多个独立集群 | 理论分析 + 实验验证 |
| LAR 保证 | 通过设计保证高本地激活率 | 数学推导 + 实验验证 |
| 通信优化 | 消除跨节点 all-to-all | 通信量分析 + 实验验证 |
| 无质量损失 | 保持与 MoE 相同的生成质量 | 训练曲线 + 零样本评估 |
4.2 技术细节
训练收敛性验证:
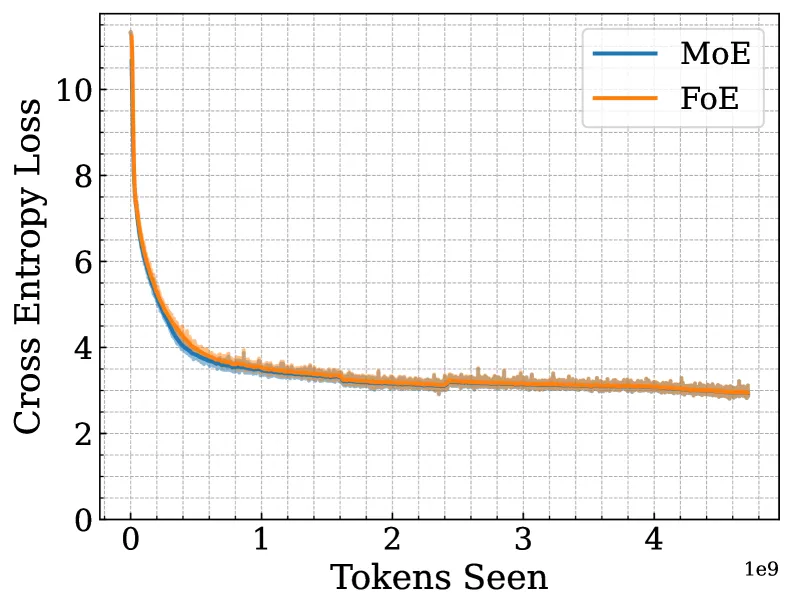 图 3(a):1B 模型训练损失
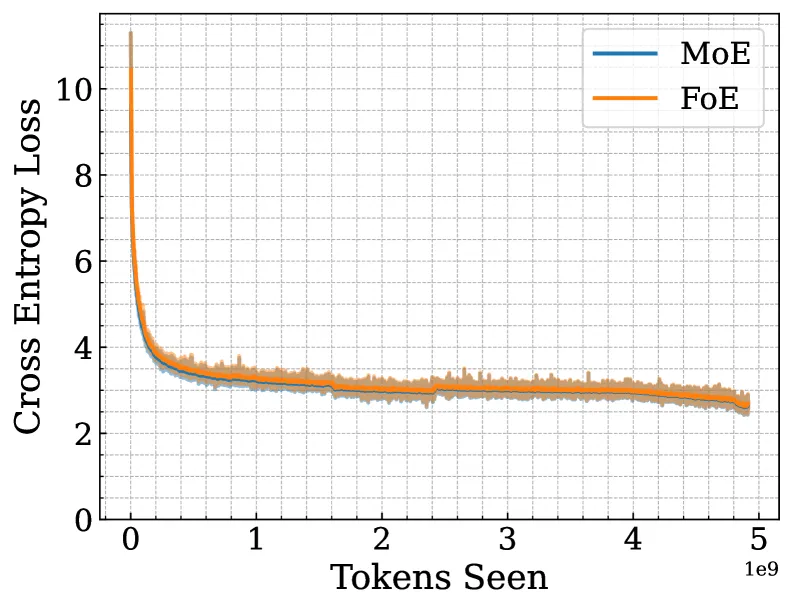 图 3(b):7B 模型训练损失
关键发现:
- 1B FoE 和 MoE 曲线在 Chinchilla 级训练结束时不可区分
- 7B 模型训练到活跃参数的 5x
- 证实 FoE 的局部路由约束保持与 MoE 相同的收敛轨迹
五、代码实现分析
5.1 实现概览
| 组件 | 说明 |
|---|---|
| FlexServe | 基于 FlexAttention 的 MoE 推理引擎 |
| PagedAttention | 内存优化的注意力实现 |
| Chunked Prefill | 分块预填充优化 |
| Data Parallelism | 数据并行支持 |
| Pipeline Parallelism | 流水线并行支持 |
5.2 部署架构
- 单节点:8x NVIDIA H100 (SXM, HBM3) 80GB
- 多节点:2 个 8-GPU 服务器,通过 InfiniBand 连接
- 框架:FlexServe(即将开源)
六、实验结果
6.1 单节点推理性能
| 指标 | MoE | FoE | 提升 |
|---|---|---|---|
| TTFT (均值) | 基线 | -3.1x | 3.1x 加速 |
| TTFT (p99) | 基线 | 显著降低 | 尾延迟优化 |
| TBT | 基线 | -1.95x | 1.95x 加速 |
| E2E 延迟 | 基线 | -5.2x | 5.2x 加速 |
6.2 多节点推理性能
关键发现:
- 本地激活率显著提高
- GPU 负载均衡率改善
- 跨节点通信减少
6.3 通信跟踪对比
 图 5:标准 MoE 单层通信跟踪
 图 6:FoE 单层通信跟踪,通信开销显著减少
6.4 生成质量
零样本推理准确率:
| 基准 | MoE | FoE |
|---|---|---|
| GSM8K | 基线 | 相当 |
| MATH | 基线 | 相当 |
| HellaSwag | 基线 | 相当 |
| ARC | 基线 | 相当 |
关键发现:
- FoE 在所有基准测试中保持与 MoE 相当的生成质量
- 证实局部路由约束不影响模型性能
七、相关工作
7.1 MoE 优化方法
| 方法 | 类型 | 特点 |
|---|---|---|
| Expert Parallelism | 通信优化 | 标准 all-to-all 调度 |
| MoETuner | 调度优化 | 预测 token-expert 调度 |
| Sem-MoE | 调度优化 | 语义感知调度 |
| FoE | 架构优化 | 结构性消除跨节点通信 |
7.2 技术差异
| 特性 | 传统方法 | FoE |
|---|---|---|
| 优化层面 | 系统/调度 | 架构 |
| 通信模式 | 全局 all-to-all | 组内 all-to-all |
| LAR 保证 | 无 | 有 |
| 跨节点通信 | 存在 | 消除 |
八、总结
8.1 核心贡献
- FoE 架构:将 MoE 重构为多个独立的专家集群
- 通信优化:单节点完全消除 all-to-all,多节点限制在节点内
- LAR 保证:通过设计保证高本地激活率
- 性能提升:端到端延迟降低 5.2x,TTFT 降低 3.62x
- 无质量损失:保持与 MoE 相同的生成质量
8.2 技术影响
- 推理效率:显著提高分布式 LLM 推理效率
- 通信成本:降低跨节点通信成本
- 扩展性:支持更大规模的分布式部署
- 实用性:适用于实际生产环境
8.3 局限性
- 架构依赖:需要修改模型架构
- KV 头数限制:H 必须等于 KV 头数
- 训练开销:需要从头预训练
- 硬件要求:需要高带宽节点内互联
九、参考资源
9.1 论文链接
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | MoE vs FoE 时间线对比 | figure-1-moe-timing.png, figure-1-foe-timing.png |
| 图 2 | MoE vs FoE 架构对比 | figure-2-moe-diagram.png, figure-2-foe-diagram.png |
| 图 3 | 训练损失曲线 | figure-3-training-loss-1b.png, figure-3-training-loss-7b.png |
| 图 5 | MoE 通信跟踪 | figure-5-moe-trace.png |
| 图 6 | FoE 通信跟踪 | figure-6-foe-trace.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Switch Transformers | Fedus et al. | 2022 | MoE 基础 |
| DeepSeek V3 | DeepSeek AI | 2024 | 大规模 MoE 部署 |
| vLLM | Kwon et al. | 2023 | 推理引擎 |
| SGLang | Zheng et al. | 2024 | 推理引擎 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 混合专家 | Mixture of Experts (MoE) | 稀疏激活的专家网络 |
| 专家并行 | Expert Parallelism | 专家分布在多个 GPU |
| 本地激活率 | Local Activation Rate (LAR) | 本地解析的专家选择比例 |
| All-to-all | All-to-all | 全对全通信原语 |
| 时间到首个 token | Time to First Token (TTFT) | 首个 token 生成延迟 |
| token 间时间 | Time Between Tokens (TBT) | 相邻 token 生成间隔 |
分析完成时间:2026年6月22日 分析工具:Claude Code + paper-analyzer skill + agent-browser