JoyAI-Image: Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation
统一多模态基础模型,融合空间增强 MLLM 与 MMDiT,实现理解/生成/编辑一体化,支持空间推理
JoyAI-Image: Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | JoyAI-Image: Awaking Spatial Intelligence in Unified Multimodal Understanding and Generation |
| 作者 | Lin Song, Wenbo Li, Guoqing Ma, Wei Tang, Bo Wang, Yuan Zhang, Yijun Yang, Yicheng Xiao, Jianhui Liu, Yanbing Zhang, Guohui Zhang, Wenhu Zhang, Hang Xu, Nan Jiang, Xin Han, Haoze Sun, Maoquan Zhang 等 |
| 机构 | 京东探索研究院 (JD AI Research) |
| 论文 | arXiv:2605.04128 |
| 代码 | github.com/jd-opensource/JoyAI-Image |
| 发布 | 2026-05-05 (v1), 2026-05-20 (v2) |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
当前统一多模态模型面临两大核心挑战:
- 理解-生成交互弱:视觉理解未充分利用来指导生成和编辑,生成变换也很少为感知和推理提供反馈
- 缺乏空间智能:现有模型缺乏对物理世界的强空间理解能力,无法处理物体布局、相对几何、相机视角等空间属性
核心需求:构建一个真正理解 3D 空间结构的统一视觉基础模型,实现理解、生成、编辑的双向增强。
解决方案概述
JoyAI-Image 提出了一个空间增强的统一多模态框架,核心创新包括:
- 空间增强 MLLM:基于 Qwen3-VL-8B 构建,通过 OpenSpatial 引擎和 3M 数据增强空间推理能力
- 统一 MMDiT 架构:16B 参数的多模态扩散 Transformer,同时处理理解和生成
- Thinking with Novel Views (TwNV):利用生成的新视角增强空间推理,形成理解-生成-推理闭环
三、技术架构
整体框架图
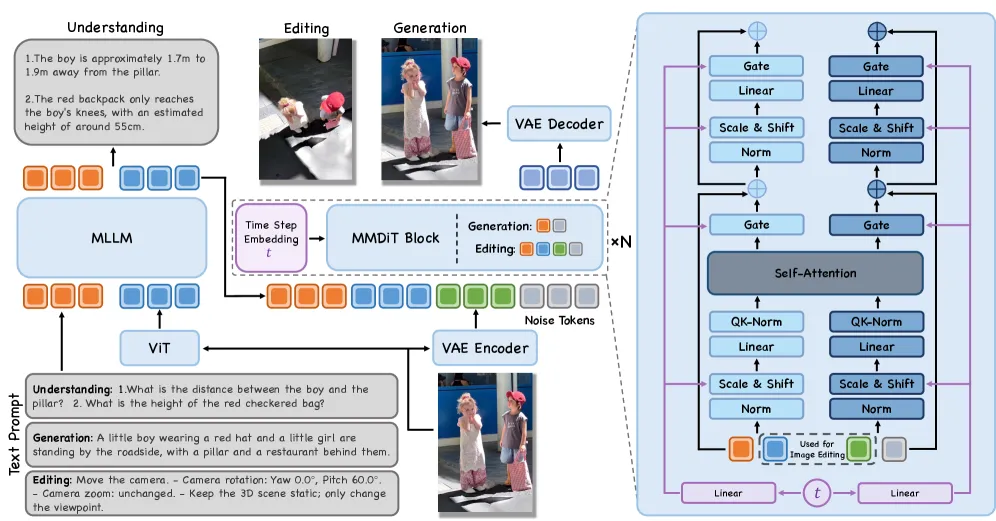
JoyAI-Image 的架构遵循三阶段流程:
JoyAI-Image Architecture
├── Stage 1: Multimodal Understanding (MLLM)
│   ├── Input: Image + Text
│   ├── Base: Qwen3-VL-8B-Instruct
│   ├── Enhancement: OpenSpatial (3M QA pairs)
│   └── Output: Semantic representations
├── Stage 2: Latent Encoding (VAE)
│   ├── Model: Wan-2.1-VAE
│   ├── Type: Causal 3D convolutions
│   └── Output: Compact latent representations
└── Stage 3: Conditional Generation (MMDiT)
    ├── Parameters: 16B
    ├── Architecture: Dual-stream diffusion
    ├── Input: MLLM priors + Noise
    └── Output: Generated/Edited images
核心组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| MLLM | 空间增强的多模态大语言模型 | Qwen3-VL-8B, OpenSpatial-3M 数据 |
| VAE | 潜在编码器 | Wan-2.1-VAE, 因果 3D 卷积 |
| MMDiT | 多模态扩散 Transformer | 16B 参数, 40 层, 4096 维 |
| OpenSpatial | 空间数据引擎 | 3M QA pairs, 5 类空间能力 |
MMDiT 超参数
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| Input/Output Dim | 16 | Attention Heads | 32 |
| Patch Size | 1×2×2 | Modulation Type | WanX |
| Number of Layers | 40 | Position Embedding | MRoPE |
| Hidden Dim | 4096 | RoPE Base θ | 10,000 |
| Text Hidden Dim | 4096 | RoPE Dim List | [16, 56, 56] |
核心公式
Flow Matching 目标函数:
其中:
- :图像潜在表示(通过 WanVAE 编码)
- :高斯噪声
- :线性插值
- :文本条件
空间理解训练目标:
其中 是层平均 KL 散度,仅应用于通用数据集以保留预训练能力。
OpenSpatial 数据引擎
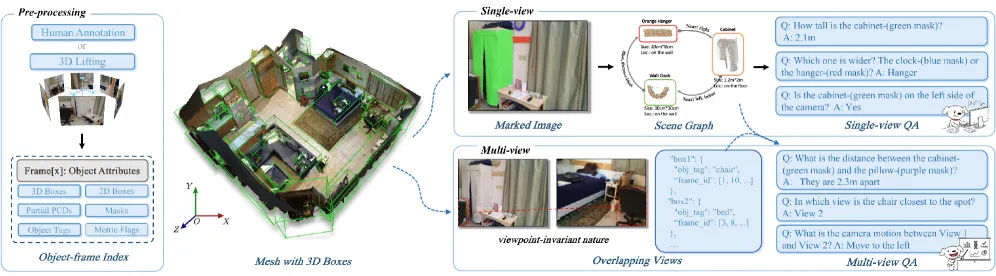
OpenSpatial 是一个自动化数据合成引擎,核心特点:
- 3D 升级机制:将网络视频转换为高保真 3D 训练数据
- 5 类空间能力:空间测量 (SM)、空间关系 (SR)、相机感知 (CP)、多视图一致性 (MC)、场景感知推理 (SAR)
- 19 个子任务:覆盖完整的空间理解能力谱
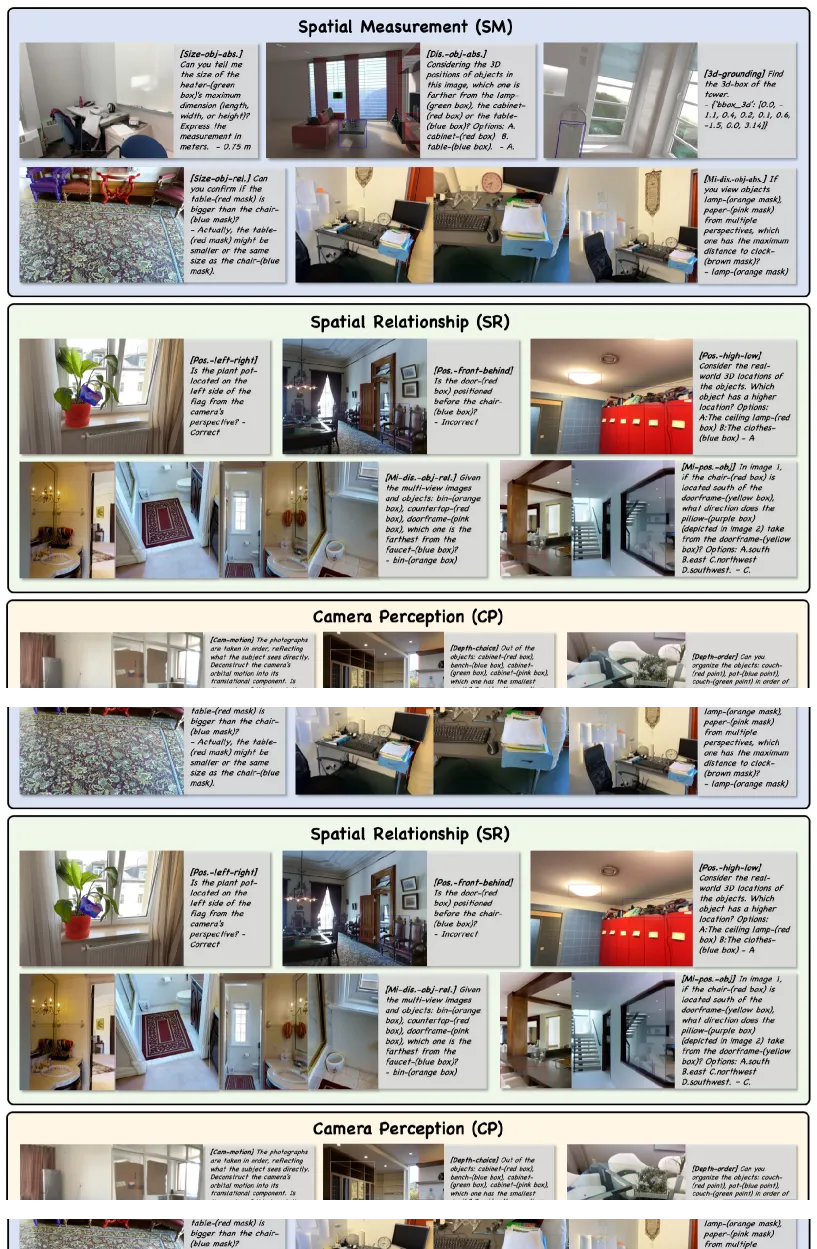
OpenSpatial-3M 数据集:300 万条空间理解样本,来源于:
- 3D 室内扫描(ScanNet, Matterport3D, ARKitScenes, ScanNet++, Hypersim)
- 网络视频的 3D 升级
- 合成渲染数据
空间理解训练
训练策略:
- 基于 Qwen3-VL-8B-Instruct 全参数微调
- 动态序列打包:减少 padding 浪费
- 解耦学习率:视觉编码器较小更新率
- 在线知识蒸馏:保留预训练能力
三层评估体系:
- Level 1: 2D 语义感知(MMBench, MMStar, OCRB, MathVista)
- Level 2: 3D 空间理解(BLINK, CV-3D, 3DSR, MMSI, RealWorldQA)
- Level 3: 4D 时空推理(VSI-Bench, AllAnglesBench)
图像生成
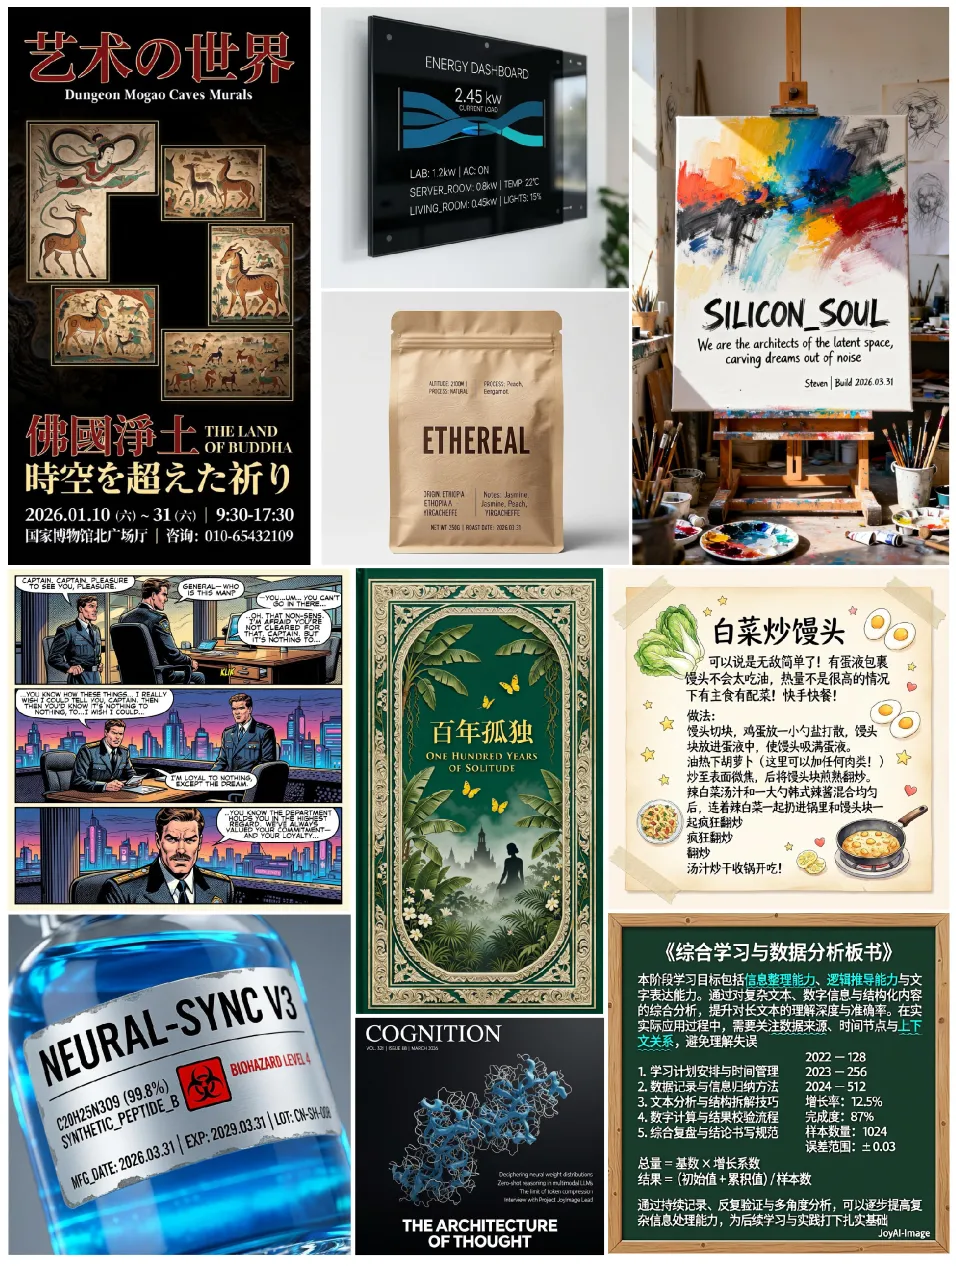
数据处理流程:
- 数据过滤:多阶段质量过滤,逐步提高准入阈值
- 图像描述:多级文本描述生成
- 分布重平衡:基于语义分类纠正长尾分布偏差
- 人工标注:细粒度质量标准
- 多视图生成:百万级 Blender 渲染多视图语料
预训练阶段:
- 低分辨率 (208P) → 中分辨率 (512P) → 高分辨率 (1024P)
- 高分辨率阶段引入多视图数据支持空间编辑
图像编辑
JoyAI-Image-Edit:
- 基于 MMDiT 架构
- 融合文本条件、源图像条件、噪声潜在输入
- 支持空间编辑:相机变换、几何变换
编辑数据分布:
- 开域编辑:~50%
- 空间编辑:~30%(相机、旋转、物体移动)
- 专业编辑:~20%(文本渲染、IP 保持、局部修改)
Thinking with Novel Views (TwNV)
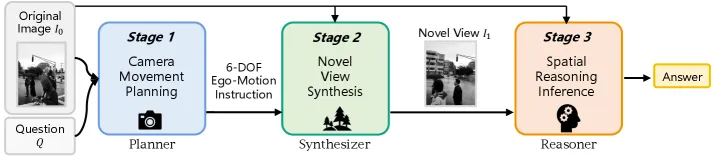
TwNV 是本文的核心创新,形成理解-生成-推理闭环:
TwNV Pipeline:
Input Image I₀ + Spatial Question Q
    ↓
MLLM Planner → 6-DOF Camera Motion Instruction
    ↓
Synthesizer → Novel View I₁
    ↓
MLLM Reasoner → Answer over {I₀, I₁}关键发现:
- JoyAI-Image-Edit 作为 Synthesizer 时,相对提升 4.2%(使用 GPT-5 Reasoner)
- 跨 Reasoner 泛化:对 Qwen3-VL-32B 提升 7.8%
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| OpenSpatial 引擎 | 自动化 3D 空间数据合成,从网络视频生成训练数据 | 3M QA pairs, 19 子任务 |
| 空间增强 MLLM | 通过专用数据和训练增强空间推理能力 | 三层评估体系 |
| 统一 MMDiT | 16B 参数同时处理理解和生成 | 表 1 超参数 |
| TwNV 范式 | 利用生成新视角增强空间推理,形成闭环 | 表 14 提升 4.2-7.8% |
| 双语长文本渲染 | 英文和中文长文本生成均达 0.963 | LongText-Bench 结果 |
五、实验结果
空间理解评估
三层评估结果(部分关键指标):
| 基准测试 | Level | JoyAI-Image | 对比模型 |
|---|---|---|---|
| MMBench | L1 | 竞争力 | SOTA |
| MMStar | L1 | 竞争力 | SOTA |
| BLINK | L2 | 竞争力 | SOTA |
| 3DSR | L2 | 竞争力 | SOTA |
| VSI-Bench | L3 | 竞争力 | SOTA |
| AllAnglesBench | L3 | 竞争力 | SOTA |
图像生成评估
LongText-Bench 结果:
| 模型 | EN | ZH |
|---|---|---|
| JoyAI-Image | 0.963 | 0.963 |
| 对比模型 | 0.8xx | 0.8xx |
关键发现:
- 双语长文本渲染均达 0.963,超越现有方法
- 英文和中文性能一致,无语言差距
图像编辑评估
GEdit 基准:
- 指令遵循:强
- 语义一致性:强
- 内容保持:强
SpatialEdit-Bench:
- 物体中心操作:强
- 相机视角控制:强
人类评估:JoyAI-Image-Edit 在多个编辑维度上超越竞争模型
Thinking with Novel Views 评估
| Editor | Orient. | Loc. | Multi-Obj. | Overall | 相对提升 |
|---|---|---|---|---|---|
| None (w/o NV) | 63.6 | 80.9 | 60.5 | 68.8 | - |
| Qwen-Image-Edit | 61.8 | 77.8 | 61.5 | 67.4 | -2.0% |
| Nano Banana Pro | 60.9 | 83.0 | 63.6 | 69.5 | +1.0% |
| JoyAI-Image-Edit | 65.3 | 82.6 | 66.2 | 71.7 | +4.2% |
六、消融实验
空间训练消融
- OpenSpatial-3M 数据显著提升空间理解能力
- 知识蒸馏保留预训练能力
- 解耦学习率优化训练稳定性
编辑数据消融
- 空间编辑数据占比 ~30% 提升几何变换能力
- 开域编辑数据保持通用编辑能力
- 专业编辑数据处理长尾场景
七、相关工作
| 工作 | 关系 | 差异 |
|---|---|---|
| Qwen-Image | 基础 MLLM | JoyAI-Image 增强空间能力 |
| FLUX | 扩散模型 | JoyAI-Image 统一理解-生成 |
| InstructPix2Pix | 编辑模型 | JoyAI-Image 支持空间编辑 |
| ScanNet | 3D 数据 | JoyAI-Image 从 2D 视频合成 3D 数据 |
八、总结
核心贡献
- OpenSpatial 引擎:自动化 3D 空间数据合成,从网络视频生成 3M 训练数据
- 空间增强 MLLM:通过专用数据和训练增强空间推理能力
- 统一 MMDiT 架构:16B 参数同时处理理解和生成
- TwNV 范式:利用生成新视角增强空间推理,形成理解-生成-推理闭环
- 双语长文本渲染:英文和中文均达 0.963
- 开源:提供代码和模型检查点
技术影响
- 空间智能:为统一视觉模型注入空间理解能力
- 闭环推理:理解-生成-推理的双向增强
- 下游应用:视觉-语言-动作系统、机器人、世界模型
- 多模态统一:推动从通用能力到空间智能的演进
局限性
- 计算成本:16B MMDiT 需要大量计算资源
- 3D 数据依赖:OpenSpatial 引擎依赖 3D 扫描数据
- 编辑质量:复杂场景编辑仍有提升空间
- 推理速度:扩散模型生成速度较慢
九、参考资源
- 论文: arXiv:2605.04128
- 代码: github.com/jd-opensource/JoyAI-Image
- 相关模型:
- Qwen3-VL - 基础 MLLM
- Wan-2.1-VAE - VAE 编码器
- FLUX - 扩散模型
- 相关数据集:
- ScanNet - 3D 室内扫描
- Matterport3D - 3D 室内场景
- ARKitScenes - AR 场景数据
- 评估基准:
- MMBench - 多模态理解
- LongText-Bench - 长文本生成
- GEdit - 图像编辑
- SpatialEdit-Bench - 空间编辑