SplitZip: Ultra Fast Lossless KV Compression for Disaggregated LLM Serving
面向 prefill-decode 分离式 LLM 服务的 GPU 友好、无损 KV cache 传输压缩器。核心洞见:BF16 KV 激活的冗余集中在指数字段(指数熵仅 2.89-3.59 bit,而 BF16 指数占 8 bit),Top-16 高频指数即覆盖 ≥99.3%。SplitZip 用定长 4-bit 码编码高频指数(两码打包一字节),罕见指数走稀疏 escape 流(位置+原值),符号-尾数原样保留——比特级无损。离线校准 Top-16 码本消除在线直方图;规整稠密路径 + 稀疏 escape 修正使编解码在 GPU 上无分支高效。真实 BF16 激活上达 613.3 GB/s 压缩、2181.8 GB/s 解压(超越所有已测无损压缩器);端到端 BF16 KV 传输加速 1.32×、TTFT 1.30×、请求吞吐 1.23×;同法扩展 FP8 在 E5M2 上再压 1.14×
SplitZip: Ultra Fast Lossless KV Compression for Disaggregated LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SplitZip: Ultra Fast Lossless KV Compression for Disaggregated LLM Serving |
| 作者 | Yipin Guo, Siddharth Joshi |
| 论文 | arXiv:2605.01708(v3,2026-05-03 提交,2026-06-23 修订) |
| 发布 | 2026 年 5 月 3 日(v3 于 6 月 23 日) |
| 领域 | cs.DC(分布式并行计算);cs.AI;cs.LG |
| 性质 | 系统 + 算法(无损 KV cache 传输压缩编解码器) |
| 测试硬件 | NVIDIA H200 GPU + 双路 Intel Xeon Platinum 8468,ConnectX-7 IB/RDMA |
| 测试模型 | Qwen3-32B、Llama-3-8B、Qwen3-30B-A3B 等 6 个模型族 |
| 代码 | 论文声明开源(arXiv 页 “this https URL”) |
二、核心思想
问题定义
Prefill-Decode(PD)分离已成为大规模 LLM 服务的主流设计(vLLM、SGLang、Dynamo 采用):prefill 计算密集、decode 内存带宽密集,分离部署可各自专门化。但其效率取决于 prefill worker 生成的 KV cache 必须传给 decode worker 才能开始生成。当两者跨节点/跨集群部署(因资源隔离、集群管理、弹性伸缩、异构加速器、独立扩缩),传输须经更慢受限的链路——跨集群带宽通常 50-100 GB/s,比机架内 RDMA(400+ GB/s NVLink)低一个数量级。对长输入/agentic 负载(文档级 QA、代码库理解、多文档摘要),prefill 产生的大 KV cache 使传输成为日益严重的瓶颈。
现有方案不适用:
- 有损压缩(剪枝/量化/选择性保留)压缩比高,但改变模型输出、需逐部署验证、误差随 KV token 累积(长上下文/多步推理下恶化);
- 现有无损编解码器主要针对离线权重压缩、跑在 CPU 上、或用变长编码(其压缩速度跟不上 prefill 期的 KV 生产)。
关键洞见
已有工作发现 BF16 模型权重的冗余集中在指数字段、尾数几无可压。本文发现这对激活(含 PD 分离服务中的 KV 张量)同样成立:跨常见 LLM,指数熵仅 3-4 bit(相对 BF16 指数的 8 bit,约有 4 bit 无损压缩空间)。
Huffman 编码虽渐近熵最优,但其变长比特流产生不规则内存访问、映射到 GPU 差;变长码在解码时有顺序依赖限制并行吞吐。SplitZip 改用定长 4-bit 码编码高频指数、罕见值作 escape 存位置+原值——实践中 4-bit 码覆盖约 99%,escape 开销极小,且定长设计天然映射 GPU 并行。
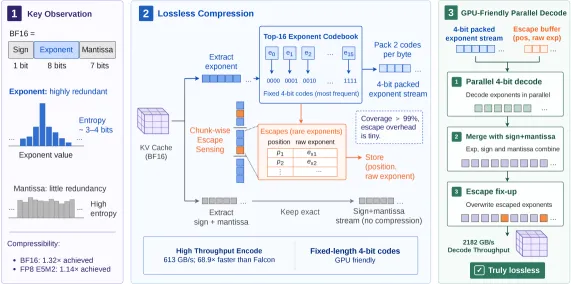
图 1:SplitZip 无损 KV cache 压缩概览。利用 BF16 指数字段冗余、保符号与尾数精确;高频指数用定长 4-bit 码、罕见值存入小 escape 缓冲(位置+原始指数)。此设计支持 GPU 友好并行解码并比特级重建原始 KV cache。
三大贡献
- 刻画 KV 激活冗余:证明权重中的 BF16 指数冗余同样出现在 KV 激活,且跨 6 个模型(稠密/MoE/混合架构)、多个校准数据集、几乎所有 transformer 层一致;
- 在线编解码的 SplitZip:定长编解码器达 613.3 GB/s 编码、2181.8 GB/s 解码(所测无损浮点压缩器中最高),显式 escape 位置虽有小元数据开销,却因无分支 GPU 执行带来 3.5× 更高解码吞吐;
- 生产服务栈端到端验证:集成入 SGLang(基于 Mooncake 传输)——BF16 KV 传输快 1.32×、TTFT 快 1.30×、请求吞吐高 1.23×;FP8 E5M2 上再压 1.14×。
三、方法(§3)
3.1 KV 指数熵(§3.1)
Table 1 刻画多模型族 KV cache 的指数分布:指数熵 2.89-3.59 bit(vs BF16 的 8-bit 指数),分布高度集中——Top-16 指数值覆盖 ≥99.3%(跨稠密/MoE/混合)。Top-8 覆盖从 83.5%(Qwen3-30B-A3B)到 96.0%(Qwen3-Next-80B-A3B)波动,说明 3-bit 码本跨激活分布不够鲁棒,故 SplitZip 用 Top-16 设计。
| 模型 | 族 | Top-8 | Top-16 | 熵 | SplitZip 压缩比 |
|---|---|---|---|---|---|
| Qwen3-30B-A3B | Qwen-MoE | 83.5% | 99.3% | 3.59 b | 1.31× |
| Qwen3-32B | Qwen | 90.1% | 99.8% | 3.29 b | 1.32× |
| Qwen3-Next-80B-A3B | Qwen-Hyper | 96.0% | 99.9% | 2.89 b | 1.33× |
| Llama-3.1-70B | Llama | 89.7% | 99.5% | 3.41 b | 1.32× |
| Llama-3-8B | Llama | 90.9% | 99.6% | 3.30 b | 1.32× |
| Phi-2 | Phi | 92.3% | 99.6% | 3.11 b | 1.32× |
3.2 方法(§3.2)
对 BF16 值(16-bit 整数 ),SplitZip 提取 8-bit 指数 与精确的符号-尾数字节 ;给定解码指数 重建 。
- 符号-尾数:作 8-bit 流无损存储;
- 指数流:用校准 Top-16 码本,每个高频指数用 4-bit 码、两码打包一字节;Top-16 外的为 escape 值——记录 chunk 内相对位置(16-bit 无符号)与原始指数(8-bit)。
设 Top-16 集为 、escape 集 、张量 个元素、 个 escape,则存储: 其中 escape 率 。压缩比 ,随 escape 率降低渐近趋于 4/3。当 Top-16 覆盖 >99% 时 极小,escape 开销相对 8-bit→4-bit 指数缩减可忽略。
编码两阶段:① 稠密变换(提指数、查编码表、两 4-bit 码打包一字节、原样存符号-尾数);② 扫描原指数流,把非 Top-16 指数压入 chunk 化的 escape 位置/值数组。瓶颈在指数提取与 4-bit 打包,故用 Quad64 向量化编码融合为单 kernel(类似循环展开),提升 1.5×(详见附录 A)。
解码逆序:先解包每字节为两 4-bit 码、查 16 项解码表、结合存储的符号-尾数重建 BF16;escape 元素初始可能解错为高频指数,再经稀疏修正流按记录的 escape 位置覆写为精确原始指数,实现无损。
3.3 校准(§3.3)
每次压缩都算精确指数直方图代价高,故 SplitZip 做一次性离线校准:在小代表性数据集上提取全部指数值、统计频率、选 Top-16、构建三张查找表(指数→4-bit 编码表、4-bit→指数解码表、检测 escape 的成员表)。这把直方图构建移出在线路径。实验证明所选高频指数集跨输入泛化良好。
3.4 Top-16 而非 Top-15(§3.4)
自然替代方案是保留一个码字作显式 escape token(Top-15+sentinel),让解码器直接从码流推断 escape 位置以省位置开销。但这把直接可表示的高频指数从 16 减到 15,并在稠密解码路引入特殊处理。SplitZip 用全部 16 个 4-bit 码表示高频指数,escape 指数在码流中赋 dummy 码、经显式位置数组覆写——提高覆盖并保持统一稠密解码路(每元素同一 4-bit 查找)。
四、实验结果(§4)
4.1 设置(§4.1)
- 平台:H200 GPU + Xeon 8468,ConnectX-7 IB/RDMA;吞吐以未压缩 BF16 张量字节数计(GB/s),10 次取平均,先验证比特级往返正确性;
- 数据/负载:真实 BF16 KV 激活。编解码/消融用 Qwen3-32B KV 张量组成 256M BF16 工作负载(wikitext2-test),chunk 大小 1024;Mooncake 传输评测 Llama-3-8B 与 Qwen3-30B-A3B 四种扫描(batch/序列长度组合);Qwen3-32B 传输分解报告序列长 2K/16K/64K;码本默认在 WikiText-2 训练子集校准;
- 基线:nvCOMP(LZ4/Cascaded/Bitcomp)、DFloat11、ZipNN、ZipServ、Falcon。
4.2 结果(§4.2)
编解码器级性能(Table 2):SplitZip 达 613.3 GB/s 编码、2181.8 GB/s 解码,两项均超所有基线:
| 方法 | 压缩比 | 编码(GB/s) | 解码(GB/s) |
|---|---|---|---|
| nvCOMP LZ4 | 1.019 | 13.4 | 137.1 |
| nvCOMP Cascaded | 1.000 | 111.8 | 155.2 |
| nvCOMP Bitcomp | 1.056 | 341.5 | 147.7 |
| ZipNN | 1.515 | 1.2 | 1.7 |
| DFloat11 | 1.423 | 0.004 | 468.2 |
| Falcon | 1.428 | 8.9 | 14.4 |
| ZipServ-CPP | 1.236 | 0.1 | 499.5 |
| ZipServ-Kernel | 1.236 | N/A | 1260.9 |
| SplitZip | 1.324 | 613.3 | 2181.8 |
- 编码比最快 nvCOMP 编码器 Bitcomp 快 1.8×;解码比最快 nvCOMP 解码器 Cascaded 快 14.1×;
- 比 ZipServ GPU kernel 解码快 1.7×(且去掉其 CPU 压缩瓶颈);比 Falcon 编码快 68.9×;
- 压缩比仍强:含元数据比 ZipServ 高 7.1%,仅比 Huffman 的 DFloat11 低 7.0%;
- 跨 GPU 代际(附录 E):编码吞吐一贯最高(比最强编码器高 1.8-3.0×),解码更受硬件影响、在新 GPU 高带宽下领先扩大(说明其解码吞吐主要受 GPU 内存带宽限制、计算部分已充分优化)。
FP8 扩展:E5M2 的 5-bit 指数可用 4-bit Top-16 码同框架压缩。Qwen3-32B 上 E5M2 达 1.14×(escape 率 0.16%,约为理论上限 88%),Top-16 达 249.7 GB/s 编码、564.9 GB/s 解码。
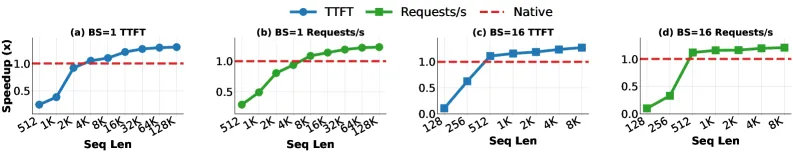
图 2:Qwen3-32B 上 SplitZip 集成入 SGLang 跨序列长度的端到端加速。
KV 传输时间(图 3,Mooncake):跨 batch/序列长度,KV 负载足够大(带宽主导)后 SplitZip 一贯降低传输时间;短序列因固定开销与 kernel 启动占比大收益较小。最大点上 Llama-3-8B 加速 1.27-1.32×、Qwen3-30B-A3B 1.22-1.32×。
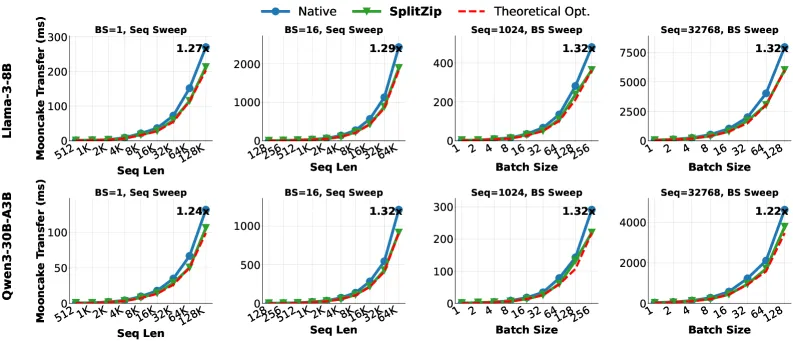
图 3:Mooncake 上跨序列长度与 batch 扫描的 KV cache 传输时间。Theoretical Opt 为零编解码开销、无 escape 的理论最优。
SGLang 端到端(图 2):负载在长序列变为传输主导后一贯改进(小负载区因固定开销偶有轻微变慢)。batch=1、512-128K:TTFT 加速至 1.303×、吞吐至 1.233×;batch=16、128-64K:TTFT 至 1.274×、吞吐至 1.206×。
传输时间分解(图 4,Qwen3-32B,batch=16,RoCE 4×200G):加性核算编码/压缩传输/解码。2K 时 56.5→53.1ms;16K 时 441.4→353.8ms;64K 时 1749.3→1397.0ms。长上下文下压缩传输占 SplitZip 时间 92.9%,编码/解码仅 5.7%/1.4%——证明编解码开销足够小,长上下文 KV 传输仍主要受带宽约束。
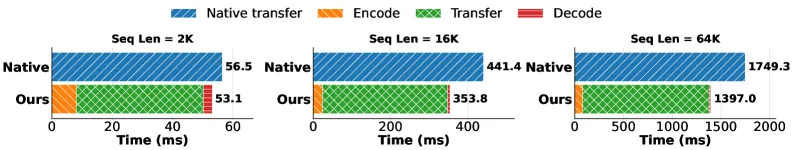
图 4:Qwen3-32B 传输时间分解。Native 传原始 BF16 KV,SplitZip 含编码 + 压缩传输 + 解码(RoCE 4×200G)。
4.3 消融研究(§4.3)
- Top-k 指数编码(Table 3):Top-8(3-bit)覆盖 92.11%、escape 率 7.89%、压缩比降到 1.241×、解码 710.5 GB/s;Top-16(4-bit)覆盖 99.84%、escape 率 0.16%、压缩比 1.324×、解码 2181.8 GB/s——Top-16 解码快 3.07×(3-bit 码不对齐字节、escape 近 50× 高);
- 校准数据集(Table 4):WikiText-2 训练校准,跨 HumanEval/GSM8K/MMLU/PTB 覆盖均 >99%、几乎匹配 oracle(B→B)——高频指数跨域稳定;
- 校准粒度(Table 5):per-token/per-channel 覆盖略升至 99.90%,但吞吐暴跌数个数量级(降到 sub-GB/s,因众多小码本导致不规则查找)——per-tensor 是正确选择;
- escape 位置元数据(Table 6):Top-15+sentinel 压缩比略高(1.331×)但解码降到 620.8 GB/s(慢 3.5×),因解码器须检查码流识别 sentinel、引入不规则控制流;Top-16+显式位置保持统一稠密查找路,优先吞吐;
- 预校准(Table 7):动态 Top-16(每输入重建码本)压缩比/escape 率/解码吞吐几乎相同,但编码从 613.3 降到 80.7 GB/s(慢 7.6×),因加了在线直方图与 top-k 选择;
- 层级覆盖(图 5):Qwen3-32B 全 64 层用共享 Top-16 码本——K-cache 全 64 层 >99.0%(61 层 >99.8%);V-cache 有轻微低覆盖尾(两早层 <99.0%,最差 98.77%,对应 1.23% escape 率,中位层仍 99.88%);
- Quad64 向量化(附录 A,Table 8):把每 4 个 BF16 重解释为一个 64-bit 字批量处理,编码 416.2→613.3 GB/s(1.47×),不改压缩格式与无损语义。
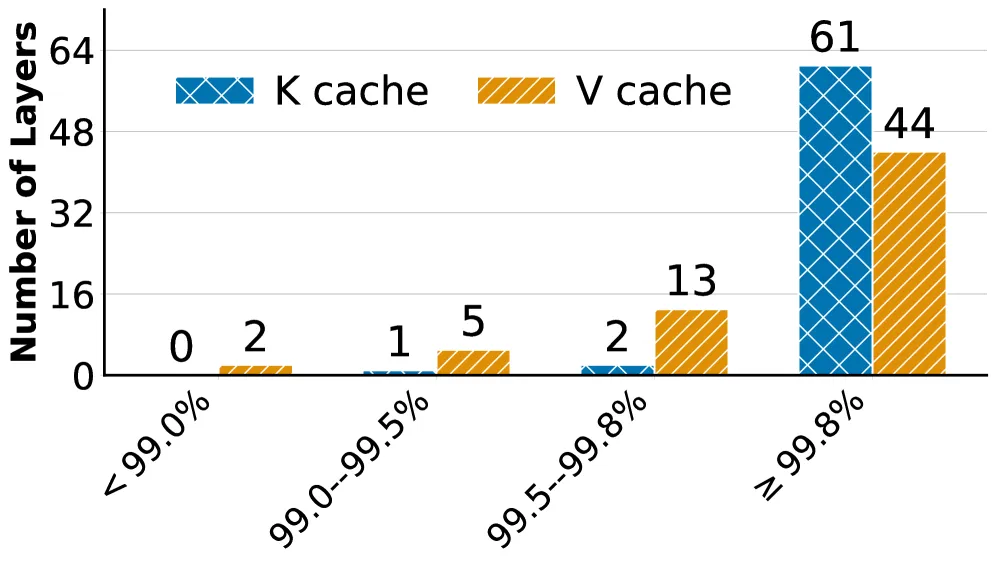
图 5:Qwen3-32B 上固定共享 Top-16 码本的层级覆盖。K-cache 稳定,V-cache 有轻微低覆盖尾。
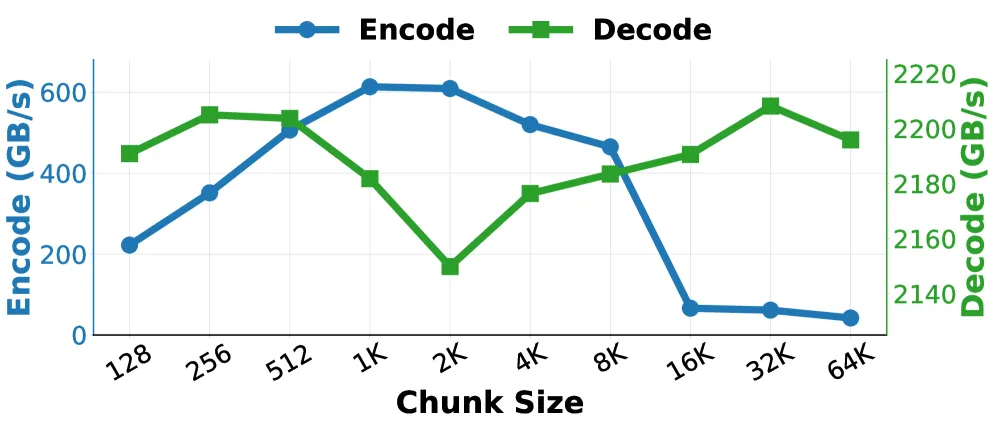
图 6(附录 D):escape 值捕获 chunk 大小消融。
4.4 流水线隐藏编解码开销(附录 B)
PD 分离服务中压缩/传输/解压可作流式流水线。设原始大小 、压缩比 、编码吞吐 、解码 、通信带宽 ,则各阶段 、、,稳态流水线时间取最慢阶段。完全隐藏编解码开销的最大带宽 。SplitZip 中 GB/s——只要物理通信带宽 ≤ 约 463 GB/s,SplitZip 就表现为纯带宽节省变换、无暴露编解码延迟。
五、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| KV 激活指数冗余刻画 | 指数熵 2.89-3.59 bit、Top-16 覆盖 ≥99.3%,跨 6 模型/多数据集/几乎所有层 | §3.1;Table 1 |
| 定长 4-bit 指数码 + 稀疏 escape | 高频指数定长码(两码一字节),罕见值存位置+原值,比特级无损 | §3.2 |
| 离线校准 Top-16 码本 | 消除在线直方图,编码保持 613.3 GB/s(vs 动态 80.7) | §3.3;Table 7 |
| Top-16 而非 Top-15 | 统一稠密解码路(无分支),解码快 3.5× | §3.4;Table 6 |
| Quad64 向量化编码 | 4 个 BF16 打包 64-bit 字批处理,编码 1.47× | 附录 A;Table 8 |
| 与量化正交 | 可叠加于已量化 KV(FP8),E5M2 再压 1.14× | §4.2;附录 C |
六、总结
核心贡献
- 首个面向 PD 分离 KV 传输的 GPU 友好无损压缩器:保模型语义精确、不改任何张量值、无需改模型执行;
- 定长指数编码 + 显式 escape 修正:牺牲极小压缩比(1.324× vs Huffman 1.423×)换取数量级更高的编解码吞吐(编码 613.3、解码 2181.8 GB/s);
- GPU 无分支执行:Top-16 统一查找 + 稀疏覆写 + Quad64 向量化 + 离线校准,全面对齐 GPU 并行;
- 生产验证:SGLang+Mooncake 上 BF16 传输 1.32×、TTFT 1.30×、吞吐 1.23×,与量化正交(FP8 再压 1.14×)。
局限性
- 仅在 KV 通信为主瓶颈时最有效:短上下文/计算受限区,编解码开销可能盖过传输量减少(图 2/4 小负载区偶有轻微变慢);
- 压缩比受浮点指数冗余上界约束(渐近 4/3),故与更激进的有损/模型感知压缩互补而非替代;
- V-cache 少数早层覆盖略低(最差 98.77%),全局码本以微小尾部换取吞吐(未用 per-layer 码本);
- 作为效率改进,可能增加总部署量,应配合适当治理。
七、参考资源
- arXiv 论文:https://arxiv.org/abs/2605.01708
- 集成栈:SGLang(Zheng 2024)、Mooncake(Qin 2024,KV-centric 分离架构 + RDMA/TCP Transfer Engine)
- 无损压缩相关:DFloat11(Zhang,BF16 权重指数编码)、ZipNN、ZipLLM、Falcon、ZipServ(多级定长编码)、nvCOMP(LZ4/Cascaded/Bitcomp)
- PD 分离相关:DistServe、Splitwise、FlowKV
- 测试模型:Qwen3-32B/30B-A3B/Next-80B(Yang 2025)、Llama-3/3.1(Meta)、Phi-2