World Model for Robot Learning: A Comprehensive Survey
A comprehensive survey of world models from a robot-learning perspective, examining policy coupling, learned simulators for RL and evaluation, robotic video generation, and benchmarks/datasets across embodied applications
World Model for Robot Learning: A Comprehensive Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | World Model for Robot Learning: A Comprehensive Survey |
| 作者 | Jianfei Yang, Yihang Xu, Zhihao Dou, Shufei Zhang, Hao Wang, Jiarong Zhou, Shijie Wang, Zhiyi Mao, Song-Chun Zhu, Jindong Gu, Siyuan Huang, Feng Chen, Tianshu Yu, Xiao Zhang, Benyou Wang |
| 机构 | NTU, UC Berkeley, Stanford, UTokyo, Oxford, Microsoft, ETH Zurich, Princeton, Harvard |
| 论文 | https://arxiv.org/abs/2605.00080 |
| 代码 | https://github.com/NTUMARS/Awesome-World-Model-for-Robotics-Policy |
| 发布 | arXiv:2605.00080, May 1, 2026 |
| 许可 | - |
| 项目页 | https://ntumars.github.io/wm-robot-survey/ |
二、核心思想
问题定义
世界模型(World Models)作为描述环境如何在行动下演化的预测表示,已成为机器人学习的核心组件。它们支持策略学习、规划、模拟、评估、数据生成等功能。随着基础模型(Foundation Models)和大规模视频生成的兴起,世界模型取得了快速发展。然而,现有文献在架构、功能角色和具身应用领域之间仍然碎片化严重。
解决方案概述
本调查从机器人学习视角出发,系统性地审查世界模型文献,涵盖三大主线:
- 世界模型与机器人策略的耦合方式 — 从解耦的”预测-执行”管线到统一的单骨干网络
- 世界模型作为学习模拟器 — 用于强化学习和策略评估
- 机器人视频世界模型的演进 — 从想象力生成到可控、结构化、基础规模建模
进一步连接导航和自动驾驶等其他具身应用,并总结代表性数据集、基准和评估协议。
世界模型的三种核心能力
- 预见力(Foresight) — 在执行前预测未来状态或行动后果
- 想象驱动规划(Imagination-driven planning) — 使用想象的 rollout 比较和选择候选行为
- 数据放大(Data amplification) — 合成额外的演示或交互轨迹以改善学习
历史演进两条方向
- 方向1:预测建模与动作生成的更紧密耦合(从解耦到统一)
- 方向2:将学习到的世界模型作为模拟器用于验证、后训练和强化学习(更广泛的应用范围)
三、技术架构
整体框架图
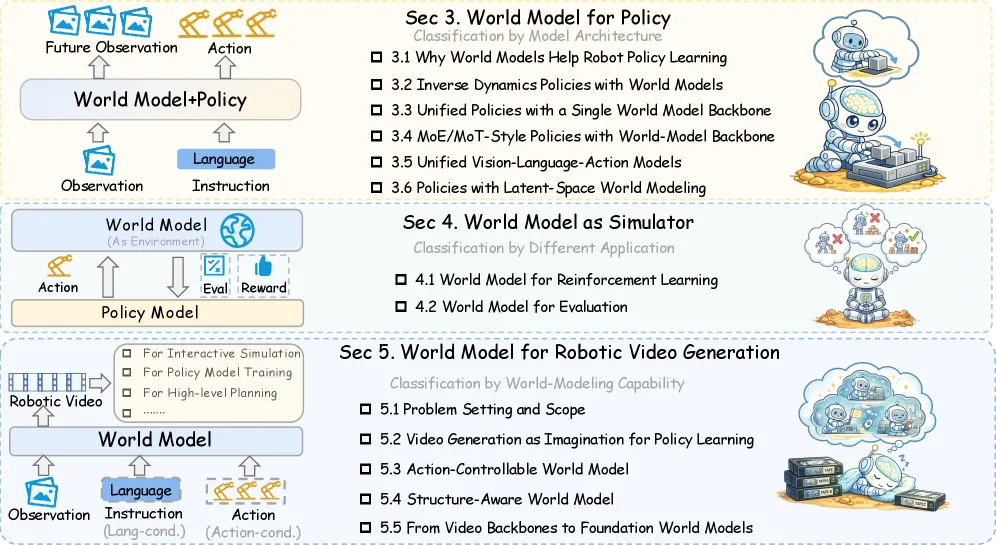
概率框架:策略与世界模型的统一视角
核心公式:联合分布 p(o_{t+1:t+k}, a_{t+1:t+k} | o_t, l) 以不同方式分解:
- 策略模型(Policy Model):
p(a_{t+1:t+k} | o_t, l)— 仅条件于当前观测 - 被动世界模型(Passive World Model):
p(o_{t+1:t+k} | o_t, l)— 对动作积分 - 可控世界模型(Controllable World Model):
p(o_{t+1:t+k} | o_t, a_{t+1:t+k})— 条件于动作 - 逆动态模型(Inverse Dynamics Model):
p(a_{t+1:t+k} | o_{t:t+k})— 从观测序列推断动作
这四种形式是同一底层预测-控制模型的不同边缘/条件分布。这解释了为什么世界模型和策略可以自然耦合。
世界模型的一般表述
p(x_{t+1:t+H} | x_t, a_{t:t+H-1}, l)其中 x_t 是被建模的状态(可以是视觉观测、隐状态、结构化物理状态或抽象符号状态),a_{t:t+H-1} 是 horizon H 上的动作序列,l 是高层任务规范(语言指令或目标描述)。
视频生成模型(视觉实例化)
p(v_{t+1:t+H} | o_t, a_{t:t+H-1}, l)保留了更丰富的空间、时间和交互细节,因为未来以视觉证据显式表示。
机器人策略
p(a_{t+1:t+k} | o_t, l)两种主要范式:
- 视觉运动策略(Visuomotor policies):如 Diffusion Policy,任务特定、轻量级,使用生成建模(扩散、流匹配)捕捉多模态动作分布
- 视觉-语言-动作策略(VLA models):如 RT-2、OpenVLA、Pi0,在机器人轨迹数据上微调大型 VLM,继承语义知识和开放词汇推理
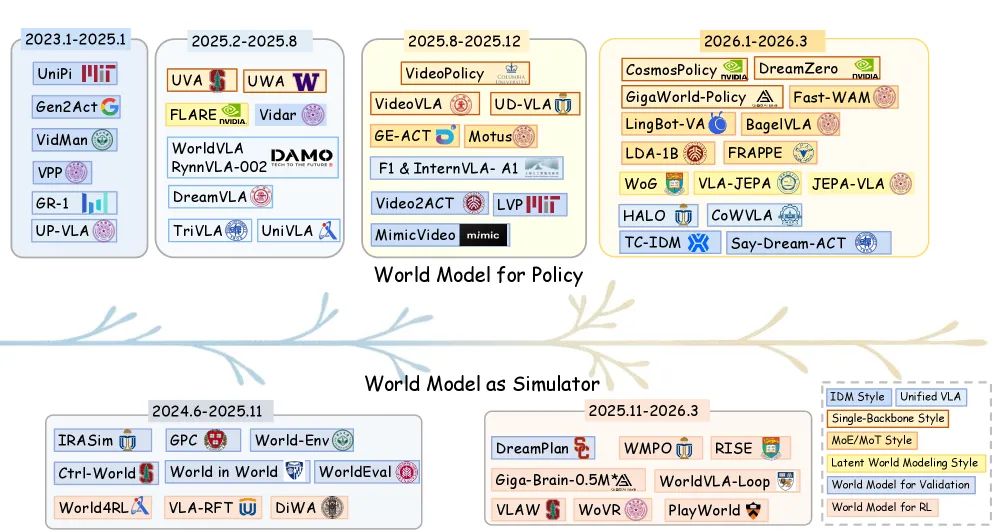
六大架构范式
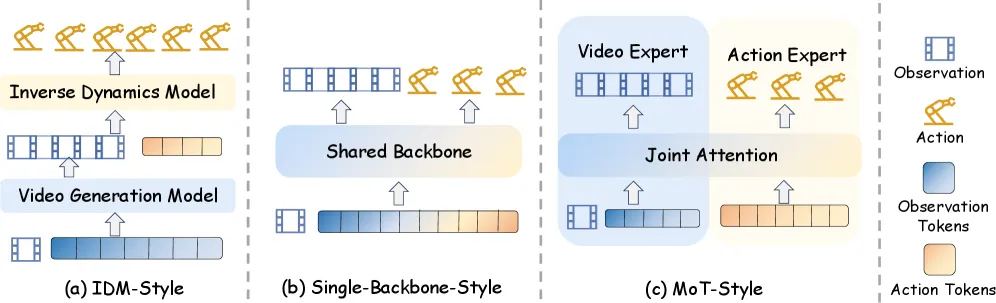
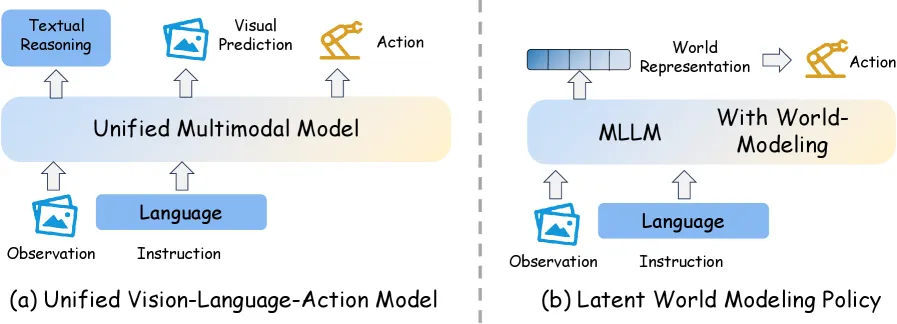
两大 MLLM 路由
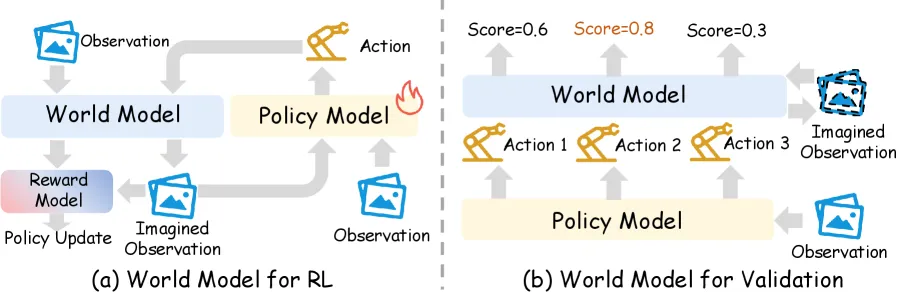
模拟器用途
机器人视频世界模型统一视图
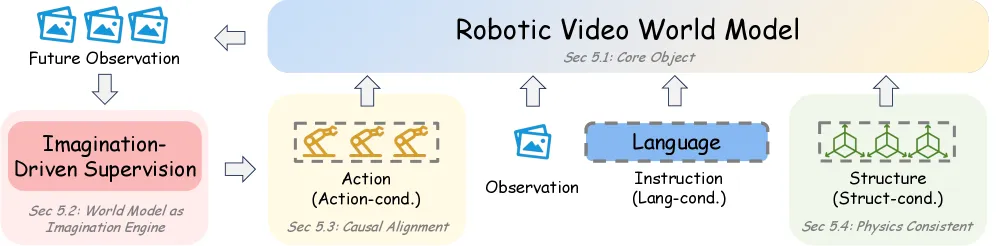
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个以策略为中心的世界模型调查 | 从机器人学习角度系统性分类世界模型 | 覆盖 6 大架构范式、4 阶段视频生成演进 |
| 细粒度分类体系 | 区分主要架构范式和功能角色 | Table 1(20+ 代表作)、Table 2(~27 方法) |
| 完整的基准/数据集综述 | 30+ 数据集和基准的全面映射 | Table 3(核心属性)、Table 4(能力相关性) |
| 跨范式的结果比较 | 所有架构范式在 LIBERO/RoboTwin/CALVIN 上的表现 | 证明高性能可从多种设计范式涌现 |
| 六大挑战与未来方向 | 因果条件缺口、效率瓶颈、多模感知、经典控制、符号结构、评估指标 | Section 8 详细分析 |
五、世界模型用于策略(Section 3)
5.1 逆动态策略(解耦范式)
两步流程:
o_hat_{t+1:t+H} = W(o_t, l)— 世界模型预测未来pi(a | o_t, l, Phi(o_hat))— 策略基于当前观测 + 生成的未来
演化路线:
- 早期:UniPi 使用任务条件世界模型生成未来视频,分离的逆动态模型推导动作
- 视觉扩展:VidMan、Vidar 引入掩码逆动态强调动作相关区域
- Gen2Act:条件化于生成的人类视频而非机器人中心 rollout
- VPP、Video2Act:从预训练视频扩散模型的隐空间提取控制相关特征
- MimicVideo:用部分去噪的隐视觉计划替代显式视频预测
- TC-IDM、LVP:将生成未来翻译为执行导向的中间表示(几何轨迹、可撤回视觉计划)
- 结构化几何中间表示:AVDC(密集对应)、VidBot(3D 手轨迹)、NovaFlow(3D 对象流)
特点:架构解耦 — 预测模型通常先预训练然后冻结/轻适配,与策略头分离。带来模块化性和可复用视频先验,但性能受限于生成未来的保真度和可控性。
5.2 单一世界模型骨干的统一策略
使用单个生成骨干网络联合建模未来视觉演化和未来动作。观测和动作 token 在一个共享骨干中处理。
统一目标函数:
y_hat = f_theta(x_tilde_tau, o_t, l, tau)  where x = [z_v; z_a]
L_unified = E[l(y_hat, y)]
代表工作:
- UVA:学习联合视频-动作隐空间,双模态联合监督
- UWA:在单个 transformer 下整合视频和动作扩散
- VideoVLA:将 Video DiT 扩展到 Video-Action DiT
- VideoPolicy:将视频生成作为主要策略基底
- Cosmos Policy:保持预训练视频扩散架构基本不变,将机器人动作/未来状态/值编码为扩散序列中的附加隐帧
- DreamZero:自回归流匹配视频-动作 DiT,闭环分块联合去噪
- UD-VLA:离散多模态设置耦合未来图像 token 和动作 token
- GigaWorld-Policy:联合优化未来动作预测和动作条件视频,视觉分支在推理时可选
5.3 MoE/MoT 风格策略(专家世界模型骨干)
保持视频预测、动作生成和语言/场景理解的显式专业化,通过共享注意力、交叉注意力或交错序列实现模态交互。
核心公式:
(h^{v}_{l+1}, h^{a}_{l+1}) = F_mix_l(h^{v}_l, h^{a}_l; o_t, l)三种模式:
- 并行专家耦合:GE-Act 在预训练视频扩散世界模型旁引入并行流匹配动作路径
- Transformer 混合深度交互:Motus(理解/视频生成/动作专家)、LingBot-VA(交错的视频-动作 token)、BagelVLA(语言规划/视觉预测/动作生成交错)、DiT4DiT(中间去噪特征引导动作)
- 隐空间专家化:LDA-1B(DINO 隐空间的视觉预测)、FRAPPE(平行专家流对齐视觉基础模型)
Fast-WAM 为混合点 — 采用共享注意力 MoT 骨干,但结论是主要收益来自训练期间的视频共同训练而非推理时的显式想象。
5.4 统一视觉-语言-动作模型
将世界模型作为策略扩展到显式视频生成之外。面向未来的预测结构内化于统一 VLA 架构中。
三个子类:
- 显式未来状态预测:GR-1(联合预测动作和未来图像)、UP-VLA(未来图像预测改善动作生成)、WorldVLA(统一动作和图像理解/生成,未来图像预测主要作为联合训练信号)
- 隐式/隐未来建模:DreamVLA(预测结构化世界知识 — 动态/空间/语义线索)、UniVLA(在多模态 tokenization 上融入世界建模)、CoWVLA(建模隐运动和紧凑未来视觉目标)
- 多专家/多系统统一:F1(未来视觉状态作为 MoT 架构内的规划目标)、InternVLA-A1(轻量隐视觉预见)、HALO(视觉子目标预测和具身推理)、TriVLA(接地/情景动态感知/控制作为协调子系统)
5.5 隐空间世界建模策略
将未来预测完全内化于表示空间,无需显式图像/视频生成。
- FLARE:将动作去噪网络的隐藏特征与未来观测的隐嵌入对齐
- VLA-JEPA:JEPA 风格预训练的 VLA,无泄漏状态预测
- JEPA-VLA:将视频 JEPA 模型(V-JEPA 2)学到的预测嵌入作为现有 VLA 模型的更好骨干
- WoG:学习紧凑的未来导向条件与动作一起
- DIAL:通过隐世界建模将高层意图与低层动作解耦
5.6 架构范式比较(Table 1)
| 范式 | 代表作数 | 推理时未来生成 | 骨干 | 耦合风格 |
|---|---|---|---|---|
| IDM-style | 11 | 显式视频 rollout / 隐预测特征 | VGM | 解耦 |
| Single-backbone | 8 | 联合隐预测 / 联合扩散 / 可选视觉分支 | VGM | 共享骨干 |
| MoE/MoT | 8 | 隐视觉引导 / 专家 rollout / 训练时视频 | VGM | 专家融合 / MoT 融合 |
| Unified VLA | 9 | 未来图像预测 / 结构化世界知识 / 隐动态 | UMM | 联合共训练 / 统一 MoT |
| Latent-space WM | 5 | 隐对齐 / 隐目标预测 / 隐视觉预见 | MLLM | 隐内化 |
六、世界模型作为模拟器(Section 4)
6.1 强化学习中的世界模型
核心公式:
(o_{t+1}, r_t, d_t) ~ p_phi(. | o_{<=t}, a_{<=t}, l)
J(theta) = E_{tau_hat ~ (pi_theta, p_phi)} [sum_t gamma^t r_t]第一级范式(世界模型固定,策略在其中优化):
- UniSim、World-Env、VLA-RFT、DiWA、World4RL
第二级范式(世界模型和策略协同进化):
phi^{k+1} <- UpdateWM(phi^k, D_real U D_policy(pi_{theta^k}))
theta^{k+1} <- UpdatePolicy(theta^k, D_hat(phi^{k+1}))- World-VLA-Loop、VLAW、WoVR(可控动作条件视频建模 + Keyframe-Initialized Rollouts)
6.2 评估中的世界模型
Rollout 候选评估:
- GPC:增强冻结生成式机器人策略,使用预测前瞻在线排名和优化候选动作
- IRASim:基于模型规划,模拟多条候选轨迹
- World-in-World:闭环规划,想象中的候选计划由修订策略评估
- DreamPlan:从世界模型 rollout 构建候选动作偏好对
MPC 方法:
- TD-MPC2:隐空间 MPC 增强长horizon 推理
- LeWorldModel:通过世界模型的梯度规划发现复杂策略
JEPA 线:V-JEPA 2、V-JEPA 2.1、Ctrl-World(动作忠实 rollout 支持想象策略评估)
关键洞察:评估器只有当其想象的未来保留候选动作的因果后果时才有用。幻觉和长horizon 错误不仅降低视觉质量,还会直接破坏评估信号本身。
七、机器人视频世界模型(Section 5)
7.1 四阶段演进
| 阶段 | 核心问题 | 代表方法 | 关键能力 |
|---|---|---|---|
| Stage 1: 想象力 | 视频生成作为策略学习的想象引擎 | UniPi, Dreamitate, RoboDreamer, PhysWorld, DreamGen | 任务引导、数据扩增 |
| Stage 2: 动作可控 | 生成未来是否遵循命令动作序列 | IRASim, RoboEnvision, RoboMaster, Ctrl-World, EVA | 帧级动作条件、动作忠实度 |
| Stage 3: 结构感知 | richer 交互结构(掩码/几何/多视角) | Mask2IV, TesserAct (4D RGB-D-Normal), RoboVIP | 多视角一致性、物理结构 |
| Stage 4: 基础模型 | 从任务特定到可复用基础层 | Vid2World, Genie Envisioner, WoW, Cosmos Predict 2.5, GigaWorld-0 | 可扩展、通用交互预测 |
7.2 能力分类(Table 2 摘要)
~27 个方法按 4 组分类,每个方法标注:任务条件、动作条件、结构感知、基础规模、主要用途(规划/数据/评估/模拟)。
7.3 核心瓶颈
生成在因果上与机器人动作对齐、在长horizon 上物理和运动学自洽、跨视角和 embodiment 一致、在交互中稳定、足够可执行以支持真实策略改进。
八、其他应用(Section 6)
8.1 导航
- Pathdreamer:生成合理的未来 360° RGB、深度和语义观测
- VISTA/VISTAv2:“想象-对齐”策略,导航世界模型在候选动作上展开自我中心未来
- NWM:可控视频生成作为导航世界模型
- SparseVideoNav:稀疏未来生成以实现更快部署
- EgoWM:将预训练互联网规模视频扩散模型适配为动作条件自我中心世界模型
8.2 自动驾驶
- MILE:带几何归纳偏置的隐动态模型
- OccWorld:3D 占据空间的世界建模
- GAIA-1:视频/文本/动作 token 的多模态序列建模
- DriveDreamer:带结构约束的扩散建模
- Drive-WM:可控多视角未来视频,通过想象的多未来 rollout 选择更安全轨迹
- UniDWM:结构和动态感知的隐世界表示
- SteerVLA:高层 VLM 作为语义世界模型生成细粒度常识推理
九、基准、数据集与结果(Section 7)
9.1 三层评估框架
| 层级 | 评估内容 | 代表基准 |
|---|---|---|
| 开环 | 测试一致的行动条件未来 | RBench, EWMBench, DreamGen Bench, EVA-Bench |
| 闭环 | 测试规划和策略评估的有用性 | WorldArena, WorldEval, WorldGym, World-in-World |
| 诊断 | 测试物理接地、可控性、可执行性 | WorldSimBench, WoW-World-Eval, DrivingGen, WM-ABench |
9.2 数据集全景(Table 3 摘要)
30+ 数据集按 7 维标注:跨 embodiment 覆盖、显式动作监督、强观测支持(>单目RGB)、语言/任务条件、多模态/接触丰富信号。
关键数据集:
- RoVid-X:机器人视频数据集(2026)
- Open X-Embodiment (OXE):跨 embodiment 真实机器人数据
- DROID:大规模真实机器人数据,含语言条件
- UMI / MV-UMI / ActiveUMI:大规模交互数据
- Humanoid Everyday:人形机器人,含 3D 观测和多模态信号
- RoboMIND 2.0:真实+模拟,跨 embodiment,含语言
- RH20T / RH20T-P:多模态真实机器人数据
- Action100M:网络视频,1亿级规模
9.3 基准结果比较(Table 5 & 6)
LIBERO Standard 4-Suite 结果:
| 方法 | 类别 | Spatial | Object | Goal | Long | Avg |
|---|---|---|---|---|---|---|
| Cosmos Policy | Single-backbone | 98.1 | 100.0 | 98.2 | 97.6 | 98.5 |
| LingBot-VA | MoE/MoT | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| Say-Dream-ACT | Decoupled | 99.4 | 99.2 | 98.6 | 95.4 | 98.1 |
| Motus | MoE/MoT | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| RynnVLA-002 | Unified VLA | 99.0 | 99.8 | 96.4 | 94.4 | 97.4 |
| VLA-JEPA | Latent-space WM | 96.2 | 99.6 | 97.2 | 95.8 | 97.2 |
RoboTwin 结果:
- LingBot-VA: 92.9/91.6 (RT-A/RT-B)
- InternVLA-A1: 89.4/87.0
- Motus: 88.7/87.0
9.4 关键发现
- 所有架构范式均出现强劲结果 — 解耦、共享骨干、统一、混合、隐预测 — 世界模型的效用不绑定于某一特定实现
- 长horizon 操作仍是关键区分因素 — Goal 和 Long 套件上下降最大,成功依赖于持续的、动作接地的一致性
- 高性能可从多种设计范式涌现 — 写实视频生成并非有效具身控制的必要条件
- 主要剩余挑战:长horizon 鲁棒性、跨基准泛化、缺乏标准化报告
十、挑战与未来方向(Section 8)
| 挑战 | 核心问题 | 缓解方向 |
|---|---|---|
| 8.1 因果条件缺口 | 预测未来更多条件于历史上下文而非具体待定机器人动作 | 隐式统一训练(WorldVLA) |
| 8.2 效率瓶颈 | 扩散视频预测的高推理延迟、训练计算开销 | 部分去噪(MimicVideo)、隐空间模型(LeWorldModel)、训练时剥离(Fast-WAM) |
| 8.3 多模感知瓶颈 | 主要依赖视觉,缺乏触觉/力反馈 | 视触联合模型、异步信号对齐 |
| 8.4 经典控制集成 | MPC 计算开销大,神经表达能力与形式控制保证的调和 | Lyapunov 稳定性融合 |
| 8.5 符号结构集成 | 像素/隐空间预测的长horizon 误差累积 | 混合世界模型(学习表示+符号结构) |
| 8.6 评估指标开放挑战 | 缺乏功能导向评估,碎片化 across benchmarks | 函数感知评估框架:预测真实性+动作敏感性+长horizon一致性+控制效用 |
十一、总结
核心贡献
- 首个以策略为中心的世界模型调查 — 从机器人学习视角系统性审查世界模型文献
- 细粒度分类体系 — 6 大架构范式(IDM-style、Single-backbone、MoE/MoT、Unified VLA、Latent-space WM + Simulator)
- 机器人视频世界模型四阶段演进 — 从想象力到动作可控、结构感知、基础规模
- 完整的基准/数据集全景 — 30+ 数据集和 10+ 基准的全面映射
- 跨范式结果比较 — 证明高性能可从多种设计范式涌现
- 六大挑战与未来方向 — 从因果条件到符号结构的全面分析
技术影响
- 世界模型不再是视频生成的附属品,而是机器人学习的核心组件
- 从”预测-然后-执行”到”联合预测-控制”的范式转变
- 评估应从视觉真实性转向功能实用性(动作忠实度、规划效用、可执行性)
局限性
- 当前系统严重依赖视觉观测,多模态感知(触觉/力觉)整合仍处于起步阶段
- 长horizon 预测的误差累积问题尚未根本解决
- 缺乏标准化的跨基准评估协议,难以公平比较不同方法
- 像素/隐空间预测与符号/结构化表示之间的鸿沟仍未弥合
十二、参考资源
- arXiv: https://arxiv.org/abs/2605.00080
- GitHub: https://github.com/NTUMARS/Awesome-World-Model-for-Robotics-Policy
- 项目页: https://ntumars.github.io/wm-robot-survey/
- V-JEPA 2: assran2025vjepa2
- Cosmos Policy: kim2025cosmospolicy
- WorldVLA: cen2025worldvla
- MimicVideo: pai2025mimicvideo
- LIBERO: song2023libero
- CALVIN: shi2023calvin
- Open X-Embodiment: oxe2024