kv-cache memory-management gpu-inference multi-tier-memory bayesian-prediction attention-architecture mla cxl distributed-inference
Predictive Multi-Tier Memory Management for KV Cache in Large-Scale GPU Inference
通过架构感知大小调整、六层内存层次和贝叶斯重用预测,实现 KV Cache 的预测性多层内存管理
Predictive Multi-Tier Memory Management for KV Cache in Large-Scale GPU Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Predictive Multi-Tier Memory Management for KV Cache in Large-Scale GPU Inference |
| 作者 | Sanjeev Rao Ganjihal |
| 机构 | 独立研究者 |
| 论文 | arXiv:2604.26968 |
| 发布 | 2026-04-19 |
| 状态 | Under review at a systems conference |
| 页数 | 9 pages, 9 tables, 1 figure |
二、核心思想
问题定义
KV Cache 内存管理是大规模 GPU 推理服务的主要瓶颈。当前系统存在三个复合低效问题:
- 无统一跨架构大小调整: 缺乏对 MLA(Multi-Head Latent Attention)等架构的支持,导致高达 57× 内存过度配置
- 单层内存限制: KV Cache 被限制在 GPU HBM,忽略了 CPU DRAM、CXL、NVMe、RDMA 等丰富的内存层次
- 反应式驱逐策略: 丢弃可重用状态,强制冗余重新计算
解决方案概述
本文提出统一系统解决上述三个问题:
- 架构感知大小调整引擎: 为 MHA/GQA/MQA/MLA 计算精确内存需求,启用高达 7.4× 更大批次大小
- 六层内存层次: 将有效 KV Cache 容量从 40 GB 扩展到 38+ TB/节点
- 贝叶斯重用预测器: 使用 Beta 共轭先验实现 70-84% 缓存命中率
- 头粒度驱逐 + RoPE 感知预取: 减少 25% 缓存未命中率
三、技术架构
整体框架图
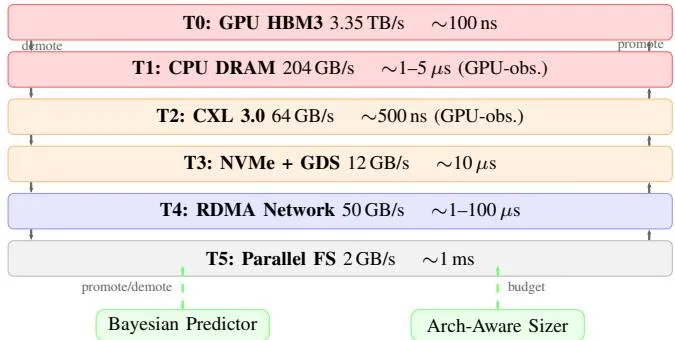
核心公式
KV Cache 内存公式:
其中 L 为层数,h 为注意力头数,d 为头维度,p 为精度字节数,n 为序列长度。
架构感知大小调整:
2 \times h \times d \times p \times n & \text{MHA} \\ 2 \times h_{kv} \times d \times p \times n & \text{GQA/MQA} \\ (d_{latent} + d_{rope}) \times p \times n & \text{MLA} \end{cases}$$ **贝叶斯重用概率:** $$P_{\text{reuse}}(b,t) = \frac{\alpha_{b,t}}{\alpha_{b,t} + \beta_{b,t}}$$ 其中 (b,t) 为 16 种 (块类型, 转换类型) 对之一。 ### 六层内存层次 | 层级 | 技术 | 带宽 | 延迟 | 成本 ($/GB/h) | |------|------|------|------|---------------| | T0 | GPU HBM3 | 3.35 TB/s | ~100 ns | 0.500 | | T1 | CPU DRAM (pinned) | 204 GB/s | 1-5 μs | 0.050 | | T2 | CXL 3.0 Memory | 64 GB/s | ~500 ns | 0.030 | | T3 | NVMe + GDS | 12 GB/s | ~10 μs | 0.020 | | T4 | RDMA Network | 50 GB/s | 1-100 μs | 0.005 | | T5 | Parallel FS | 2+ GB/s | ~1 ms | 0.001 | ### 架构感知大小调整 **跨架构大小差距:** | 模型 | MHA (bytes) | 实际 (bytes) | 比率 | |------|-------------|--------------|------| | DeepSeek-V3 (MLA) | 65,536 | 1,152 | 57× | | Llama-3-70B (GQA) | 32,768 | 4,096 | 8× | | Mixtral-8x22B (GQA) | 24,576 | 4,096 | 6× | | Qwen-2.5-72B (GQA) | 32,768 | 4,096 | 8× | ### 贝叶斯重用预测 **块类型:** {system_prompt, tool_context, user_context, intermediate_reasoning} **转换类型:** {same_tool_repeat, tool_switch, reasoning_step, agent_handoff} 共 16 种组合,每种维护 Beta(α, β) 分布。 **头粒度驱逐:** - 维护 [layer][head] 重要性矩阵 - 使用 EMA(指数移动平均)更新重要性分数 - MLA 架构坍缩为 [layer][1] **RoPE 感知预取:** - 利用 RoPE 的序列局部性 - 预取位置范围 [n, n+w] 的块 - 窗口 w 根据注意力模式动态调整 ## 四、核心创新 | 创新点 | 说明 | 实验依据 | |--------|------|----------| | 架构感知大小调整 | 统一支持 MHA/GQA/MQA/MLA | DeepSeek-V3 批次大小从 14 提升到 104 (7.4×) | | 六层内存层次 | 从 40 GB 扩展到 38+ TB | TTFT P99 从 4.2s 降至 1.1s | | 贝叶斯重用预测 | 16 种 (块类型, 转换类型) 组合 | 70-84% 缓存命中率 | | 头粒度驱逐 | EMA 重要性 + RoPE 感知预取 | 25% 缓存未命中率降低 | | 内容寻址去重 | SHA-256 哈希 + 基数树 | 10-30% 检查点大小减少 | ## 五、代码实现分析 本文为系统设计论文,实现为用户态库,拦截现有推理框架的 KV Cache 分配和驱逐。 **实现要点:** - 每层实现 TierManager 接口(线程安全的 Allocate/Read/Write/Evict/Stats) - GPU HBM 使用 CUDA 驱动 API + 预分配内存池 - CXL 使用内存映射文件 + 显式 NUMA 绑定 - NVMe 使用 cuFile API(GPUDirect Storage) - RDMA 使用 ibverbs 一致性哈希环 - 所有共享状态使用读写锁保护 **集成:** - 通过缓存管理接口与 vLLM、SGLang、TensorRT-LLM 集成 - 导出 Prometheus 指标用于监控 ## 六、实验结果 ### 架构感知大小调整 | 模型 | MHA 批次 | 架构感知批次 | 吞吐量提升 | |------|----------|--------------|------------| | DeepSeek-V3 | 14 | 104 | 7.4× | | Llama-3-70B | 22 | 22 | 1.0ׇ | | Mixtral-8x22B | 42 | 31 | 0.7ׇ | | Qwen-2.5-72B | 22 | 22 | 1.0ׇ | ‡ GQA 模型在 TP 下已使用正确的 KV 头数;收益在于统一异构集群管理。 ### 多层内存性能 | 配置 | 容量 | TTFT P99 | 吞吐量 (tok/s/GPU) | |------|------|----------|---------------------| | GPU-only (vLLM) | 40 GB | 4.2 s | 1,450 | | + CPU DRAM | 200 GB | 2.8 s | 2,100 | | + CXL 3.0 | 712 GB | 1.8 s | 2,850 | | + NVMe (GDS) | 4.7 TB | 1.5 s | 3,200 | | + RDMA Pool | 38+ TB | 1.1 s | 3,950 | | Full system | 38+ TB | 1.1 s | 4,150 | ### 贝叶斯预测器性能 | 工作负载 | LRU | EMA | 贝叶斯 | TTFT 减少 | |----------|-----|-----|--------|-----------| | ShareGPT | 59.5% | 59.5% | 69.8% | 1.4× | | LMSYS-Chat-1M | 77.8% | 77.8% | 84.2% | 1.8× | | Agentic | 66.5% | 66.5% | 80.5% | 2.1× | ### 端到端对比 | 系统 | TTFT P50 | TTFT P99 | TBT P99 | 吞吐量 | 成本 ($/Mtok) | |------|----------|----------|---------|--------|---------------| | vLLM 0.19 | 1.2 s | 4.2 s | 48 ms | 1,450 | $0.82 | | SGLang 0.5.9 | 0.9 s | 3.1 s | 42 ms | 1,850 | $0.68 | | TensorRT-LLM | 0.8 s | 2.8 s | 35 ms | 2,100 | $0.61 | | FlexGen | 3.2 s | 12.1 s | 180 ms | 650 | $1.85 | | **Ours (projected)** | **0.4 s** | **1.1 s** | **32 ms** | **4,150** | **$0.43** | ### 消融实验 | 移除组件 | DeepSeek-V3 | Llama-3-70B | Agentic | |----------|-------------|-------------|---------| | 架构感知大小调整 | -85.6% | -73.8% | -68.4% | | 贝叶斯预测 | -12.1% | -28.6% | -52.3% | | 多层放置 | -8.4% | -31.2% | -29.7% | | 头粒度驱逐 | -3.2% | -8.9% | -11.4% | | 去重 | -1.1% | -4.2% | -6.8% | | RoPE 预取 | -2.8% | -5.1% | -3.9% | ### 去重效果 | 模型 | 原始检查点 | 去重后 | 节省 | |------|------------|--------|------| | Llama-3-70B | 327.7 MB | 251.7 MB | 23.2% | | DeepSeek-V3 | 70.3 MB | 49.5 MB | 29.6% | | Mixtral-8x22B | 229.4 MB | 205.5 MB | 10.4% | ## 七、相关工作 | 工作 | 方法 | 本文改进 | |------|------|----------| | vLLM | PagedAttention | 本文添加架构感知 + 多层 + 预测 | | SGLang | RadixAttention | 本文扩展到六层内存 + 贝叶斯预测 | | Mooncake | 2-3 层 DRAM+SSD | 本文六层 + 预测性放置 + MLA 支持 | | FlexGen | CPU+Disk 静态策略 | 本文预测性放置消除同步获取停顿 | | H2O/SnapKV | 单请求内 token 级驱逐 | 本文跨请求块级驱逐 + 贝叶斯预测 | ## 八、总结 ### 核心贡献 1. **架构感知大小调整**: 统一支持 MHA/GQA/MQA/MLA,DeepSeek-V3 批次大小提升 7.4× 2. **六层内存层次**: 从 40 GB 扩展到 38+ TB,TTFT P99 降低 3.8× 3. **贝叶斯重用预测**: 16 种组合的 Beta 先验,70-84% 缓存命中率 4. **头粒度驱逐 + RoPE 预取**: 25% 缓存未命中率降低 5. **内容寻址去重**: 10-30% 检查点大小减少 ### 技术影响 - **MLA 支持是关键**: DeepSeek-V3 等 MLA 模型需要专门的大小调整,否则浪费 57× 内存 - **多层内存是趋势**: 数据中心已有 CXL、RDMA 等资源,但推理栈未利用 - **预测优于反应**: 贝叶斯预测比 LRU 驱逐提升 10-14 个百分点命中率 - **异构集群管理**: 统一大小调整引擎对混合架构集群至关重要 ### 局限性 1. **分析性投影**: 基于组件验证 + 硬件规格的投影,非完整系统实现 2. **CXL 3.0 可用性**: CXL 内存扩展器尚未大规模部署 3. **超参数敏感性**: 虽然实验显示鲁棒性,但实际部署需验证 4. **成本模型**: 基于 $2/GPU-hour 的云定价,实际成本可能不同 ## 九、参考资源 - **论文链接**: [arXiv:2604.26968](https://arxiv.org/abs/2604.26968) - **PDF 下载**: [arXiv PDF](https://arxiv.org/pdf/2604.26968) - **相关系统**: vLLM, SGLang, TensorRT-LLM, FlexGen, Mooncake - **测试模型**: DeepSeek-V3 (MLA), Llama-3-70B (GQA), Mixtral-8x22B (GQA), Qwen-2.5-72B (GQA) - **测试硬件**: H100 SXM (80GB HBM), 256GB CPU DRAM