DMEP: Adaptive and Fine-grained Module-wise Expert Pruning for Efficient LoRA-MoE
动态模块级专家剪枝框架,实现LoRA-MoE微调参数减少43%且精度不降
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Adaptive and Fine-grained Module-wise Expert Pruning for Efficient LoRA-MoE Fine-Tuning |
| 作者 | Weihang Li, Jianchun Liu, Hongli Xu |
| 机构 | - |
| 论文 | arXiv:2604.26340 |
| 代码 | - |
| 发布 | 2026-04-29 |
| 领域 | 机器学习 (cs.LG) |
二、核心思想
问题定义
LoRA-MoE 结合了 LoRA 的低训练成本和 MoE 的增强适应能力,是参数高效微调 (PEFT) 的有效范式。然而,现有 LoRA-MoE 框架存在两个关键问题:
问题 1:固定均匀专家分配
- 所有 Transformer 模块(如 attention query/key 投影和 MLP 门控网络)使用相同数量的专家
- 忽略了不同模块的功能角色和容量需求差异
- 导致局部过度配置、冗余参数和不必要的优化器状态开销
问题 2:强制负载均衡
- 现有方法在整个训练过程中强制专家负载均衡
- 早期阶段有益,但一旦路由模式稳定后变得限制性
- 限制了专家对下游任务的专业化
专家利用率的层内异质性
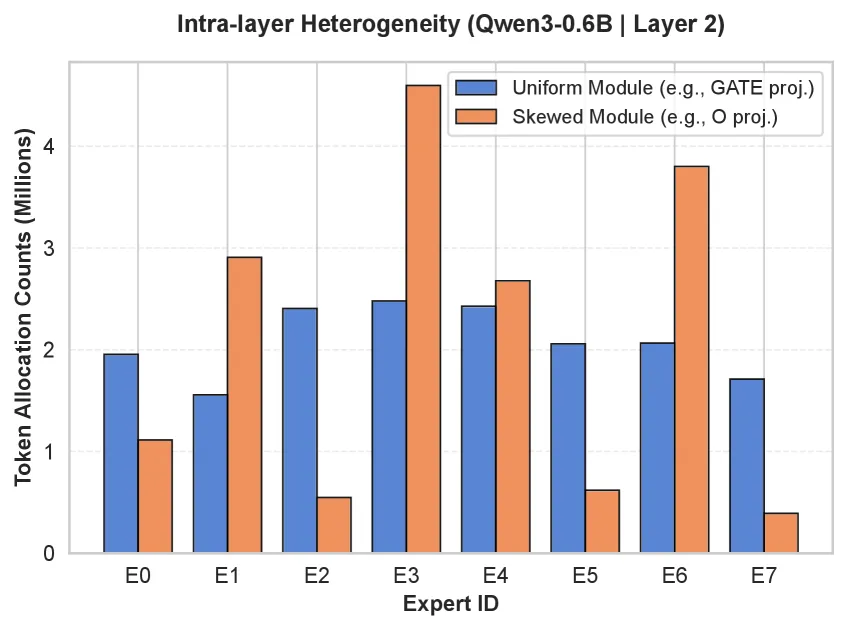
实验证明不同模块的专家利用率差异显著:
- 浅层模块倾向于集中路由行为(仅少数专家频繁激活)
- 深层模块受益于更广泛的专家参与
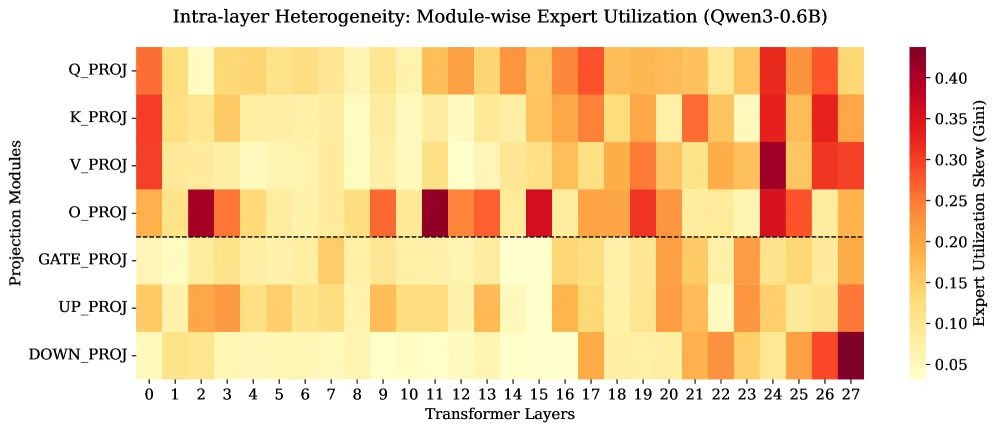
解决方案概述
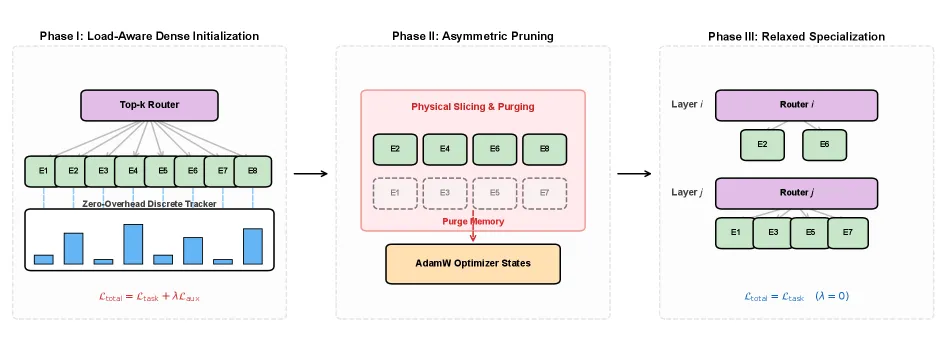
DMEP (Dynamic Module-wise Expert Pruning) 提出三阶段框架:
- Phase I: 负载感知密集初始化 - 在线追踪路由频率,辅助负载均衡损失防止早期路由崩溃
- Phase II: 细粒度模块级剪枝 - 基于利用率分数,物理移除低效专家及其优化器状态
- Phase III: 松弛专业化 - 恢复微调,禁用负载均衡损失,允许专家专业化
核心结果:
- 可训练参数减少 35%-43%
- 训练吞吐量提升约 10%
- 保持或超越下游推理精度
三、技术架构
DMEP 框架
LoRA-MoE 基础
标准 LoRA 前向传播 (Eq. 1):
其中 是冻结的预训练权重,,,
LoRA-MoE 前向传播 (Eq. 2):
其中 是路由概率,Top-k 门控激活最高分专家
总损失 (Eq. 3):
路由动力学分析
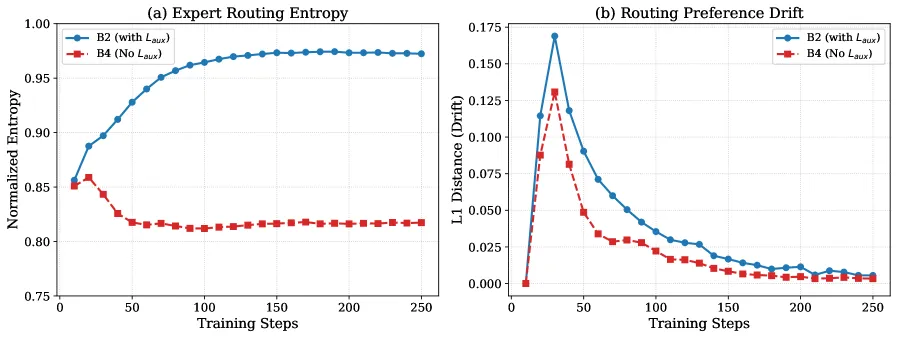
关键观察:
- 归一化路由熵 在训练早期快速收敛
- 约 1 个 epoch 后路由模式趋于稳定
- 稳定后禁用负载均衡损失不会降低性能
三阶段详细流程
Phase I: 负载感知密集初始化
- 模型以均匀密集初始化开始
- 在线追踪器记录离散路由频率(开销可忽略)
- 辅助负载均衡损失防止早期路由崩溃
Phase II: 细粒度模块级剪枝
利用率评分:基于路由频率计算每个专家的利用率分数
结构化物理剪枝:
- 根据利用率分数移除低效专家
- 同时移除对应的优化器状态
- 产生异构架构(不同模块保留不同数量专家)
最小生存约束:,确保每个模块至少保留 2 个专家
Phase III: 松弛专业化
- 完全禁用辅助路由正则化 ()
- 消除优化冲突
- 允许剩余专家实现更尖锐的专业化
剪枝后架构
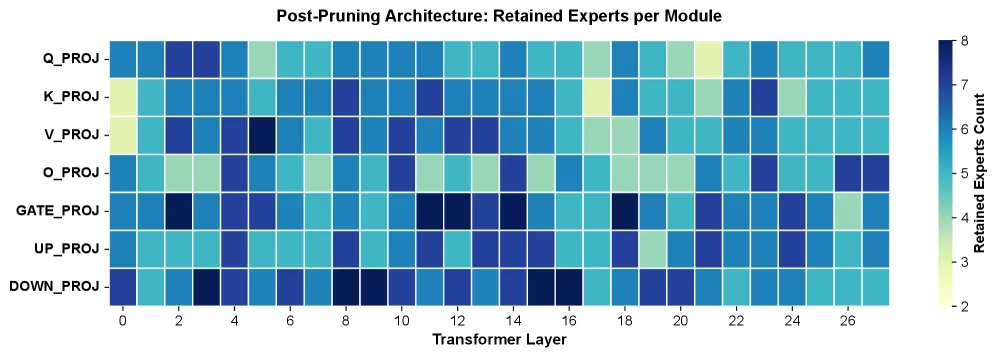
不同模块保留不同数量的专家,形成任务自适应的异构架构。
收敛对比
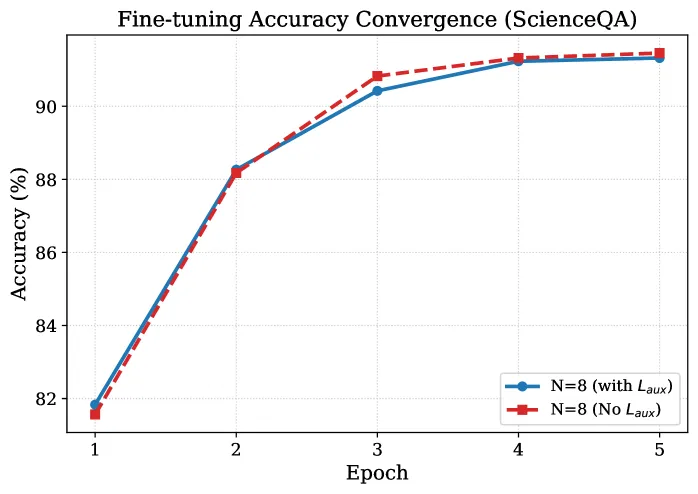
禁用负载均衡损失后,训练收敛更快且最终精度更高。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 模块级异构剪枝 | 不同模块保留不同数量专家 | 利用率热力图显示显著异质性 |
| 在线路由追踪 | 训练过程中动态追踪专家利用率 | 开销可忽略,无需离线 profiling |
| 结构化物理剪枝 | 真正移除专家参数和优化器状态 | 比伪稀疏(二值掩码)更有效 |
| 延迟禁用负载均衡 | 路由稳定后禁用 | 路由熵分析证明合理性 |
五、实验结果
实验设置
模型:Qwen3-0.6B, Qwen3-8B
数据集:
- ScienceQA:多模态科学问答(文本推理部分)
- OpenBookQA:常识和基础科学知识问答
- GSM8K:数学推理(直接答案预测)
超参数:
| 参数 | 值 |
|---|---|
| LoRA rank | r=8 |
| 缩放因子 | α=16 |
| 适配模块 | q/k/v/o_proj, gate/up/down_proj (7个) |
| Top-k | k=2 |
| 训练轮数 | 5 epochs |
| 学习率 | 3×10⁻⁴ (cosine decay, 10% warmup) |
| 有效 batch size | 128 |
| 最大序列长度 | 256 |
| 热身轮数 | E_w=1 |
| 最小生存专家 | K_min=2 |
核心结果
可训练参数减少:35%-43%
训练吞吐量提升:约 10%
下游推理精度:保持或超越均匀 LoRA-MoE 基线
关键发现
- 模块级异质性显著:不同投影模块的专家利用率差异巨大
- 早期路由稳定:约 1 epoch 后路由模式趋于稳定
- 禁用负载均衡有益:路由稳定后禁用 提升专业化
- 物理剪枝优于伪稀疏:真正移除参数比二值掩码更有效
六、相关工作
| 方法 | 特点 | DMEP 优势 |
|---|---|---|
| LoRAMoE | 标准 LoRA-MoE | 模块级异构分配 |
| MixLoRA | 混合 LoRA 专家 | 动态剪枝 |
| MoELoRA | MoE + LoRA | 物理移除冗余 |
| MoLA | 层级专家数变化 | 模块级(更细粒度) |
| MALoRA | 层级异构 | 在线追踪(无需离线 profiling) |
| DA-MoE | 动态分配 | 结构化物理剪枝(非伪稀疏) |
| LoRA-SMoE | 稀疏 MoE | 剪枝后禁用负载均衡 |
| AdaLoRA | 动态 rank | 与 MoE 正交,可结合 |
七、总结
核心贡献
- DMEP 框架:三阶段动态模块级专家剪枝框架
- 模块级异构分配:首次在 LoRA-MoE 中实现模块级(而非层级)的异构专家分配
- 在线路由追踪:轻量级在线追踪机制,开销可忽略
- 结构化物理剪枝:真正移除冗余参数和优化器状态
- 延迟负载均衡禁用:基于路由稳定性分析,合理禁用
技术影响
- 为 LoRA-MoE 微调提供了新的效率优化范式
- 模块级异构思想可推广到其他 MoE 架构
- 在线追踪 + 物理剪枝的方法适用于资源受限场景
局限性
- 主要验证在 Qwen3 系列模型上
- 剪枝决策在训练中期固定,不支持后期动态调整
- 未探索与其他 PEFT 方法(如 Adapter、Prefix Tuning)的结合
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 专家利用率层内异质性 | expert-utilization-heterogeneity.png |
| Figure 2 | 模块级专家利用率热力图 | module-wise-heatmap.png |
| Figure 3 | 路由动力学分析 | routing-dynamics.png |
| Figure 4 | 收敛对比 | convergence-comparison.png |
| Figure 5 | DMEP 框架总览 | dmep-framework.png |
| Figure 6 | 剪枝后架构 | post-pruning-architecture.png |