CapKV: Rethinking KV Cache Eviction via a Unified Information-Theoretic Objective
基于信息瓶颈原理统一解释KV缓存驱逐方法,提出CapKV——通过统计杠杆分数最大化对数行列式容量目标,显著提升长上下文推理的性能-内存权衡
CapKV: Rethinking KV Cache Eviction via a Unified Information-Theoretic Objective
一、论文概述
| 属性 | 内容 |
|---|---|
| 论文标题 | Rethinking KV Cache Eviction via a Unified Information-Theoretic Objective |
| 论文编号 | arXiv:2604.25975 (v1: 2026-04-28, v2: 2026-08-10) |
| 作者 | Jiaming Yang, Chenwei Tang, Liangli Zhen, Jiancheng Lv |
| 代码 | 见 arXiv 论文链接 |
| 图表 | 13 幅图 / 8 张表 |
摘要:Key-Value (KV) 缓存对大型语言模型推理至关重要,但其内存开销构成了长上下文生成的关键瓶颈。现有驱逐策略主要依赖经验启发式规则,缺乏严格理论基础。本文从信息瓶颈原理重新审视 KV 缓存驱逐。在线性高斯注意力代理下,我们推导出闭式互信息目标,刻画了保留 KV 缓存子集的有效信息容量。该公式揭示了一大类现有驱逐策略可被解释为同一容量最大化原理的不同近似。受此启发,我们提出 CapKV——一种容量感知驱逐方法,通过统计杠杆分数的对数行列式近似直接针对信息保留。该方法以理论上确证机制替代经验启发式选择,最大化保留预测信号。多模型与长上下文基准上的实验表明,CapKV 一致优于已有方法,实现了更优的内存效率与生成品质的权衡。
二、核心思想
2.1 问题定义
现代 LLM 采用自回归 Transformer decoder 架构,自注意力是核心计算。解码步骤 时:
注意力输出:
KV 缓存存储 和 ,但线性增长的缓存大小造成内存瓶颈。问题:给定内存预算 ,选择最优索引集 ,,使压缩表示 保留最大预测信号。
2.2 信息瓶颈视角
经典信息瓶颈寻求中间表示 :
KV 缓存驱逐本质是表示压缩,但与经典 IB 有差异:queries、keys、values 是固定预训练模型产生的中间激活,无学习 encoder,压缩直接通过硬缓存容量约束 施加。关键洞察:自回归解码中,不确定性主要来源于未来 queries。驱逐策略的目标是选择能稳健支持未来 query 多样性的子集 。将未来 query 视为随机变量,保留 KV 子集 为固定条件集, 为注意力输出,定义:
衡量从所选 KV 对经瓶颈传输到输出的 query 信息内容。最大化 鼓励保留的缓存条目支持广泛可能的未来 queries。
2.3 线性高斯代理传输模型
假设 3.1(线性高斯代理传输模型):对给定的保留子集 ,注意力诱导输出 可近似为:
其中 堆叠保留 keys, 堆叠 value 诱导输出方向(如 ), 聚合未建模效应。假设 , 独立于 。
在此框架下,KV 缓存条目被视为通信信道的结构参数,驱逐问题简化为信道设计问题:选择子集 最大化代理信道的信息容量。
2.4 统一信息目标
定理 3.2:在假设 3.1 下,query 与输出 的条件互信息有以下闭式:
四个关键因素:
- Key 可及性 ():哪些 query 方向可通过保留 keys 观测
- Value/输出通道 ():这些方向如何影响模型输出
- Query 统计 ():哪些方向在未来的解码步骤中可能被 query
- 噪声水平 ():建模近似带来的不确定性
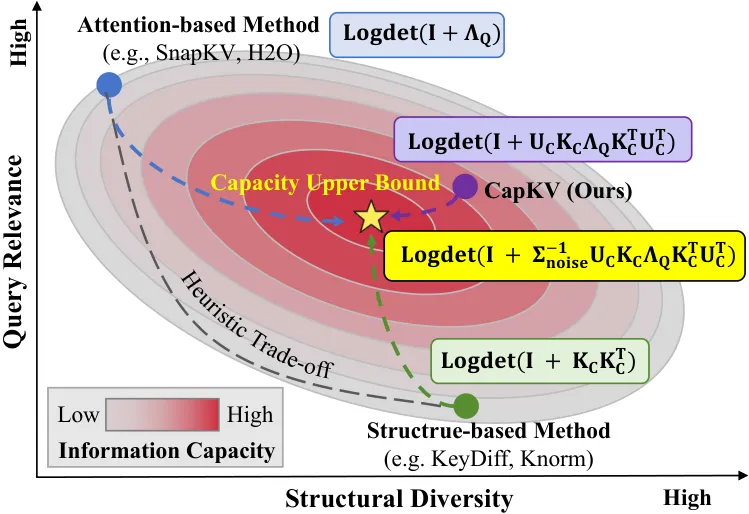
图 1 KV 缓存驱逐的统一信息论视角。横轴反映保留 KV 条目的结构多样性,纵轴反映 query 相关性(与未来可能 query 的对齐度)。KV 缓存驱逐可被视为最大化信息容量目标,现有方法对应不同近似。
三、CapKV 方法
3.1 容量矩阵与对数行列式近似
直接优化式 (5) 在推理时不可行。构造输出空间的容量矩阵:
实践中取输出方向代理 (共享输出投影视为隐式线性变换)。
引理 3.3(矩阵行列式引理):
单步驱逐得分:
3.2 Query 对齐权重
采用基于历史 query 统计的轻量代理:
其中 为可调超参,控制历史 query 信息的影响: 忽略 query 依赖先验,较大值强调与过去 queries 的对齐。 作为低方差重要性先验,补充对数行列式目标中的二阶多样性驱动结构。
3.3 算法流程
Algorithm 1: CapKV
- 输入:KV 缓存 ,历史 queries ,缓存预算
- 计算平均 query
- 对 到 :按式 (9) 计算 query 对齐权重 ,设
- 按式 (6) 计算容量矩阵
- 对 到 :按式 (8) 计算杠杆分数
- 选择 top- 索引
- 返回
3.4 计算复杂度
,其中 为缓存 key-value 对数, 为 value 维度。虽非与序列长度无关,但避免了 的高阶依赖,且相比长上下文解码的总注意力计算开销可忽略。
四、现有方法的统一解释(Appendix B)
4.1 Key 空间多样性方法
简化假设:,,,式 (5) 简化为 。
Knorm(保留 范数大的 key):一阶近似 。保留具有大边际信道增益的 key 方向,但忽略冗余:多个沿相似方向的高范数 key 贡献甚微。
KeyDiff(促进几何差异性):通过抑制 进入容量目标的高阶交互项,间接考虑二阶冗余效应。 等于选定 key 张成的平方体积,最大化它惩罚共线性并促进 key 空间覆盖。
4.2 Attention-Based 与 Query-Aware 方法
SnapKV 等 attention-based 方法通过平均 attention scores 提供 的主特征空间的经验估计。预期 attention 权重:
零均值情形下,与高方差 query 方向对齐的 keys 获得系统性更大的预期 attention。
互补性:attention-based 方法不显式惩罚保留 key 间的冗余。多个与同一主导 query 方向对齐的 key 可能都获得高 attention score——这凸显了 query-aware 与 diversity-driven 准则的互补性。
4.3 小噪声极限
命题 B.1:,,, 为 的特征值:
时,仅 的方向有贡献,容量由诱导信道的非零特征方向的数目和多样性主导——解释了为何冗余消除在紧容量或低噪声 regime 下至关重要。
五、容量代理与性能关联(RQ1)
5.1 三种简化容量代理
为便于分析方法无关的可视化分析,引入三种简化容量代理(假设各向同性 query 分布):
分别捕获 key 空间多样性、输出空间多样性、以及两者的联合效应。仅作为信息保留的诊断指标,不用于预测性能。
5.2 容量-性能强相关
图 3(Qasper)和 图 6(2WikiMQA、MultiFieldQA、Passage-Retrieval)显示:
- 所有方法的保留容量随压缩增加单调递减
- 下游性能更强的方法一致保留更高的容量
- Spearman 0.73–0.87,统计显著( 值极低)
- KeyDiff 偏向高 K-Capacity,但不一致转化为 U-Capacity 或下游性能增益
- 有效信息容量来自 key-value 的联合交互,而非单一空间多样性
结论:KV 缓存驱逐不能简化为优化单一多样性或重要性概念,而需要平衡多个相互依赖因素的统一容量视角。
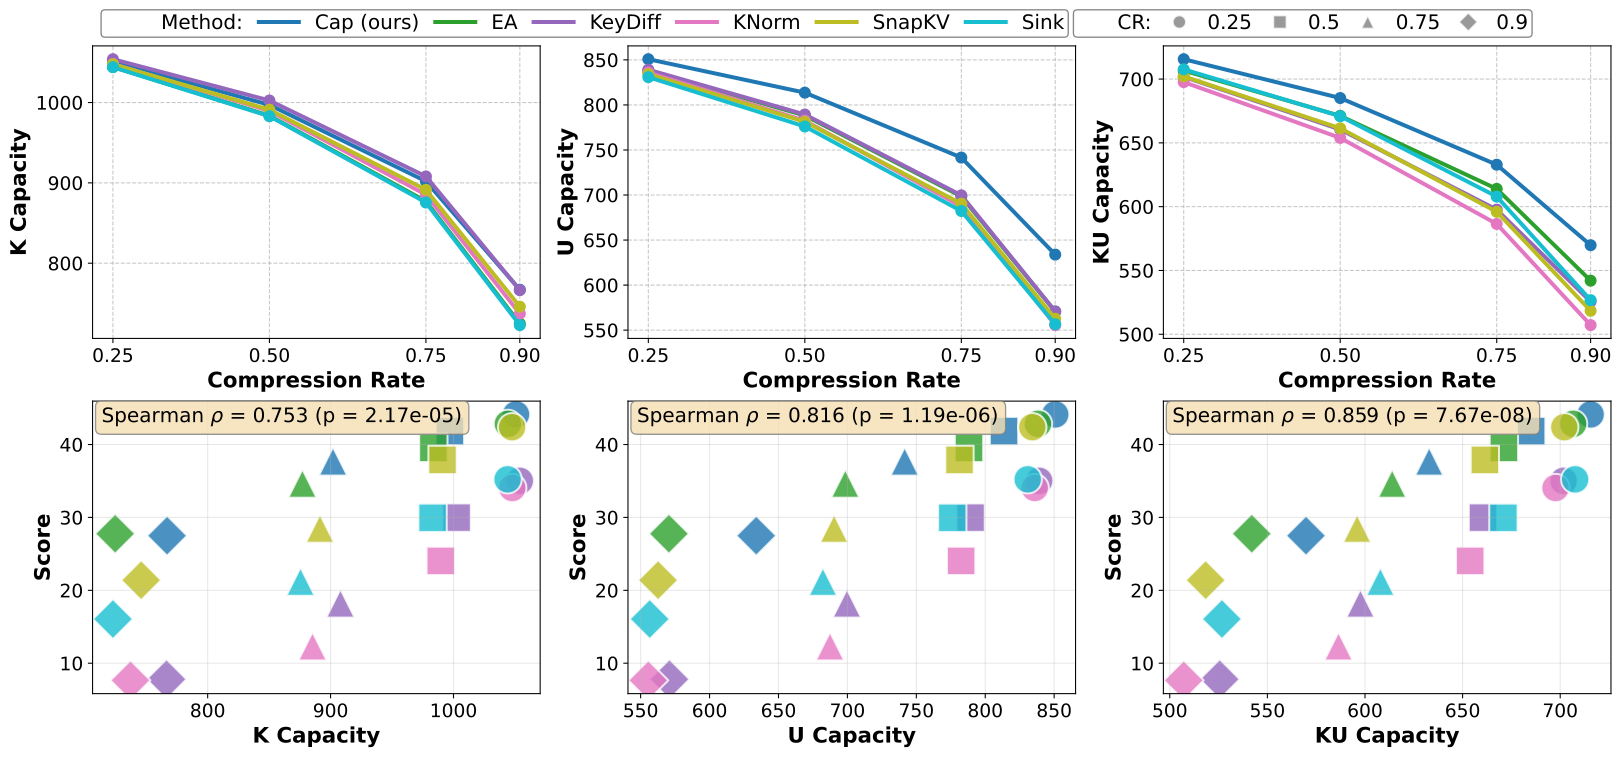
图 3 Qasper 上的容量保留与容量-性能相关性。顶行:不同 KV 缓存驱逐方法在递增压缩比下的保留容量。底行:保留容量与任务性能的散点图,标注 Spearman 等级相关系数与 值。
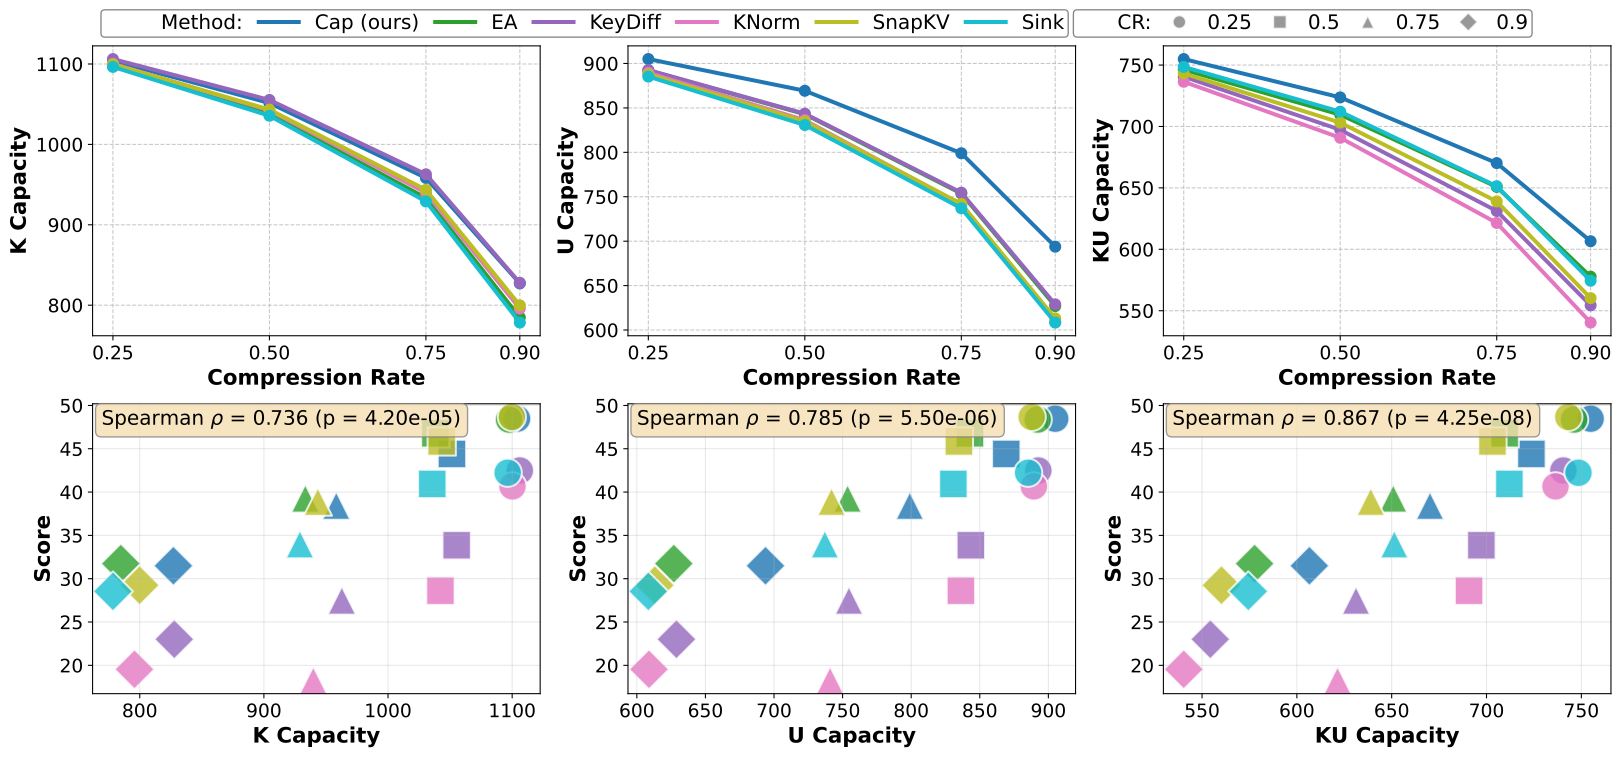
图 6 2WikiMQA、MultiFieldQA、Passage-Retrieval 上的容量-性能相关性分析。
六、实验结果
6.1 实验设置
- 模型:Qwen3-8B(主要)、Qwen3-14B,另加 Llama 3.1-8B、Mistral 0.3-7B、Qwen3-4B、Nemotron-7B
- 基准:LongBench(16 个长上下文任务),AIME25(推理),LongBench v2(超长上下文 32K–128K)
- 基线:EA、KeyDiff、Knorm、SnapKV、Sink
- 压缩比:0.25, 0.5, 0.75, 0.9
- 计算资源:4 × NVIDIA L40S GPU
- CapKV 超参:(全局固定,未按数据集/压缩比微调)
6.2 LongBench 主结果(Table 1)
Qwen3-8B(压缩比 0.25):
| 方法 | Avg | 2WQA | MN | MF | PR |
|---|---|---|---|---|---|
| EA | 47.85 | 48.37 | 24.94 | 53.02 | 91.81 |
| KeyDiff | 44.03 | 42.49 | 24.93 | 49.12 | 91.50 |
| Knorm | 43.48 | 40.66 | 24.51 | 49.59 | 93.00 |
| SnapKV | 46.97 | 48.67 | 24.20 | 51.45 | 91.58 |
| CapKV | 49.51 | 48.47 | 25.05 | 54.26 | 95.54 |
Qwen3-14B(压缩比 0.25):
| 方法 | Avg | 2WQA | MN | MF | PR |
|---|---|---|---|---|---|
| EA | 50.17 | 56.44 | 24.85 | 51.06 | 97.45 |
| KeyDiff | 46.95 | 45.09 | 24.94 | 50.24 | 98.58 |
| Knorm | 46.59 | 43.52 | 24.95 | 52.17 | 100.00 |
| SnapKV | 50.11 | 55.07 | 24.82 | 50.65 | 98.33 |
| CapKV | 50.80 | 54.25 | 24.88 | 52.49 | 99.08 |
关键发现:CapKV 在 Qwen3-8B 和 Qwen3-14B 上均在所有压缩比下取得最高平均得分。对问答任务保持更高精度,对摘要和代码任务降级更平缓。
Llama 3.1-8B(Table 6):CapKV 0.25 得 48.60(基准 45.72,超基线);0.5 得 47.12(基准 43.63)。
Mistral 0.3-7B(Table 7):CapKV 0.25 得 43.46(基准 43.18);0.5 得 43.64。
Qwen3-4B(Table 8):CapKV 0.25 得 47.86(基准 46.63);0.5 得 46.41。
跨模型结论:CapKV 的优势不局限于特定模型规模或架构,泛化至 diverse Transformer backbones。
6.3 AIME25 推理基准(Figure 4)
Nemotron-7B + AIME25,每 512 解码步执行驱逐:
- CapKV 展现出更稳定、更平缓的退化曲线
- 基于局部重要性信号的启发式方法在不可逆设置下遭受更陡的精度下降
- 容量感知驱逐在错误不可纠正的最具挑战性推理 regime 下依然有效
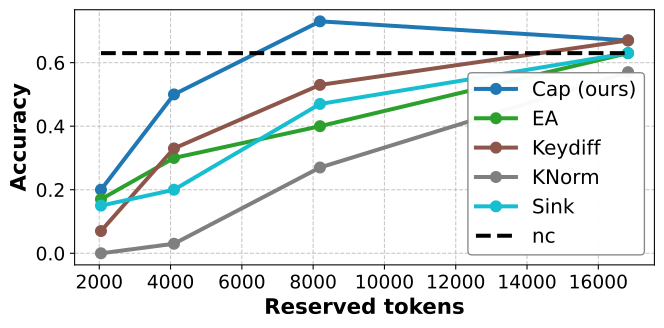
图 4 Nemotron7B 推理模型在 AIME25 上的实验。nc 表示无压缩。
6.4 超长上下文(LongBench v2,Table 5)
32K–128K 序列,采用 YaRN 外推:
| C.R. | EA | KeyDiff | Knorm | SnapKV | CapKV |
|---|---|---|---|---|---|
| 0.5 | 45.4 | 29.4 | 31.9 | 46.2 | 43.7 |
| 0.75 | 45.4 | 31.1 | 23.5 | 38.7 | 47.9 |
| 0.9 | 43.7 | 22.7 | 16.8 | 42.9 | 44.8 |
未压缩基准:44.5。CapKV 在高压缩比(0.75–0.9)下一致超越所有基线,接近未压缩性能。
6.5 消融研究(Table 2)
| Method | C.R. | 2WQA | MN | MF | PR | TREC | Avg |
|---|---|---|---|---|---|---|---|
| CapKV | 0.5 | 44.40 | 24.59 | 51.11 | 98.42 | 66.50 | 57.00 |
| w/ Exact | 0.5 | 43.76 | 24.76 | 51.88 | 98.02 | 67.50 | 57.18 |
| w/ Cov | 0.5 | 47.26 | 23.98 | 50.29 | 97.06 | 64.00 | 56.52 |
| CapKV | 0.75 | 38.44 | 23.12 | 44.16 | 96.96 | 60.50 | 52.64 |
| w/ Exact | 0.75 | 39.29 | 23.35 | 44.18 | 97.54 | 60.00 | 52.87 |
| w/ Cov | 0.75 | 39.71 | 21.84 | 43.63 | 94.92 | 46.00 | 49.22 |
输出方向代理( vs ):精确方向仅带来 <0.23% 平均提升,但复杂度从 升至 ——恒等代理是更优的效率-性能权衡。
Query 感知门控( vs ):协方差基变体略降性能。二阶统计量从有限历史 query 中估计困难,引入显著噪声;均值统计量作为稳健低方差先验稳定驱逐决策。
6.6 敏感性(Table 3)
| C.R. | |||||
|---|---|---|---|---|---|
| 0.25 | 47.61 | 47.66 | 47.94 | 47.02 | 45.85 |
| 0.5 | 46.07 | 46.71 | 46.91 | 46.79 | 45.92 |
| 0.75 | 38.49 | 39.34 | 39.95 | 39.46 | 37.93 |
| 0.9 | 30.19 | 32.05 | 32.11 | 30.41 | 32.41 |
| Avg | 40.59 | 41.44 | 41.73 | 40.92 | 40.53 |
取得最高平均分。过大 导致过度强调少量 key 并降低缓存多样性,激进压缩下性能明显下降。
6.7 与量化兼容性(Table 4)
结合 4-bit HQQ KV-cache 量化,压缩比 0.5 和 0.75:
C.R. = 0.5:CapKV Avg 55.47(基准 55.14,超过全部基线)。 C.R. = 0.75:CapKV Avg 51.26(基准 42.32,显著超越)。
容量感知驱逐标准与低比特 KV-cache 量化兼容,被选中的 KV 条目在附加数值压缩下仍保持信息丰富且稳健。
6.8 运行时效率(Figure 5)
- 所有方法的总生成时间随输入序列长度近似线性增长
- CapKV 在所有评估设置下与现有驱逐方法计算代价相当
- 尽管涉及杠杆分数选择和轻量矩阵运算,但实践中未引入明显运行时开销
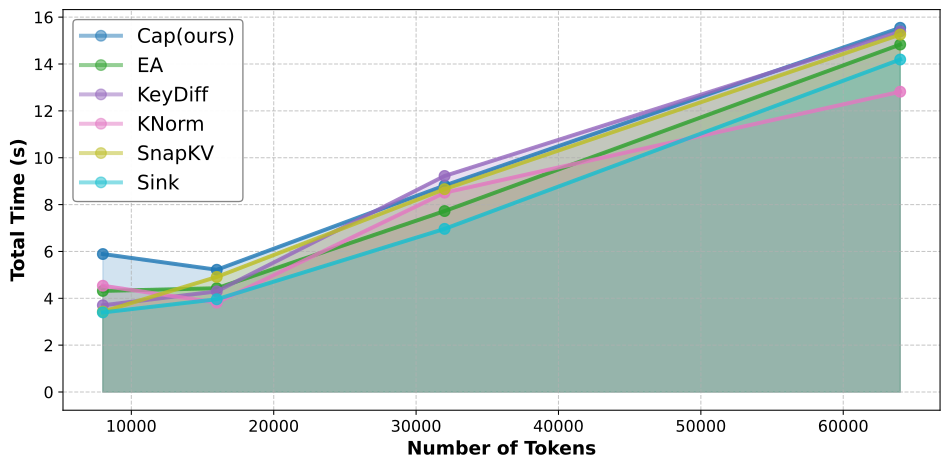
图 5 Qwen3-8B 上不同上下文长度与压缩比下 KV 缓存驱逐方法的运行时对比。
七、核心创新
| 创新点 | 描述 | 理论/实验依据 |
|---|---|---|
| 统一信息论框架 | 将 KV 缓存驱逐形式化为线性高斯信道下的互信息最大化 | 定理 3.2 闭式推导 |
| 现有方法统一解释 | 证明多种启发式策略是同一容量目标的差异化近似 | Appendix B 一阶/二阶分析 |
| CapKV 算法 | 基于对数行列式近似与统计杠杆分数的确定性驱逐策略 | Algorithm 1, |
| 容量-性能关联验证 | 三种容量代理与下游性能 Spearman 0.73–0.87 | Figure 3 & 6,4 数据集 |
| 跨模型泛化 | 在 Qwen3、Llama 3.1、Mistral、Nemotron 上验证 | Table 1–8,5 模型家族 |
| 与量化兼容 | 与 4-bit HQQ 联合使用仍最优 | Table 4 |
| 超长上下文鲁棒 | 32K–128K 仍优于基线 | Table 5 |
八、结论
8.1 核心贡献
- 基于信息瓶颈原则建立原理性的分析框架,将 KV 缓存驱逐形式化为线性高斯信道下的互信息最大化,统一不同启发式策略
- 提出 CapKV,一种明确优化缓存信息容量的新型驱逐方法,通过简化容量矩阵的统计杠杆分数提供确定性近似
- 多模型、多长上下文基准的广泛实验表明,CapKV 一致优于现有 SOTA,实现更优的生成品保-内存效率权衡
8.2 实践启示
- KV 缓存驱逐不应简化为单一多样性或重要性概念,而需平衡 key 可及性、value 输出通道、query 统计和噪声水平的联合效应
- 容量-性能强相关( 0.73–0.87)为方法选择提供了可解释的诊断指标
- 超参 中等值()最优——query 相关性应与多样性保持平衡,过大值导致多样性损失
- 代理已足够——精确输出方向仅带来 <0.23% 提升却大幅增加计算
- 容量感知驱逐可与量化技术正交组合——两种压缩手段互补
8.3 局限性
- 线性高斯代理是对真实 Transformer 非线性注意力动力学的简化——虽为分析 tractability,但并非精确刻画
- 未来 query 分布协方差 在实际推理中无法精确已知,当前使用均值代理为近似的子最优方案
- 未评估训练式稀疏注意力方法(区别于 Sparse Frontier 论文),但本文作者认为训练无关方法的洞见可迁移
- 仅评估 4 个开源模型家族,其他架构(如 MoE、状态空间模型)需进一步验证
九、参考资源
- arXiv: https://arxiv.org/abs/2604.25975
- HTML 版本: https://arxiv.org/html/2604.25975v2
- PDF 版本: https://arxiv.org/pdf/2604.25975
- 代码: 见论文链接
- 评估模型: Qwen3-8B/14B, Llama 3.1-8B, Mistral 0.3-7B, Qwen3-4B, Nemotron-7B
- 对比方法: EA, KeyDiff, Knorm, SnapKV, Sink
- 基准: LongBench(16 任务), AIME25, LongBench v2
- 计算资源: 4 × NVIDIA L40S GPU