Kwai Summary Attention (KSA):一种序列级 KV Cache 压缩的高效长上下文注意力机制
快手 OneRec 提出的序列级语义压缩注意力,通过可学习 summary token 实现 O(n/k) 的 KV Cache,长上下文精度匹配或超越 Full attention
Kwai Summary Attention (KSA):一种序列级 KV Cache 压缩的高效长上下文注意力机制
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Kwai Summary Attention Technical Report |
| 作者 | Chenglong Chu, Guorui Zhou*, Guowang Zhang, Han Li, Hao Peng, Hongtao Cheng*, Hui Wang, Jian Liang, Jiangxia Cao†, Kun Gai, Lingzhi Zhou, Lu Ren, Qi Zhang, Ruiming Tang†, Ruitao Wang*, Xinchen Luo*, Yi Su*, Zhiyuan Liang, Ziqi Wang 等(快手 OneRec Team) |
| 机构 | 快手 OneRec Team |
| 论文 | arXiv:2604.24432 |
| 代码 | github.com/Kuaishou-OneRec/KSA |
| 模型 | HuggingFace: OpenOneRec/KSA-4B-base |
| 发布 | 2026-04-27 (v1) / 2026-07-05 (v2) |
| 许可 | Apache 2.0 |
核心问题与贡献
该论文解决长上下文推理下 vanilla attention 的双重开销问题:随序列长度增长,KV cache 线性膨胀()、注意力计算二次膨胀(),存储与算力开销不可承受。KSA 主张走一条被忽视的中间道路——序列级语义压缩:既不追求最小 KV cache(如 MLA/GDN 的严格线性/常数压缩),也不保留完整 token 级历史(如 Full/SWA),而是以 的 KV cache 保留对远距离历史的完整可寻址性与可解释性。
主要贡献包括:
- 提出 Kwai Summary Attention (KSA):通过可学习 summary token 做序列级压缩,KV cache 复杂度降为
- 设计 Sliding Chunk Attention (SCA) 与三段式连续 KV cache 布局,实现无需拼接/gather 的高效解码内核
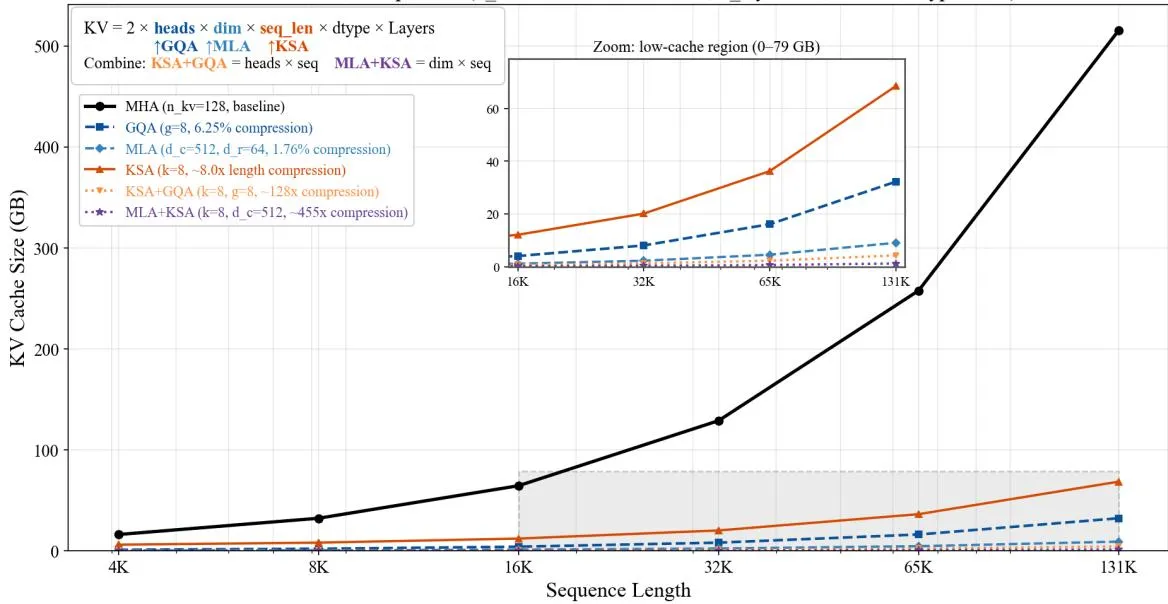
- 证明 KSA 与 GQA/MLA 正交,压缩率可相乘(KSA+GQA≈0.78%,KSA+MLA≈0.22%)
- 提出 Hybrid-KSA(KSA:Full=3:1)架构配方,在 11 个基准上系统验证:长上下文匹配或超越 Full attention,通用基准差距最小
二、核心思想
背景:长上下文成为 LLM 关键 scaling 维度
Transformer 的 scaling law 已在数据量、参数量、算力三个方向取得成功;序列长度提供了同样关键的第四个维度。随着并行基础设施进步,有效上下文窗口已从早期约 1K 扩展至 128K~1M(Anthropic Claude Opus 4.6、Kimi K2.6、LongCat、Qwen3.5、GLM-5)。长上下文能力能显著降低幻觉,并孵化 Code Agent、推荐系统超长用户行为建模等复杂应用。在 Agent 时代,跨多轮获取巨大记忆并精确检索历史上下文,是高度智能体与长链推理的前提。
核心瓶颈
标准 Softmax Attention 面临两个不可接受的开销:
- KV Cache 线性增长 :成为长序列推理的内存瓶颈
- Attention 计算二次增长 :训练与 prefill 阶段成本急剧上升
现有两条技术路线及其局限
路线一:单层内压缩 KV Cache(GQA、MLA)
- GQA:按 head 分组共享 KV,KV Cache 降为
- MLA(DeepSeek-V2/V3):低秩投影()压缩每层 KV
- 局限:KV Cache 仍与序列长度保持严格 1:1 线性关系
路线二:KV Cache 友好的架构混合(SWA、Linear/GDN)
- SWA:每个 token 仅关注窗口内邻居,KV Cache 为
- 线性 Attention(RWKV/Mamba/GDN):用固定大小状态替代注意力矩阵
- 局限:线性 Attention 固定状态为有损压缩,远期信息模糊不可追溯;SWA 完全丢弃窗口外信息
KSA 的核心洞察——被忽视的中间路径
作者认为存在第三条路径:
维持 KV Cache 与序列长度的线性关系,但通过特定压缩比 实现语义级压缩,即 路径。
这条路径不追求”最小 KV Cache”(如 Linear Attn 的 ),而是以可接受的内存代价,换取对长程依赖的完整、可参考、可解释保留。
三、技术架构
整体框架与核心机制
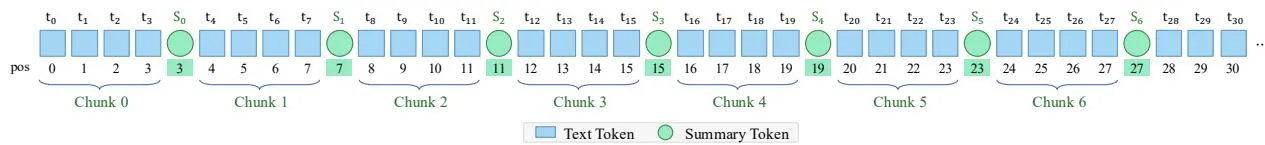
KSA 核心机制:
- 摘要 Token 注入:输入序列 按 chunk size 切分为 个 chunks,在每个 chunk 末尾注入可学习摘要 embedding
- 信息路由规则:
- 摘要 token → 仅 attend 当前 chunk 内的原始 tokens
- 文本 token → 关注滑动窗口内文本 + 之前所有 chunks 的摘要 tokens
- 非重叠设计:每个 past chunk 要么”作为原始文本完全可见”,要么”仅通过其 summary 访问”,永不双重计数
核心公式
1. 序列分块与 Summary Token 注入
把长度为 的序列切成大小为 的 chunk,每个 chunk 末尾追加共享可学习 summary token :
2. 文本 token 的完整可见范围(Eq. 2–3)
当前位置 的局部上下文(Sliding Chunk)为:
\left[ t_{(\lfloor i/k\rfloor - C)\cdot k}, \ldots, t_{i-1}, t_i \right] \tag{2}
远距离历史通过已累积的 summary token 访问,二者拼接为完整可见范围:
\underbrace{\left[ s_0, s_1, \ldots, s_{\lfloor i/k\rfloor - C - 1} \right]}_{\text{distant summary tokens}} \cup \underbrace{\left[ \text{local sliding chunk} \right]}_{\text{recent text}} \tag{3}
其中 为滑动窗口覆盖的 chunk 数(默认 128)。
3. 摘要 token 独立参数与退火融合
摘要 token 使用独立投影权重(退火前):
退火融合策略—— 从 1 线性递减到 0,最终独立摘要权重完全融入主权重,推理时无额外参数:
对 text/summary 分别投影(统一写法):
\hat{X}_t = \begin{cases} \hat{\mathcal{T}}_t(W^X)^\top, & t \notin \mathcal{S}, \\ \hat{\mathcal{T}}_t(W_\mathcal{S}^X)^\top, & t \in \mathcal{S}. \end{cases} \tag{8}
4. KSA 注意力(带 chunk 结构掩码)
标准注意力 扩展为带结构掩码 的形式:
\hat{O} = \operatorname{softmax}\left(\hat{Q}\hat{K}^\top/\sqrt{d} + \mathcal{M}_{\mathrm{KSA}}\right)\hat{V}. \tag{10}
5. 训练目标——注意力蒸馏
用 Full attention 作为 teacher,对 text token 的中间表示与最终分布做 MSE + KL 蒸馏:
\mathcal{L} = \mathcal{L}_{LM} + \alpha \mathcal{L}_{MSE} + \beta \mathcal{L}_{KL} \tag{1}
Sliding Chunk Attention(而非 token 级 SWA)
传统 SWA(token-level 滑动窗口)在与摘要 token 配合时会出现边界切割问题——窗口可能截断某个 chunk,导致部分 text token 既不在窗口内也不被视为远处摘要,造成信息割裂。KSA 采用 Sliding Chunk Attention (SCA),以 chunk 为滑动粒度,保证”每个 past chunk 要么全在窗口内、要么全在窗口外”。
| Token 类型 | 可见范围 | 作用 |
|---|---|---|
| 摘要 Token () | 仅当前 chunk 内的文本 tokens | 专注压缩当前 chunk 语义,避免递归压缩误差累积 |
| 文本 Token () | ① 滑动窗口内相邻文本 tokens + ② 之前 chunks 的全部摘要 tokens | 局部细粒度 + 全局摘要 |
三段式连续 KV Cache 布局
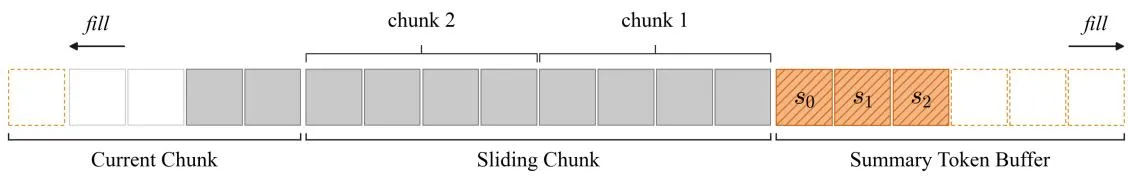
KSA 的 KV Cache 组织为三个连续区域(Current Chunk / Sliding Chunk ring buffer / Summary Token Buffer):解码时无需拼接、gather 或动态 mask,所有 tensor 连续存放,物理布局直接编码可见性规则,支持高效内存访问;生命周期包括写入新 token、插入 summary、原地回收 chunk。
Hybrid-KSA
KSA 层与 Full attention 层按 3:1 交错(默认配置):纯 KSA 在极长依赖检索上略弱,插入少量 Full 层充当”跨 chunk 集成器”,恢复全局精确寻址,兼顾检索精度与成本。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 序列级语义压缩(非 token-level) | 以 chunk 为单位压缩序列长度维度,而非 head 或 embedding 维度,实现 KV Cache | 128K 下 KV cache 仅 Full 的 ~12.5%,压缩 2.5–2.8× |
| 压缩正交性 | KSA 压缩 PastToken、GQA 压缩 HeadNum、MLA 压缩 EmbeddingDim,三轴独立可相乘 | KSA+GQA≈0.78%,KSA+MLA≈0.22% |
| Sliding Chunk Attention | 以 chunk 为滑动粒度对齐边界,避免 token 级 SWA 的边界切割导致的信息割裂 | 消融显示 SCA 优于 SWA(RULER 全长领先) |
| 块稀疏注意力内核 | 利用 KSA mask 的结构化稀疏性,仅加载非零 block pair,避免 dense mask | 训练/Prefill 阶段显著加速 |
| 连续 KV Cache 布局 | 物理布局编码可见性规则,解码期单次连续切片读取,无需 concat/gather | 硬件友好,16K decode 吞吐达 Full 的 1.06× |
| 非重叠 token 路由 | 窗口内看原始 token,远处仅通过摘要访问 | 避免双重计数,信息不重叠 |
| 参数退火融合 | 摘要独立权重按 逐步融入主权重 | 推理零额外参数开销 |
五、代码实现分析
项目结构
KSA/
├── muse/                           # 核心训练框架
│   ├── modeling_qwen3sa.py         # Qwen3-SA 模型定义(含 KSA 注意力层)
│   ├── layers/                     # 自定义注意力层逻辑
│   └── train/                      # 训练循环
├── recipes/                        # 统一预训练入口脚本
├── summary_attention_kernel/       # 块稀疏注意力 CUDA 内核
│   ├── prefill_kernel.cu           # Prefill 阶段内核
│   └── decode_kernel.cu            # Decoding 阶段内核
├── examples/
│   ├── pretrain/                   # 渐进式长度扩展配方
│   │   ├── model_config/           # 模型配置 JSON
│   │   ├── run_pretrain_{8,32,64,128}k.sh
│   │   └── hf_template/            # HuggingFace 兼容模板
│   └── inference/                  # 推理与权重转换
├── dockerfile/                     # Ubuntu 24.04 + CUDA 12.6 + PyTorch 2.6.0
└── data/                           # 用户需自行放置 mmap 语料库
关键文件
| 文件 | 功能 |
|---|---|
muse/modeling_qwen3sa.py | 主模型定义,包含 KSA 注意力层的 forward 计算 |
summary_attention_kernel/prefill_kernel.cu | 块稀疏 prefill CUDA 核,利用结构化稀疏避免 dense mask |
summary_attention_kernel/decode_kernel.cu | 解码内核,配合三段式连续 KV cache 布局 |
examples/pretrain/model_config/ | 不同长度下的超参配置(chunk size、sliding chunks、hybrid ratio) |
训练配置
基础模型:基于 Qwen3
- 1.9B:从零训练(from scratch),开源代码与配置,不发布权重
- 4B:持续预训练(CPT),基于 Qwen3-4B-base 注入 128K 上下文能力,权重已开源
分布式训练:FSDP + DCP (Distributed Checkpointing) + FlashAttention 2 + 自定义块稀疏内核
关键实现细节:
- 推理阶段退火融合后无需 additional parameters
- 块稀疏 kernel 利用 KSA mask 结构化稀疏,仅计算非零 block pair
- 三段式连续 KV cache 生命周期确定:写入 token → 插入 summary → 原地回收 chunk
六、实验结果
实验设置
模型配置(表 2):
| Configuration | From Scratch | Continual Pretraining |
|---|---|---|
| Number of layers | 24 | 36 |
| Hidden size | 2048 | 2560 |
| Intermediate size | 6144 | 9728 |
| Attention heads (Q/KV) | 16/16 | 32/8 |
| Head dimension | 128 | 128 |
| Hybrid architecture ratio (KSA:Full) | 3:1 | 3:1 |
| Summary chunk size | 8 | 8 |
| Sliding chunk number | 128 | 128 |
| Tied embeddings | False | True |
训练配方(表 3):
| Configuration | From Scratch | Continual Pretraining |
|---|---|---|
| Sequence Length Stages | 8K/32K/64K/128K | 32K/64K/128K |
| Token Budget per Stage | 250B/50B/50B/50B | 25B/35B/25B |
| Max Learning Rate | 8K:; ≥32K: | All: |
| Min Learning Rate | ||
| RoPE Theta | 8K:; ≥32K: | |
| Optimizer | AdamW () | AdamW |
| Weight Decay | 0.01 | 0.01 |
| LR Schedule | WSD | WSD |
| Gradient Clipping | 1.0 | 1.0 |
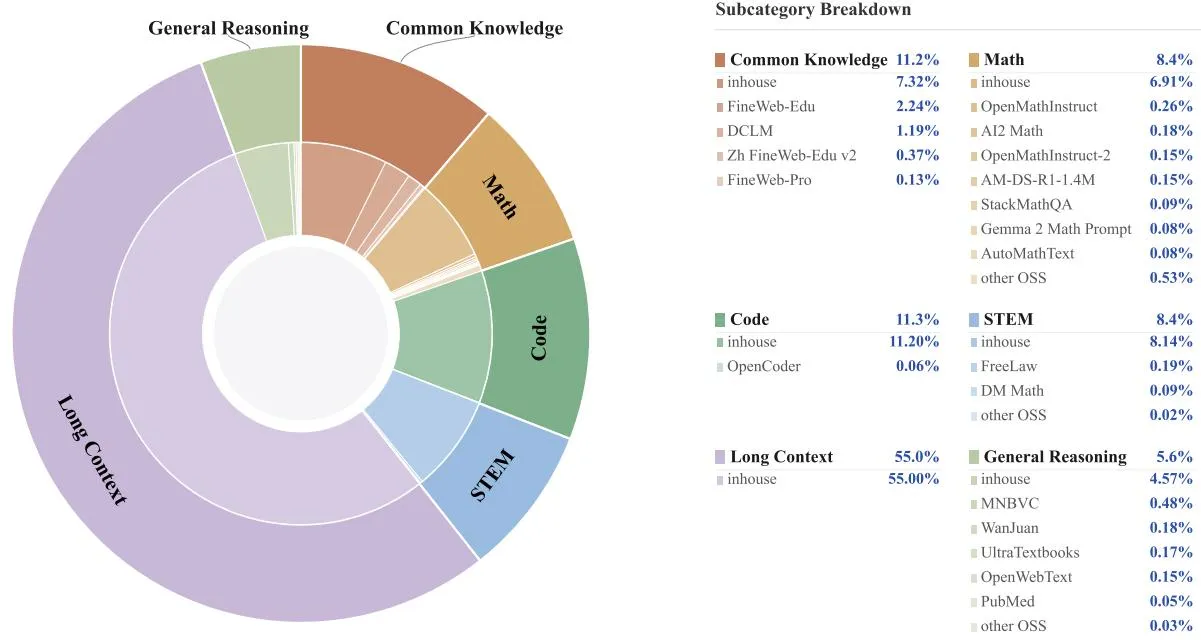
持续预训练(CPT)性能对比(表 4)
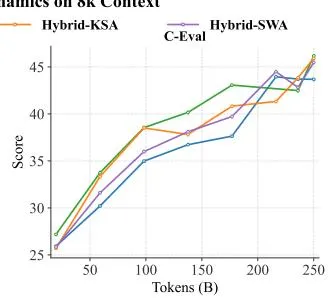
在 RULER 长上下文检索与通用/数学/代码基准上,Hybrid-KSA 全面接近或超越 Full attention,且显著优于 Hybrid-SWA / Hybrid-SCA / Hybrid-Linear。
| Benchmarks | Full | Hybrid-SWA | Hybrid-SCA | Hybrid-Linear | KSA | Hybrid-KSA |
|---|---|---|---|---|---|---|
| RULER-4K | 92.88 | 91.30 | 86.02 | 86.39 | 91.55 | 92.97 |
| RULER-8K | 91.38 | 88.03 | 84.28 | 83.86 | 86.78 | 90.53 |
| RULER-16K | 89.12 | 82.87 | 80.67 | 78.06 | 84.78 | 88.86 |
| RULER-32K | 84.74 | 78.94 | 76.89 | 76.48 | 80.30 | 86.65 |
| RULER-64K | 78.16 | 73.88 | 68.88 | 73.50 | 76.09 | 76.04 |
| RULER-128K | 65.86 | 66.27 | 60.94 | 67.98 | 66.81 | 71.67 |
| MMLU | 71.83 | 70.57 | 69.83 | 64.33 | 70.73 | 70.50 |
| CMMLU | 75.00 | 73.69 | 72.59 | 68.41 | 73.29 | 72.63 |
| C-Eval | 73.66 | 72.36 | 71.66 | 67.42 | 72.14 | 72.66 |
| MMLU-Pro | 46.36 | 45.23 | 45.11 | 38.83 | 45.70 | 45.39 |
| CMath | 83.41 | 84.84 | 83.16 | 79.09 | 84.58 | 84.25 |
| GSM8K | 82.75 | 81.92 | 80.10 | 72.44 | 81.09 | 79.50 |
| MATH | 47.48 | 48.24 | 47.45 | 42.57 | 48.15 | 47.56 |
| MBPP | 61.30 | 61.70 | 59.60 | 55.30 | 61.50 | 62.20 |
| HumanEval | 58.54 | 61.89 | 61.89 | 54.58 | 60.97 | 62.50 |
| Average | 73.50 | 72.12 | 69.94 | 67.28 | 72.30 | 73.59 |
要点:RULER-128K 上 Hybrid-KSA 71.67,超过 Full 65.86(+5.81);平均 73.59 与 Full 73.50 基本持平,但 KV cache 仅 Full 的 ~12.5%。
从零训练(From-Scratch)性能对比(表 5)
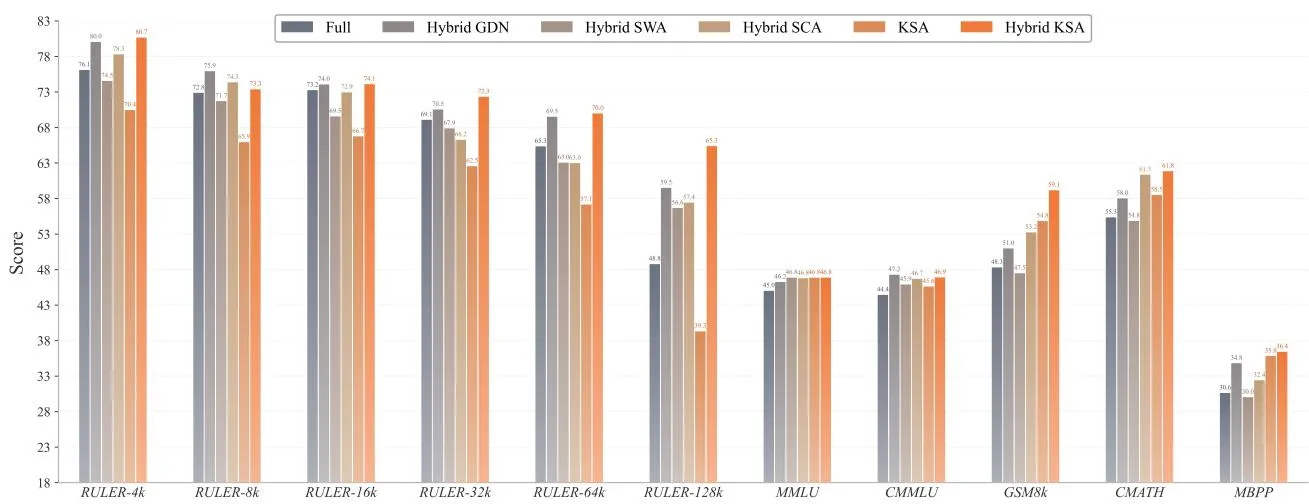
| Benchmarks | Full | Hybrid-SWA | Hybrid-SCA | Hybrid-GDN | KSA | Hybrid-KSA |
|---|---|---|---|---|---|---|
| RULER-4K | 76.08 | 74.54 | 77.72 | 79.83 | 70.44 | 80.65 |
| RULER-8K | 72.85 | 71.69 | 75.22 | 76.01 | 65.91 | 73.35 |
| RULER-16K | 73.24 | 69.54 | 72.55 | 74.04 | 66.74 | 74.07 |
| RULER-32K | 69.06 | 67.86 | 67.74 | 70.41 | 62.54 | 72.30 |
| RULER-64K | 65.32 | 63.03 | 63.54 | 69.39 | 57.13 | 69.95 |
| RULER-128K | 48.75 | 56.64 | 58.01 | 59.87 | 39.29 | 65.35 |
| MMLU | 44.99 | 46.84 | 46.77 | 46.23 | 46.83 | 46.83 |
| CMMLU | 44.41 | 45.89 | 46.42 | 47.19 | 45.59 | 46.88 |
| C-Eval | 44.28 | 43.54 | 47.62 | 45.54 | 45.69 | 44.13 |
| MMLU-Pro | 19.48 | 20.46 | 20.10 | 21.22 | 21.72 | 22.52 |
| CMath | 55.33 | 54.83 | 62.33 | 58.00 | 58.50 | 61.83 |
| GSM8K | 48.29 | 47.46 | 52.39 | 50.95 | 54.81 | 59.14 |
| MATH | 23.38 | 31.46 | 28.82 | 33.30 | 30.04 | 36.92 |
| MBPP | 30.60 | 30.00 | 31.60 | 34.80 | 35.80 | 36.40 |
| HumanEval | 25.61 | 28.05 | 26.83 | 27.44 | 29.88 | 31.71 |
| Average | 49.44 | 50.12 | 51.84 | 52.95 | 48.73 | 54.80 |
要点:从零训练下 KSA 差距被放大(RULER-128K 仅 39.29),但 Hybrid-KSA 65.35 远超 Full 48.75(+16.60),平均 54.80 亦为各方案最高——说明混合 Full 层对从零训练的长上下文收敛至关重要。
Needle-in-a-Haystack(表 6)
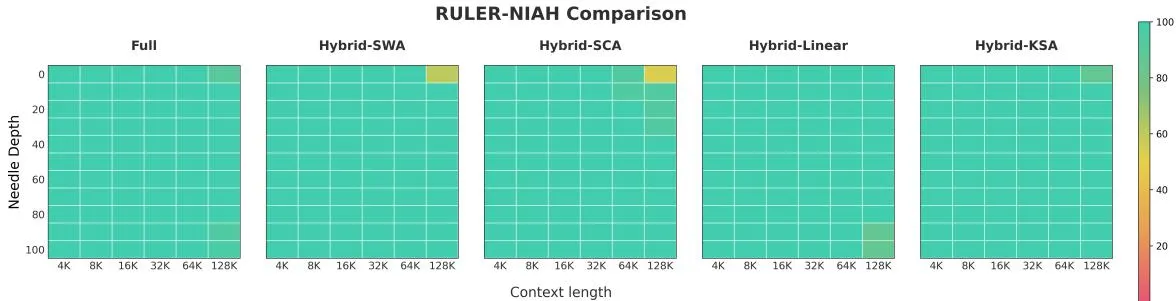
| Subtasks | Full | Hybrid-SWA | Hybrid-SCA | Hybrid-Linear | KSA | Hybrid-KSA |
|---|---|---|---|---|---|---|
| NIAH-Single | 100.00 | 100.00 | 99.16 | 100.00 | 97.50 | 100.00 |
| NIAH-Multikey | 75.00 | 74.16 | 70.84 | 79.16 | 74.16 | 75.84 |
| NIAH-Multivalue | 88.12 | 83.75 | 91.25 | 95.62 | 83.75 | 98.75 |
| NIAH-Multiquery | 95.62 | 93.12 | 98.12 | 99.38 | 95.62 | 98.12 |
| VT | 60.50 | 67.50 | 42.50 | 87.50 | 65.50 | 90.50 |
| FWE | 51.66 | 51.66 | 33.33 | 23.33 | 72.50 | 65.84 |
| SQuAD | 30.00 | 30.00 | 15.00 | 35.00 | 32.50 | 42.50 |
复杂检索子任务上 Hybrid-KSA 优势明显:NIAH-Multivalue 98.75(+10.63)、VT 90.50(+30.0)、FWE 65.84(+14.18)、SQuAD 42.50(+12.5)。
推理效率分析
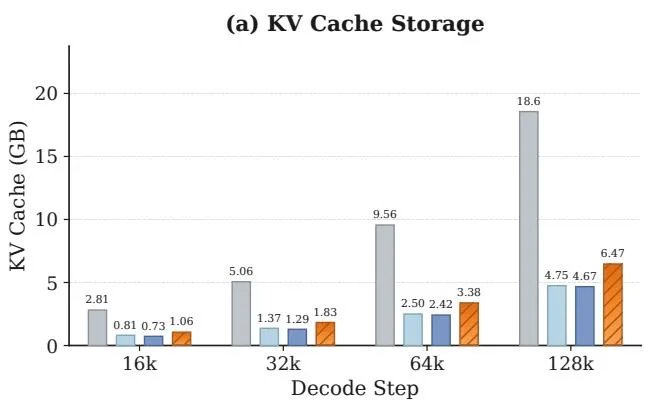
KV Cache 显存占用(128K 上下文): Hybrid-KSA 6.47 GB,相对 Full (GQA) 18.6 GB 压缩约 2.5–2.8×。
Decode Throughput(128K 上下文):
| 机制 | Tokens/s | 相对 Full |
|---|---|---|
| Full (GQA) | 11.0 | 1.0× |
| Hybrid-SWA | 27.5 | 2.5× |
| Hybrid-Linear | 34.7 | 3.2× |
| Hybrid-KSA | 25.4 | 2.3× |
Hybrid-KSA 显存减少约 2.8× 的同时保持接近最优的 decode 吞吐;16K decode 吞吐可达 Full 的 1.06×。
训练收敛
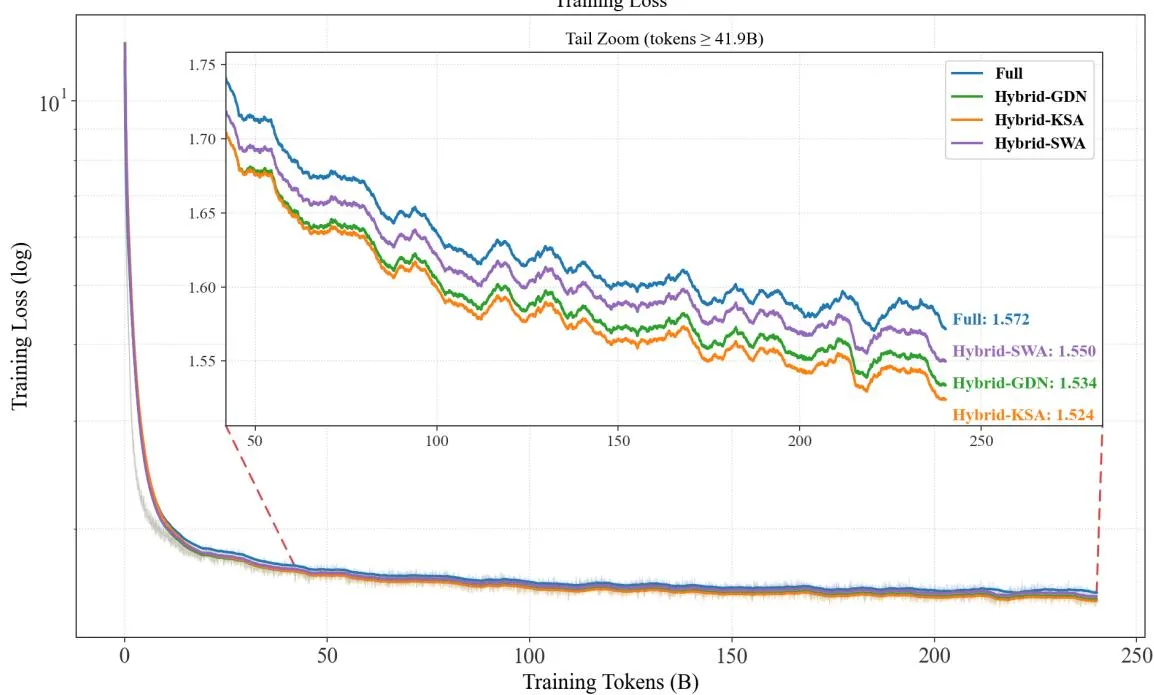
| 设置 | Full | Hybrid-KSA |
|---|---|---|
| From Scratch 最低 loss | 1.572 | 1.524 |
| CPT 最低 loss | 1.891 | 1.867 |
Hybrid-KSA 在多阶段训练中收敛更快且达到更低 loss。
设计消融(表 7)
(a) Chunk Num (N):N=64 平均最高(83.16),N=128 默认下 RULER-64K 反而最好(76.35),说明更大滑动窗口利于超长检索。 (b) Chunk Size (S):S=8 默认在 RULER-64K(76.35)与平均上均衡;S 增大检索掉点,但短上下文略有收益(S=64 在 4K 达 86.50)。 (c) Hybrid Ratio (Summary:Full):1:1 长上下文最弱(RULER-128K 69.36),3:1 默认在 64K 检索最佳(76.35),5:1 在短上下文(4K 93.75)更强但 128K 掉到 70.31——3:1 是性能/成本的最优折中。
| Configuration | 4K | 8K | 16K | 32K | 64K | RULER Avg. | GSM8K | CMath | MBPP |
|---|---|---|---|---|---|---|---|---|---|
| N=32 | 91.02 | 89.46 | 84.42 | 78.35 | 70.74 | 82.80 | 81.23 | 83.59 | 60.50 |
| N=64 | 93.36 | 88.65 | 87.21 | 76.91 | 69.69 | 83.16 | 80.13 | 83.00 | 61.20 |
| N=128 (Default) | 88.69 | 88.01 | 83.62 | 78.19 | 76.35 | 82.97 | 80.75 | 82.48 | 60.20 |
| N=256 | 92.05 | 88.30 | 83.86 | 79.40 | 65.73 | 81.87 | 81.16 | 84.92 | 61.60 |
| S=8 (Default) | 88.69 | 88.01 | 83.62 | 78.19 | 76.35 | 82.97 | 80.75 | 82.48 | 60.20 |
| S=16 | 88.77 | 83.78 | 82.20 | 77.34 | 71.97 | 80.82 | 80.81 | 83.59 | 61.20 |
| S=32 | 90.21 | 84.66 | 80.26 | 77.31 | 75.09 | 81.50 | 81.23 | 83.25 | 61.20 |
| S=64 | 86.50 | 81.61 | 78.12 | 72.63 | 70.09 | 77.79 | 80.48 | 81.84 | 62.10 |
| 1:1 | 84.50 | 82.85 | 82.16 | 74.76 | 69.36 | 78.72 | 81.09 | 84.50 | 60.40 |
| 3:1 (Default) | 88.69 | 88.01 | 83.62 | 78.19 | 76.35 | 82.97 | 80.75 | 82.48 | 60.20 |
| 5:1 | 93.75 | 89.12 | 87.54 | 78.47 | 70.31 | 83.84 | 79.83 | 83.41 | 59.20 |
| 8:1 | 90.80 | 85.88 | 78.94 | 71.83 | 66.19 | 78.73 | 79.98 | 82.91 | 58.10 |
KV Cache 压缩率全景对比(表 1)
| Mechanism | Effective Context | KV Cache Size (n→∞) | Compression Rate |
|---|---|---|---|
| MHA | (exactly) | - | |
| GQA | (exactly) | ||
| MLA | (exactly) | ||
| GDN | (ambiguous) | ||
| SWA | (exactly) | ||
| KSA () | (summarized) | ||
| KSA + GQA | (summarized) | ||
| KSA + MLA | (summarized) |
(参数:、、、、、。)关键洞察:KSA 减少的是要 attend 的 token 数量本身,GQA/MLA 减少的是每 token 的存储维度,二者正交、压缩比可相乘。
七、相关工作
Sequence-Level Compression 家族
| 方法 | 机制 | 与 KSA 差异 |
|---|---|---|
| AutoCompressors (Chevalier et al., 2023) | 跨 chunk 递归积累 last-layer summary vectors | KSA 无递归,每个 token 恰好被压缩一次 |
| Activation Beacon (Zhang et al., 2025b) | 逐层 key-value 激活压缩并跨 chunk 累积 | KSA 在注意力层面压缩,非激活层面 |
| UniGist (Deng et al., 2025) | 统一稀疏 gist layout,单遍训练 | KSA 采用 chunk-local 而非全局 gist |
| DAST (Chen et al., 2025) | 推理时动态按信息密度分配 soft-token 预算 | KSA 使用固定 chunk boundary 压缩 |
| AdmTree (Li et al., 2025) | 自适应语义树 + 双向自注意力聚合 leaf gist | KSA 为单向 chunk-boundary,无树结构 |
与高效 Attention 的定位对比
| 特性 | KSA | Linear/GDN | SWA | Sparse Attn |
|---|---|---|---|---|
| KV Cache 增长 | ||||
| 远期信息可追溯 | ✅ 完整可查 | ❌ 有损模糊 | ❌ 窗口外不可见 | ✅ 选择性 |
| 实现复杂度 | 中等 | 低 | 极低 | 高(需动态路由) |
| 硬件友好度 | 高(连续内存) | 高 | 极高 | 低 |
| 适用场景 | 长程检索+推理 | 生成速度优先 | 本地模式为主 | 均衡 |
横向定位(与已分析工作对比)
| 论文 | 优化层面 | 核心手段 | 主要收益 |
|---|---|---|---|
| SageAttention2++ | 注意力计算内核 | FP8 Matmul 改用 FP16 累加器 | 相对 FA2 最高 3.9× 加速,精度无损 |
| FlashAccel | 推理内存/硬件 | HBF 高带宽闪存 + GPU 协同 | 每 GPU 吞吐 2.54×、能效 1.93× |
| KSA(本文) | 注意力算法/表示 | chunk summary token + sliding chunk | KV cache 压缩 2.5×,长上下文精度≥Full |
三者互补:KSA 改”算什么”,SageAttention2++ 改”怎么算得快”,FlashAccel 改”存得下”,工程上可叠加。
八、总结
核心贡献
- 提出 KSA 机制:一种序列级压缩注意力,通过可学习 summary token 实现 的 KV Cache,兼具完整可寻址性与可解释性
- 块稀疏训练内核 + 连续 KV Cache 布局:支持高效训练与推理,退火融合后推理零额外参数
- Hybrid-KSA 架构配方:3:1 混合比例取得最佳性价比
- 在 11 个基准上的系统性验证:几乎所有长上下文任务超越或匹配 Full attention,通用基准差距最小(CPT RULER-128K 71.67>Full 65.86;From-Scratch 65.35>Full 48.75,+16.60)
- 完全开源:训练脚本、CUDA 内核、HF 兼容模板与 4B 权重均已公开
技术影响
- 长上下文推理经济:128K 上下文 KV Cache 减少约 2.5–2.8×,吞吐提升约 2.3×
- 与主流架构正交:可与 GQA/MLA 组合,最高进一步压缩至 0.22%
- 特别适合 Agentic RL:完整可追溯的远程依赖对多步推理与用户行为建模至关重要
局限性
- 当前仅完成 Pre-training 阶段,尚未探索 post-training(SFT、偏好优化、RLHF)
- 压缩比 与模型容量、任务难度的 Scaling Laws 尚未充分探索
- 纯 KSA 在从零训练与极端检索上弱于 Hybrid;summary token 的语义上限、超大上下文(>128K)下 summary 膨胀、与实际推理框架(vLLM/TensorRT-LLM)的 kernel 集成仍待深入
未来方向
- 稀疏摘要注意力:基于 query 条件化地选择摘要 token
- KSA post-training:SFT、偏好优化、推理 RL、多教师 OPD
- 压缩比的 Scaling Laws:建立类似参数/数据的序列级压缩 scaling 定律
- 与 OneRec/OneReason 的统一:构建 generative recommendation foundation model
九、参考资源
| 类型 | 链接 |
|---|---|
| arXiv 论文 | https://arxiv.org/abs/2604.24432 |
| 代码仓库 | github.com/Kuaishou-OneRec/KSA |
| 开源模型 | HuggingFace: OpenOneRec/KSA-4B-base |
| RULER 长上下文基准 | Hsieh et al. (2024) |
| Needle-in-a-Haystack | Kamradt (2023) |
| WSD 学习率调度 | Yu et al. (2025) |
| GQA / MLA 对比基线 | Ainslie et al. (2023) / DeepSeek-V2 (2024) |
引用
@article{chu2026ksa,
  title={Kwai Summary Attention Technical Report},
  author={Chu, Chenglong and Zhou, Guorui and others},
  journal={arXiv preprint arXiv:2604.24432},
  year={2026}
}
Analysis generated using paper-analyzer skill. 正文公式与 7 张结果表由 MinerU full.md 提取(PDF→MinerU 全文回退路径);配图由源 PDF 按页渲染并裁剪至 docs/figures/ksa/。