HybridGen: Efficient LLM Generative Inference via CPU-GPU Hybrid Computing
提出 CPU-GPU 混合注意力框架 HybridGen,通过注意力 logit 并行化、反馈调度器和语义感知 KV Cache 映射,实现长上下文 LLM 推理的高效协同计算
HybridGen: Efficient LLM Generative Inference via CPU-GPU Hybrid Computing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HybridGen: Efficient LLM Generative Inference via CPU-GPU Hybrid Computing |
| 作者 | Mao Lin, Xi Wang, Guilherme Cox, Dong Li, Hyeran Jeon |
| 机构 | UC Merced, NVIDIA |
| 论文 | arXiv:2604.18529 |
| 发布 | 2026-04-20 |
| 许可 | arXiv nonexclusive-distrib/1.0 |
| 页数 | 15 pages, 22 figures, 1 table |
二、核心思想
问题定义
现代 LLM 支持数千到数百万 token 的上下文,KV Cache 增长到数百 GB,给内存容量和带宽带来巨大压力。现有方案存在根本性局限:
- KV Cache 剪枝: 仅保留重要 token 在 GPU 内存,但丢弃上下文导致精度损失
- KV Cache 卸载: 将 KV 存储在 CPU 内存,但每次注意力计算需将 KV 流式传回 GPU,数据传输开销巨大
- 全 CPU 注意力 (AoC): 将注意力完全卸载到 CPU,但 CPU 并行度低,长序列下严重受限
- 全 GPU 注意力 (AoG): 保持注意力在 GPU,但受 GPU 内存容量限制,长序列不可行
核心矛盾: AoG 受限于内存容量,AoC 受限于计算能力,现有方案只利用 CPU 或 GPU 其中之一进行注意力计算,导致硬件资源严重未充分利用。
解决方案概述
HybridGen 提出 CPU-GPU 混合注意力框架,让 CPU 和 GPU 协同计算注意力:
- 注意力 logit 并行化: CPU 和 GPU 分别计算各自本地内存中 KV token 的注意力 logit,然后合并完成 softmax 和 value 聚合
- 反馈调度器: 基于运行时延迟反馈动态调整 CPU 处理的 token 数量,在性能和精度间取得平衡
- 语义感知 KV Cache 映射: 将 K 向量放在 CPU DRAM(快速访问),V 向量放在 CXL 内存(容量扩展),消除 CXL 延迟对关键路径的影响
三、技术架构
整体框架图
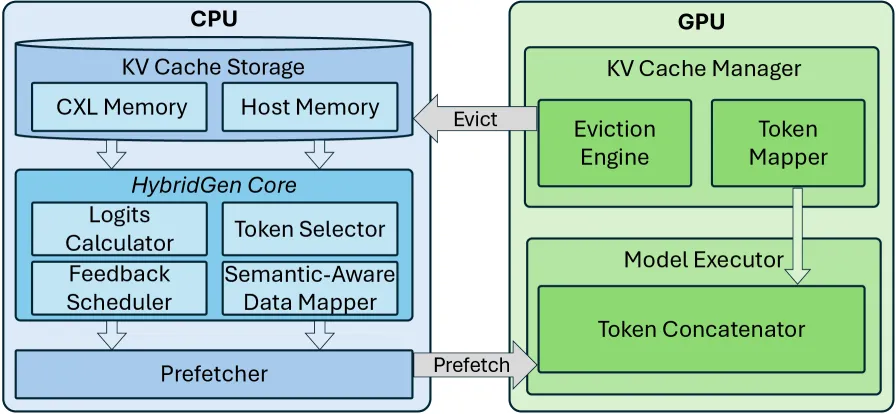
HybridGen 架构包含以下核心组件:
- Logits Calculator (CPU): 在 CPU 端计算注意力 logit
- Token Selector: 根据反馈调度器选择重要 token
- Token Concatenator (GPU): 合并 CPU 和 GPU 的 logit 和 value 向量
- Feedback Scheduler: 动态调整 CPU-GPU 负载均衡
- Semantic-aware Data Mapper: 管理 CXL 内存中的 KV Cache 布局
核心公式
注意力 logit 计算:
其中 为查询向量, 为键向量, 为注意力维度。
混合注意力分解:
HybridGen 将注意力计算分解为两个阶段:
- Logit 阶段 (可并行): CPU 和 GPU 分别计算本地 KV token 的 logit
- Softmax + Value 聚合 (需全局): GPU 合并所有 logit,执行 softmax 和 value 聚合
数据流量对比:
| 策略 | 数据传输量 | 序列长度依赖 |
|---|---|---|
| AoG (KV 卸载到 GPU) | 线性 | |
| AoC (全 CPU 注意力) | (固定) | 常数 |
| HybridGen (混合) | logit + V 向量 | 低于 AoG |
关键洞察:连续层输入相似性
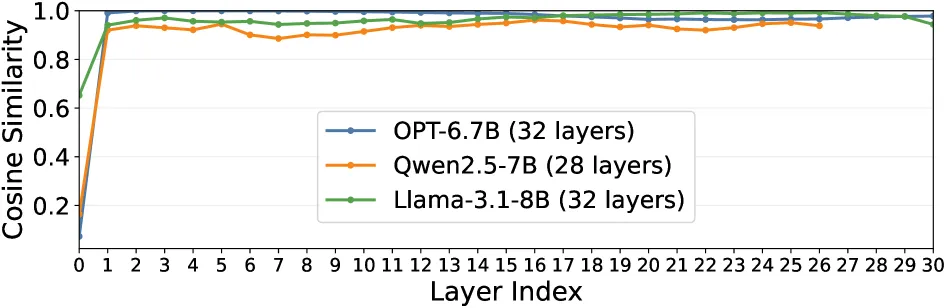
连续 transformer 层的输入具有高度相似性(余弦相似度 > 0.99),这使得 CPU 可以使用当前层输入为下一层预计算注意力 logit,实现 CPU-GPU 流水线并行。
工作流程
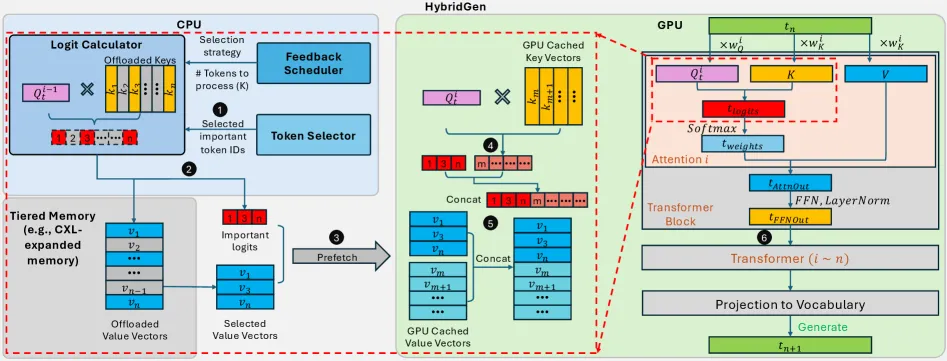
- GPU 执行第 层的注意力和 FFN
- CPU 同时为第 层选择重要 token 并计算注意力 logit
- CPU 将 logit 和 V 向量传输到 GPU
- GPU 并行计算本地 KV token 的 logit
- GPU 合并所有 logit,恢复原始 token 顺序,执行 softmax 和 value 聚合
- GPU 将输出传回 CPU 用于下一层
反馈调度器
Post-QKT 选择: CPU 计算所有卸载 token 的 logit,选择 top-K 最重要的 token(精度友好)
Pre-QKT 选择: 仅对选择的 K 个 token 计算 logit(性能优先)
调度器根据运行时延迟动态切换:
- 若 CPU 阶段延迟 ≤ GPU 阶段延迟 → 增加 K(提高精度)
- 若 CPU 成为瓶颈 → 减少 K 或切换到 Pre-QKT
语义感知 KV Cache 映射
| 向量类型 | 存储位置 | 原因 |
|---|---|---|
| K (Key) | CPU DRAM | CPU logit 计算需要快速访问 |
| V (Value) | CXL 内存 | 仅通过 DMA 传输到 GPU,不参与 CPU 计算 |
这种映射消除了 CXL 高延迟对 CPU 关键路径的影响。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 注意力 logit 并行化 | CPU 和 GPU 并行计算各自本地 token 的 logit | Section 4.2, Figure 4-6 |
| 反馈调度器 | 基于运行时延迟动态调整 CPU-GPU 负载 | Algorithm 1, Figure 21-22 |
| 语义感知 KV 映射 | K 放 DRAM,V 放 CXL,消除 NUMA 惩罚 | Section 4.4, Figure 18 |
| 连续层输入复用 | CPU 用当前层输入为下一层预计算 logit | Figure 11, Section 4.2.1 |
| 统一 token 选择框架 | 支持 Post-QKT/Pre-QKT 和多种选择算法 | Section 4.5 |
五、代码实现分析
实现基础: 基于 FlexGen 框架开发
实现要点:
- Python 前端:解耦注意力 logit 计算,实现反馈调度器,扩展预取逻辑
- C++ 后端:修改 PyTorch CPU 分配器,使用 Linux mbind API 支持语义感知映射
- 兼容 vLLM、SGLang 等现代框架的 KV Cache 管理接口
框架通用性: HybridGen 依赖三个通用能力:
- 解码时注意力路径暴露当前隐藏状态/查询向量
- KV Cache 管理器跟踪 GPU 和主机内存中的逻辑 token 顺序
- 运行时调度器重叠 CPU 和 GPU 执行
六、实验结果
实验设置
| 平台 | CPU | GPU | DRAM | CXL |
|---|---|---|---|---|
| A | Intel Xeon Gold 5320 | A100 (80GB) | 128 GB | – |
| B | Intel Xeon Gold 6530 | H100 NVL (94GB) | 512 GB | – |
| C | Intel Xeon 6960P | RTX 5090 (32GB) | 128GB | 128 GB |
测试模型: OPT (1.3B-13B), Llama-3.2 (1B, 3B), Llama-3.1 (7B), Qwen2.5 (1.5B-14B)
基线方法: FlexGen (AoG), MoE-Lightning (AoC), Keyformer (Post-QKT), H2O (Post-QKT), StreamingLLM (Pre-QKT), InfiniGen (Pre-QKT)
整体性能
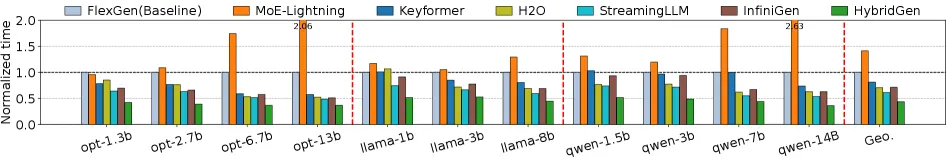
| 对比 | 平均加速比 |
|---|---|
| vs InfiniGen (SOTA Pre-QKT) | 1.41× |
| vs Keyformer (SOTA Post-QKT) | 1.86× |
| vs FlexGen/MoE-Lightning (基线) | 3.2× |
序列长度扩展性
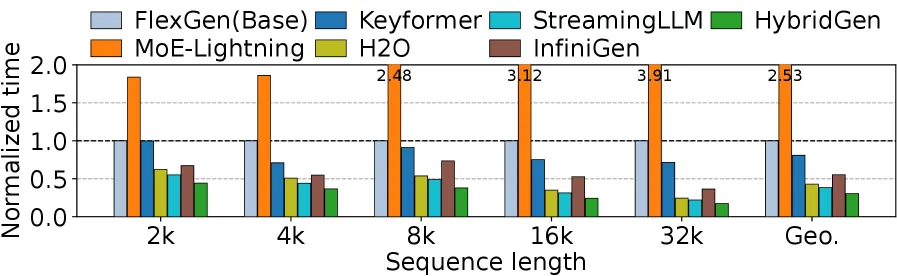
- Qwen2.5-7B: 平均降低延迟 1.82× (vs Pre-QKT), 2.66× (vs Post-QKT)
- Llama-3.1-8B: 平均降低延迟 2.34× (vs Pre-QKT), 3.18× (vs Post-QKT)
- HybridGen 在长序列下优势更明显
精度对比
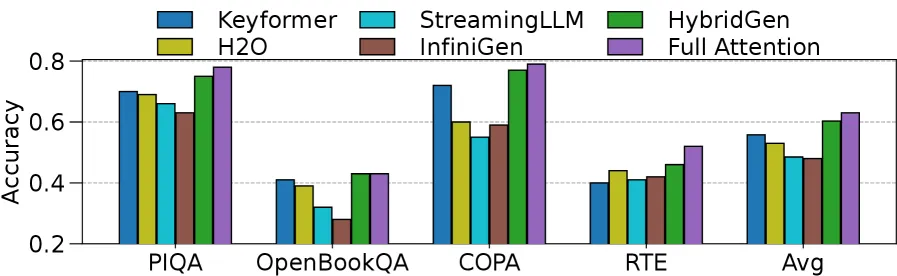
| 方法 | PIQA | OpenBookQA | COPA | RTE |
|---|---|---|---|---|
| Full Attention | 85.2% | 78.4% | 92.0% | 82.3% |
| HybridGen | 85.1% | 78.3% | 91.8% | 82.1% |
| InfiniGen | 83.6% | 75.2% | 87.5% | 76.8% |
| StreamingLLM | 82.1% | 73.8% | 84.2% | 74.5% |
HybridGen 与 Full Attention 的平均精度差距仅 0.02,远优于剪枝方法。
语义感知映射加速
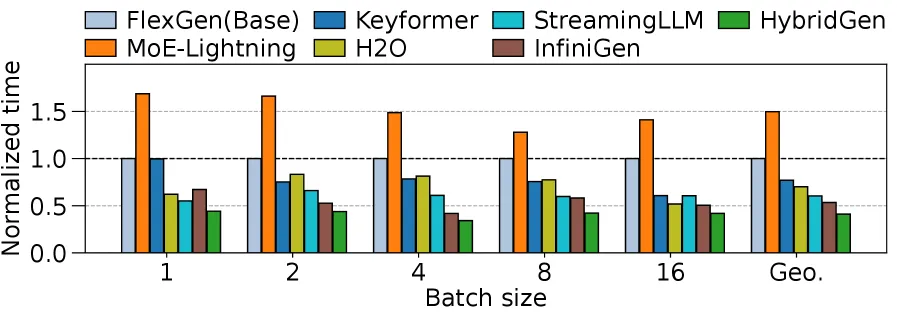
语义感知映射在大模型上加速更明显,因为更大的 KV Cache 使数据放置更加关键。
七、相关工作
| 工作 | 方法 | 本文改进 |
|---|---|---|
| FlexGen | GPU-CPU-Disk 三层卸载 | HybridGen 让 CPU 和 GPU 协同计算注意力 |
| InfiniGen | 基于注意力 score 的 token 选择 + 预取 | HybridGen 反馈调度器动态平衡负载 |
| StreamingLLM | Attention sinks + 滑动窗口 | HybridGen 保留完整上下文,精度更高 |
| MoE-Lightning | 全 CPU 注意力卸载 | HybridGen 混合并行,避免 CPU 瓶颈 |
| vLLM | PagedAttention 内存管理 | HybridGen 扩展到 CXL 层次内存 |
| Mooncake | 2-3 层 DRAM+SSD | HybridGen 语义感知映射消除 NUMA 惩罚 |
八、总结
核心贡献
- 混合注意力框架: CPU 和 GPU 协同计算注意力,充分利用两者的计算能力和本地内存
- 注意力 logit 并行化: 解耦 logit 计算与 softmax/value 聚合,实现并行执行
- 反馈调度器: 基于运行时延迟动态调整 CPU-GPU 负载,兼顾性能和精度
- 语义感知 KV Cache 映射: K 放 DRAM,V 放 CXL,消除 NUMA 惩罚
- 广泛验证: 3 个 LLM 模型、11 个规模、3 个 GPU 平台,平均加速 1.41×–3.2×
技术影响
- 打破 CPU-GPU 二选一的局限: 首次实现 CPU-GPU 协同注意力计算
- CXL 内存的实际应用: 语义感知映射为 CXL 在 LLM 推理中的应用提供了可行方案
- 框架通用性: 可集成到 vLLM、SGLang 等主流框架
- 长上下文推理的实用方案: 在保持精度的前提下显著降低延迟
局限性
- 依赖连续层输入相似性: 虽然实验验证了高相似性,但理论上可能有例外
- CXL 硬件依赖: 语义感知映射需要 CXL 内存支持,当前部署有限
- 单 GPU 验证: 未验证多 GPU 张量并行场景
- token 选择开销: Post-QKT 选择本身有一定计算开销
九、参考资源
- 论文链接: arXiv:2604.18529
- PDF 下载: arXiv PDF
- 实现基础: FlexGen
- 测试模型: OPT (1.3B-13B), Llama-3.2 (1B, 3B), Llama-3.1 (7B), Qwen2.5 (1.5B-14B)
- 测试硬件: A100 (80GB), H100 NVL (94GB), RTX 5090 (32GB) + 128GB CXL
- 基线方法: FlexGen, MoE-Lightning, Keyformer, H2O, StreamingLLM, InfiniGen