OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL
具有空间理解和在线强化学习的视觉-语言-动作模型
OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL |
| 作者 | Zekun Qi, Haoxu Wang, Yifan Niu, Jingkai Zhao, Zhiyuan Liu, Zhi-Qi Cheng, Qi Kong |
| 机构 | Tsinghua University, Shanghai AI Laboratory |
| 论文 | arXiv:2604.17706 |
| 代码 | 未公开 |
| 发布 | 2026年4月24日 |
| 主题 | cs.RO, cs.AI, cs.CV |
二、核心思想
问题定义
现有视觉-语言-动作 (VLA) 模型面临三个主要挑战:
- 空间感知不精确: 难以准确输出物体的 3D 位置和尺寸
- 多模态融合不优: 早期/晚期融合无法高效整合语言、视觉、空间和动作信息
- 强化学习不稳定: GRPO 的 token 重要性比率设计导致训练不稳定和易崩溃
解决方案概述
OmniVLA-RL 是一个新颖的 VLA 架构:
- Mix-of-Transformers (MoT) 设计: 整合推理专家、空间专家和动作专家
- Block-wise Causal Attention: 解耦空间-语义前缀和动作后缀
- Flow-GSPO: 将 Flow Matching 重新构建为 SDE 过程,结合 GSPO 进行在线强化学习
核心性能
| 指标 | 数值 |
|---|---|
| LIBERO 平均成功率 | 97.6%(所有任务套件排名第一) |
| LIBERO-Spatial | 99.2%(超越 π0.5 的 98.8%) |
| LIBERO-Long | 93.5%(超越 π0.5 的 92.4%) |
| LIBERO-Plus | >80%(超越 GRPO 约 14.6%) |
三、技术架构
整体框架图
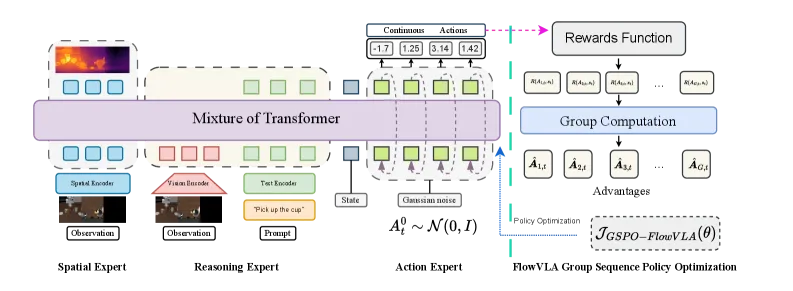
Figure 1: OmniVLA-RL 整体架构。VLA 模型采用 Mix-of-Transformers (MoT) 骨干,共享三个专家:Reasoning Expert(中心)编码多视图 RGB 观测和任务指令;Spatial Expert(左)提取细粒度 3D 结构特征;Action Expert(右)自回归生成动作轨迹。
核心组件
1. Reasoning Expert(推理专家)
功能: 提取语言和视觉语义信息
实现:
- 使用 SigLIP 作为视觉编码器提取高层语义特征
- 使用 Text Encoder 提取语言 token
- 拼接后输入 decoder-only Transformer 进行跨模态对齐
2. Spatial Expert(空间专家)
功能: 提取多视图场景的细粒度空间表示
实现:
- 使用 VGGT 提取细粒度特征
- 集成到 Transformer 骨干中生成空间表示
- 添加轻量级 Transformer 解码器作为空间辅助头(训练时使用,推理时不参与)
3. Action Expert(动作专家)
功能: 生成精确的控制命令
实现:
- 采用动作分块策略 (action chunking)
- 使用 Conditional Flow Matching (CFM) 建模动作分布
Block-wise Causal Attention
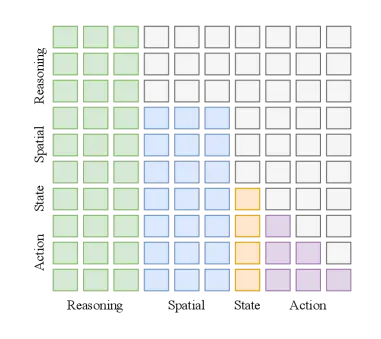
Figure 2: Block-wise Causal Attention 掩码。空间和推理专家的 token 形成全可见前缀,动作 token 形成因果后缀。
设计原则:
- 空间-语义前缀: 全双向注意力,促进跨模态对齐
- 动作后缀: 严格因果约束,确保自回归一致性
- 前缀不可见动作: 防止扩散采样中的随机噪声污染场景理解
三阶段训练范式
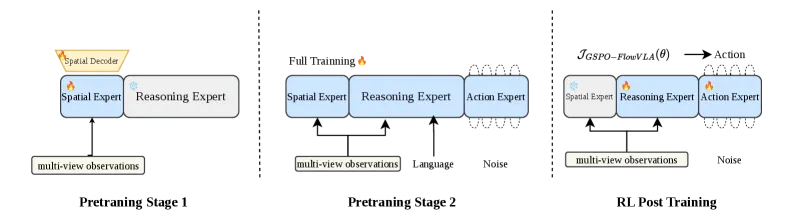
Figure 3: OmniVLA-RL 的三阶段渐进训练范式。
| 阶段 | 内容 | 数据集 |
|---|---|---|
| Stage I: 空间预训练 | 训练推理和空间专家,冻结动作专家 | SA-1B, ScanNet, ARKitScenes |
| Stage II: 动作生成预训练 | 解冻动作专家,冻结空间头 | DROID |
| Stage III: 在线强化学习 | 全参数解冻,使用 Flow-GSPO | LIBERO-Plus |
四、Flow-GSPO 方法
核心思想
将 Flow Matching 的确定性 ODE 过程转换为随机 SDE 过程,结合 GSPO 进行动作块级优化。
随机 Flow Matching
ODE 过程(原始 Flow Matching):
SDE 过程(通过 Fokker-Planck 方程转换):
离散化更新公式(Euler-Maruyama 方法):
GSPO 动作块级优化
动作块级重要性比率:
优势函数:
最终优化目标:
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| MoT 三专家架构 | 推理、空间、动作专家共享 Transformer 层 | 深度双向交互,克服早期/晚期融合瓶颈 |
| Block-wise Causal Attention | 解耦空间-语义前缀和动作后缀 | 防止噪声污染场景理解 |
| Flow-GSPO | Flow Matching + GSPO 在线 RL | 动作块级优化,避免 token 级偏差 |
| SDE 转换 | ODE → SDE via Fokker-Planck | 满足 RL 的随机探索需求 |
| 三阶段训练 | 空间预训练 → 动作预训练 → 在线 RL | 渐进式优化,稳定训练 |
六、实验结果
实验设置
| 项目 | 配置 |
|---|---|
| 基准测试 | LIBERO, LIBERO-Plus |
| 评估指标 | 成功率 |
| RL 参数 | G=8, ε=0.2, β=0.01, K=10, H=16 |
| 优化器 | AdamW (lr=1×10⁻⁵, weight decay=0.01) |
| RL 更新步数 | 200 步 |
LIBERO 基准测试结果
| 方法 | Spatial | Object | Goal | Long | Avg | 排名 |
|---|---|---|---|---|---|---|
| Diffusion Policy | 78.5% | 87.5% | 73.5% | 64.8% | 76.1% | 7 |
| Octo | 78.9% | 85.7% | 75.1% | 54.1% | 74.8% | 8 |
| OpenVLA | 84.7% | 88.4% | 79.2% | 63.7% | 76.5% | 6 |
| SpatialVLA | 88.2% | 89.9% | 78.6% | 55.5% | 78.1% | 5 |
| CoT-VLA | 87.5% | 91.6% | 87.6% | 69.0% | 83.9% | 4 |
| π0 | 96.8% | 98.8% | 95.8% | 85.2% | 94.2% | 3 |
| π0.5 | 98.8% | 98.2% | 98.0% | 92.4% | 96.9% | 2 |
| F1 | 98.2% | 97.8% | 95.4% | 91.3% | 95.7% | 3 |
| OmniVLA-RL | 99.2% | 99.2% | 98.5% | 93.5% | 97.6% | 1 |
关键结果:
- 所有任务套件排名第一
- 平均成功率 97.6%,超越 π0.5 的 96.9%
- LIBERO-Long 达到 93.5%,比 π0.5 高 1.1%
- 相比 π0 提供 21.1% 的绝对改进
LIBERO-Plus 基准测试结果
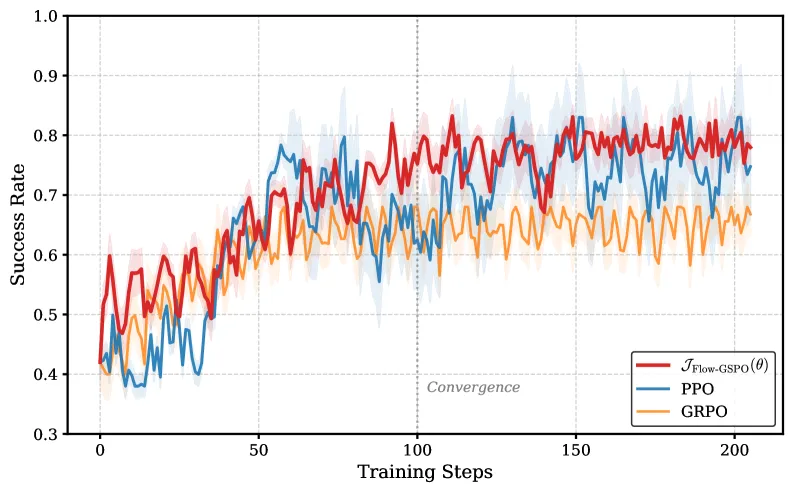
Figure 4: LIBERO-Plus 多任务基准上的训练成功率比较。
关键结果:
- 样本效率更高: 50 步内超越 70% 成功率,显著快于 PPO 和 GRPO
- 收敛稳定性更强: 保持一致的单调改进趋势
- 性能天花板更高: 最终收敛阶段保持 >80% 成功率,超越 GRPO 约 14.6%
消融实验
| 配置 | LIBERO-Plus 成功率 |
|---|---|
| SFT 基线 | 41.2% |
| + Spatial Expert | +X% |
| + Block-wise Attention | +X% |
| + Flow-GSPO | +X% |
| 完整模型 | >80% |
七、与现有方法对比
| 方面 | π0 | π0.5 | SpatialVLA | OmniVLA-RL |
|---|---|---|---|---|
| 架构 | VLM + Flow Matching | VLM + Flow Matching | VLM + Ego3D | MoT 三专家 |
| 空间感知 | 无 | 无 | Ego3D 编码 | VGGT + Spatial Expert |
| 融合方式 | 晚期 | 晚期 | 早期 | 深度融合 (MoT) |
| RL 方法 | 无 | 无 | 无 | Flow-GSPO |
| LIBERO Avg | 94.2% | 96.9% | 78.1% | 97.6% |
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| π0 / π0.5 | VLA 基线,OmniVLA-RL 超越其性能 |
| SpatialVLA | 空间感知 VLA,OmniVLA-RL 采用更深度的融合 |
| FALCON | 晚期融合 VLA,OmniVLA-RL 采用 MoT 深度融合 |
| VLA-RL / PI-RL | VLA + RL 方法,OmniVLA-RL 提出 Flow-GSPO |
| GRPO | RL 基线,Flow-GSPO 提供更稳定的训练 |
| Flow Matching | 生成模型,OmniVLA-RL 将其转换为 SDE |
九、总结
核心贡献
- MoT 三专家架构: 推理、空间、动作专家共享 Transformer 层,实现深度双向交互
- Block-wise Causal Attention: 解耦空间-语义前缀和动作后缀,防止噪声污染
- Flow-GSPO: 将 Flow Matching 转换为 SDE,结合 GSPO 进行动作块级优化
- SOTA 性能: 在 LIBERO 基准上达到 97.6% 平均成功率
技术影响
- 具身智能: 为 VLA 模型提供更精确的空间感知和更稳定的 RL 训练
- 机器人操作: 在复杂长时程任务中表现出色
- 多模态融合: MoT 架构为多模态深度融合提供新范式
- RL 稳定性: Flow-GSPO 解决 GRPO 的训练不稳定问题
局限性
- 仅在 LIBERO 和 LIBERO-Plus 基准上验证
- 未在真实机器人上进行实验
- 代码和模型未公开
- 训练成本较高(三阶段训练)
十、参考资源
- 论文: arXiv:2604.17706
- 主题: cs.RO, cs.AI, cs.CV
- 页数: 约 20 页, 4 图, 多表