Breaking the Training Barrier of Billion-Parameter Universal Machine Learning Interatomic Potentials
突破十亿参数通用机器学习原子间势函数的训练壁垒
Breaking the Training Barrier of Billion-Parameter Universal Machine Learning Interatomic Potentials
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Breaking the Training Barrier of Billion-Parameter Universal Machine Learning Interatomic Potentials |
| 作者 | Yuanchang Zhou, Hongyu Wang, Yiming Du, Yan Wang, Mingzhen Li, Siyu Hu, Xiangyu Zhang, Weijian Liu, Chen Wang, Zhuoqiang Guo, Long Wang, Jingde Bu, Yutong Lu, Guangming Tan, Weile Jia |
| 机构 | 中国科学院计算技术研究所、国家超级计算中心等 |
| 论文 | https://arxiv.org/abs/2604.15821 |
| 发布 | 2026-04-17 |
| 页数 | 11页,8图 |
| 类别 | cs.DC (分布式计算), cs.LG (机器学习) |
核心亮点
- MatRIS-MoE:首个十亿参数级通用机器学习原子间势函数(uMLIP)模型
- Janus框架:专为uMLIP设计的高维分布式训练框架
- Exascale性能:在两台Exascale超算上达到1.2/1.0 EFLOPS峰值性能
- 训练时间压缩:将十亿参数uMLIP训练从数周压缩到数小时
二、核心思想
问题定义
通用机器学习原子间势函数(uMLIPs)在大规模多样化数据集上预训练,涵盖无机材料和有机分子,可作为量子精度物理模拟的基础模型。然而,uMLIP训练面临两大挑战:
- 二阶导数需求:uMLIP训练需要力(forces)和应力(virial stresses)的计算,这要求二阶自动微分,缺乏相应的并行训练框架
- 规模瓶颈:扩展到十亿参数规模导致计算和通信开销的爆炸性增长
解决方案概述
本文引入两个核心贡献:
- MatRIS-MoE:基于不变架构的十亿参数Mixture-of-Experts模型
- Janus:首个针对uMLIP的高维分布式训练框架,具有硬件感知优化
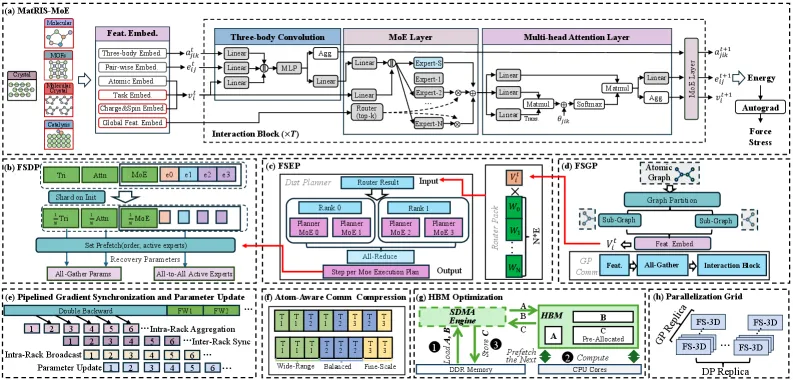
Figure 2: 工作概述。(a) 模型架构。(b)-(d) 框架级优化,包括FSDP、FSEP和FSGP。(e)-(g) 超算级通信和内存效率优化。(h) DP和GP replica的FS-3D并行策略。
三、技术架构
3.1 MatRIS-MoE模型架构
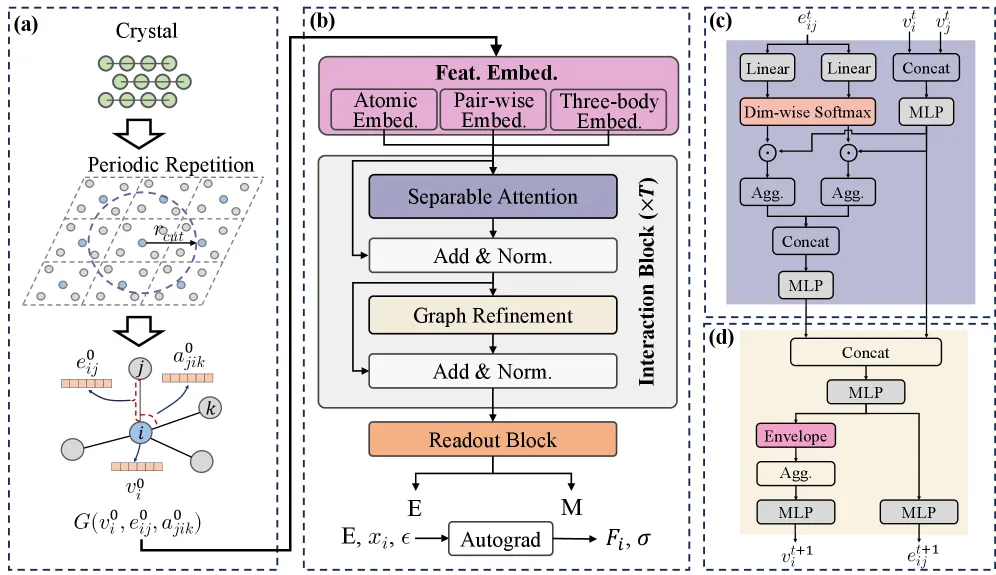
Figure 1: MatRIS架构概述。(a) 周期性重复条件下的图构建。(b) 整体工作流,包括特征嵌入、交互模块和readout。(c) 用于不变消息传递的图可分离注意力。(d) 图精炼模块。
模型配置 (Table II):
| 超参数 | (S) | (M) | (L) |
|---|---|---|---|
| 总参数量 | 1.09B | 2.47B | 11.5B |
| 激活参数量 | 0.19B | 0.56B | 2.89B |
| 专家数量 | 72 | 40 | 72 |
| Top-k路由 | 4 | 8 | 16 |
| 层数 | 6 | 6 | 6 |
| 节点特征维度 | 2560 | 1536 | 1920 |
| 边特征维度 | 384 | 1536 | 1920 |
| MLP隐藏维度 | 2560 | 1536 | 1920 |
| 注意力头数 | 8 | 4 | 4 |
| 注意力维度 | 384 | 512 | 512 |
3.2 算法创新
多任务特征嵌入:
- 任务嵌入:注入数据集嵌入,对齐不同密度泛函(PBE、R2SCAN、ωB97M)计算的系统
- 电荷和自旋嵌入:处理带电和自旋极化系统
- 全局特征嵌入:区分元素组成
稀疏MoE设计:
- 在自注意力层前后插入稀疏MoE模块
- 消息更新MoE:专注于消息构建
- 特征更新MoE:专注于注意力后精炼
- 基于元素类型的路由:每种元素类型激活自己的top-K专家
- 激活的专家集在模拟过程中保持稳定,维持连续光滑的势能面(PES)
多头自注意力替换:
- 将原始可分离注意力替换为多头自注意力
- 在固定截断半径下,计算复杂度仍为O(N)
3.3 核心公式
多任务鲁棒训练损失:
其中:
- :batch中的结构数
- :第个样本的基础损失(能量、力、应力、磁矩误差的加权组合)
- :标准化分数
- :平滑权重函数
力和应力计算:
- 采用保守训练方式:力和应力严格通过能量的自动微分获得
- 需要二阶导数(double backward)
3.4 Janus训练框架
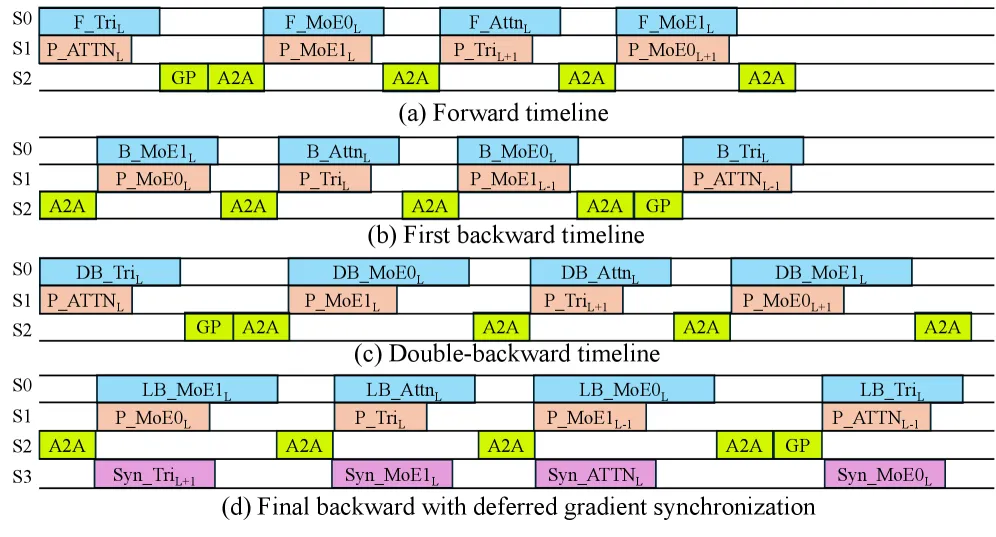
Figure 3: MatRIS-MoE框架的执行时间线。每个交互块包含Tri、MoE0、Attn和MoE1。蓝色块表示算子计算,粉色块表示参数预取,绿色块表示GP通信或token-routing All-to-All (A2A),紫色块表示延迟梯度同步。
FS-3D(Fully Sharded 3 Dimensions):
Janus采用FS-3D作为基本执行单元,集成三种分片并行:
| 并行方式 | 功能 |
|---|---|
| FSDP (Fully Sharded Data Parallelism) | 减少静态内存使用,包括模型参数、梯度和优化器状态 |
| FSGP (Fully Sharded Graph Parallelism) | 跨rank分区原子图 |
| FSEP (Fully Sharded Expert Parallelism) | 在分片MoE层上执行专家并行 |
DP和GP replica:
- 每个DP-replica内,全局batch沿图维度分片,每个FS-3D unit处理固定数量的原子
- GP-replica沿图维度复制FS-3D unit,保持原子子图的邻居信息一致
3.5 系统级优化
CNIS超算优化
流水线调度:
- 跨多个梯度桶设计流水线调度机制
- 协调层次化通信和参数更新
- 每个桶内保持依赖链:机架内聚合 → 跨机架同步 → 机架内广播 → 参数更新
- 利用优化器在梯度桶间无数据依赖的特性,并行处理不同桶
Atom-type-aware FP16压缩:
- 路由后,本地dispatch buffer中的tokens按原子类型分组
- 使用每类型的缩放因子进行量化
- 以FP16传输,通信后反量化
- 将MoE路由All-to-All通信量减少50%
高性能内核优化:
- 邻居聚合:融合索引实现合并内存访问
- 边聚合:基于GEMM的reduction重构
- 多头注意力:批处理GEMM调用
- MoE dispatch/combine:竞争感知scatter
LineShine超算优化
异步MPI运行时:
- 开发软件定义的异步MPI运行时
- 物理分区CPU资源:计算核心、通信核心、调度核心
- 实现计算和通信重叠
SDMA数据移动:
- 利用LX2处理器的on-package SDMA引擎
- 定制HBM数据移动,在内存受限算子级别进行优化
- 算子达到最高1.4x的内存带宽提升
四、实验结果
4.1 精度结果
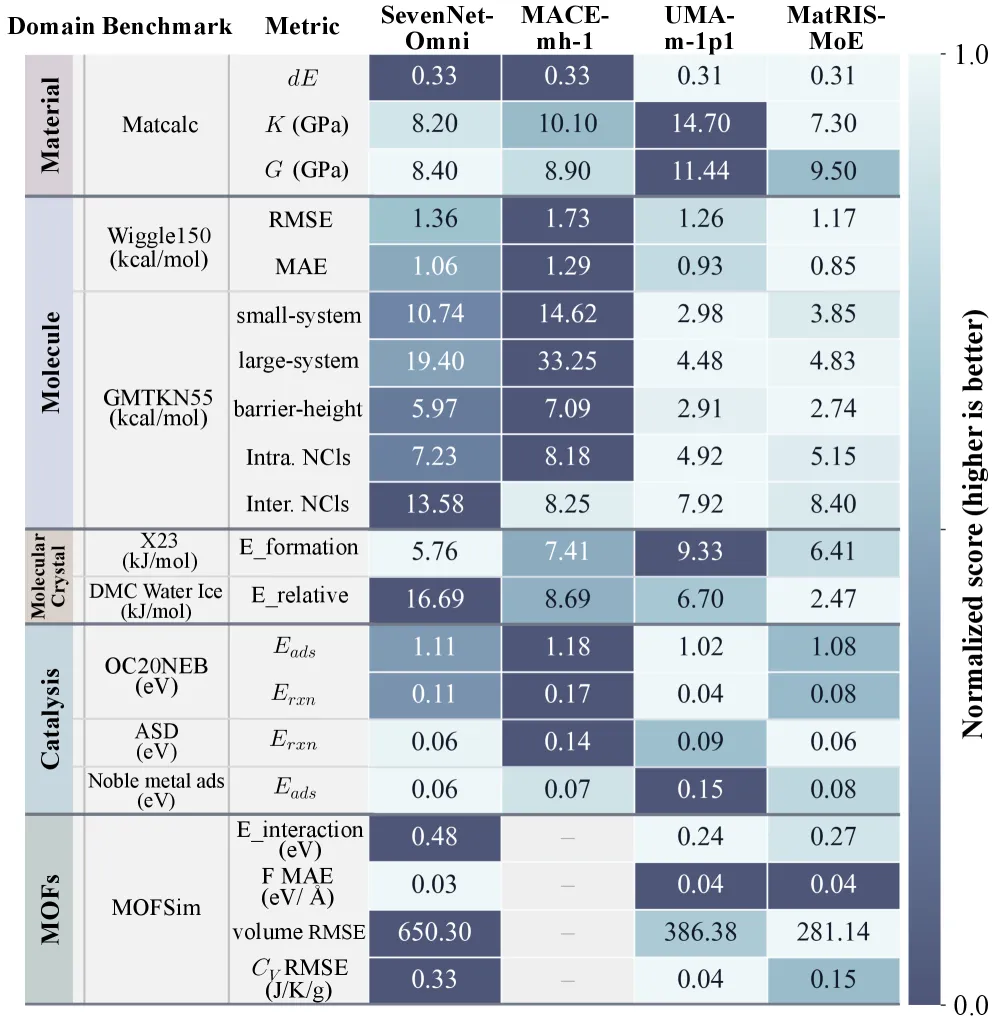
Figure 5: MatRIS-MoE在跨域基准上的开箱即用精度结果。代表性任务涵盖分子、材料、催化、分子晶体和MOF。
MatRIS-MoE (S) 虽然只有约10亿参数,但在多个基准上达到SOTA或接近SOTA精度:
- 材料:Matcalc基准(结构相似度dE、体积模量K、剪切模量G)
- 分子:Wiggle150基准
- 催化:催化反应分析
- 分子晶体:晶体结构预测
- MOFs:金属有机框架
4.2 性能提升 (Table III)
| 机器 | 模型 | Baseline | 优化后 | 加速比 |
|---|---|---|---|---|
| CNIS | MatRIS-MoE (M) | 5.96s | 2.21s | 2.7x |
| MatRIS-MoE (L) | 7.71s | 2.66s | 2.9x | |
| LineShine | MatRIS-MoE (M) | 33.1s | 8.08s | 4.1x |
| MatRIS-MoE (L) | 40.7s | 8.14s | 5.0x |
性能提升来源:
- 异步优化器:重叠梯度同步与参数更新
- Atom-type-aware压缩:MoE路由通信量减少50%
- 高性能内核:图算子、注意力、MoE dispatch优化
- SDMA数据移动:LineShine上额外1.4x内存带宽提升
4.3 收敛行为
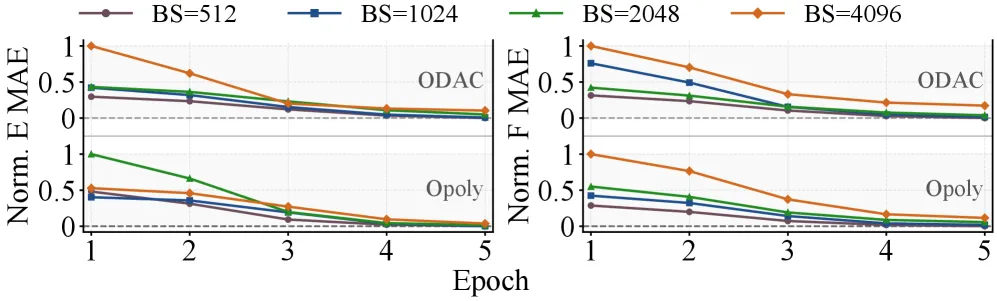
Figure 4: MatRIS-MoE在不同batch size下在ODAC25和Opoly26验证集上的收敛行为。
4.4 强扩展
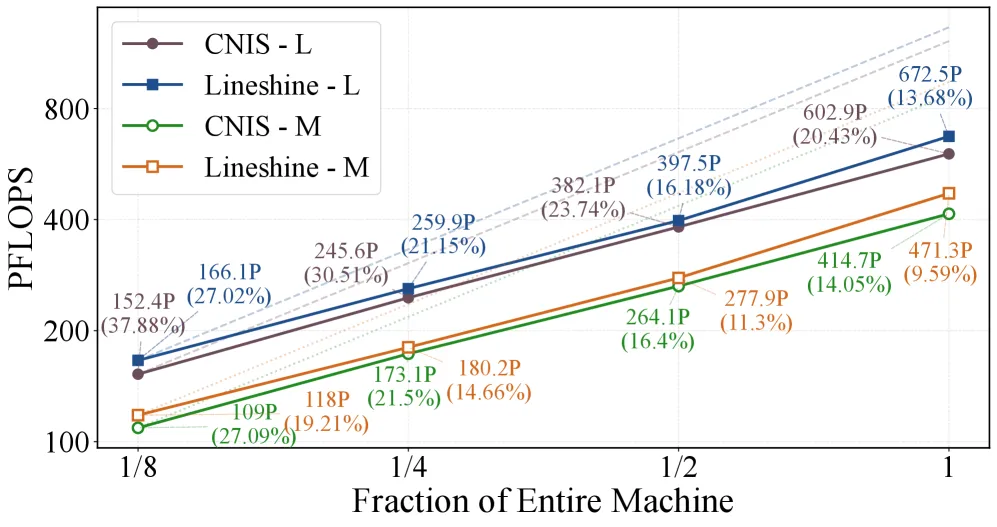
Figure 6: MatRIS-MoE训练在CNIS和LineShine上的强扩展。MatRIS-MoE (L)和(M)从1/8扩展到全机器规模,保持固定全局问题大小。
| 模型 | 机器 | 并行效率 | 峰值性能 |
|---|---|---|---|
| MatRIS-MoE (L) | CNIS | 53.93% | 602.9 PFLOPS |
| LineShine | 50.60% | 672.5 PFLOPS | |
| MatRIS-MoE (M) | CNIS | 51.87% | 414.7 PFLOPS |
| LineShine | 49.9% | 471.3 PFLOPS |
4.5 弱扩展
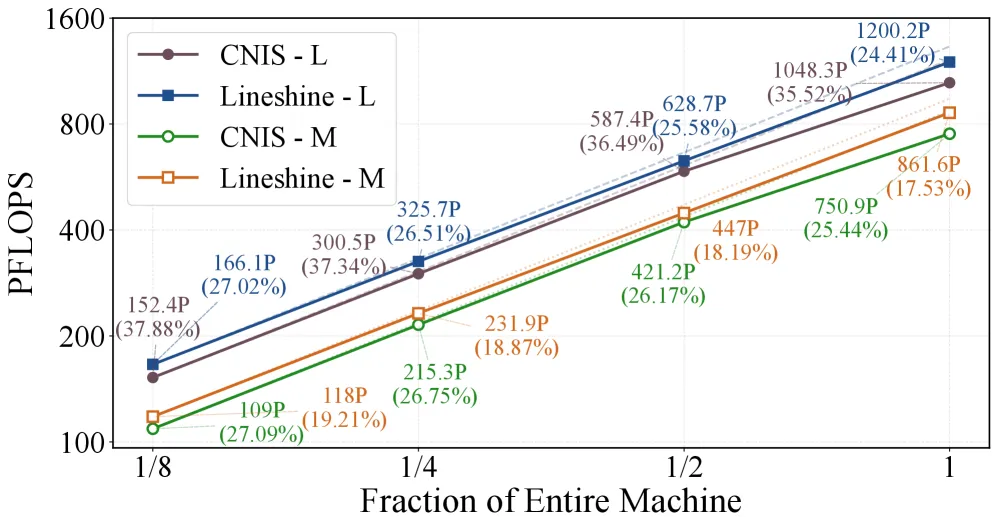
Figure 7: MatRIS-MoE训练在CNIS和LineShine上的弱扩展。问题大小与机器规模成比例增加。
| 模型 | 机器 | 峰值性能 | 并行效率 |
|---|---|---|---|
| MatRIS-MoE (L) | CNIS | 1,048.3 PFLOPS | 93.78% |
| LineShine | 1,200.2 PFLOPS (1.2 EFLOPS) | 90.3% | |
| MatRIS-MoE (M) | CNIS | 750.9 PFLOPS | 93.91% |
| LineShine | 861.6 PFLOPS | 91.3% |
4.6 持续性能
| 模型 | 机器 | 持续性能 | 理论峰值占比 |
|---|---|---|---|
| MatRIS-MoE (L) | CNIS | 762.3 PFLOPS | 25.84% |
| LineShine | 1,033.3 PFLOPS | 21.02% |
差距来源:初始化开销(RCCL/MPI初始化、Python模块导入、PyTorch运行时初始化)
4.7 应用验证
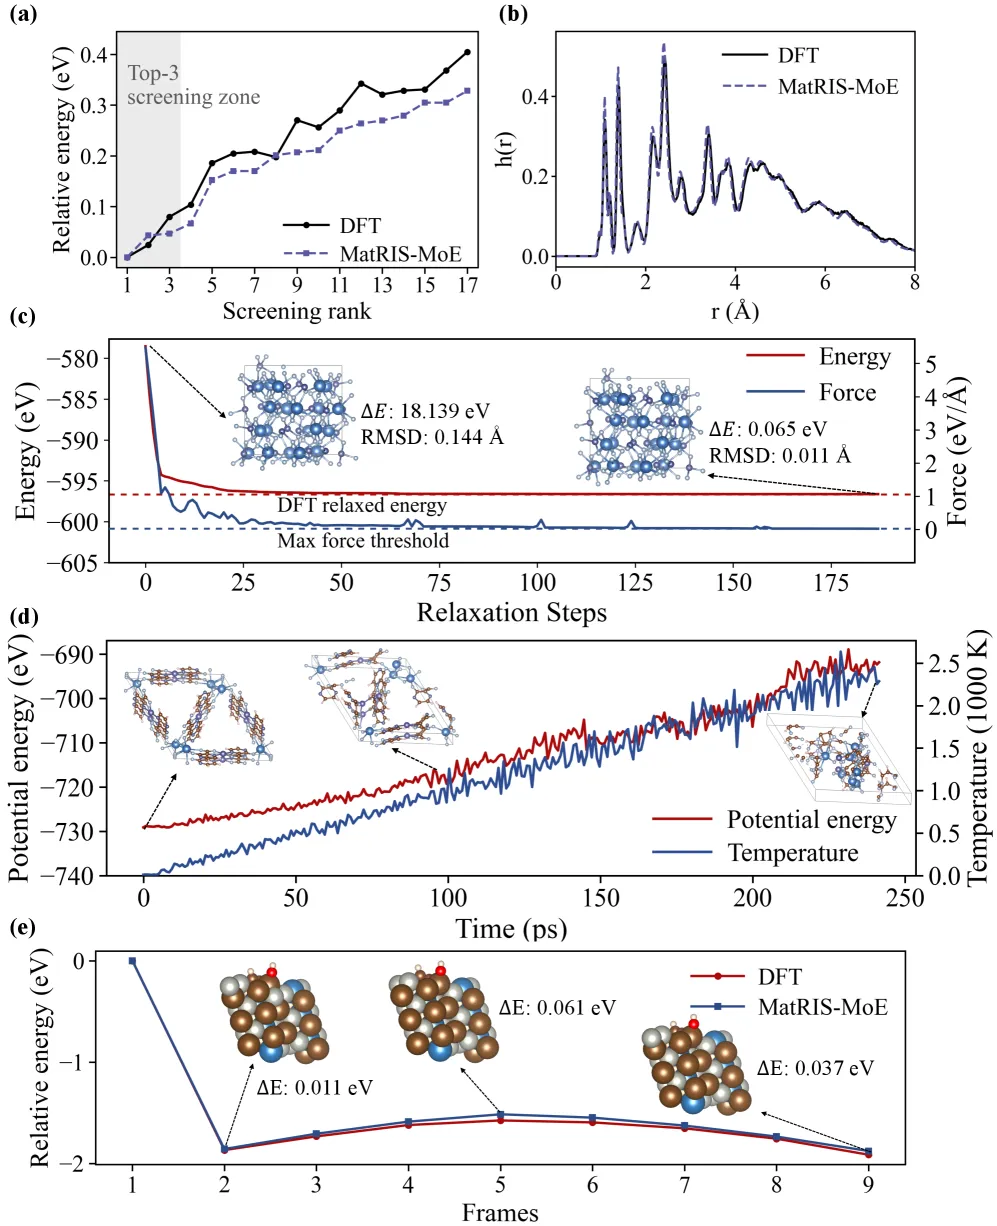
Figure 8: MatRIS-MoE在(a)能量排序、(b)分子分布函数、(c)结构弛豫、(d)分子动力学、(e)催化反应分析方面的适用性。
五、与现有工作对比 (Table I)
| 工作 | 年份 | 类别 | 多任务 | 总参数 | 激活参数 | 硬件 | 吞吐量 |
|---|---|---|---|---|---|---|---|
| M3GNet | 2022 | Invariant | No | 0.23M | 0.23M | RTX3090 | - |
| CHGNet | 2023 | Invariant | No | 0.41M | 0.41M | A100 | 0.0022 |
| GNoME | 2023 | Equivariant | No | 16.2M | 16.2M | TPUv3 | - |
| eqV2 | 2024 | Equivariant | No | 86M | 86M | A100 | 3.09 |
| UMA | 2025 | Equivariant | Yes | 1.4B | 50M | H200 | 1.00 |
| MACE-mh | 2025 | Equivariant | Yes | 6.4M | 6.4M | H100 | - |
| SevenNet-Omni | 2026 | Equivariant | Yes | 54.9M | 54.9M | H200 | 0.706 |
| 本文 (M) | 2026 | Invariant | Yes | 2.47B | 0.56B | GPGPU | 653.4 |
| 本文 (L) | 2026 | Invariant | Yes | 11.5B | 2.89B | GPGPU | 2795.9 |
关键优势:
- 参数规模最大:11.5B总参数,2.89B激活参数
- 吞吐量最高:归一化吞吐量达到UMA的2795.9倍
- 唯一支持多任务+十亿参数的uMLIP
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| MatRIS-MoE架构 | 不变架构+稀疏MoE,元素类型路由 | 11.5B参数,多任务支持 |
| 多任务鲁棒损失 | 标准化分数加权,处理数据集不一致性 | 稳定多任务训练 |
| FS-3D并行 | FSDP+FSGP+FSEP统一执行单元 | 高效分片执行 |
| Double-backward生命周期管理 | 重用前向执行顺序,预取和重叠 | 减少内存和通信开销 |
| Atom-type-aware FP16压缩 | 按原子类型分组量化 | MoE通信量减少50% |
| 异步MPI运行时 | 软件定义异步,物理分区CPU | 计算通信重叠 |
| SDMA数据移动 | 利用on-package SDMA引擎 | 1.4x内存带宽提升 |
七、总结
核心贡献
- MatRIS-MoE:首个十亿参数级通用uMLIP模型,支持多任务学习
- Janus框架:首个针对uMLIP的高维分布式训练框架
- Exascale训练:在两台Exascale超算上实现1.2/1.0 EFLOPS
- 系统级协同优化:从内核到框架到超算的全面优化
- 训练时间压缩:将数周训练压缩到数小时
技术影响
- AI4Science:为科学基础模型建立新的高性能计算标杆
- 分子动力学:支持量子精度的大规模物理模拟
- 材料科学:跨周期表的通用势函数
- HPC:展示CPU和GPU异构超算上训练大型MoE模型的可行性
实际应用
- 能量排序:材料筛选和稳定性分析
- 分子分布函数:径向分布函数计算
- 结构弛豫:晶体结构优化
- 分子动力学:长时间尺度原子模拟
- 催化反应分析:反应路径和能垒计算
局限性
- 计算资源需求:需要Exascale超算进行训练
- 二阶微分开销:Double-backward增加计算和内存需求
- 初始化开销:大规模系统上的初始化时间较长
- 模型部署:十亿参数模型的推理仍需优化
八、参考资源
- 论文: https://arxiv.org/abs/2604.15821
- CNIS超算: 中国新一代智能超算
- LineShine超算: Armv9 CPU超算
- 数据集: ODAC25, Opoly26