RouterWise: Joint Resource Allocation and Routing for Latency-Aware Multi-Model LLM Serving
RouterWise 首次将多模型 LLM 路由与 GPU 资源分配联合建模,通过对偶价格公式化的分数最大化路由 + setup 特化的延迟分析模型,搜索可行的 tensor 并行/GPU 线程份额组合,在满足延迟 SLO 前提下最大化输出质量。实验表明同一 GPU 集群下不同 setup 的可达质量差异高达 87%,证明资源分配是路由性能的关键决定因素。
RouterWise: Joint Resource Allocation and Routing for Latency-Aware Multi-Model LLM Serving
一、论文概述
| 字段 | 内容 |
|---|---|
| 标题 | RouterWise: Joint Resource Allocation and Routing for Latency-Aware Multi-Model LLM Serving |
| 作者 | Hossein Hosseini Kasnavieh, Gholamreza Haffari, Christopher Leckie, Adel N. Toosi |
| 机构 | Monash University / The University of Melbourne(作者归属推断自 Haffari、Leckie、Toosi 长期任职) |
| 论文链接 | https://arxiv.org/abs/2604.10907 |
| HTML | https://arxiv.org/html/2604.10907v2 |
| https://arxiv.org/pdf/2604.10907 | |
| 发布 | 2026-04-13(v1),2026-06-22(v2) |
| 分类 | cs.NI(primary)、cs.DC |
二、核心思想
问题定义
现有多模型 LLM 路由方法(FrugalGPT、Hybrid LLM、BEST-Route 等)通常假设每个候选模型的调用延迟固定,因此把模型选择建模成一个纯粹的质量-成本折中问题。然而在真实的多模型 GPU 集群部署中:
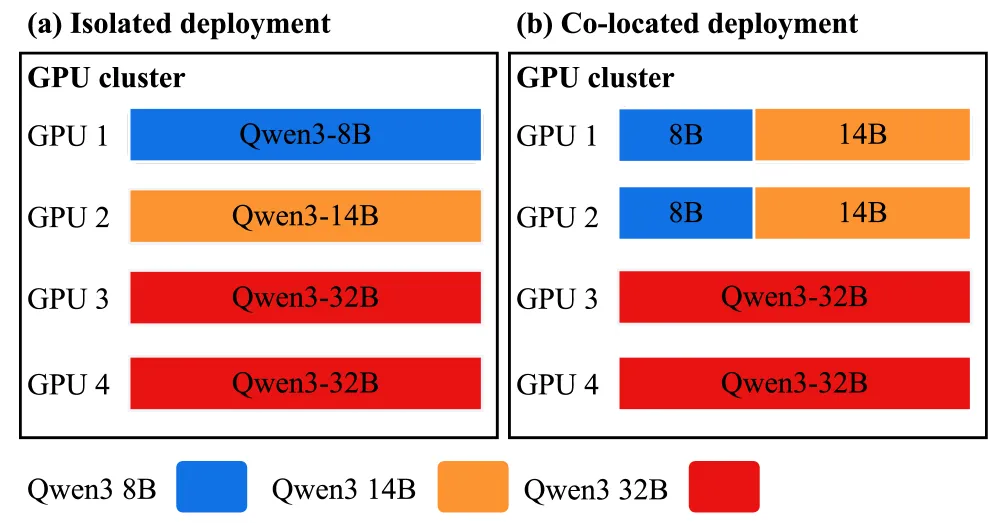
- 多个模型往往共享有限 GPU 资源(TP 分片、MPS 线程份额、显存),单一模型的延迟同时依赖于分配给它的资源与由路由决定的请求负载 。
- 由此路由决策与资源分配决策紧耦合:同一 GPU 集群下不同的部署 setup 会导致完全不同的延迟-吞吐曲线,进而改变可行的路由策略。
论文形式化这一联合问题:给定模型池、GPU 数量 和延迟 SLO ,找到 (setup , 路由分数 ) 使得平均输出质量 最大且满足 。
解决方案概述
RouterWise 组合两大核心组件:
- 对偶价格路由(dual-price routing):为得分-最大化的路由问题引入模型级”价格”变量 ,把每个 prompt 的模型选择解耦为独立的 argmax。
- Setup 特化的延迟建模:对每个 (model, TP, ρ) 三元组,在多种输入负载下做剖析,构造分段线性延迟曲线;避免用一个统一的解析模型跨模型/setup 强行拟合。
在此基础上,RouterWise 使用 Lagrange 松弛 + β 搜索 + setup 枚举三级流水线(Section IV-A)求解联合问题。
三、技术架构/方法
系统设定与 GPU 共享模型
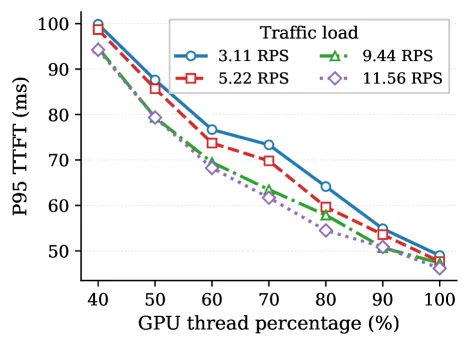
- 每个模型通过 tensor parallelism 拆成若干 shard;不同模型的 shard 允许通过 NVIDIA MPS 共享同一 GPU,每个进程可被限定最多可用的 GPU 线程百分比 。
- 显存则在同 GPU 的共驻模型间显式静态划分。
- 论文选择 TP 层级 ,构造离散化的可行 setup 空间。
路由模型与得分
对每个 prompt ,一个 DeBERTa-v3-Large 多头回归器输出各模型的预测质量向量:
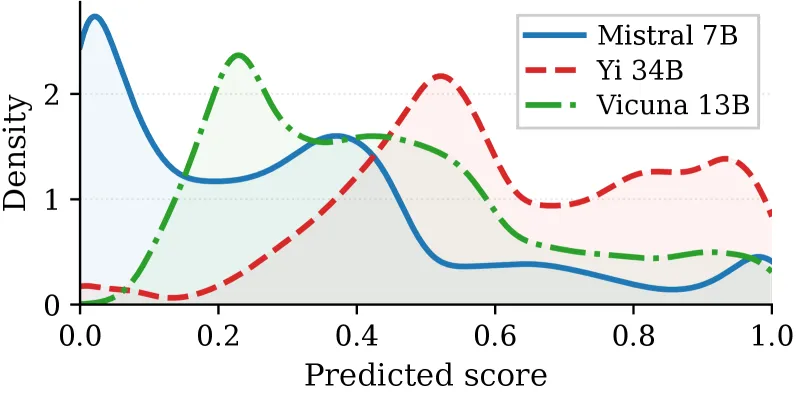
在 RouterBench(36,000 条 prompt)上训练,router 架构本身不是本文重点。RouterBench 上不同模型的得分分布重叠明显(Figure 3),说明简单的 argmax 路由并非最优。
联合优化形式
给定路由分数 (M 维概率单纯形),最大可达平均分:
约束条件 。
单模型负载 ;延迟聚合为
联合优化目标:
对偶价格路由(Proposition 1)
将逐模型的容量约束 引入 Lagrangian(价格 ),得到凸对偶问题:
对固定的 ,最优 prompt 分配退化为逐 prompt 的 argmax:
Proposition 2 证明 是凸的,RouterWise 用子梯度法迭代更新价格:
含义:模型被”多分配”时价格上调,反之下调。
Setup 特化的延迟建模
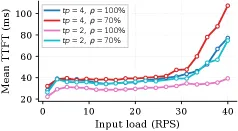
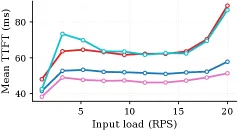
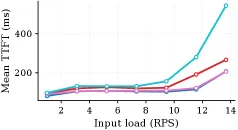
由于不同 (model, TP, ρ) 组合的延迟形状差异极大(同一模型下 TP=2 常常优于 TP=4,如 Mistral 7B),论文放弃”统一解析模型”策略,改为:
- 在离散 setup 上做实测剖析,记录 TTFT / TPOT 在多种输入负载下的取值;
- 对固定 (model, setup) 用分段线性插值构造 ;
- 组合成 用于优化。
三级优化流水线
对目标 :
- Stage 1(Algorithm 1 OptimizeFractions):固定 ,对 做投影梯度上升;每步内层用子梯度法解 dual 得到 ,取 作为对 的次梯度(Proposition 3),再减去 ,最后通过 Duchi et al. 2008 的单纯形投影 。
- Stage 2(Algorithm 2 OptimizeBeta):搜索 Lagrange 乘子 ,找出满足 且 最大的操作点。
- Stage 3(Algorithm 3 SelectSetup):枚举可行 setup(TP 与 ρ 离散组合),对每个 setup 调用 Stage 1/2,最终返回全局最优 。
可行性过滤:只保留能装下模型且总线程份额 (不能有闲置计算容量)的 setup。
四、核心创新
| # | 创新点 | 说明 |
|---|---|---|
| 1 | 联合建模路由与资源分配 | 首个显式建模 latency 依赖 (TP, ρ, load) 的多模型 LLM 路由框架;打破”固定成本”假设 |
| 2 | 对偶价格路由 | 通过模型级价格 把 O(NM) 的 0-1 指派解耦为独立 argmax,得到凸 dual,可用子梯度法快速求解 |
| 3 | Setup 特化的分段线性延迟模型 | 用剖析而非单一解析模型刻画异构 (model, TP, ρ) 对的延迟曲线,避免跨 setup 的建模偏差 |
| 4 | β + setup 双层搜索 | Lagrange 乘子驱动的操作点选择 + 离散 setup 枚举,支持 3–4 模型规模的实际部署 |
| 5 | 揭示资源分配是关键决定因素 | 同一 GPU 集群、同一延迟 SLO 下不同 retained setup 的可达平均分差异最高 87% |
五、实验结果
实验设置
- 硬件:NVIDIA A100 80GB PCIe, GPU。
- 服务栈:vLLM;MPS 提供 GPU 线程份额限制。
- 模型池:Mistral-7B-Chat、WizardLM-13B-V1.2、Yi-34B-Chat(另外还评估 4-model 变体)。
- 数据/router:RouterBench 36k prompts,多头 DeBERTa-v3-Large。
- Setup 空间:,,同模型不同 shard 不允许 co-locate。
- Baseline:Equal-Split Setup / Size-Proportional Setup / Isolated Setup(三种资源分配策略)。
主要结果
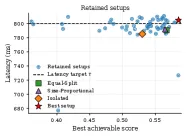
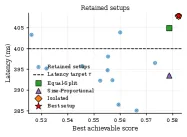
- Score–Latency 平面(Figure 5):在同一 GPU 数量、输入负载、SLO 下,不同 retained setup 的最优可达分数差异可达 87%。
- 即使强制 (无闲置 GPU 计算容量),平均相对分数仍在 0.30 到 0.56 之间波动,说明差异来源于资源分配本身而非未用满 GPU。
- Baseline 中 Equal-Split / Size-Proportional 都无法可靠命中最佳 setup;Isolated 部署损失最大,说明 co-location + MPS 细粒度控制是获得收益的关键。
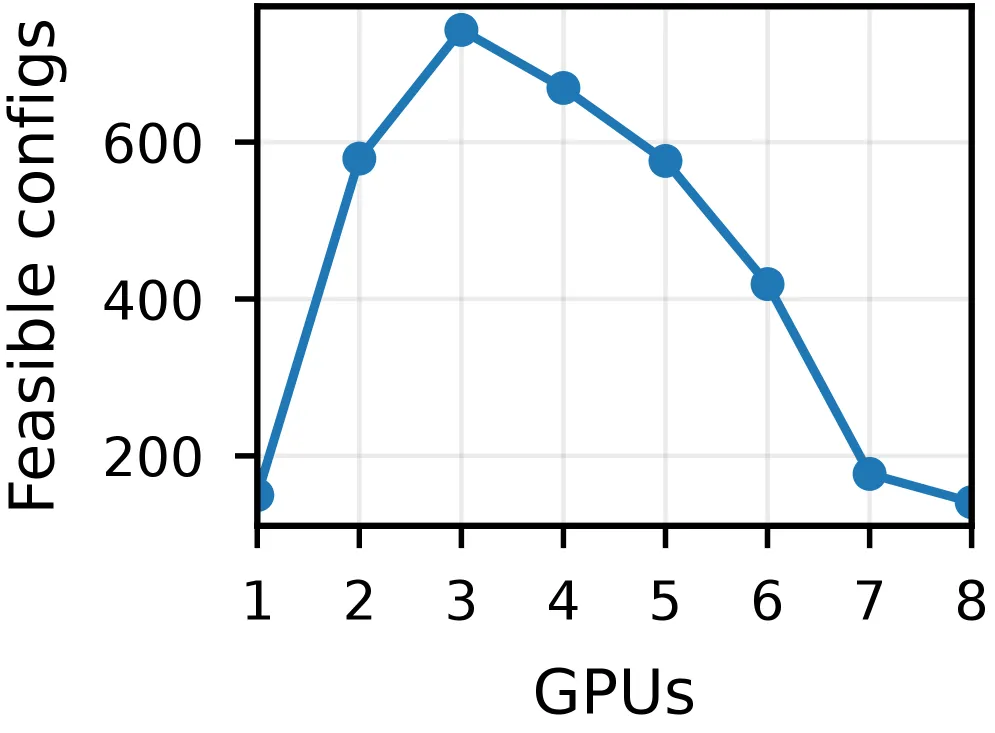
可扩展性(Figure 6)
- 3 模型时约 700 个 retained setup;4 模型时约 16,000 个。
- 每个 setup 的评估约 1s,因此 4 模型情形依旧在合理时间内完成。
- 时 retained setup 数比 少(更容易被 utilization 过滤器裁掉),并随输入负载升高进一步收缩。
其他观察
- 剖析显示 Mistral 7B 在广域负载下 TP=2 反而好于 TP=4,验证了”用剖析而非解析”的必要性。
- Router 得分分布上,模型间存在显著重叠,因此简单地”总是选最大模型”或”始终按分数 argmax”都不最优。
六、总结
核心贡献
- 首次将多模型 LLM 路由与 GPU 资源分配作为联合约束优化问题形式化,明确了 的耦合结构。
- 提出对偶价格公式化,得到凸 dual 和逐 prompt argmax 的高效求解方式。
- 提出 setup 特化的分段线性延迟建模流程,避免统一延迟模型的偏差。
- 用 β 搜索 + setup 枚举 + 单纯形投影梯度组合,得到可实施的 RouterWise 三阶段算法。
- 在 vLLM + A100 的 3–4 模型场景下,量化了资源分配对可达分数的巨大影响(最高 87% 差异)。
技术影响
- 为 LLM 多模型服务系统提供了”routing-aware provisioning”的新视角,凸显 co-location + MPS 细粒度控制的价值。
- 对偶价格路由公式可复用于其他带容量约束的模型选择/负载均衡场景(例如带成本预算的推理路由)。
- setup 特化延迟建模思路对任何异构推理系统(DiT、MoE、专家并行)都可复用。
局限性
- 目前仅支持最多 4 个候选模型;setup 空间随模型数呈组合爆炸,需要更 scalable 的搜索/剪枝或学习式启发。
- 假设 prompt 分布固定,无法在线适应负载/分布漂移;未处理输入分布 shift。
- 依赖离线剖析构造延迟曲线,剖析成本随 setup 与负载区间线性增长。
- 单一固定 arrival rate 假设,未联合多负载区间。
七、参考资源
- arXiv 摘要页:https://arxiv.org/abs/2604.10907
- HTML 全文:https://arxiv.org/html/2604.10907v2
- PDF:https://arxiv.org/pdf/2604.10907
- 图表索引:
figures/2604.10907-routerwise/README.md - 相关工作:RouterBench (Hu et al. 2024)、FrugalGPT (Chen et al. 2023)、BEST-Route (Ding et al. 2025)、Hybrid LLM (Ding et al. 2024)、vLLM PagedAttention (Kwon et al. 2023)