SpecMoE: A Fast and Efficient Mixture-of-Experts Inference via Self-Assisted Speculative Decoding
通过自辅助推测解码实现高效MoE推理,最高4.30×吞吐量提升
SpecMoE: A Fast and Efficient Mixture-of-Experts Inference via Self-Assisted Speculative Decoding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SpecMoE: A Fast and Efficient Mixture-of-Experts Inference via Self-Assisted Speculative Decoding |
| 作者 | Jehyeon Bang, Eunyeong Cho, Ranggi Hwang, Jinha Chung, Minsoo Rhu |
| 机构 | 未明确标注 |
| 论文 | arXiv:2604.10152 |
| 发布 | 2026-04-11 |
| 领域 | 人工智能 (cs.AI), 机器学习 (cs.LG) |
| 会议 | DAC 2026 (第63届ACM/IEEE设计自动化会议) |
二、核心思想
问题定义
MoE架构通过选择性激活参数来降低LLM的计算成本,但面临以下挑战:
- 高内存需求:MoE模型参数量巨大,GPU内存难以容纳
- 参数效率低:尽管只激活部分专家,但所有专家参数都需要存储
- CPU卸载效率有限:现有CPU-offloaded MoE推理系统在大batch size下效率不佳
- 内存带宽瓶颈:频繁的GPU-CPU数据传输成为性能瓶颈
核心发现
关键洞察:
- MoE模型的专家激活具有高度局部性——相邻token倾向于激活相同专家
- 推测解码思想可以应用于MoE推理——用”草稿”模型预测未来token的专家激活
- 无需额外训练或微调,直接利用MoE模型自身作为”自辅助”草稿模型
解决方案概述
SpecMoE 是一个基于自辅助推测解码的内存高效MoE推理系统:
- 自辅助推测解码:利用MoE模型自身的稀疏性作为草稿模型
- CPU-GPU协同:草稿模型在CPU上运行,验证在GPU上执行
- 选择性专家预取:根据推测结果提前从CPU加载专家到GPU
- 无需额外训练:直接应用于现有预训练MoE模型
核心结果:
- 吞吐量提升最高 4.30×
- 显著降低内存和互联带宽需求
- 在内存受限系统上效果尤为显著
三、技术架构
SpecMoE架构总览
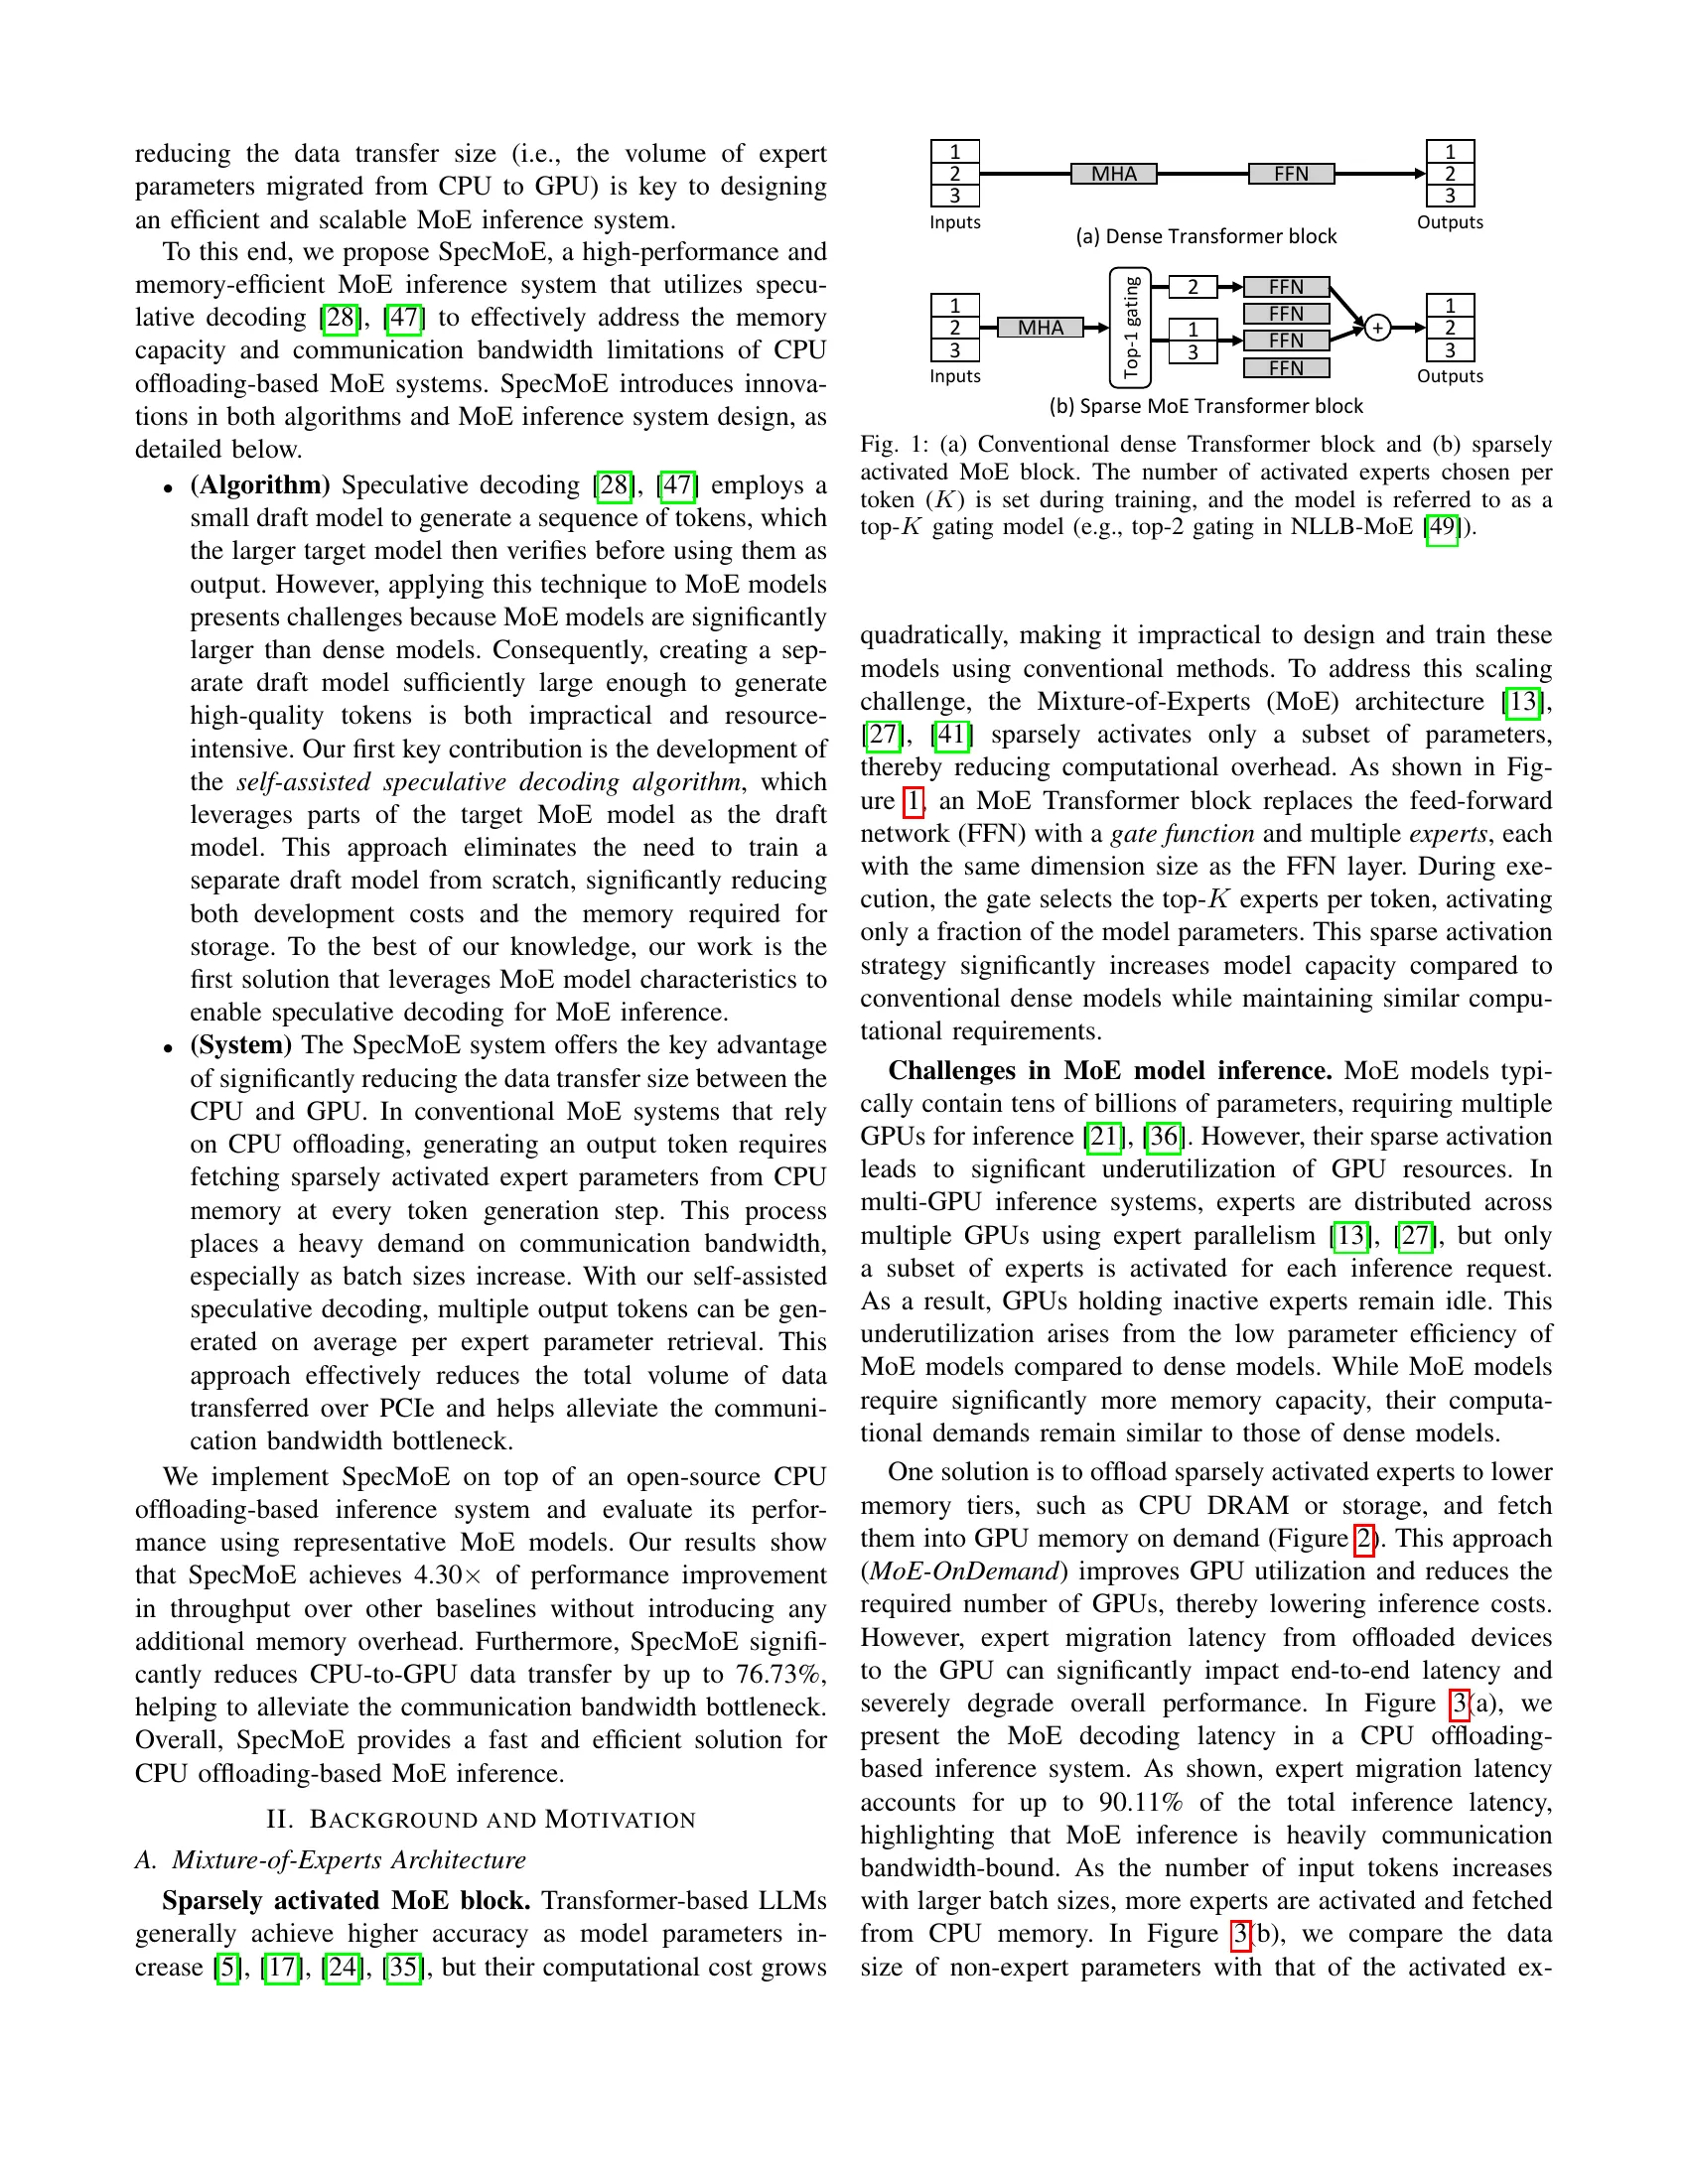
系统组成:
- GPU端:运行验证阶段,执行实际的专家计算
- CPU端:运行草稿阶段,预测未来token的专家激活
- 专家预取机制:根据预测结果提前传输专家参数
自辅助推测解码算法
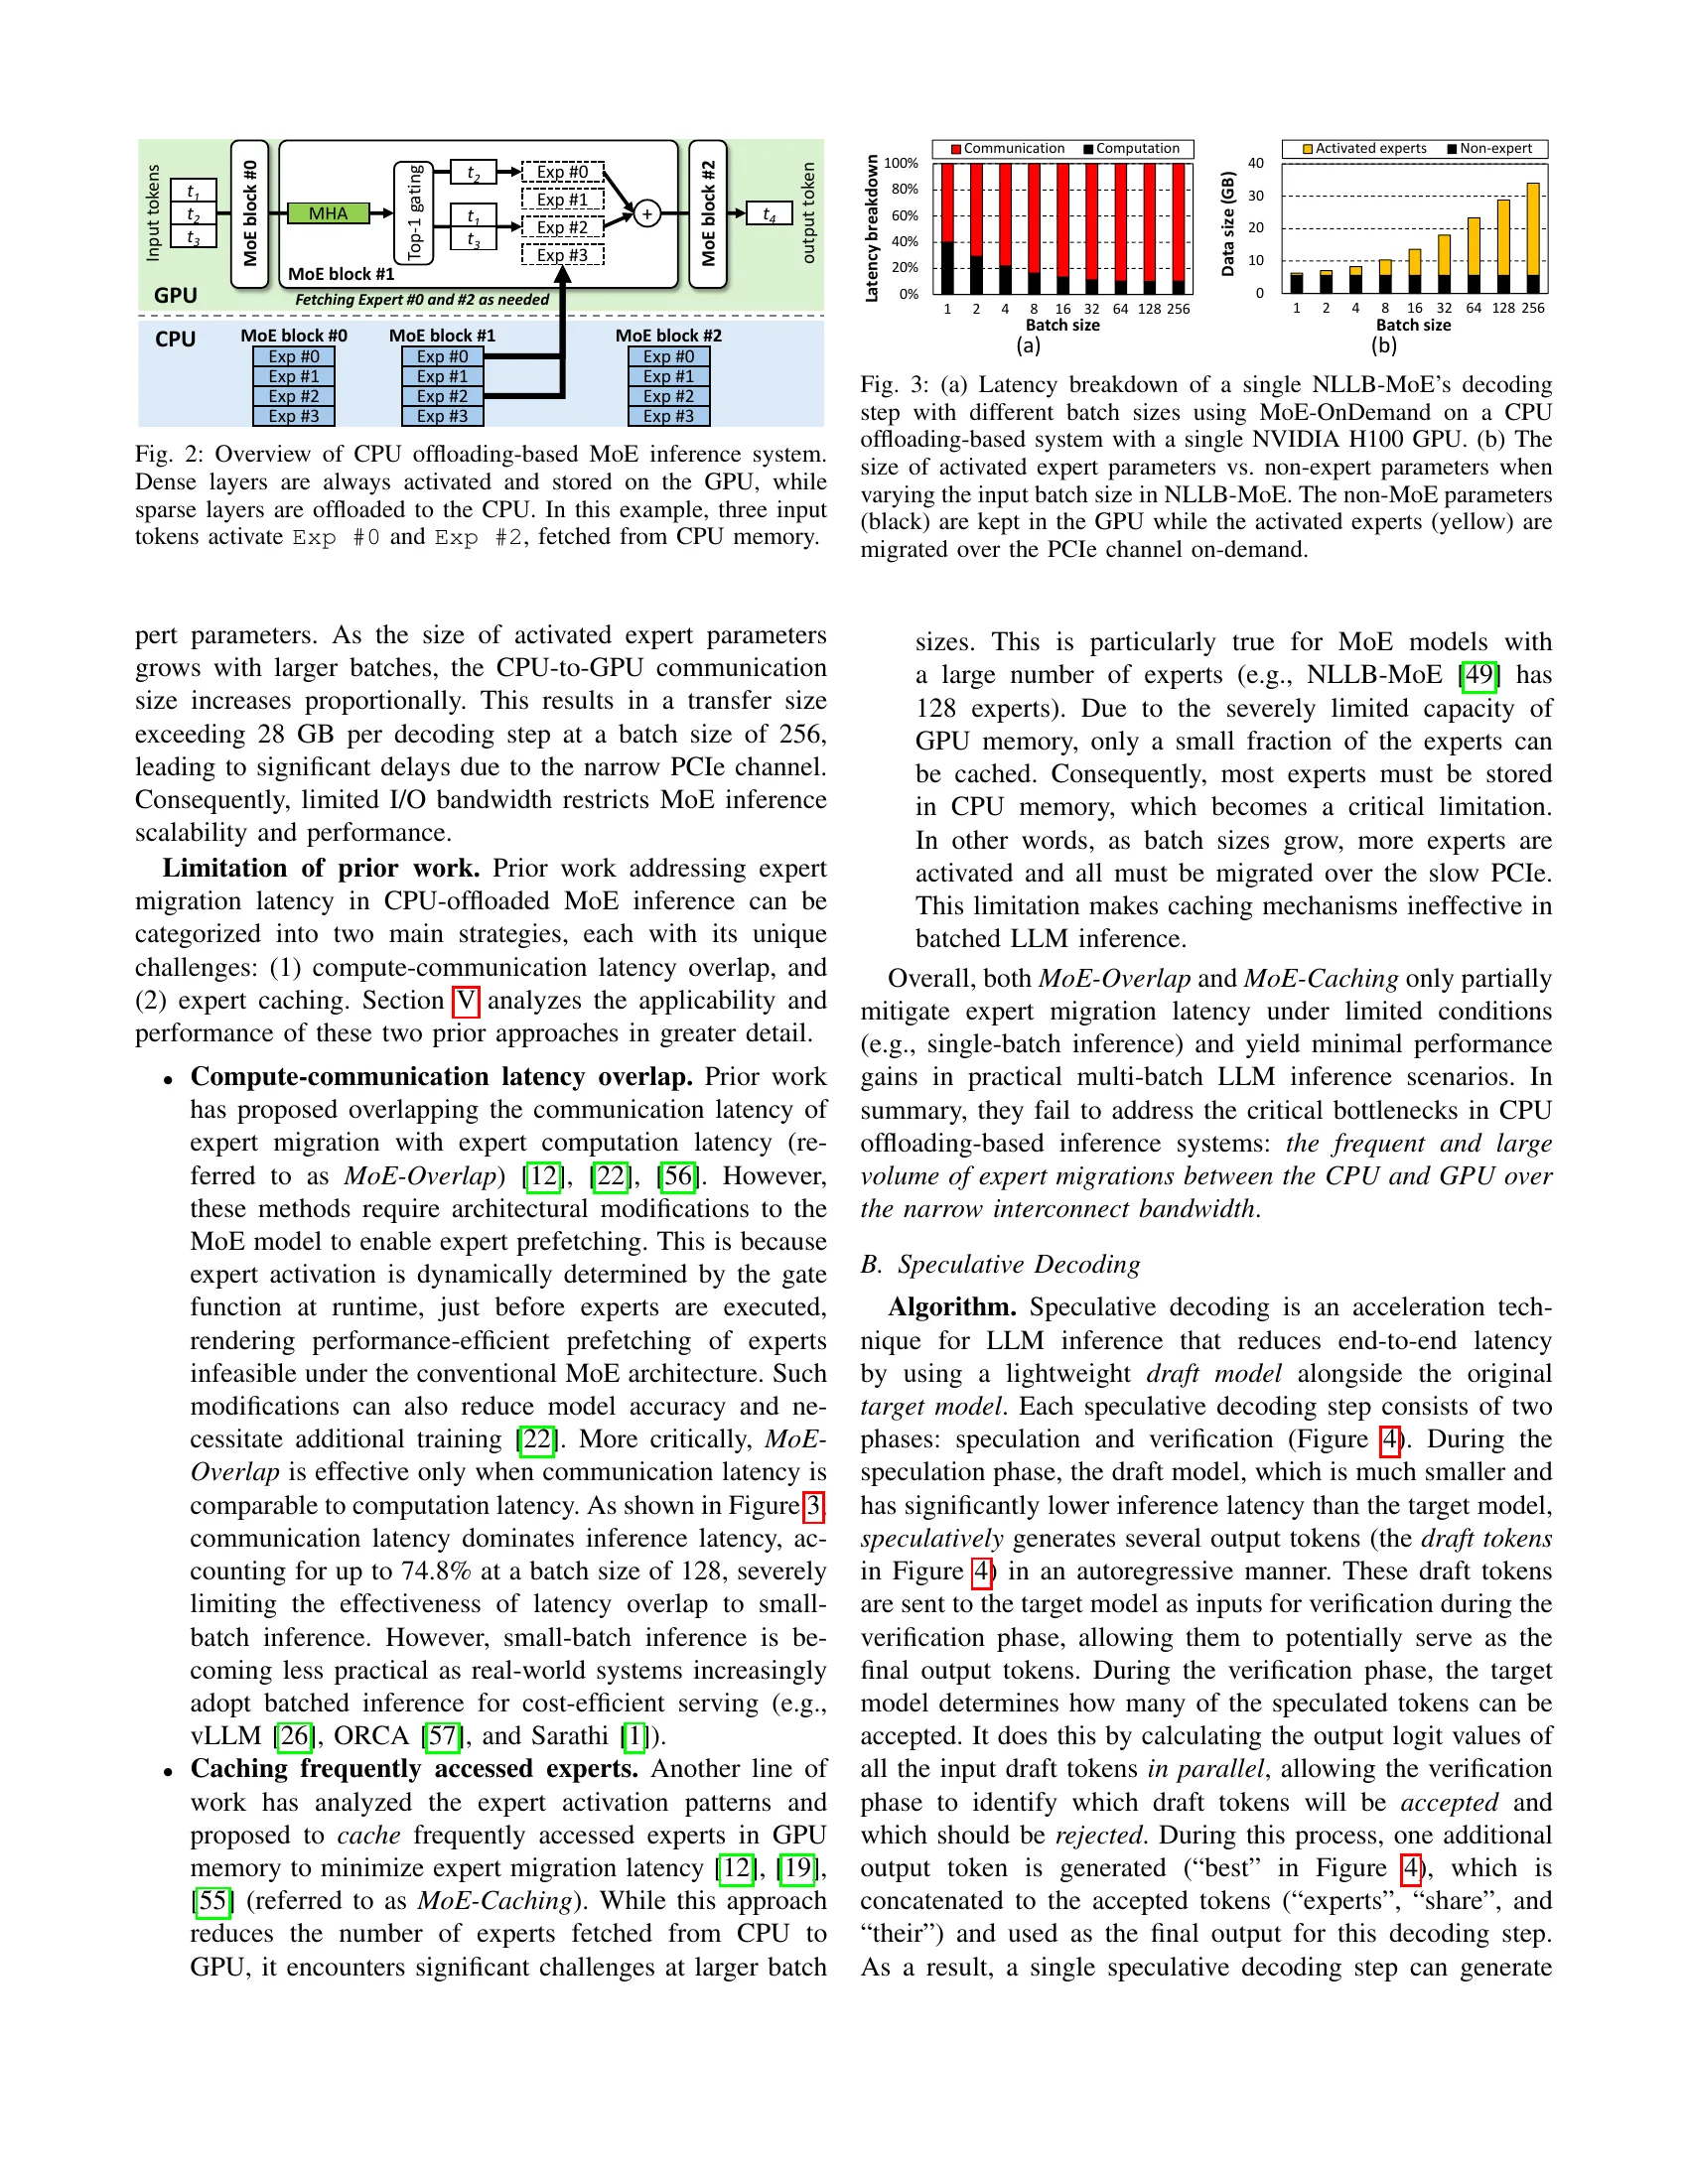
算法流程:
-
草稿阶段(CPU):
- 使用MoE模型的稀疏激活特性作为”草稿”
- 预测未来γ个token可能激活的专家
- 利用专家激活的局部性减少预测开销
-
验证阶段(GPU):
- 接收CPU预测的专家集合
- 执行实际的前向传播
- 验证预测的正确性
-
专家预取:
- 根据预测结果提前从CPU内存加载专家到GPU
- 重叠计算和数据传输
内存层次设计
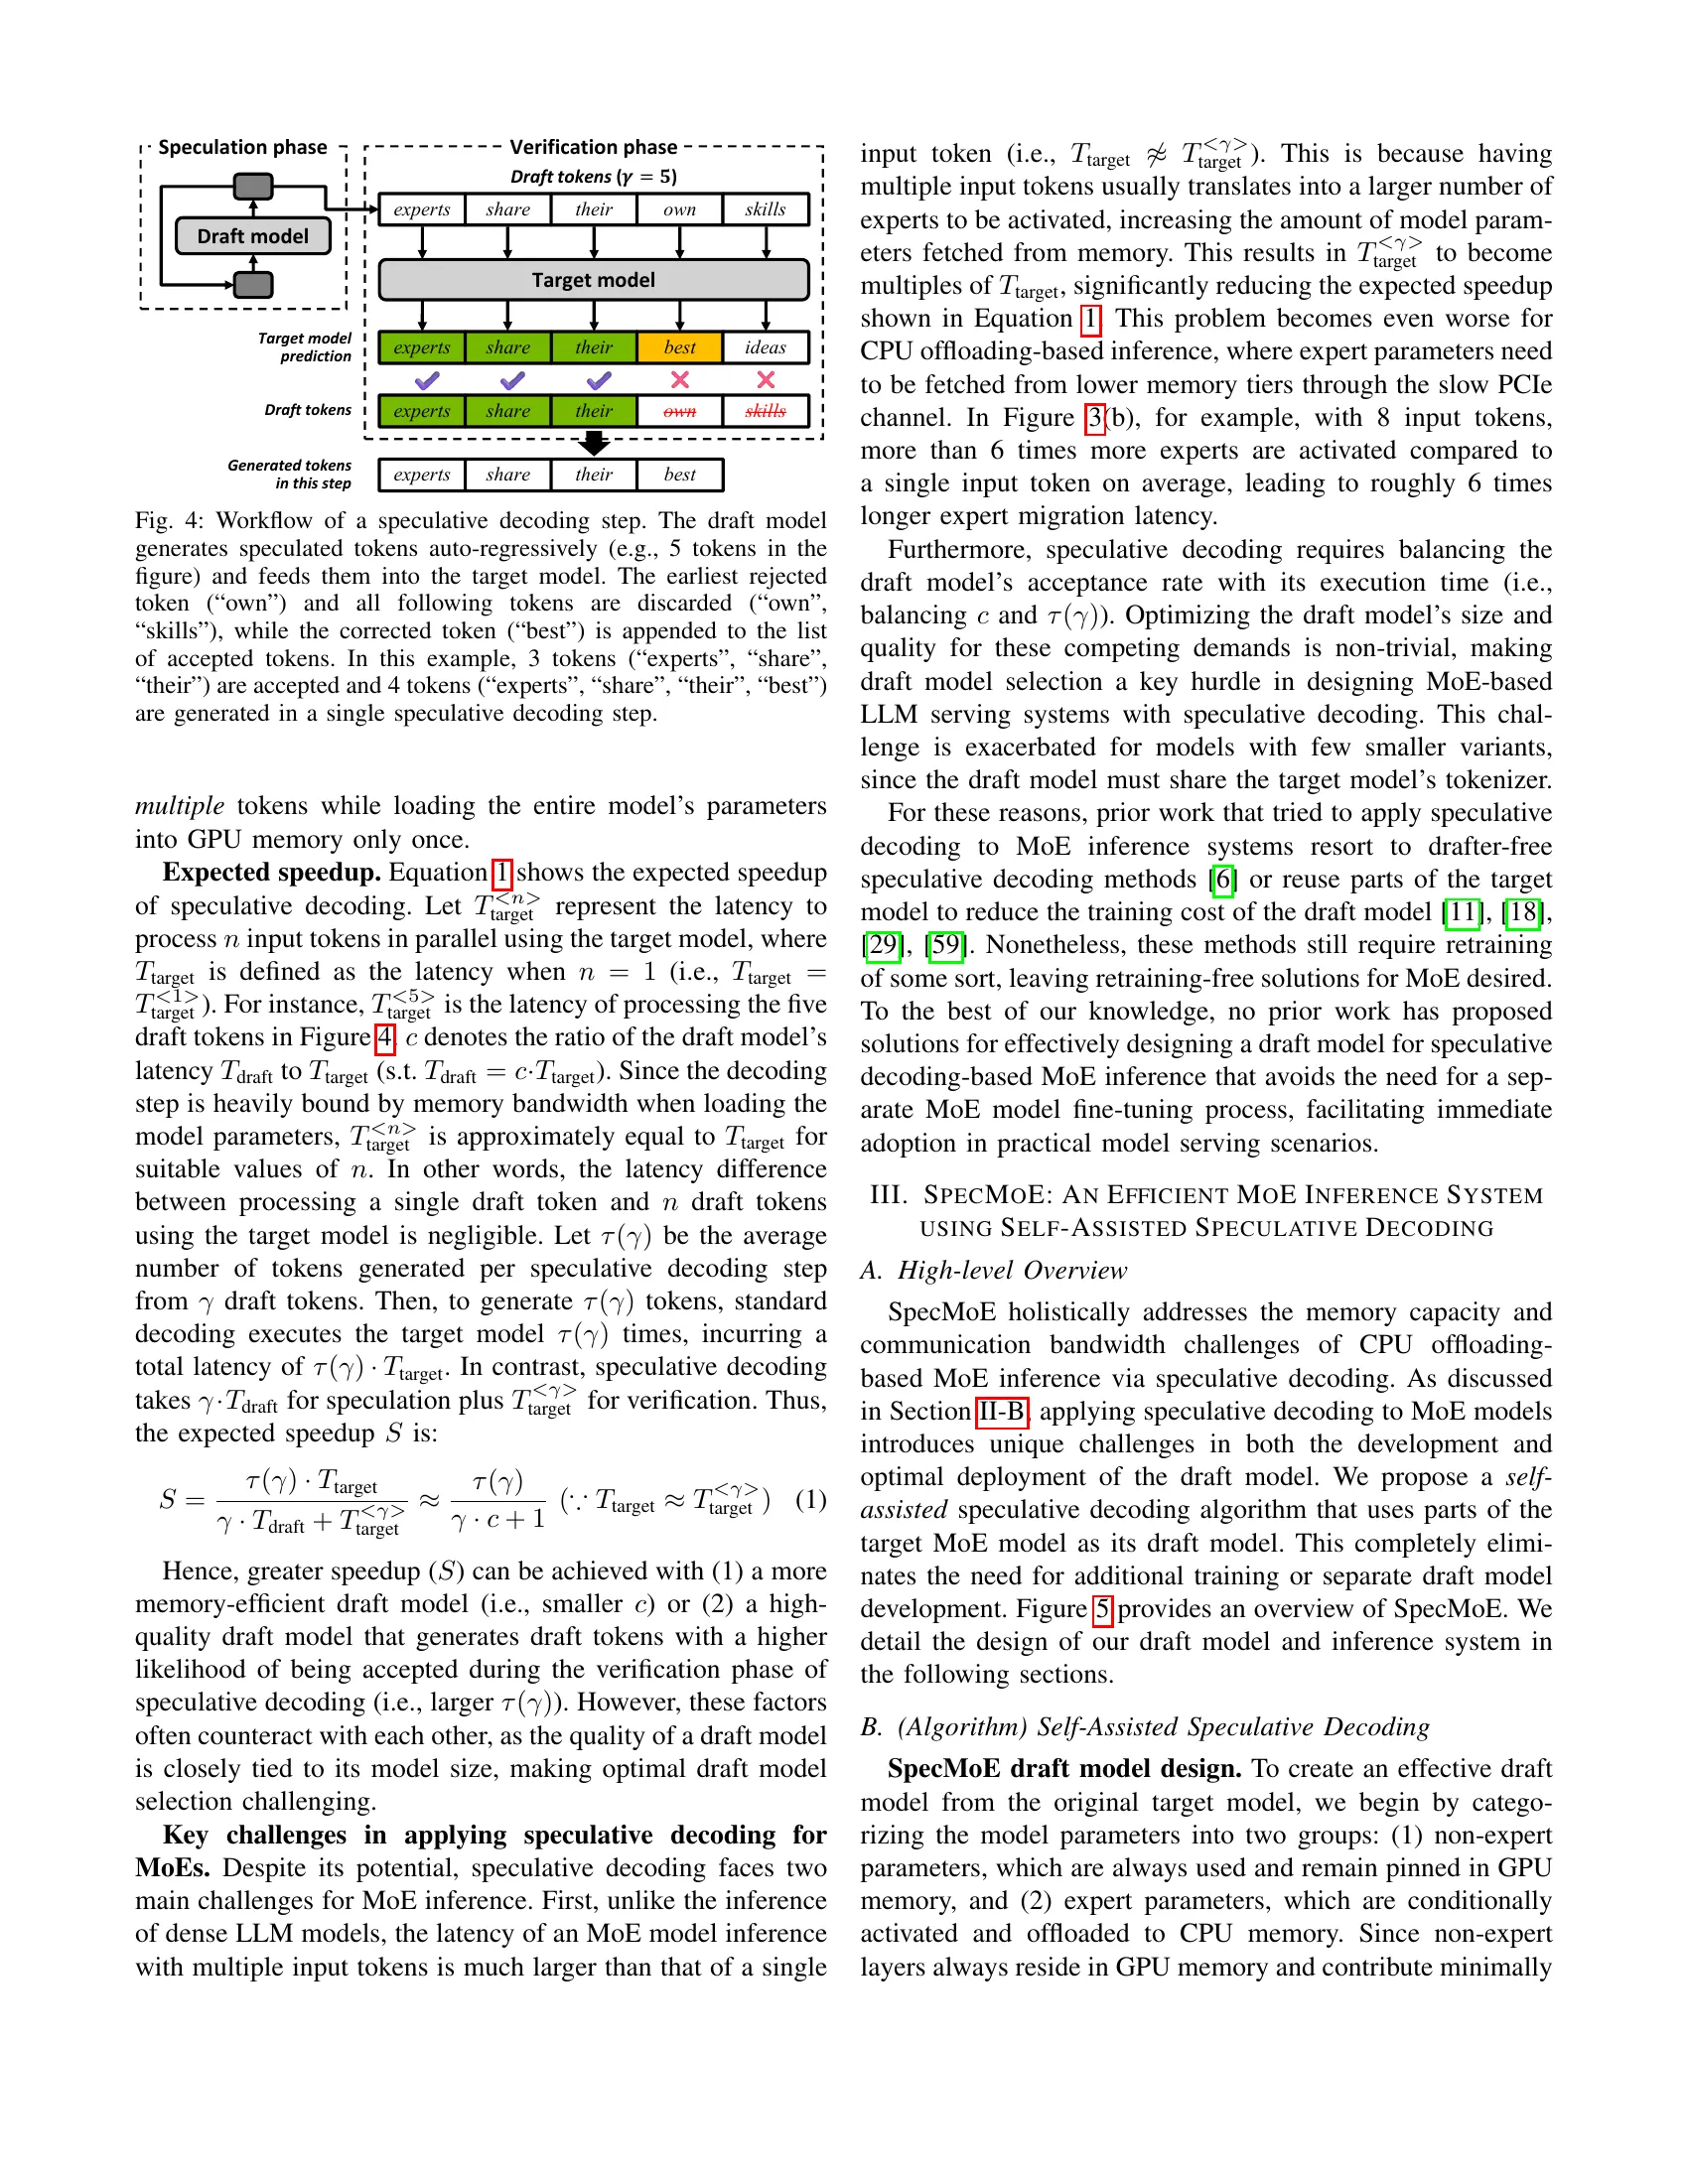
三级内存架构:
- GPU HBM:存储活跃专家和KV缓存
- CPU DRAM:存储所有专家参数
- NVLink/PCIe:高速互联传输
关键优化:
- 专家激活的局部性使得预测准确率高
- 预取机制隐藏了数据传输延迟
- 批量传输减少通信开销
推测解码的MoE适配
传统推测解码 vs SpecMoE:
| 方面 | 传统推测解码 | SpecMoE |
|---|---|---|
| 草稿模型 | 小型独立模型 | MoE模型自身 |
| 预测目标 | 未来token | 未来token的专家激活 |
| 验证方式 | token级别 | token + 专家级别 |
| 额外训练 | 需要 | 不需要 |
专家预取策略
预取决策:
- 基于历史激活模式预测未来专家
- 考虑GPU内存容量限制
- 优先预取高概率激活的专家
预取时机:
- 在当前token验证期间预取下一个token的专家
- 利用计算和传输的重叠
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 自辅助推测解码 | 利用MoE模型自身稀疏性作为草稿 | 无需额外训练 |
| 专家激活局部性 | 相邻token激活相似专家 | 预测准确率分析 |
| CPU-GPU协同 | 草稿在CPU,验证在GPU | 内存效率提升 |
| 选择性预取 | 根据预测提前加载专家 | 隐藏传输延迟 |
| 无需微调 | 直接应用于预训练模型 | 通用性强 |
五、实验结果
实验设置
模型:
- Mixtral 8×7B:8个专家,top-2选择
- 其他MoE模型
硬件平台:
- GPU:NVIDIA A100/H100
- CPU:高性能服务器CPU
- 互联:NVLink/PCIe
评估指标:
- 吞吐量(tokens/s)
- 延迟(TTFT, TBT)
- 内存使用
- 带宽需求
吞吐量提升
主要结果:
- 最高 4.30× 吞吐量提升
- 在内存受限场景下效果显著
- 大batch size下优势更明显
内存效率
内存优化:
- 显著降低GPU内存需求
- 减少互联带宽需求
- 支持更大的batch size
与基线对比
对比方法:
- 标准MoE推理
- CPU-offloaded MoE推理
- 其他推测解码方法
SpecMoE优势:
- 比标准CPU-offload效率更高
- 无需额外模型训练
- 在不同batch size下均有效
六、相关工作
| 方法 | 特点 | SpecMoE优势 |
|---|---|---|
| 标准MoE推理 | 全部在GPU上 | 内存需求高 |
| CPU-offload MoE | 专家在CPU上 | 大batch效率低 |
| 推测解码 | 需要额外草稿模型 | 需要训练 |
| 专家缓存 | 静态缓存策略 | 适应性差 |
| SpecMoE | 自辅助推测解码 | 无需训练,效率高 |
七、总结
核心贡献
- 自辅助推测解码:首次将推测解笔应用于MoE推理,无需额外训练
- 专家激活局部性利用:发现并利用相邻token的专家激活相似性
- CPU-GPU协同优化:草稿在CPU,验证在GPU,最大化内存效率
- 选择性专家预取:根据预测结果提前加载专家,隐藏传输延迟
- 显著性能提升:最高4.30×吞吐量提升,内存和带宽需求大幅降低
技术影响
- 为MoE模型在内存受限环境下的部署提供了新思路
- 证明了推测解码思想可以成功应用于MoE架构
- 无需额外训练的特性使其易于部署
- 与现有MoE优化技术正交,可进一步结合
局限性
- 依赖于专家激活的局部性假设
- 在某些工作负载下预测准确率可能下降
- CPU-GPU协同引入额外复杂性
- 需要仔细调优预取策略
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | SpecMoE架构总览 | page2-02.png |
| Figure 2 | 推测解码流程 | page3-03.png |
| Figure 3 | 内存层次设计 | page4-04.png |
| Figure 4 | 实验结果 | page5-05.png |
| Figure 5 | 性能对比 | page7-07.png |
| Figure 6 | 内存分析 | page8-08.png |
| Figure 7 | 消融实验 | page9-09.png |