Networking-Aware Energy Efficiency in Agentic AI Inference: A Survey(面向网络感知的 Agentic AI 推理能效综述)
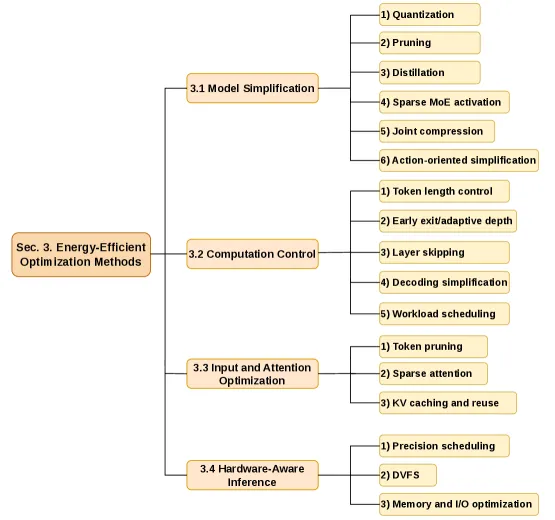
CGO 2026 预印本 arXiv 2604.07857。Cornell + NVIDIA 团队(与 Tawa 同作者群)。这是一篇综述论文,系统梳理了 Agentic AI(感知-推理-行动闭环智能体)的能耗挑战与优化方法。核心贡献:① 提出**能量核算框架**,将 Agentic AI 能耗拆解为**计算能量**(FLOPs + 内存访问,DRAM 访问 ~640 pJ vs 算术 <1 pJ)和**通信能量**(token 传输、中间结果交换、多智能体同步)两大瓶颈;② 建立**统一分类学**,四大支柱:模型简化(量化/剪枝/蒸馏/稀疏 MoE/动作简化)、计算控制(token 长度控制/早退/层跳过/解码简化/工作负载调度)、输入与注意力优化(token 剪枝/稀疏注意力/KV 缓存复用)、硬件感知推理(精度调度/DVFS/内存 I/O 优化);③ 探讨**跨层协同设计**:跨层优化变量(传输-推理耦合/移动感知调度/模型-信道自适应)、用户-边缘-云协作(分割推理/自适应卸载/协作缓存)、通信-推理联合设计(语义通信/RAG 通信/能量感知调度);④ 识别五大开放挑战:不确定性量化自适应推理、跨模态/跨智能体协作能效、绿色 AI 与性能权衡、联邦绿色学习、碳感知智能体、6G 原生 Agentic AI、能量收集自维持系统。
Networking-Aware Energy Efficiency in Agentic AI Inference: A Survey(面向网络感知的 Agentic AI 推理能效综述)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Networking-Aware Energy Efficiency in Agentic AI Inference: A Survey |
| 作者 | Xiaojing Chen, Haiqi Yu, Wei Ni, Dusit Niyato, Ruichen Zhang, Xin Wang, Shunqing Zhang, Shugong Xu |
| 机构 | 多机构合作(含 Nanyang Technological University, Beijing University of Posts and Telecommunications 等) |
| 论文 | arXiv:2604.07857(2026-04-09 提交) |
| 分类 | eess.SY(系统与控制)、cs.AI(人工智能) |
| 类型 | 综述论文(Survey) |
一句话总结:本文是 Agentic AI(感知-推理-行动闭环智能体)能效领域的首篇系统性综述,首次将计算能量与通信能量统一纳入分析框架,建立了从模型简化→计算控制→输入优化→硬件感知→跨层协同→无线-边缘-云协作的完整分类学,并指出了联邦绿色学习、碳感知智能体、6G 原生 Agentic AI 等前沿方向。
二、核心动机:Agentic AI 的能量困境
Agentic AI 的概念与框架
智能体经历了四代演进:
| 阶段 | 核心驱动 | 推理能力 | 记忆 | 能量特征 | 局限 |
|---|---|---|---|---|---|
| DRL 智能体 | 策略网络(DQN/PPO) | 隐式/弱 | 短期 Markov 状态 | 很低(推理阶段) | 泛化差 |
| LLM 智能体 | 静态概率生成 | 静态 CoT | 固定上下文窗口 | 高(线性增长) | 缺乏自主性 |
| 标准 Agentic AI | 感知-推理-行动闭环 | 动态长程推理 | 长期向量数据库 | 极高(乘性增长) | 高成本/高延迟 |
| 能效 Agentic AI | 资源感知协同设计 | 弹性深度+早退 | 压缩 KV 缓存 | 可控(算法-硬件协同) | 精度权衡 |
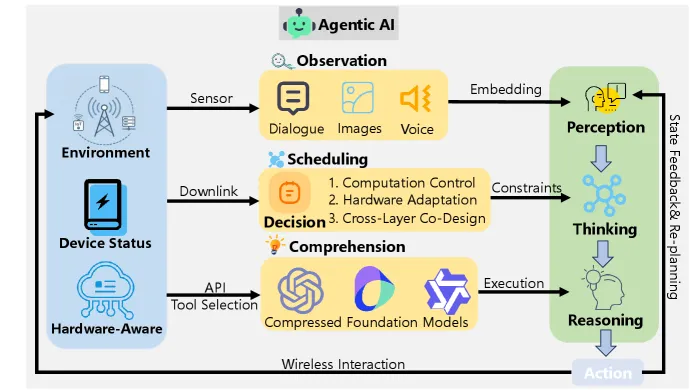
能量核算框架:两大瓶颈
Agentic AI 的闭环推理导致计算能量和通信能量双重消耗:
瓶颈 1:计算能量(Compute Energy)
- LLM 参数量从数十亿到数千亿,每次前向传播需要大量矩阵乘法和注意力计算。
- 多步推理(CoT 提示)、二次缩放注意力、多模态大中间表示 → 推理成为系统主要能耗来源。
- 关键转变:从传统 AI 的计算瓶颈(FLOPs)变为 Agentic AI 的内存瓶颈(I/O Wall)——频繁 off-chip DRAM 访问消耗约 640 pJ/次,而算术操作 <1 pJ。
瓶颈 2:通信能量(Communication Energy)
- Agentic 系统在分布式网络中运行:智能体与云服务器、边缘设备、peer 智能体持续交互。
- 通信能耗包括:token 传输、中间结果交换、同步、跨设备模型更新。
- 在 6G/边缘场景中,有限带宽、严格延迟、受限电池容量进一步放大通信负担。
乘性效应:每次推理循环调用 memory-bound 的 Reasoning 模块,可能触发额外的 Perception(信息收集)和 Action(执行步骤)操作——计算与通信联合形成关键能量瓶颈。
四大模块的能量特征
| 模块 | 主要操作 | 计算能量 | 内存能量 | 通信能量 | 关键瓶颈 |
|---|---|---|---|---|---|
| Perception | 视觉编码、RAG 检索 | 高 | 中 | 低 | 视觉编码器 FLOPs |
| Reasoning | LLM 推理、CoT 生成 | 中 | 非常高 | 低-中 | KV 缓存容量 |
| Action | 工具/API 调用、多智能体协调 | 中 | 低 | 高 | 多智能体通信 |
| Memory | KV 缓存管理、检索 | 低 | 非常高 | 中 | 缓存碎片化、GPU-CPU/DRAM 传输 |
三、统一分类学:四大优化支柱(Section 3)
支柱 1:模型简化(Model Simplification)
减少模型结构复杂度,同时保持功能,使模型更轻、更快、更节能。
3.1.1 量化(Quantization)
- 将权重/激活从全精度 FP16 降为 INT8/INT4/INT3。
- 关键数据:3-bit/4-bit 量化可比 FP16 节省高达 79% 能耗。
- 精度权衡:常识 QA 任务准确率下降 <5%;复杂推理/数学任务(如 GSM8K)下降 20%-30%。
- 代表性工作:
- QLLMS:量化自适应调度框架,联合选择量化级别和资源分配。
- DOL-LLM:混合精度量化 + 结构化剪枝 + 蒸馏,ARM 处理器上节能 30%-50%。
- Edge-LLM (LUC):逐层统一压缩,同等资源限制下准确率 +0.70%-1.29%。
3.1.2 剪枝(Pruning)
- 去除冗余参数/神经元/注意力头/前馈块(非结构化或结构化)。
- Sheared LLaMA:将 7B 模型端到端剪枝到 1.3B/2.7B,适配边缘内存和延迟预算。
- SparseGPT:一次性剪枝,在 OPT-175B 上实现 50%-60% 稀疏度,困惑度仅微增。
- GreenLLM:硬件能量估计引导的剪枝框架,在 Llama-7B 上节能和延迟降低 >30%。
3.1.3 蒸馏(Distillation)
- 教师模型知识 → 学生模型,降低推理能量。
- MobileLLM:sub-billion 参数框架,350M 8-bit 模型仅 0.035 J/token(vs 7B LLaMA-v2 的 0.7 J/token),可实现全天设备推理。
- AICD:自回归上下文蒸馏,联合优化 CoT 推理能力。
3.1.4 稀疏 MoE 激活
- 每个 token 仅激活少量专家,而非全量激活。
- EdgeMoE:专家权重动态加载,速度提升最高 2.77×,部署 >>10B 参数 MoE 模型。
- SwapMoE:虚拟专家映射,内存减少 67%,延迟降低 50%。
3.1.5 联合压缩 & 动作导向简化
- 量化+剪枝+蒸馏联合:模型尺寸减少 60%,内存减少 50%。
- eSpark:零样本框架,通过 LLM 生成的 Python 函数修剪 MARL 中的无关动作,profit/cost 提升 39%。
- Wireless Federated Distillation (WFD):空中计算 + 蒸馏,将信道干扰转化为聚合增益。
支柱 2:计算控制(Computation Control)
动态调节 Agentic AI 推理中的工作量,避免均匀执行所有层/token/解码步骤。
3.2.1 Token 长度控制
- UniToCom:将 token 视为计算和传输的基本单位,利用生成式信息瓶颈学习简洁 token 表示。
- M/G/1 排队模型:最优 token 限制减少延迟和用户丢弃率。
3.2.2 早退/自适应深度
- “简单”输入浅层计算即退出,“困难”案例深入推理。
- CE-COLLM:边缘组件 + 早退点 + 全量云端模型,减少通信开销。
- 分布式推理:轻量草稿模型 + 大目标模型,在 Unitree Go2 机器人上实现 21% 加速。
3.2.3 层跳过(Layer Skipping)
- 跳过不必要的 Transformer 层。
- JARVIS:分布式 LLM 框架,层拆分 + 跳过 + 恢复机制,增强鲁棒性。
- 层跳过联邦学习:冻结下层,选择性训练上层,通信成本降低 70%。
3.2.4 解码简化
- EdgeLLM:投机解码 + 宽度自适应 token 树,每 token 生成加速最高 9.3×。
- DSSD:分布式投机解码,边站和终端间分区验证,加速 1.5×-2.4×。
3.2.5 工作负载调度
- TAPAS:利用历史遥测数据优化 GPU VM 放置和工作负载路由(数据中心冷却约束)。
- Duo-LLM:动态 token 路由,基于任务复杂度。
- CoLLM:张量并行分布注意力/MLP,延迟感知分区,加速 1.9×-2.3×。
- 能量测试:1000 MB 传输成本 120-150 mAh,四设备协作比流水线基线节能。
支柱 3:输入与注意力优化(Section 3.3)
3.3.1 Token 剪枝
- LLMLingua:粗到细压缩,提示大小减少高达 20×,降低无线传输延迟和预填计算能量。
- SpAtten:基于累积注意力分数丢弃”懒惰”token。
- AIM:免训练多模态推理,视觉 token 合并 + PageRank 剪枝,FLOPs 减少 6.8×,预填时间减少 8×。
3.3.2 稀疏注意力
- FlashAttention:I/O 感知 exact attention,通过 tile 和重计算避免材料化完整注意力矩阵。
- M7BCO:稀疏自编码器 + Grouped Query Attention,WSN 能耗降至 20.2 mJ(150 节点)。
3.3.3 KV 缓存与复用
- Sim-LLM:余弦相似度 + 局部敏感哈希复用 KV 缓存。
- H2O:仅保留”Heavy Hitter” token,内存足迹减少 5×。
- KIVI:非对称量化(2-bit values, 4-bit keys),KV 内存减少 2.6×,支持 64K tokens。
- Quest:基于查询向量仅加载关键 KV cache pages,自注意力加速 2×。
支柱 4:硬件感知推理(Section 3.4)
3.4.1 精度调度(Precision Scheduling)
- LLM-MQ:基于梯度的逐层敏感度分析,敏感层 INT4,非敏感层 INT2。
- EcoLLM:混合精度 + 结构化剪枝,压缩 6.4×,功耗降低 45%。
3.4.2 DVFS(动态电压频率调节)
- FUSE:统一 CPU-GPU-内存频率控制器,解决”向下螺旋”效应。TinyLlama-1.1B decode 阶段:424 MHz → 848 MHz,延迟降低 41%,能量相近。
- POLCA:GPU 频率锁定 + 功率封顶重叠推理,数据中心 30% 更多服务器同功率预算。
3.4.3 内存与 I/O 优化
- 减少 CPU-GPU 传输和存储读取。
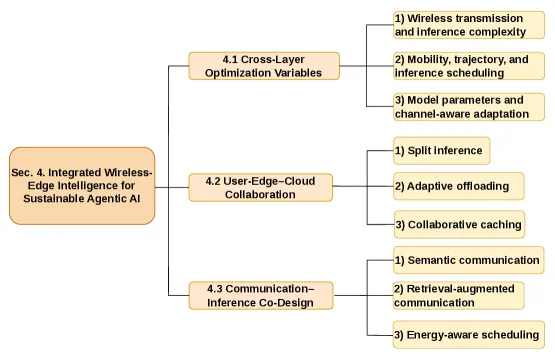
四、跨层协同设计(Section 4)
4.1 跨层优化变量
| 变量对 | 说明 | 代表工作 |
|---|---|---|
| 传输功率 ↔ 推理复杂度 | 长序列 → 高带宽/鲁棒调制;短序列 → 低通信成本 | 主动推断框架(自由能原理) |
| 移动轨迹 ↔ 推理调度 | 无人机/机器人路径决定通信距离和传输能量 | 物理路径与计算密集型推理任务联合优化 |
| 模型参数 ↔ 信道状态 | 强信道 → 大模型高精度;弱信道 → 压缩版本 | MoE 动态门控(根据带宽选专家) |
4.2 用户-边缘-云协作
| 策略 | 说明 | 代表工作 |
|---|---|---|
| 分割推理 | 轻量层在设备、中间层在边缘、重型层在云 | MBRL 动态分层点选择 |
| 自适应卸载 | 算子/ token 级实时决策 | WDMoE:门控和注意力在边缘,专家在设备 |
| 协作缓存 | 语义感知缓存,绕过冗余 LLM 调用 | 联邦学习识别等效查询 |
4.3 通信-推理联合设计
- 语义通信:传输紧凑 prompt 而非原始数据,接收方用生成模型重建。
- 检索增强通信:传输/复用 KV cache(KVCOMM)或检索 passage 而非全文。
- 能量感知调度:碳感知路由,利用空闲 GPU 周期批处理。
4.4 经验教训
- 协同 > 孤立:联合调优无线传输、模型复杂度和调度决策创造孤立优化无法达到的能效。
- 适应性是关键:协作粒度取决于信道条件、设备能力和任务紧急程度。
- 语义效率超越比特效率:交换紧凑 prompt、KV cache 或检索知识而非原始数据。
- 鲁棒性需协同设计:无线波动和智能体移动使卸载决策快速过时。
五、开放挑战与未来方向(Section 5)
5.1 基本权衡
- 推理可靠性 vs 能量效率:当前早退机制依赖启发式置信度阈值,在高危场景可能失效。需不确定性量化的自适应推理框架(如 anytime-valid confidence sequences)。
- 跨模态/跨智能体协作:需模态特异性能量预算、共享语义潜在空间、共识分布式推理。
- 绿色 AI vs 性能需求:需上下文感知性能合约(如导航智能体在路口全精度、高速路段激进压缩)。
5.2 新兴范式
- 联邦绿色学习:能量感知联邦优化、语义梯度压缩、异步聚合。
- 碳感知智能体:碳强度预测、地理负载均衡、碳预算 API。
- 6G 原生 Agentic AI:智能切片、AI 原生 6G 协议(MCS 适应行动重要性)。
- 能量收集自维持系统:无电池 IoT(太阳能/射频/动能)、能量自适应推理、碳负排放操作。
六、总结
核心贡献
- 提出 Agentic AI 能量核算框架,区分计算能量和通信能量两大瓶颈。
- 建立统一分类学:四大优化支柱(模型简化/计算控制/输入注意力优化/硬件感知推理),涵盖 20+ 具体技术和 80+ 引用工作。
- 系统综述跨层协同设计:传输-推理耦合、用户-边缘-云协作、通信-推理联合设计。
- 识别五大开放挑战和四大新兴范式,为可持续 Agentic AI 部署提供路线图。
技术影响
- 首次将 Agentic AI 的闭环推理能耗(乘性增长)与传统 AI 的单次前向传播能耗(线性增长)明确区分。
- 为 Tawa、Twill 等 warp 特化编译器提供了系统级视角——这些编译器优化 GPU kernel 层面的计算能量,而本文覆盖从模型简化→无线传输→碳感知的全栈能效优化。
- 与轻量化模型论文系列(量化/剪枝/蒸馏/MoE)形成互补:本文聚焦Agentic AI 特有的闭环推理和分布式通信能耗,而非单一模型压缩技术。
局限性
- 作为综述,不提供新的算法或实证结果。
- 分类学覆盖面广但深度有限,部分子领域(如语义通信)引用较少。
- 尚未包含 Blackwell 架构最新特性(Tensor Memory)对能效的影响分析。
七、参考资源
- 论文:arXiv:2604.07857 / HTML v1
- 相关文档(同一 warp 特化/能效研究脉络):
- Tawa: 自动 Warp 特化编译器 (CGO 2026)(同作者群,面向 Hopper 的 aref 自动 WS)
- Twill: 最优软件流水线与 Warp 特化 (arXiv 2512.18134)(SMT 求解器自动发现 SWP+WS)
- Singe: 用 Warp 特化实现 GPU 高性能 (PPoPP’14)(warp 特化 DSL 编译器)
- CudaDMA: 通过 Warp 特化优化 GPU 内存带宽 (SC’11)(warp 特化起源)
- Veda: 蒸馏式稀疏注意力(现代 Hopper kernel 的 warp specialization 实践)