MegaTrain: Full Precision Training of 100B+ Parameter Large Language Models on a Single GPU
MegaTrain:在单GPU上全精度训练100B+参数大语言模型
MegaTrain: Full Precision Training of 100B+ Parameter Large Language Models on a Single GPU
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MegaTrain: Full Precision Training of 100B+ Parameter Large Language Models on a Single GPU |
| 作者 | Zhengqing Yuan, Hanchi Sun, Lichao Sun, Yanfang Ye |
| 论文 | https://arxiv.org/abs/2604.05091 |
| 代码 | https://github.com/DLYuanGod/MegaTrain |
| 发布 | 2026-04-06 |
| 类别 | cs.CL (计算语言学), cs.DC (分布式计算), cs.OS (操作系统) |
核心亮点
- 单GPU训练120B模型:在H200 (141GB HBM) + 1.5TB主机内存上可靠训练120B参数模型
- 1.84x吞吐量提升:14B模型训练时相比DeepSpeed ZeRO-3 Offload
- 250+ TFLOPS持续性能:32B模型在GH200上维持250+ TFLOPS
- 512K超长上下文:单GH200支持7B模型512K token上下文训练
- 全精度训练:不牺牲训练精度,与标准全GPU训练数值一致
二、核心思想
问题定义
随着LLM扩展到千亿参数规模,训练重心从预训练转向后训练(指令微调、对齐、领域适配、Agent专业化)。这些工作负载计算量相对较小,原则上可以在单节点上完成。然而,微调仍需将完整模型参数和优化器状态加载到内存中,使得百亿级模型在普通硬件上不可用。
关键矛盾:LLM开发正在向内存密集型、节点规模的后训练转变,但大多数从业者缺乏GPU资源参与。调查显示,167所美国大学中只有两所实现平均每位学生超过一块H100 GPU的可用性。
解决方案概述
MegaTrain提出**内存中心(memory-centric)**训练范式:
- CPU作为参数主存储:所有持久训练状态(参数、优化器状态、累积梯度)存储在主机内存中
- GPU作为瞬态计算引擎:GPU仅用于计算,不持久存储参数
- 按需流式传输:每层参数在计算前流式传入GPU,计算后立即释放
- 无状态执行模型:用层模板动态绑定流式参数,消除持久autograd图的内存开销
核心洞察:当参数流式传输而非持久驻留时,即使是普通硬件也能处理千亿参数工作负载。
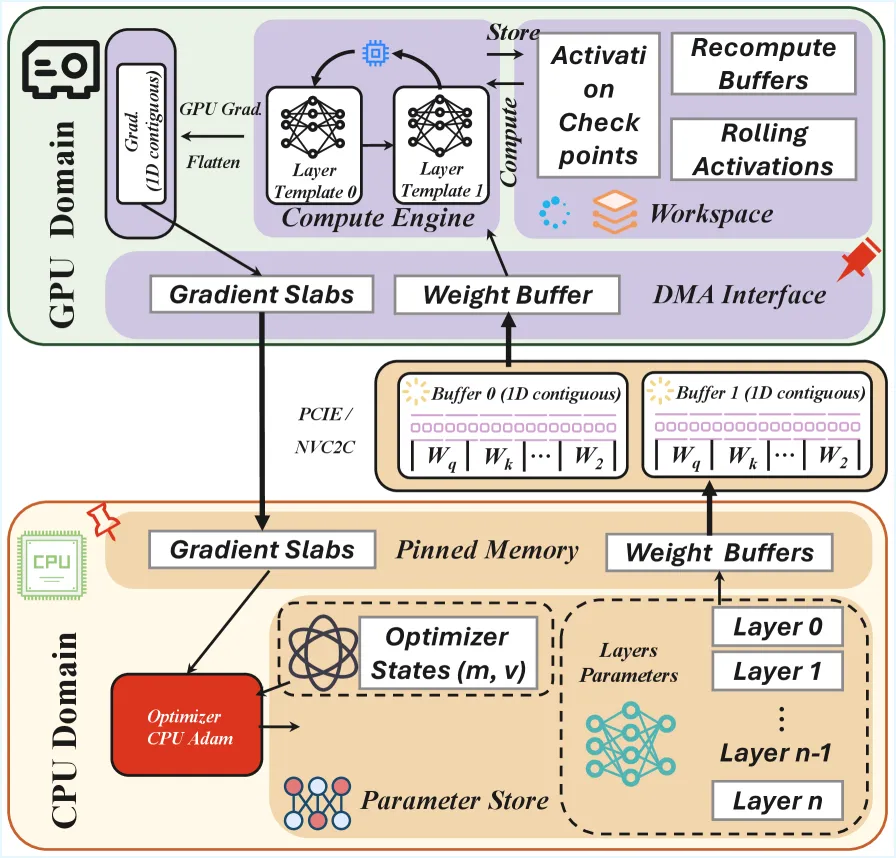
Figure 2: MegaTrain架构:CPU作为参数存储,GPU通过异步参数流式传输和梯度卸载执行瞬态层模板。
三、技术架构
3.1 内存层次结构
Table 1: H200和GH200的内存层次结构
| 层级 | 容量 | 带宽 | 单位成本 ($/GB) |
|---|---|---|---|
| SRAM (片上) | ~50-112 MB | ~80 TB/s | — |
| H200 SXM | |||
| HBM3e (每GPU) | 141 GB | 4.8 TB/s | ~20 |
| 主机DDR5 | 2-4 TB | ~200 GB/s | ~5-12 |
| PCIe Gen5链路 | — | 128 GB/s | — |
| GH200 | |||
| HBM3 (每GPU) | 96 GB | 4.0 TB/s | ~20 |
| 主机LPDDR5X | 480 GB | 512 GB/s | ~6-8 |
| NVLink-C2C链路 | — | 900 GB/s | — |
| NVMe SSD | 10+ TB | 5-14 GB/s | ~0.1 |
关键设计:MegaTrain反转了传统关系——主机内存成为所有持久训练状态的主存储,设备内存仅作为瞬态计算缓存。
3.2 执行工作流
流式前向传播:
- 从主机内存逐层流式传输参数到设备内存的权重缓冲区
- 预取下一层权重,使计算流可以立即绑定并执行当前层
- 每层完成后释放缓冲区,下一层权重立即流入
- 每 L/K 层检查点激活,保留在设备内存中
流式反向传播:
- 按反向块顺序进行
- 从检查点(驻留在设备内存中)开始,正向流式传输参数以重计算激活
- 反向流式传输参数计算梯度,立即将每层梯度卸载到主机内存
- 块级重计算用额外前向计算换取有界内存
优化器更新:
- 完全在CPU上执行
- Adam优化器轻量计算但I/O密集,避免优化器状态在GPU和CPU间往返传输
3.3 流水线执行引擎
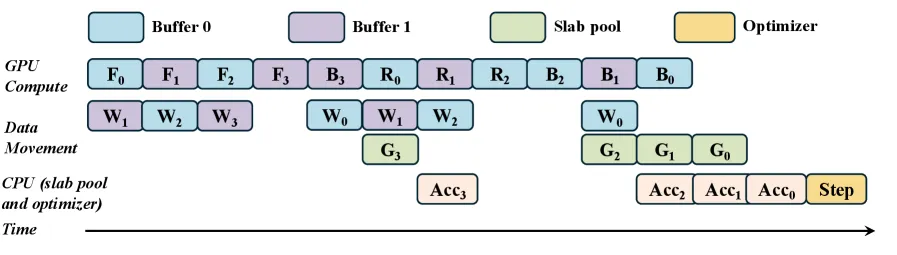
Figure 3: 端到端流水线执行。权重预取(WW)、计算(FF/RR/BB)和梯度卸载(GG)在三个CUDA流上重叠。
三个并发CUDA流:
| 流 | 功能 |
|---|---|
| S_comp | 计算流,执行前向和反向计算 |
| S_H2D | 权重传输流,从CPU到GPU传输参数 |
| S_D2H | 梯度传输流,从GPU到CPU卸载梯度 |
双缓冲机制:
- CPU和GPU域维护两组暂存缓冲区
- 乒乓预取策略:计算流使用Buffer 0执行层F_i时,权重传输流同时将层W_{i+1}打包到Buffer 1
- 确保GPU计算单元永远不停顿等待参数
CUDA事件同步:
- Weights-Ready事件:S_H2D完成W_i后记录,S_comp等待后绑定层i
- Backward-Done事件:S_comp生成∇θ_i后记录,触发S_D2H卸载
- Buffer-Free事件:S_D2H卸载完成后记录,S_H2D等待后重用缓冲区
3.4 内存管理
层连续分片(Layer-contiguous Tiling):
- 每层的所有状态(BF16权重、BF16梯度、FP32 Adam动量)打包为单个连续块
- 对齐到4KB页面,启用单突发DMA传输
- 饱和PCIe带宽(Gen4 x16上~26 GB/s)
梯度分片池(Gradient Slab Pool):
- 预分配梯度存储池,减少内存碎片
- 消除频繁的内存分配/释放开销
3.5 无状态执行模型
传统autograd的问题:
- 构建全局计算图,假设所有参数和中间激活保留在设备内存中
- 当权重逐层流式传输并立即驱逐时,假设被打破
- CUDA Graphs需要静态执行模式,无法捕获动态地址绑定
MegaTrain的解决方案:
- GPU持有空”模板”(Transformer层的计算内核)
- 动态绑定到流式传入的权重
- 完全消除存储巨大图元数据的需求
- 设备内存使用不超过单层的内存占用
四、核心公式
训练内存分析
持久状态:对于使用Adam优化器的混合精度训练,每个参数需要:
- BF16权重:2B
- BF16梯度:2B
- FP32优化器动量(m和v):8B
- 总计:每个参数12B
对于70B模型:12 × 70 × 10⁹ = 840 GB持久状态
激活内存(块级重计算):
其中:
- :batch中的token数
- :任何单层的最大激活大小
- :模型深度
- :检查点间隔
关键:设备内存使用与模型深度无关,仅取决于单层激活大小。
流式传输条件
重叠条件:每层参数的传输时间必须完全隐藏在前一层的计算时间下:
其中 是层i的参数大小, 是PCIe带宽。
长上下文TFLOPS计算
其中 是token数, 是参数量, 是层数, 是注意力头数, 是序列长度。
五、实验结果
5.1 实验设置
Table 2: 实验中使用的模型配置
| 模型 | 总参数量 | 层数 | 隐藏大小 | FFN大小 |
|---|---|---|---|---|
| Qwen2.5-7B | 7B | 28 | 3584 | 18944 |
| Qwen2.5-14B | 14B | 48 | 5120 | 13824 |
| Qwen2.5-32B | 32B | 64 | 5120 | 27648 |
| Qwen2.5-72B | 72B | 80 | 8192 | 29568 |
| GPT-OSS-120B (MoE) | 120B | 36 | 2880×128 | 2880×128 |
测试平台:
- GH200:72核Grace ARM CPU + GH200 GPU (96GB HBM3) + 480GB主机内存,NVLink-C2C 900 GB/s
- H200:Intel Xeon Platinum 8558 + H200 GPU (141GB HBM3e) + 1.5TB主机内存,PCIe Gen4
5.2 可行性边界
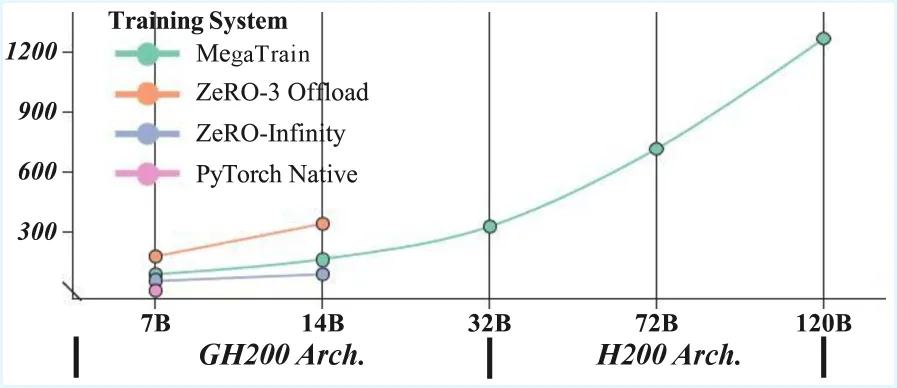
Figure 4: 不同训练系统下主机内存占用随模型规模的变化。
关键发现:
- ZeRO-3 Offload、ZeRO-Infinity、PyTorch Native随模型增长呈近指数增长
- MegaTrain保持显著更平坦的增长曲线
- 30B参数后,现有offloading系统迅速超出主机内存限制
- MegaTrain在120B规模仍保持在实际限制内
5.3 持续TFLOPS
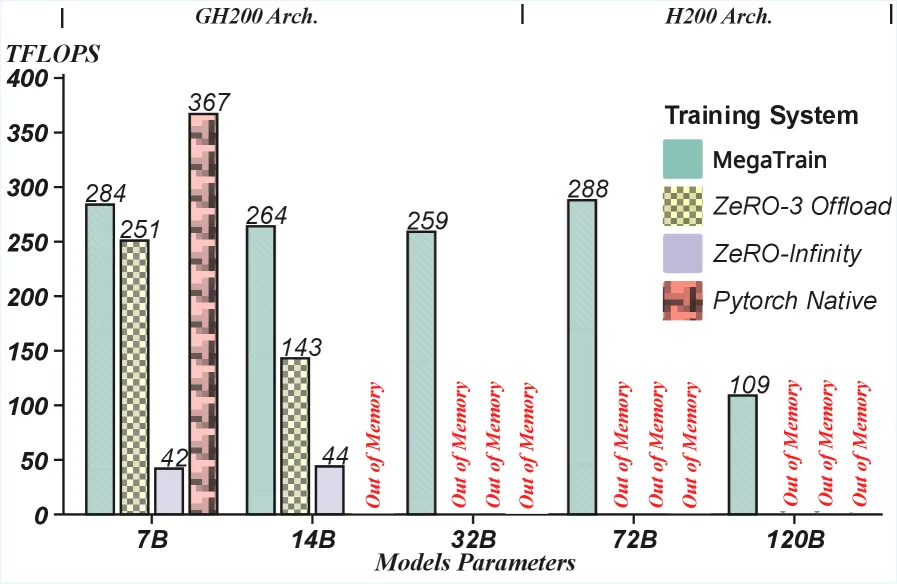
Figure 1: 不同模型规模下的持续TFLOPS。MegaTrain保持高效,而offloading基线变为GPU内存受限。
GH200性能:
| 模型 | MegaTrain TFLOPS | ZeRO-3 Offload TFLOPS | 加速比 |
|---|---|---|---|
| 7B | 284 | — | — |
| 14B | 264 | 143 | 1.84x |
| 32B | 250+ | OOM | — |
H200性能:持续扩展到72B和120B,保持高利用率。
5.4 精度验证
Table 3: 不同系统在7B和14B规模的最终精度对比
| 指标 | Baseline | ZeRO-3 Offload | ZeRO Infinity | PyTorch Native | MegaTrain |
|---|---|---|---|---|---|
| 7B Acc. (%) | 33.47 | 88.93 | 88.97 | 88.91 | 88.99 |
| 14B Acc. (%) | 37.58 | 92.41 | 92.36 | — | 92.52 |
结论:MegaTrain与标准全GPU训练和ZeRO基线的数值精度一致,无数值漂移或优化不稳定。
5.5 消融实验
Table 4: MegaTrain消融实验
| 配置 | Batch Size | TFLOPS | 设备内存 (GB) |
|---|---|---|---|
| MegaTrain (完整) | 96 | 266.3 | 75.93 |
| 去除双缓冲 | 96 | 182.91 (-31.3%) | 74.11 |
| 去除梯度分片池 | 96 | 257.55 | 75.93 |
| 检查点间隔=1 | 64 (96 OOM) | 240.45 | 81.34 |
关键发现:
- 双缓冲最关键:去除后吞吐量下降31.3%(266.3 → 182.9 TFLOPS)
- 梯度分片池影响较小(266.3 → 257.6 TFLOPS)
- 检查点间隔=1导致OOM,验证了块级重计算的必要性
5.6 深度可扩展性
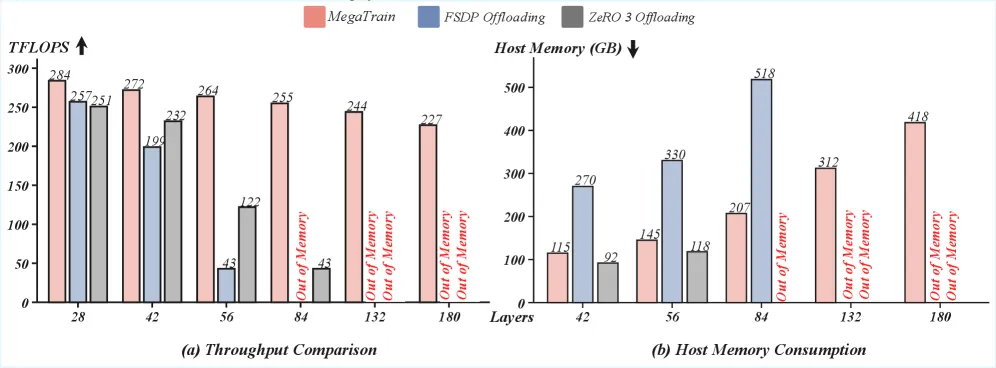
Figure 5: 固定模型宽度下的深度可扩展性。
Table 5: 深度研究模型配置
| 层数 | 参数量 (B) | 设备分配 (GB) |
|---|---|---|
| 28 | 7.62 | 3.83 |
| 42 | 10.88 | 3.83 |
| 56 | 14.14 | 3.83 |
| 84 | 20.67 | 3.83 |
| 132 | 31.85 | 3.83 |
| 180 | 43.04 | 3.83 |
关键:设备内存分配恒定3.83GB,与模型深度无关。
5.7 宽度可扩展性
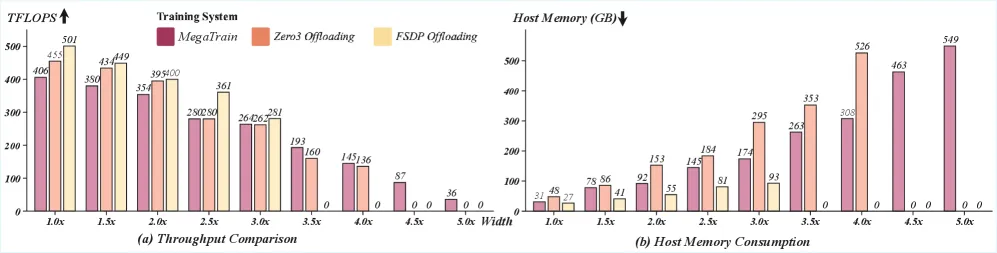
Figure 6: 固定模型层数下的宽度可扩展性。
Table 6: 宽度研究模型配置
| 宽度缩放 | 隐藏大小 | FFN大小 | 设备分配 (GB) |
|---|---|---|---|
| 1.0x | 3584 | 18944 | 3.83 |
| 2.0x | 7168 | 37888 | 11.07 |
| 3.5x | 12544 | 66304 | 28.44 |
| 5.0x | 17920 | 94720 | 53.62 |
关键:设备内存随宽度线性增长(因为单层激活大小增加)。
5.8 长上下文评估
Table 7: GH200上的长上下文训练性能
| 上下文 | Batch Size | Tokens | 步时间 (s) | TFLOPS | 内存 |
|---|---|---|---|---|---|
| 1K | 158 | 162.7K | 27.05 | 284.7 | 74.2 GB |
| 8K | 25 | 204.8K | 32.36 | 294.5 | 86.5 GB |
| 32K | 6 | 196.6K | 32.18 | 316.7 | 84.0 GB |
| 128K | 1 | 131.1K | 26.13 | 305.3 | 62.1 GB |
| 256K | 1 | 262.1K | 236.1 | 401.2 | 88.2 GB |
| 512K* | 1 | 524.3K | 871.4 | 407.4 | 81.9 GB |
*512K使用分块MLP执行以支持超长上下文。
5.9 不同设备验证
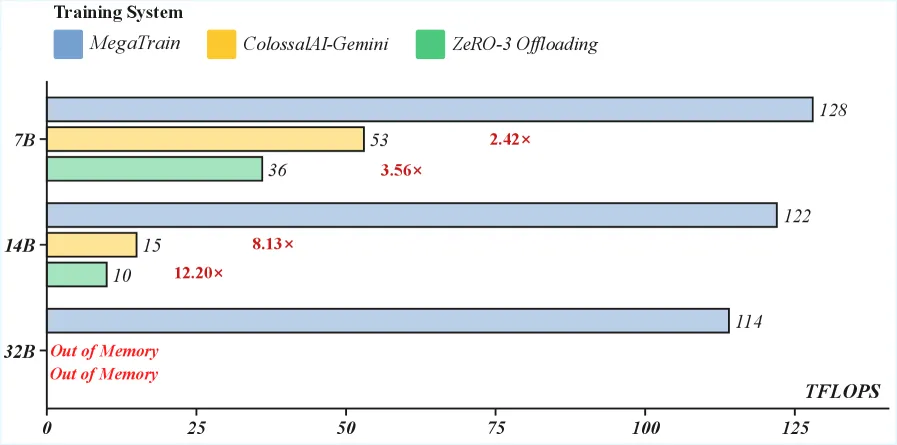
Figure 7: 单A100 PCIe系统上的性能对比。
Table 8: 三种PCIe系统的硬件特性
| A100 PCIe | RTX A6000 | RTX 3090 | |
|---|---|---|---|
| 峰值Tensor TFLOPS | 312.0 | 154.8 | 142.0 |
| 设备内存 | 80 GB HBM2e | 48 GB GDDR6 | 24 GB GDDR6X |
| 主机内存 | 600 GB DDR4 | 251 GB DDR4 | 251 GB DDR4 |
| PCIe带宽 | 32 GB/s | 32 GB/s | 16 GB/s |
| 主机带宽 | 140.8 GB/s | 204.8 GB/s | 204.8 GB/s |
Table 9: A6000和RTX 3090上的训练性能对比
| 模型 | 方法 | 最大BS | TFLOPS | GPU内存 | CPU内存 | tok/s |
|---|---|---|---|---|---|---|
| A6000 (48GB) | ||||||
| Qwen2.5-3B | MegaTrain | 15 | 49.70 | 46.74 GB | 38.3 GB | 2153 |
| ZeRO-3 Offload | 1 | 23.89 | 20.33 GB | — | — | |
| Qwen2.5-7B | MegaTrain | 12 | 55.73 | 44.74 GB | 56.7 GB | 1219 |
| ZeRO-3 Offload | 1 | 27.55 | 20.83 GB | — | — | |
| Qwen2.5-14B | MegaTrain | 9 | 56.82 | 44.64 GB | 104.1 GB | 641 |
| ZeRO-3 Offload | 1 | OOM | — | — | — | |
| RTX 3090 (24GB) | ||||||
| Qwen2.5-3B | MegaTrain | 7 | 33.18 | 22.83 GB | 25.0 GB | 1792 |
| ZeRO-3 Offload | 1 | 23.91 | 20.32 GB | — | — | |
| Qwen2.5-7B | MegaTrain | 5 | 35.09 | 22.63 GB | 56.7 GB | 768 |
| ZeRO-3 Offload | 1 | 27.49 | 20.83 GB | — | — | |
| Qwen2.5-14B | MegaTrain | 3 | 30.19 | 21.10 GB | 103.7 GB | 341 |
| ZeRO-3 Offload | 1 | OOM | — | — | — |
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 内存中心范式 | CPU作为参数主存储,GPU作为瞬态计算引擎 | 解耦模型规模与GPU内存 |
| 流式前向/反向 | 逐层流式传输参数,计算后立即释放 | 设备内存仅需单层占用 |
| 双缓冲流水线 | 三个CUDA流重叠参数预取、计算、梯度卸载 | 吞吐量提升31.3% |
| 无状态层模板 | 动态绑定流式参数,消除持久autograd图 | 消除图元数据内存开销 |
| 块级重计算 | 每L/K层检查点激活,块内重计算 | 激活内存与模型深度无关 |
| 层连续分片 | 每层状态打包为单个连续4KB对齐块 | 饱和PCIe带宽的单突发DMA |
| CPU优化器更新 | Adam完全在CPU上执行 | 避免优化器状态4x数据移动 |
七、与现有方法对比
| 方法 | 参数存储 | 设备内存需求 | 120B支持 | 特点 |
|---|---|---|---|---|
| PyTorch Native | GPU | 全量参数 | OOM | 峰值性能但无法扩展 |
| ZeRO-3 Offload | GPU+CPU分片 | 分片参数 | OOM | PCIe同步开销大 |
| ZeRO-Infinity | GPU+CPU+NVMe | 分片参数 | 勉强 | 碎片化传输 |
| MegaTrain | CPU主存储 | 单层占用 | ✓ | 流式传输,持续高性能 |
八、总结
核心贡献
- 内存中心训练系统:首次实现单GPU全精度训练120B参数模型
- 流式执行引擎:双缓冲三CUDA流流水线,重叠数据传输与计算
- 无状态执行模型:层模板动态绑定,消除持久autograd图内存开销
- 广泛硬件验证:在GH200、H200、A100、A6000、RTX 3090上验证
- 长上下文支持:单GH200支持7B模型512K token上下文训练
技术影响
- 民主化大模型训练:使百亿参数模型训练不再依赖多GPU集群
- 后训练加速:为指令微调、对齐、领域适配提供低成本方案
- 内存层次利用:展示了CPU-GPU内存层次的高效利用范式
- 系统设计启示:参数流式传输而非持久驻留的新训练范式
实际应用
- 学术研究:单GPU即可微调百亿参数模型
- 小团队开发:无需昂贵的多GPU集群
- 长上下文训练:支持超长序列的训练需求
- 资源受限环境:RTX 3090等消费级GPU也可训练14B模型
局限性
- 主机内存需求:仍需大容量主机内存(1.5TB用于120B模型)
- PCIe带宽瓶颈:PCIe系统相比GH200的NVLink-C2C性能较低
- 训练速度:相比全GPU驻留训练仍有差距
- 多GPU扩展:目前仅验证单GPU场景,多GPU扩展待探索
九、参考资源
- 论文: https://arxiv.org/abs/2604.05091
- 代码: https://github.com/DLYuanGod/MegaTrain
- ZeRO-Offload: https://arxiv.org/abs/2101.06840
- ZeRO-Infinity: https://arxiv.org/abs/2104.07857