DiffSparse: Accelerating Diffusion Transformers with Learned Token Sparsity
基于可学习 token 稀疏化的 DiT 加速框架
DiffSparse: Accelerating Diffusion Transformers with Learned Token Sparsity
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DiffSparse: Accelerating Diffusion Transformers with Learned Token Sparsity |
| 作者 | Haowei Zhu, Ji Liu, Ziqiong Liu, Dong Li, Junhai Yong, Bin Wang, Emad Barsoum |
| 机构 | AMD, Tsinghua University, BNRist |
| 论文 | arXiv:2604.03674 |
| 发布 | 2026年4月4日 |
| 主题 | cs.CV |
二、核心思想
问题定义
Diffusion Transformers (DiTs) 在图像生成中表现优异,但多步推理机制需要巨大计算成本。现有 token 缓存方法存在三个关键限制:
- 手动稀疏分配: 需要人工设置每层每个时间步的复用稀疏率,参数空间大且难以调优
- 全步设计依赖: 依赖预定义的全步计算(无缓存的步骤)来维持生成质量,限制了加速潜力
- 静态调度: 无法根据模型和数据动态优化稀疏配置
解决方案概述
DiffSparse 提出可学习的逐层稀疏优化框架:
- 可学习稀疏成本预测器: 预测每层每个时间步在不同稀疏率下的成本矩阵
- 动态规划求解器: 在全局稀疏约束下找到最优稀疏配置
- Token 选择器: 动态选择复用和重新计算的 token
- 两阶段训练策略: 消除对全步计算的依赖
核心性能
| 指标 | 数值 |
|---|---|
| PixArt-α 加速 | 1.91× (FID 27.79 vs 原始 28.20) |
| PixArt-α 稀疏率 43% | FID 26.91 (超越原始模型) |
| DiT-XL/2 加速 | 2.07× (FID 2.81 vs ToCa 3.05) |
| Wan2.1 视频生成 | 2.05× 加速 (VBench 43.83 vs 原始 43.82) |
| 训练时间 | ~4 小时 (8× AMD MI250 GPU) |
三、技术架构
整体框架
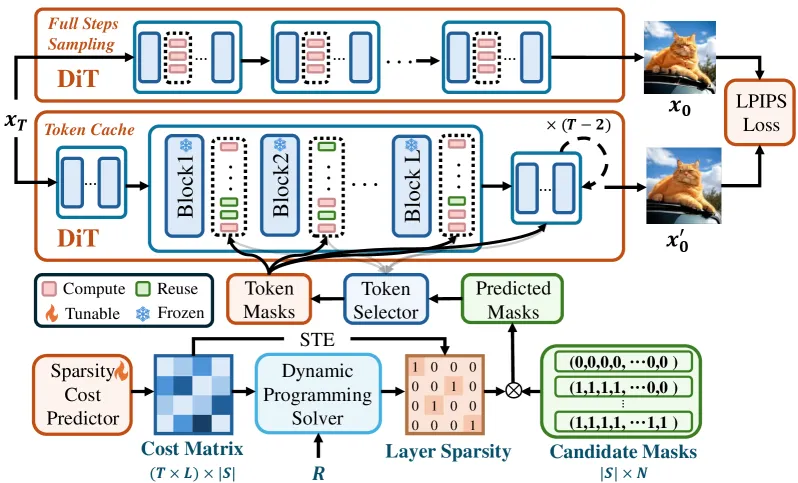
Figure 1: DiffSparse 使用可学习稀疏成本预测器和动态编程学习目标稀疏率 下的逐层稀疏。从选择的稀疏图和候选掩码生成二进制掩码。Token 选择器复用前一扩散步的特征来跳过不重要的 token,加速采样。为使梯度通过二进制掩码流动,应用直通估计器 (STE) 并使用全步采样目标和 LPIPS 损失训练模型。
核心组件
1. Token 选择器
为每个 token 分配重要性分数,决定哪些 token 重新计算、哪些保持缓存:
S(\hat{x}^i) = \mathcal{B}\left(\sum_{q=1}^{Q} \lambda_q s_q(\hat{x}^i)\right) \tag{5}
其中:
- : 不同标准的标量信号(自注意力影响、交叉注意力焦点、缓存复用频率等)
- : 权衡超参数
- : 可选的空间奖励操作(促进空间均匀覆盖)
根据分数降序排列,选择 top- token(根据稀疏率 )。
2. 可学习稀疏成本预测器
使用 个可学习参数,输出归一化成本矩阵 :
- : 去噪时间步数
- : 层数
- : 候选稀疏配置集大小
每个条目 量化在时间步 对层 应用稀疏配置 的成本。
关键特性:
- 成本预测器大小仅取决于 , , ,与 token 序列长度 无关
- 学习到的稀疏预测器可跨分辨率迁移(Table 4)
3. 动态规划求解器
定义状态函数:
F(\hat{l}, r) = \min_{\{s_i\}_{i=1}^{\hat{l}}} \sum_{i=1}^{\hat{l}} C_{i, s_i}, \quad \text{s.t.} \sum_{i=1}^{\hat{l}} s_i = r \tag{6}
递推公式:
F(\hat{l}, r) = \min_{s \in S, s \leq r} \left(F(\hat{l}-1, r-s) + C_{\hat{l}, s}\right) \tag{7}
时间复杂度:
关键: DP 求解器仅在训练时运行(~30 秒),推理时使用预计算掩码。
4. 直通估计器 (STE)
由于将预测成本矩阵 转换为离散掩码 不可微,使用 STE 近似离散掩码的梯度,实现端到端优化。
Token 缓存机制
Token 级特征缓存机制在初始时间步 计算并存储中间 token 特征到缓存 。在后续时间步,预定义缓存比例 决定每层每个时间步复用的 token 比例。
对于给定层 ,每个 token 的计算:
F(\hat{x}^i) = \gamma_i f(\hat{x}^i) + (1 - \gamma_i) C(\hat{x}^i) \tag{3}
其中 对于缓存 token, 对于重新计算的 token。
缓存更新:
C(\hat{x}^i) \leftarrow F(\hat{x}^i) \tag{4}
训练损失
使用 LPIPS 感知蒸馏损失:
\mathcal{L}_{\text{LPIPS}} = \text{LPIPS}(x_0, x_0') \tag{8}
其中 和 分别是教师和学生网络的多步采样输出。
两阶段训练策略
Stage 1:
- 预设 个全步位置
- 独立优化步成本矩阵 和层稀疏成本矩阵
- 通过 DP 找到累积成本最小的 个最优全步位置
- 对选定步骤的层稀疏成本进行 warm-start:
C_l(t, l, s) \leftarrow C_l(t, l, s) - \delta \quad \forall t \in T_f, l \in \{1, \ldots, L\}, s = N \tag{9}
Stage 2:
- 将步成本合并到层稀疏成本中
- 微调统一成本矩阵,系统性地在采样步骤间重新分配 FLOPs
- 不同于现有方法强制全步,DiffSparse 通过可微成本交互动态优化稀疏模式
候选稀疏集
| 参数 | 值 | 说明 |
|---|---|---|
| {0, 0.25, 0.50, 0.75, 1.0} | 候选稀疏率 | |
| $ | S | $ |
| 间隔 | 0.25 | 最优粒度 |
对于 ,对应保留 {0, 64, 128, 192, 256} 个 token。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 可学习逐层稀疏分配 | 端到端优化,无需手动调优 | FID 26.91 vs 手动方法 28.35 |
| 动态规划求解器 | 全局最优稀疏配置 | 时间复杂度 $O((LT)^2 \cdot |
| 两阶段训练 | 消除全步计算依赖 | FID 26.91 vs 单阶段 27.40 |
| 跨分辨率迁移 | 低分辨率训练可迁移到高分辨率 | 256→512 迁移有效 |
| STE 端到端优化 | 梯度通过离散掩码流动 | 实现可微稀疏学习 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 模型 | PixArt-α, FLUX.1-schnell, DiT-XL/2, Wan2.1-1.3B |
| 训练数据 | 10K COCO/ImageNet/WebVid captions |
| 评估 | COCO 30K, PartiPrompts 1632, ImageNet 50K, VBench |
| 硬件 | 8× AMD MI250 GPU (80GB) |
| 训练时间 | ~4-10 小时 |
文本到图像生成 (PixArt-α, 20 步)
| 方法 | MACs (T)↓ | 加速比↑ | FID-30k↓ | CLIP↑ |
|---|---|---|---|---|
| PixArt-α 原始 | 2.86 | 1.00× | 28.20 | 0.163 |
| 50% steps | 1.43 | 1.74× | 37.57 | 0.158 |
| FORA (N=2) | 1.43 | 1.64× | 29.67 | 0.164 |
| DeepCache (N=2) | 1.48 | 1.61× | 29.61 | 0.163 |
| ToCa | 1.64 | 1.75× | 28.35 | 0.164 |
| DuCa | 1.63 | 1.78× | 27.98 | 0.164 |
| TaylorSeer | 1.57 | 1.83× | 29.08 | 0.163 |
| DiffSparse (R=43%) | 1.64 | 1.74× | 26.91 | 0.164 |
| DiffSparse (R=54%) | 1.30 | 1.91× | 27.79 | 0.164 |
关键发现:
- R=43% 时 FID 26.91 超越原始模型 (28.20)
- R=54% 时 1.91× 加速,FID 仍优于原始模型
- 相比 ToCa +5.1% FID 改善
类条件生成 (DiT-XL/2, 50 DDIM 步)
| 方法 | MACs (T)↓ | 加速比↑ | FID↓ | sFID↓ | Precision↑ | Recall↑ |
|---|---|---|---|---|---|---|
| DDIM-50 步 | 11.44 | 1.00× | 2.26 | 4.29 | 0.80 | 0.60 |
| DDIM-25 步 | 5.73 | 1.96× | 3.01 | 4.60 | 0.79 | 0.58 |
| FORA | 4.13 | 2.12× | 3.88 | 6.74 | 0.79 | 0.56 |
| ToCa | 4.97 | 2.09× | 3.05 | 4.70 | 0.79 | 0.57 |
| DuCa | 4.94 | 2.10× | 3.04 | 4.70 | 0.79 | 0.57 |
| DiffSparse | 4.97 | 2.07× | 2.81 | 4.61 | 0.80 | 0.59 |
关键发现: 同等加速比下,FID 从 3.05 (ToCa) 降至 2.81,改善 8%。
文本到视频生成 (Wan2.1-1.3B, 20 步)
| 方法 | MACs (T)↓ | 加速比↑ | VBench↑ |
|---|---|---|---|
| Wan 2.1 原始 | 43.866 | 1.00× | 43.82 |
| 50% steps | 21.933 | 1.86× | 43.14 |
| DuCa (R=54%) | 20.332 | 1.69× | 43.56 |
| DuCa (R=59%) | 18.124 | 1.68× | 43.30 |
| DiffSparse | 18.124 | 2.05× | 43.83 |
关键发现: VBench 43.83 甚至超越原始模型 (43.82)。
高分辨率泛化 (PixArt-α, 512×512)
| 方法 | MACs (T)↓ | FID↓ | CLIP↑ |
|---|---|---|---|
| PixArt-α | 10.851 | 21.95 | 0.164 |
| 50% steps | 5.426 | 25.05 | 0.163 |
| ToCa | 5.993 | 23.02 | 0.165 |
| DiffSparse | 5.986 | 22.42 | 0.165 |
关键发现: 256×256 训练的稀疏预测器可直接迁移到 512×512,无需重新训练。
消融实验
Token 重要性度量
| 方法 | 基线 FID | w/ DiffSparse FID | 改善 |
|---|---|---|---|
| Norm | 29.05 | 28.89 | -0.16 |
| Similarity | 29.00 | 28.07 | -0.93 |
| Attention | 28.35 | 26.91 | -1.44 |
训练损失对比
| 损失函数 | FID↓ | CLIP↑ |
|---|---|---|
| L2 | 27.68 | 0.164 |
| SSIM | 27.46 | 0.164 |
| LPIPS | 26.91 | 0.164 |
稀疏间隔粒度
| 间隔 | | FID↓ | CLIP↑ | |------|-------|------|-------| | 0.1 | 11 | 27.96 | 0.163 | | 0.125 | 9 | 27.91 | 0.163 | | 0.25 | 5 | 26.91 | 0.164 | | 0.5 | 3 | 27.54 | 0.164 | | 1.0 | 2 | 28.22 | 0.162 |
Warm-start 强度
| FID↓ | CLIP↑ | |
|---|---|---|
| 0 | 27.40 | 0.163 |
| 5 | 27.01 | 0.164 |
| 10 | 26.91 | 0.164 |
| 20 | 26.95 | 0.164 |
两阶段训练
| 策略 | FID↓ |
|---|---|
| 单阶段 | 27.40 |
| 两阶段 | 26.91 |
与搜索方法对比
| 方法 | FID↓ | 训练时间 |
|---|---|---|
| 随机搜索 (1000 iter) | 28.34 | ~16h |
| 遗传算法 (1000 iter) | 27.94 | ~16h |
| DiffSparse | 26.91 | ~4h |
六、可视化分析
稀疏分配可视化
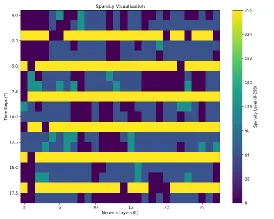
Figure 3: PixArt-α 20 步的预测逐层稀疏可视化。x 轴表示去噪时间步,y 轴表示层索引。颜色越深表示分配的稀疏率越高(更多 token 被复用)。
视觉对比
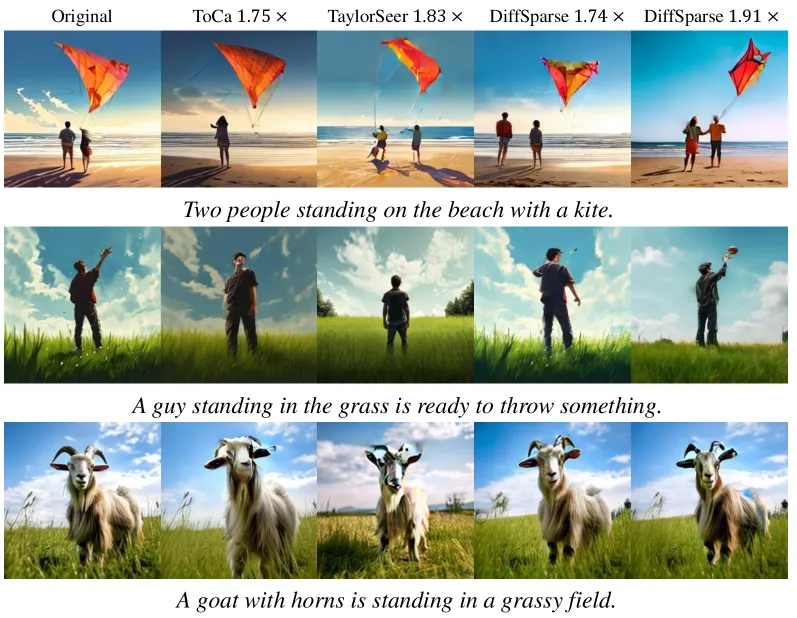
Figure 2: DiffSparse 与基线 (PixArt-α) 和现有方法的视觉对比。DiffSparse 在激进剪枝条件下仍保持高保真度,有效保留文本提示的语义内容。
七、与现有方法对比
| 方法 | 稀疏分配 | 全步依赖 | 可学习 | 跨分辨率 |
|---|---|---|---|---|
| FORA | 手动 | 是 | ✗ | ✗ |
| DeepCache | 手动 | 是 | ✗ | ✗ |
| ToCa | 手动 | 是 | ✗ | ✗ |
| DuCa | 手动 | 是 | ✗ | ✗ |
| TaylorSeer | 手动 | 是 | ✗ | ✗ |
| DiffSparse | 自动 | 否 | ✓ | ✓ |
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| FORA | 特征缓存基线,手动稀疏分配 |
| DeepCache | 层级缓存,CVPR’24 |
| ToCa | Token 缓存,ICLR’25,手动调度 |
| DuCa | Token 缓存,手动调度 |
| TaylorSeer | 预测缓存,ICCV’25 |
| TeaCache | 时间步感知缓存 |
九、总结
核心贡献
- 可学习逐层 token 稀疏: 首个端到端可微的 DiT token 稀疏优化框架
- 动态规划求解: 全局最优稀疏配置,消除手动调参
- 两阶段训练: 消除全步计算依赖,充分释放 token 缓存加速潜力
- 跨分辨率迁移: 低分辨率训练可直接应用于高分辨率
- 多任务验证: 图像生成、类条件生成、视频生成均有效
技术影响
- 自动化稀疏分配: 从手动调参到端到端学习
- 超越原始模型: 加速的同时甚至提升生成质量
- 通用框架: 适用于多种 DiT 架构(PixArt, FLUX, DiT, Wan)
- 实际部署价值: 4 小时训练即可获得 1.91× 加速
局限性
- DP 求解器训练时间随层数和时间步增加()
- 候选稀疏集 需要适度大小(过大反而降低性能)
- 仅在 DiT 架构上验证,未扩展到 UNet
- 需要 10K 标题/类别作为训练数据
十、参考资源
- 论文: arXiv:2604.03674
- 主题: cs.CV
- 页数: 约 20 页, 5 图