SoLA: Leveraging Soft Activation Sparsity and Low-Rank Decomposition for Large
利用软激活稀疏性和低秩分解的LLM压缩方法
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SoLA: Leveraging Soft Activation Sparsity and Low-Rank Decomposition for Large Language Model Compression |
| 作者 | Xinhao Huang, You-Liang Huang, Zeyi Wen |
| 机构 | The Hong Kong University of Science and Technology (Guangzhou), HKUST |
| 论文 | arXiv:2604.03258 |
| 代码 | GitHub |
| 发布 | 2026-03-12 |
| 领域 | cs.CL, cs.AI |
二、核心思想
问题定义
大语言模型(LLM)的数十亿参数给部署带来挑战。现有压缩方法存在以下问题:
| 方法类型 | 局限性 |
|---|---|
| 非结构化剪枝 | 现代LLM使用SiLU/GeLU而非ReLU,无法利用零激活稀疏性;硬件不支持 |
| 结构化剪枝 | 激进修改模型结构导致精度下降,需要微调恢复 |
| 量化 | 需要后续微调以获得更好的精度恢复 |
| 低秩分解 | 忽略输入输出数据分布和模块差异,性能下降严重 |
解决方案概述
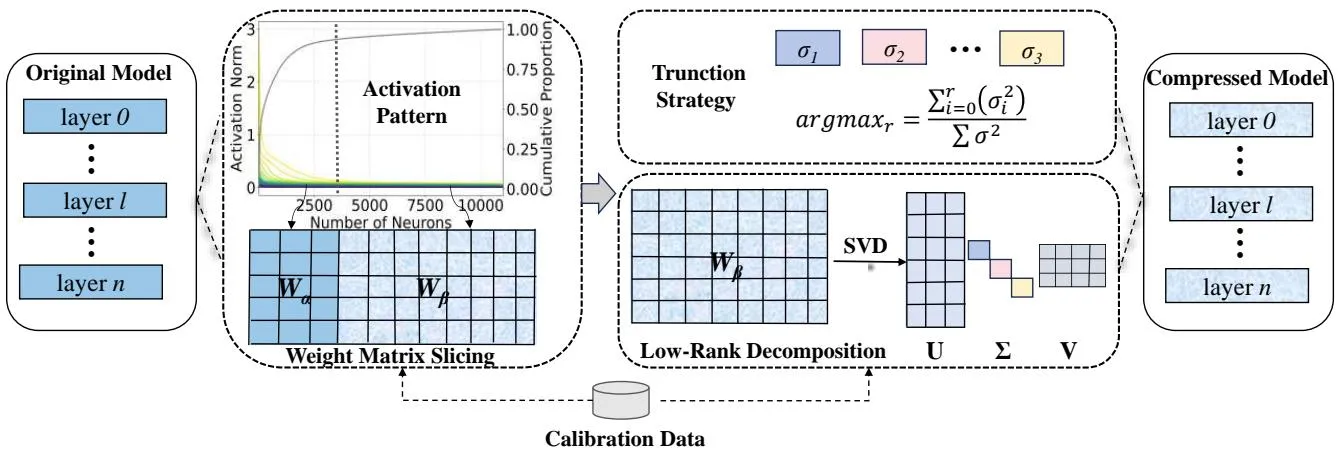
SoLA (Soft activation sparsity + Low-rAnk decomposition) 提出一种无需训练的压缩方法:
- 识别软激活稀疏性:现代LLM的FFN中存在长尾分布的激活模式
- 保留关键神经元:保留少数高激活范数的”主神经元”(Prime Neurons)
- 压缩边际神经元:对剩余的”边际神经元”应用SVD低秩分解
- 自适应秩分配:为不同权重矩阵分配最优截断位置
三、技术架构
软激活稀疏性
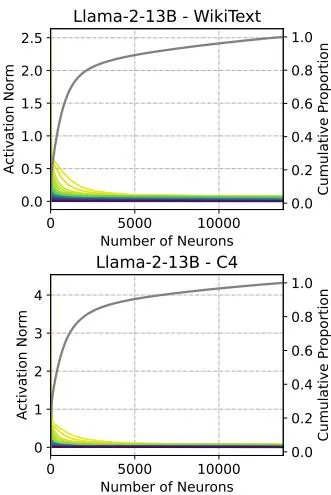
虽然现代LLM使用SiLU/GeLU而非ReLU,但仍存在软激活稀疏性:
关键发现:
- 少数神经元的激活范数占据总范数的绝大部分(如LLaMA-2-13B中15%神经元占95%)
- 移除高激活范数神经元(PN)会导致性能急剧下降
- 移除低激活范数神经元(MN)对性能影响较小
实验验证(LLaMA-2-13B):
| 操作 | 困惑度变化 |
|---|---|
| 原始模型 | 4.57 |
| 移除1% PN | 9665.4 (灾难性) |
| 移除10% PN | 4.83 (轻微) |
| 移除30% MN | 6.58 (可接受) |
| 移除50% MN | 17.03 (较大) |
核心公式
FFN计算:
h = \sigma(X W^{in}) \tag{1}
out = h W^{out} \tag{2}
FFN分解:
= \sigma(X W_{\alpha}^{in}) W_{\alpha}^{out} + \sigma(X W_{\beta}^{in}) W_{\beta}^{out} \tag{6}
其中 对应主神经元(PN), 对应边际神经元(MN)。
SVD分解:
W = U \Sigma V \tag{3}
W \approx AB \tag{4}
其中 ,
重建损失:
L = \|W - W'\|_F \tag{5}
压缩损失定理(Theorem 1):
给定输入 、权重矩阵 的SVD分解 ,以及 的Cholesky分解 :
自适应秩分配
性能评分函数:
f(r) = \frac{\sum_{i=0}^{r} \sigma_i^2}{\sum \sigma^2} \tag{8}
优化问题:
\text{s.t. } \sum g(r_c) \leq \mathcal{B} \tag{9}
其中 是组件 的截断位置, 是内存占用, 是内存预算。
压缩流程
- 校准数据收集:256个样本,序列长度4096
- 神经元排序分组:按激活范数降序排列,分为PN和MN
- 权重矩阵分区:保留PN权重不压缩,仅对MN应用SVD
- 自适应秩分配:贪心搜索算法,秩设为16的倍数(NVIDIA硬件加速)
关键设置:
- 默认 (PN比例15%)
- V投影不参与压缩(性能下降显著)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 软激活稀疏性 | 发现现代LLM中SiLU/GeLU的长尾激活分布 | 15%神经元占95%激活范数 |
| 细粒度分解 | 区分PN和MN,仅压缩MN | 移除1% PN导致灾难性下降 |
| 自适应秩分配 | 为不同权重矩阵分配最优截断位置 | 8%-18%困惑度降低 |
| 无需训练 | 仅需校准数据,无需微调 | 256样本即可 |
五、实验结果
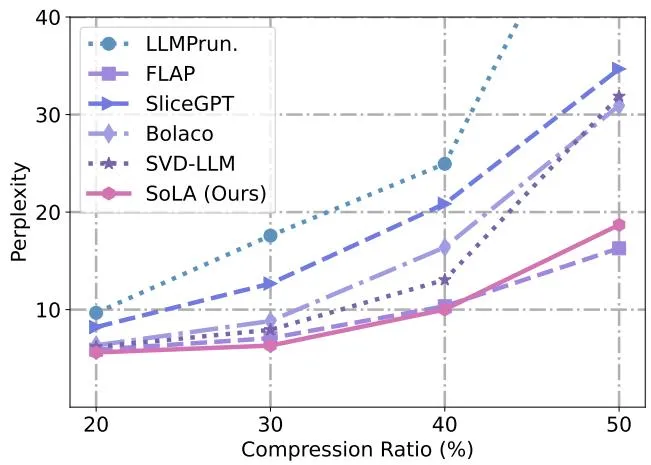
困惑度对比
| 方法 | 压缩率 | LLaMA-2-7B | LLaMA-2-13B | LLaMA-2-70B | Mistral-7B |
|---|---|---|---|---|---|
| Dense | 0% | 5.11 | 4.57 | 3.12 | 4.92 |
| SoLA | 20% | 6.52 | 5.61 | 4.06 | 6.06 |
| SVD-LLM | 20% | 8.07 | 6.18 | 5.96 | 7.26 |
| SoLA | 30% | 7.81 | 6.31 | 4.44 | 7.38 |
| SVD-LLM | 30% | 11.40 | 7.93 | 6.95 | 12.32 |
关键结果:LLaMA-2-70B 30%压缩率下,困惑度从6.95(SVD-LLM)降至4.44。
下游任务精度
LLaMA-2-70B 30%压缩率:
- SoLA平均精度:0.6625
- SVD-LLM平均精度:0.6091
- 提升:~10%
评测基准:MMLU (5-shot), BoolQ, PIQA, WinoGrande, HellaSwag, ARC-easy, ARC-challenge, OpenBookQA
主神经元影响
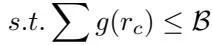
| PN比例 | 20%压缩困惑度 | 30%压缩困惑度 |
|---|---|---|
| 0% | ~6.5 | ~8.0 |
| 5% | ~5.8 | ~7.0 |
| 15% (默认) | ~5.6 | ~6.3 |
| 30% | ~5.5 | ~6.2 |
| 50% | ~5.5 | ~6.2 |
自适应 vs 均匀秩分配

| 模型 | 压缩率 | 均匀困惑度 | 自适应困惑度 | 均匀精度 | 自适应精度 |
|---|---|---|---|---|---|
| LLaMA-2-7B | 20% | 8.07 | 7.18 | 0.467 | 0.541 |
| LLaMA-2-13B | 30% | 7.93 | 7.02 | 0.485 | 0.541 |
| Mistral-7B | 30% | 12.32 | 10.09 | 0.432 | 0.491 |
提升:8%-18%困惑度降低,最高14%精度提升
推理效率
| 模型 | 压缩率 | 推理时间 (ms) | 加速比 |
|---|---|---|---|
| LLaMA-2-7B | 0% | 20.04 | - |
| LLaMA-2-7B | 20% | 16.39 | 1.22× |
| LLaMA-2-7B | 30% | 13.04 | 1.54× |
| LLaMA-2-13B | 20% | 21.92 | 1.44× |
| LLaMA-2-13B | 30% | 17.87 | 1.77× |
| LLaMA-2-70B | 20% | 65.76 | 1.47× |
| LLaMA-2-70B | 30% | 57.04 | 1.69× |
硬件:RTX4090,序列长度2048
组件级耗时分析(LLaMA-2-13B)
| 组件 | 原始 (ms) | 20% (ms) | 30% (ms) |
|---|---|---|---|
| Gate | 7.14 | 5.61 | 5.19 |
| Up | 7.12 | 5.08 | 4.53 |
| Down | 8.11 | 5.44 | 4.77 |
| Q | 3.07 | 1.34 | 0.93 |
| K | 3.09 | 1.34 | 0.68 |
| O | 3.12 | 3.12 | 1.77 |
| 总计 | 31.64 | 21.92 | 17.87 |
六、相关工作
| 方法 | 类型 | 特点 | 与SoLA的区别 |
|---|---|---|---|
| SparseGPT | 非结构化剪枝 | 稀疏回归 | 需要硬件支持 |
| Wanda | 非结构化剪枝 | 权重和激活重要性 | 硬件不支持 |
| LLM-Pruner | 结构化剪枝 | 一阶Taylor展开 | 需要微调 |
| FLAP | 结构化剪枝 | 波动剪枝指标 | 需要偏置恢复 |
| GPTQ | 量化 | 逆Hessian信息 | 需要微调 |
| ASVD | 低秩分解 | 对角矩阵缩放 | 忽略模块差异 |
| SVD-LLM | 低秩分解 | 奇异值与损失关系 | SoLA改进 |
| Bolaco | 低秩分解 | 贝叶斯优化 | 需要精确特征估计 |
七、总结
核心贡献
- 软激活稀疏性发现:首次分析并利用现代LLM中SiLU/GeLU的激活模式
- 细粒度分解方法:区分主神经元和边际神经元,仅压缩后者
- 自适应秩分配策略:为不同权重矩阵分配最优截断位置
- 无需训练压缩:仅需256个校准样本,无需微调
技术影响
- 部署友好:无需特殊硬件支持或昂贵的后训练
- 质量保持:20-30%压缩率下保持模型质量
- 通用性:适用于LLaMA-2和Mistral系列
- 高效推理:1.22×-1.77×推理加速
局限性
- 压缩率限制:超过40%压缩率性能下降明显
- V投影敏感:V投影层不能参与压缩
- 校准依赖:需要代表性校准数据
- 硬件适配:秩需设为16的倍数以利用NVIDIA加速
八、参考资源
- 论文:arXiv:2604.03258
- 代码:GitHub