DVM: A Bytecode Virtual Machine Approach for Dynamic Tensor Computation
DVM:基于字节码虚拟机的动态张量计算方法
DVM: A Bytecode Virtual Machine Approach for Dynamic Tensor Computation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DVM: A Bytecode Virtual Machine Approach for Dynamic Tensor Computation |
| 作者 | Jingzhi Fang, Xiong Gao, Renwei Zhang, Zichun Ye, Lei Chen, Jie Zhao, Chengnuo Huang, Hui Xu, Xuefeng Jin |
| 机构 | 华为 |
| 论文 | https://arxiv.org/abs/2603.24239 |
| 发布 | 2026-03-25 (v1), 2026-04-02 (v2) |
| 页数 | 13页,16图,6表 |
| 类别 | cs.PL (编程语言), cs.AI, cs.LG |
核心亮点
- 实时编译器:基于字节码虚拟机的运行时算子编译器
- 5个数量级编译加速:最大编译时间比TorchInductor快10^5倍
- 最高11.77x加速:算子/模型效率比基线提升最高11.77倍
- 动态图融合:支持动态计算图的运行时算子融合
二、核心思想
问题定义
AI计算中的动态性很常见,例如动态张量形状和动态控制流。现有方案面临以下挑战:
- 运行时编译:由于编译时间长,损害模型效率
- 离线编译器:要么需要长时间编译和大量设备内存来覆盖所有可能的执行实例,要么为了可用性牺牲优化机会
核心问题:如何让运行时编译对动态模型可行?
关键洞察:运行时编译可行的关键是加速编译或隐藏编译开销。
解决方案概述
本文提出DVM(Dynamic Virtual Machine),一个实时编译器,包含:
- 算子编译器:基于字节码虚拟机,为每个动态算子实例进行高效编译
- 算子融合器:在静态图上执行基于符号推导的融合,在动态图上执行运行时融合
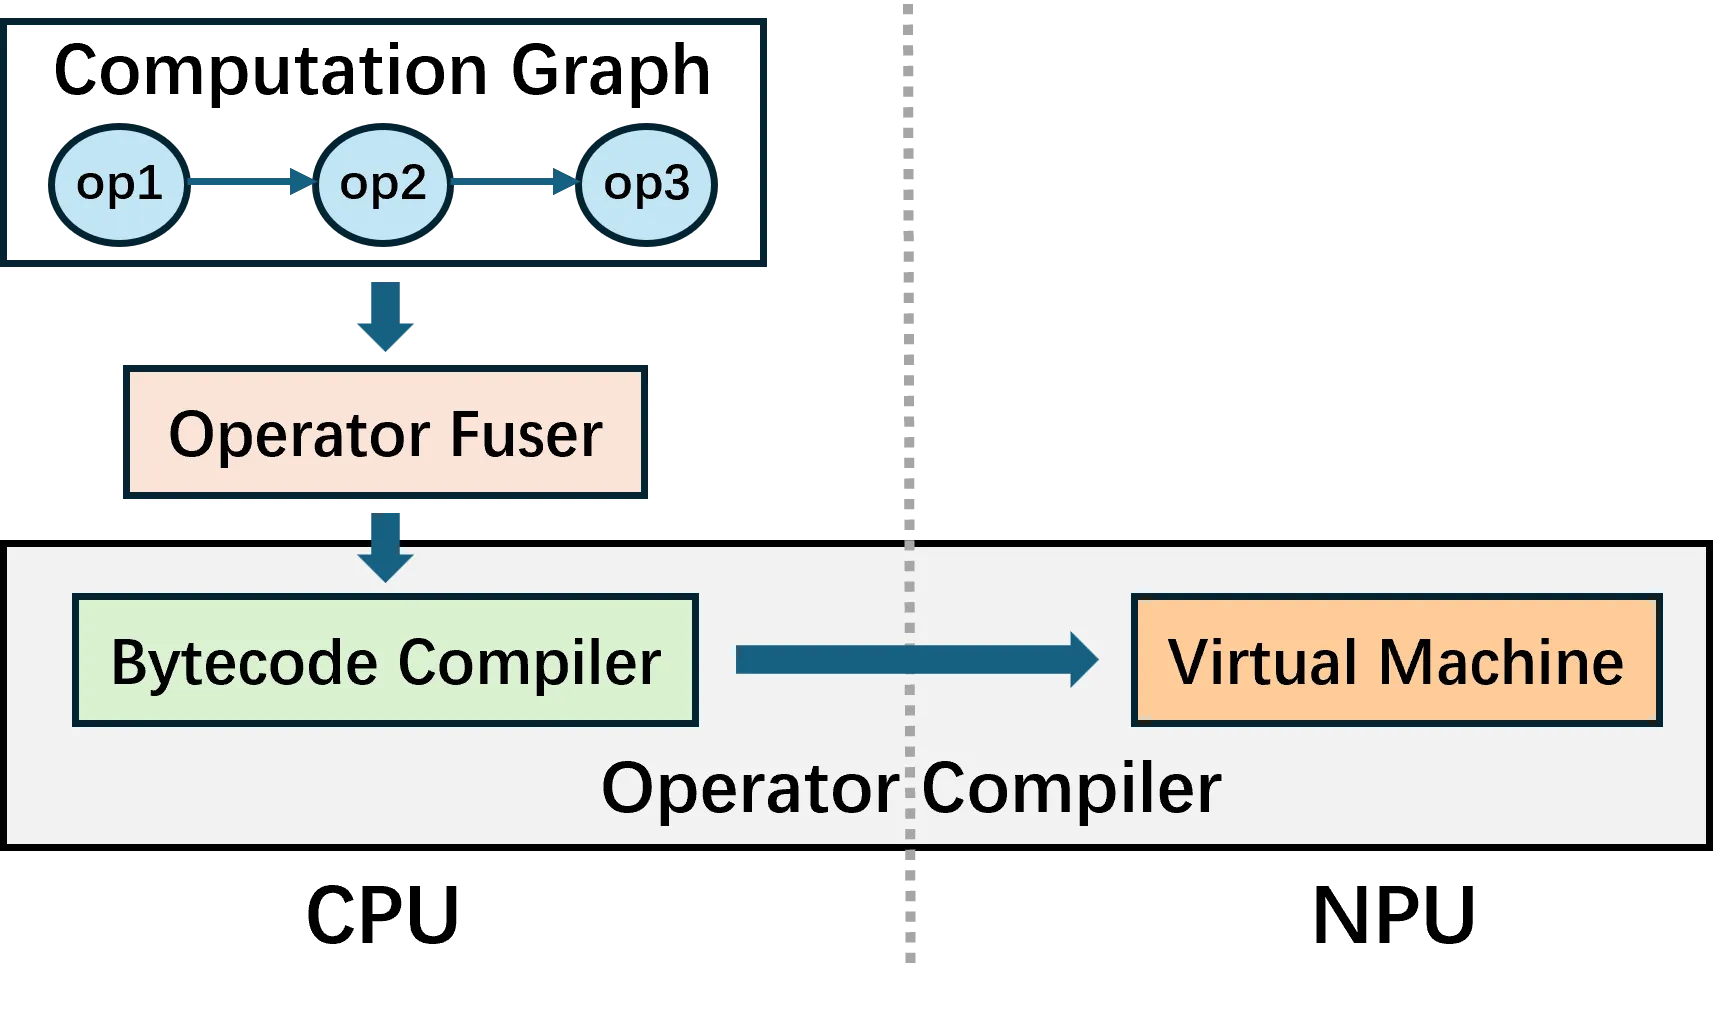
Figure 1: DVM概述。
核心创新:不是将程序编译为机器码,而是在CPU上将算子程序编码为字节码,然后在NPU上解码为虚拟指令直接执行。
三、技术架构
3.1 硬件架构抽象
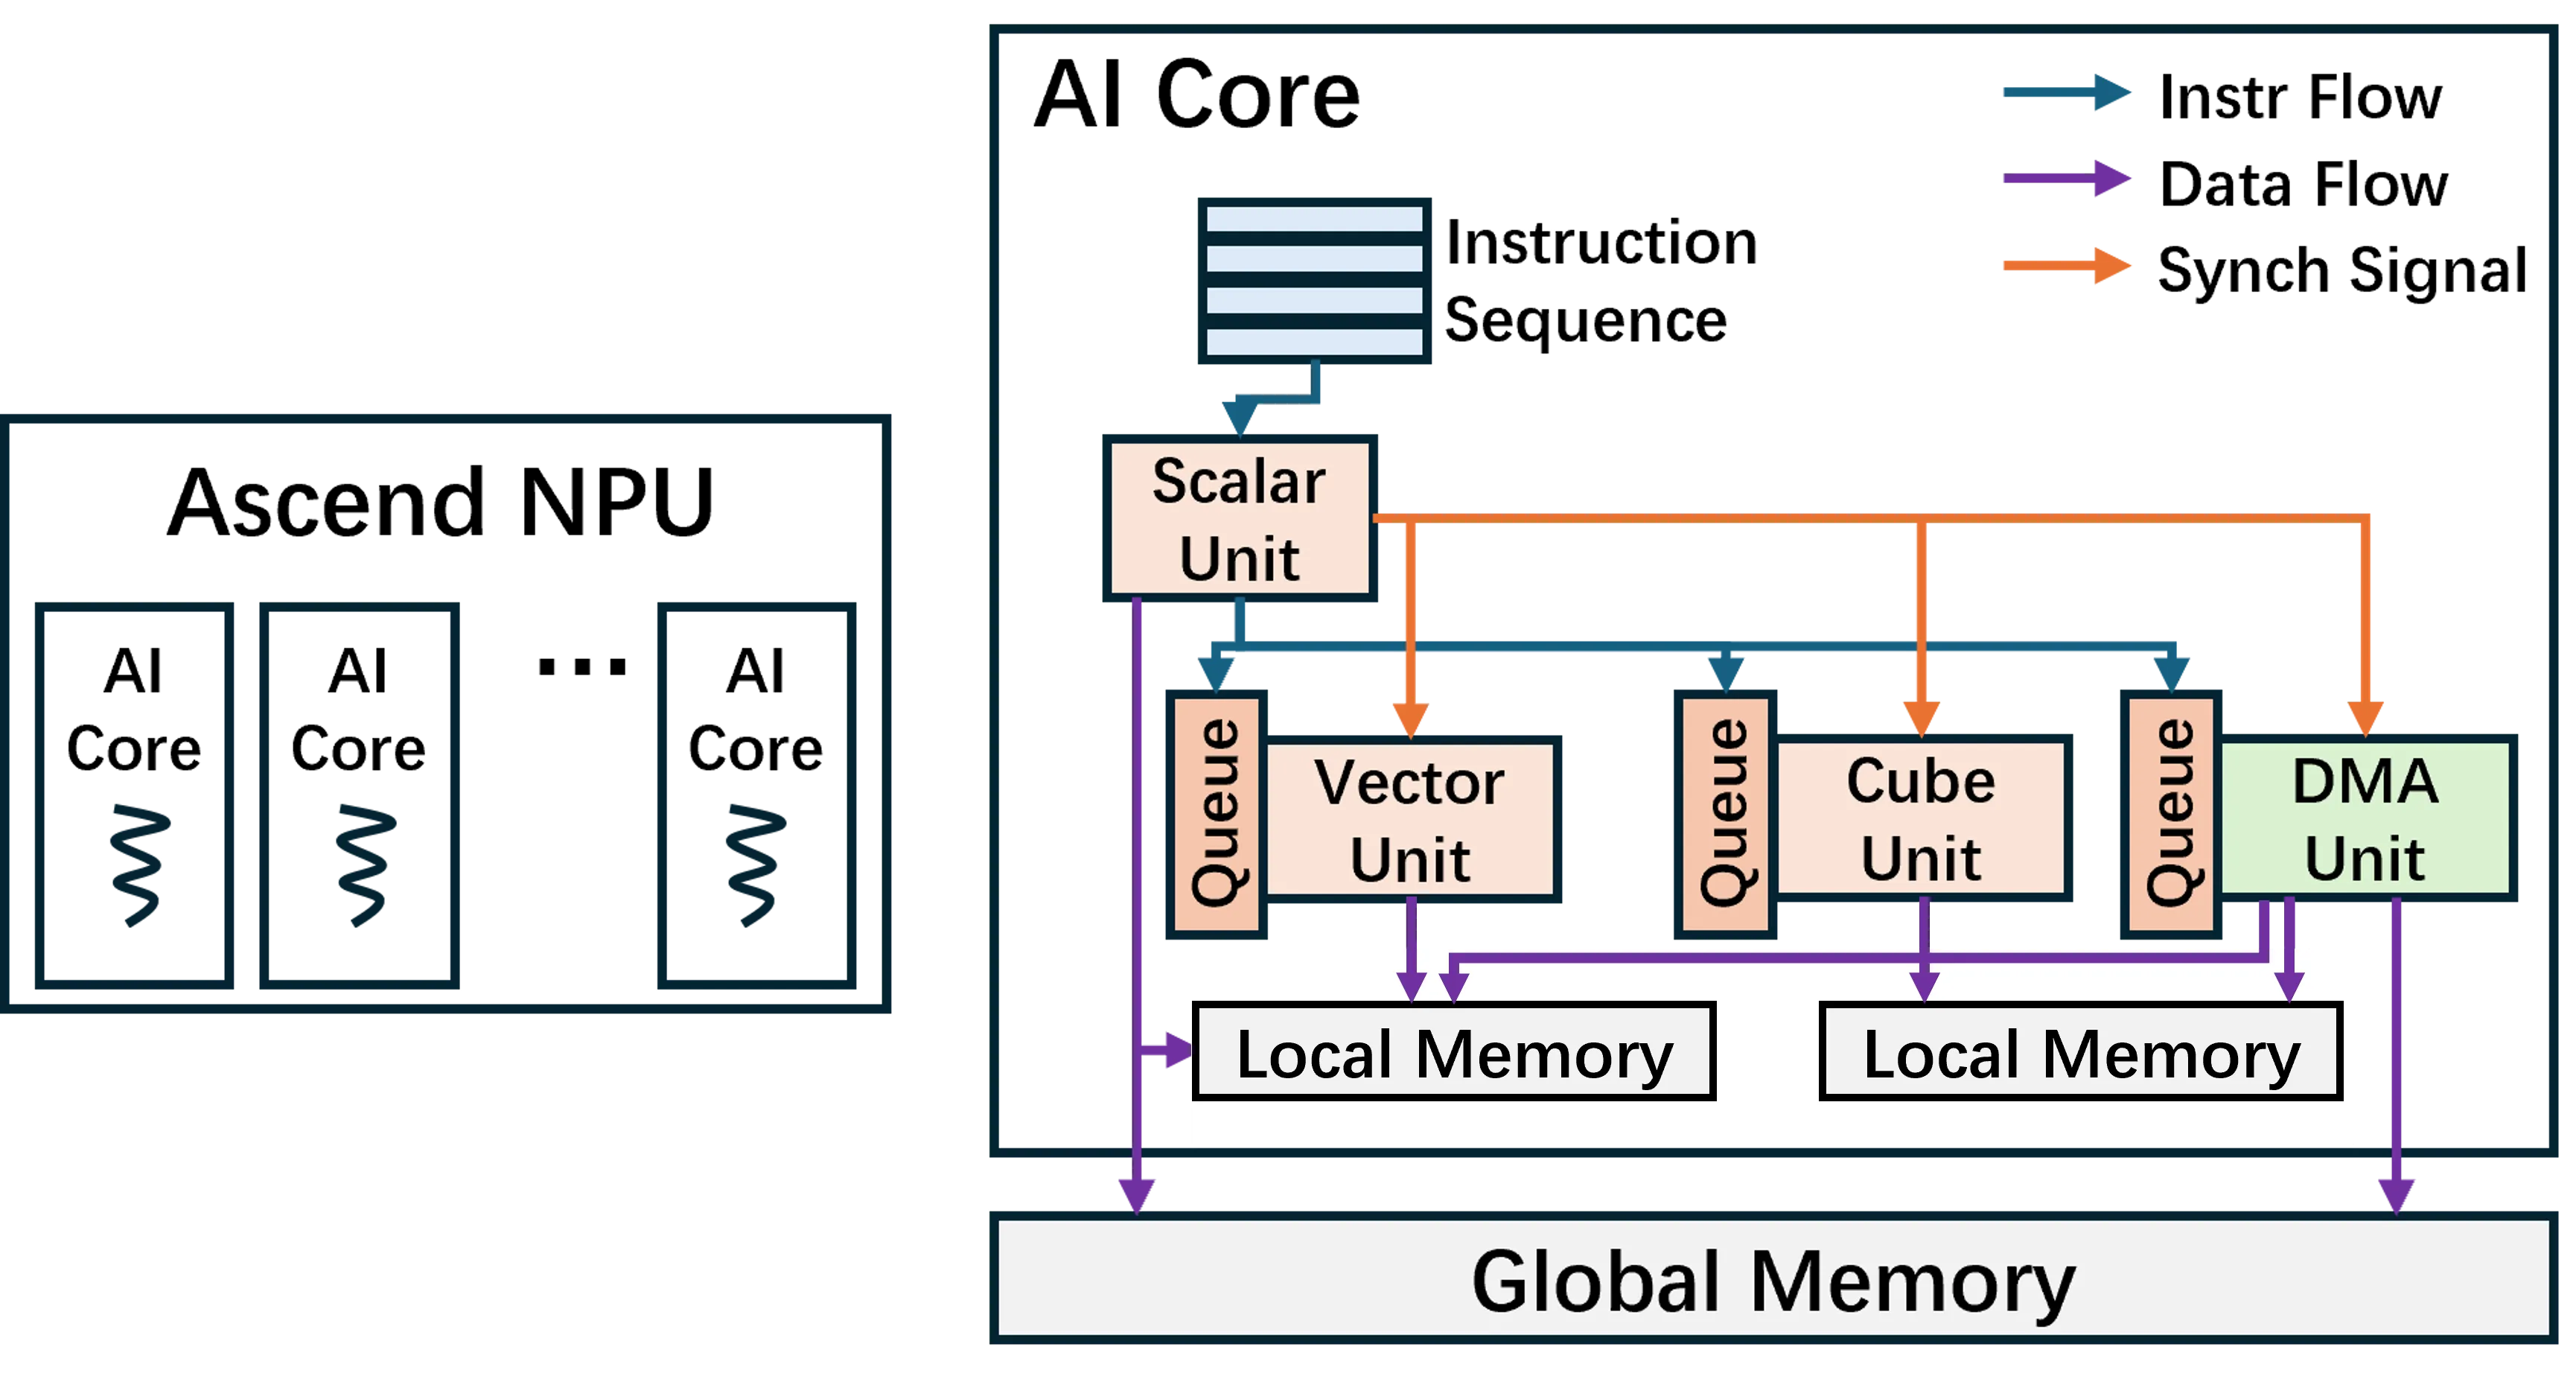
Figure 2: 硬件架构抽象(示例AI Core抽象基于A2/A3 Ascend NPU)。
Ascend NPU的AI Core包含:
- Vector单元:执行向量运算
- Cube单元:执行矩阵运算(矩阵乘法等)
- DMA引擎:处理数据搬运
- 本地内存(Local Memory/UB):高速片上存储
- 全局内存(Global Memory/HBM):大容量高带宽内存
3.2 计算流
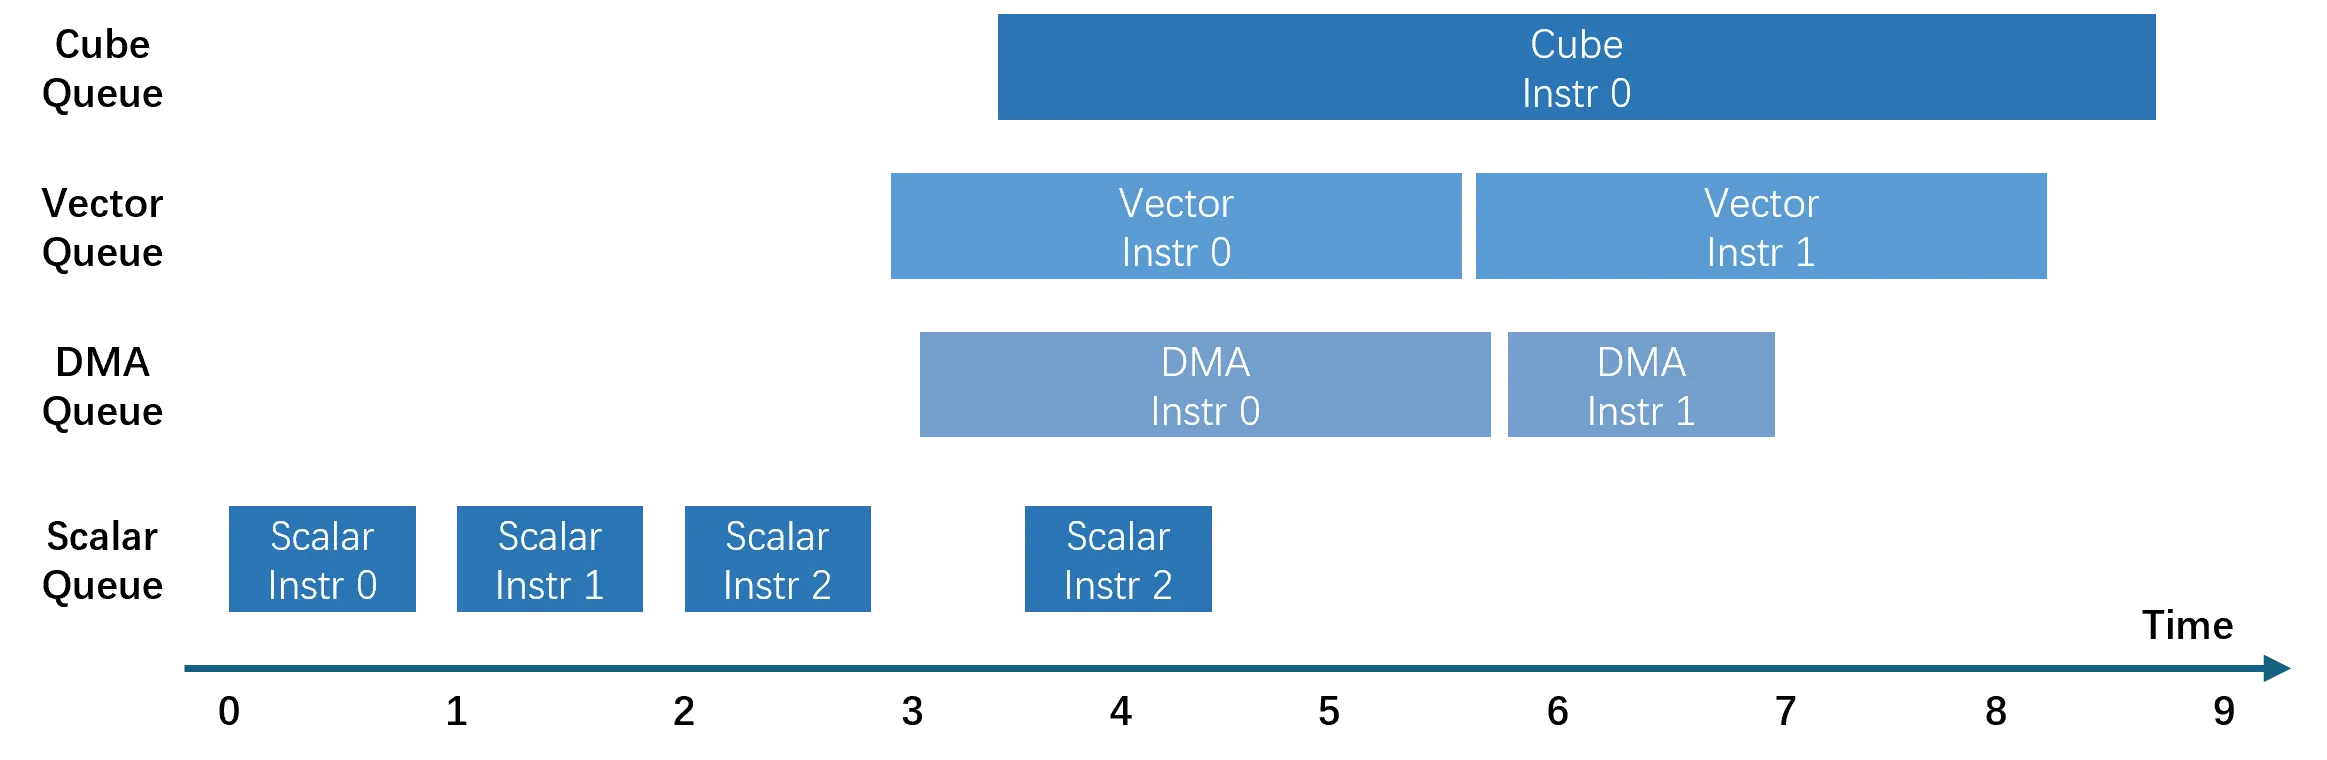
Figure 3: AI Core中的异步计算流。
AI Core中的异步计算流包括:
- Vector流:向量运算
- Cube流:矩阵运算
- DMA流:数据搬运
这些流可以异步执行,通过同步操作协调。
3.3 传统编译 vs 虚拟机
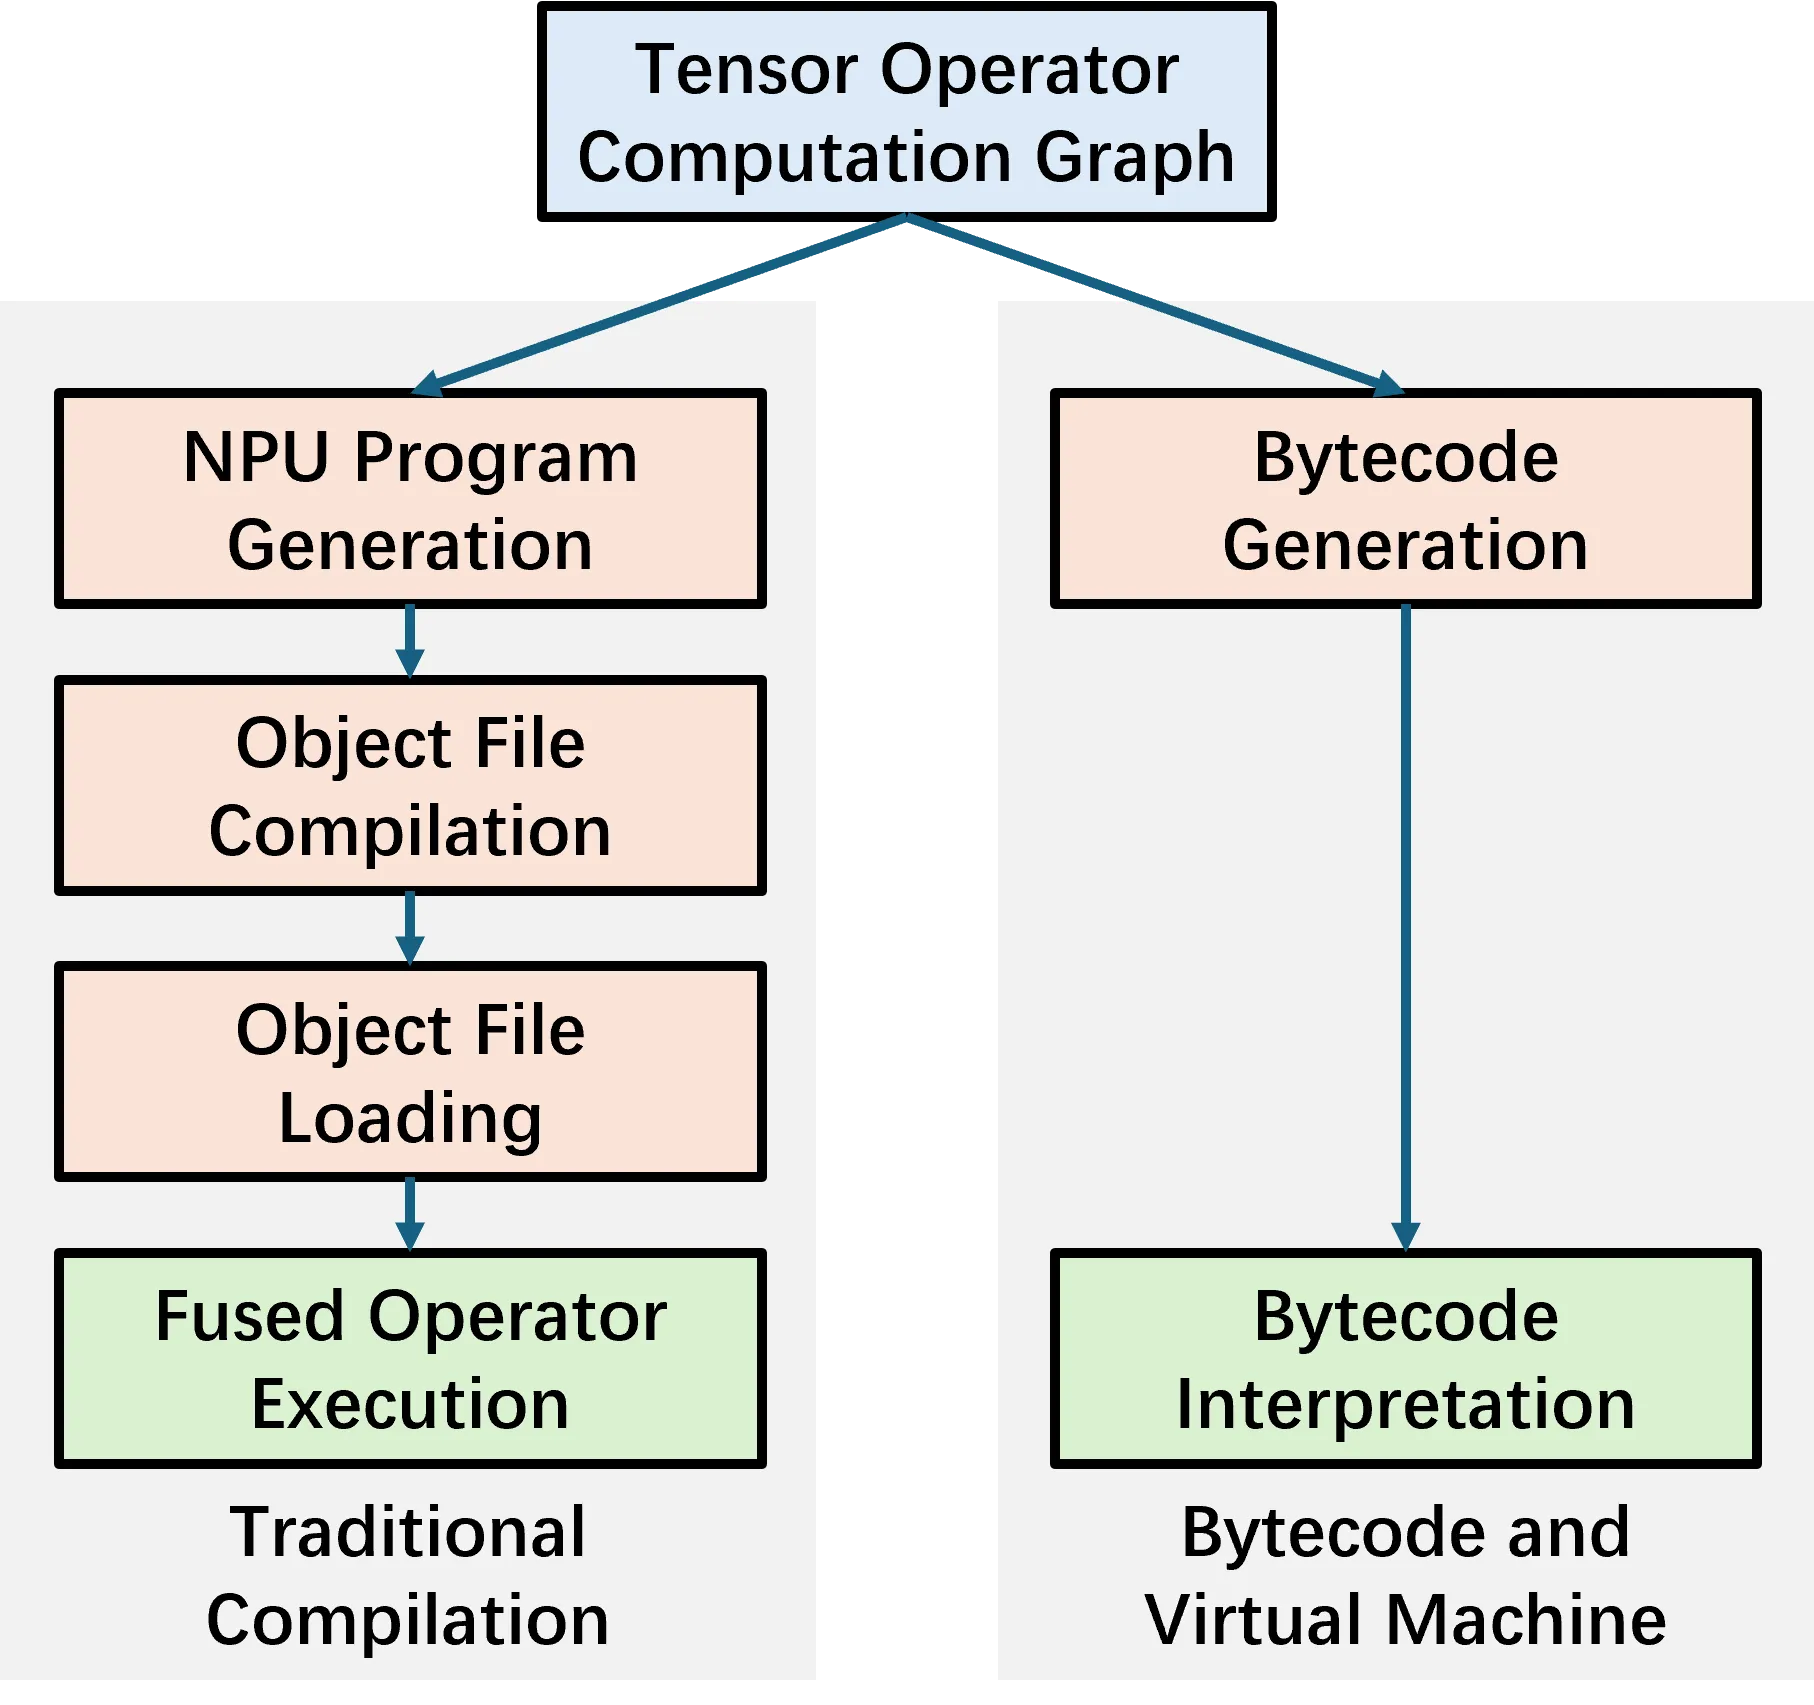
Figure 4: 传统编译 vs 虚拟机。
| 方面 | 传统编译 | DVM虚拟机 |
|---|---|---|
| 编译目标 | 机器码 | 字节码 |
| 编译位置 | CPU上 | CPU上 |
| 执行位置 | NPU | NPU(解码为虚拟指令) |
| 编译速度 | 慢(需要生成机器码) | 快(生成字节码) |
| 优化程度 | 高(机器码优化) | 中等(tile级优化) |
3.4 算子编译器工作流
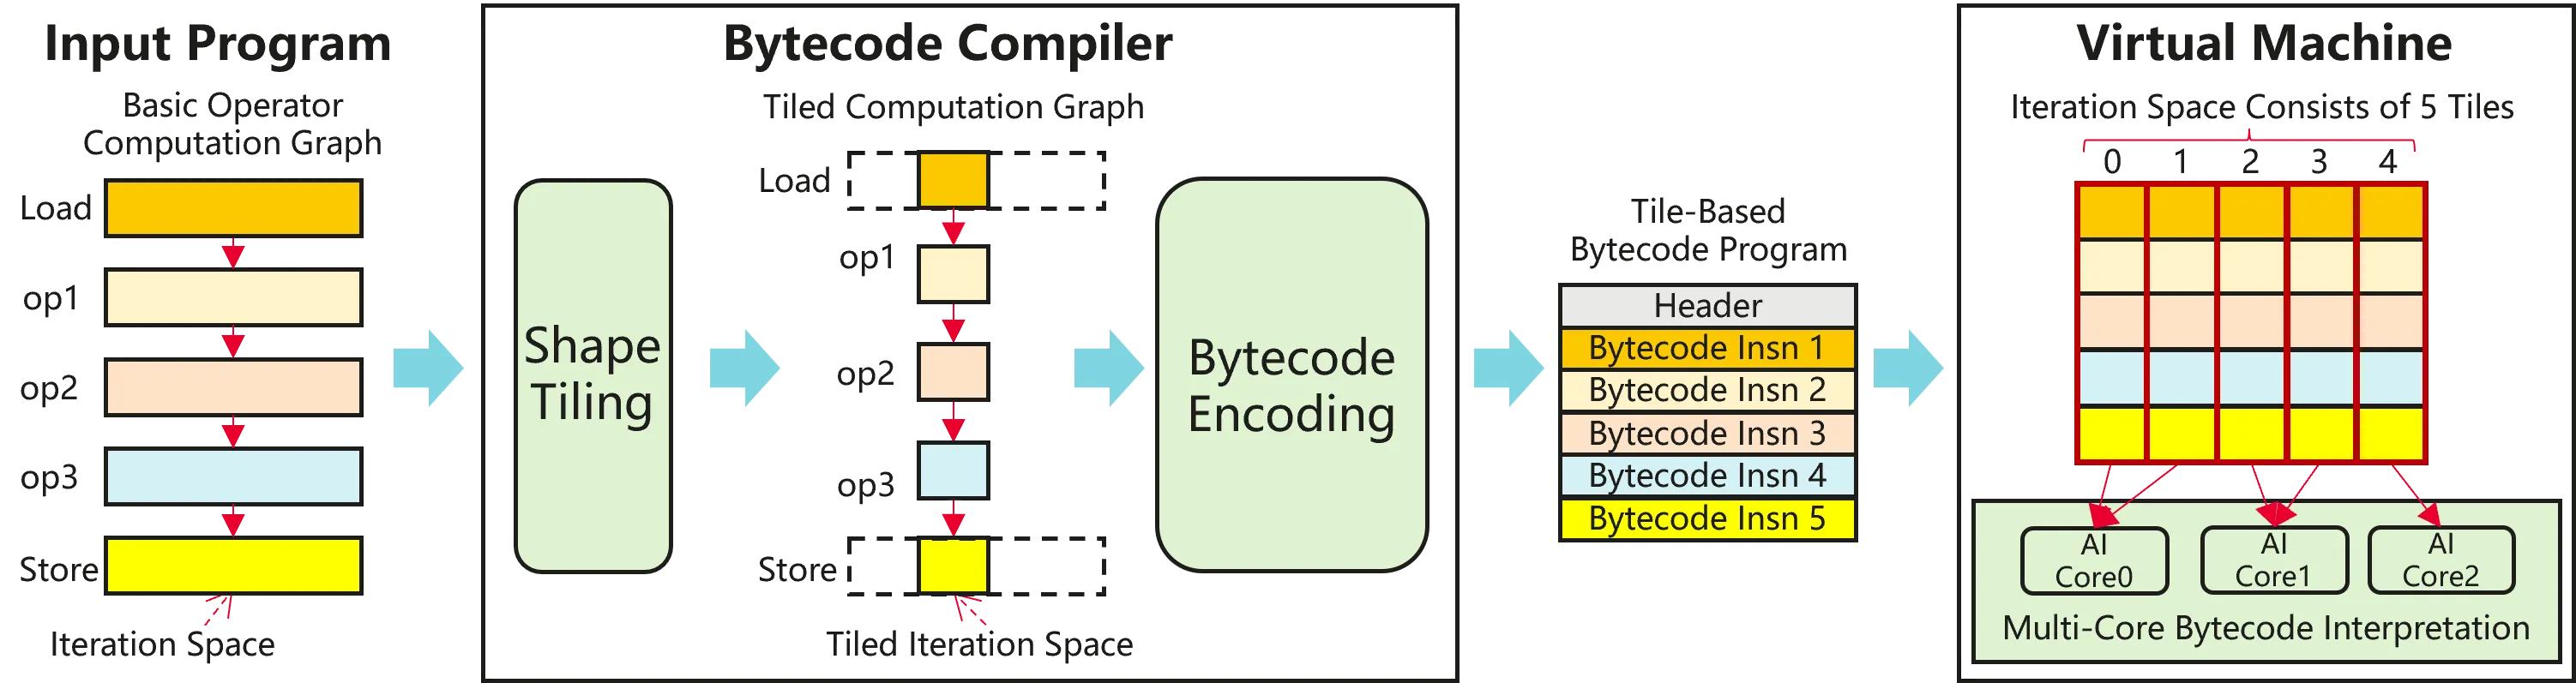
Figure 5: 算子编译器的工作流。
算子编译器的三个关键步骤:
- Shape Tiling:将迭代空间分区为多个tile,对齐硬件架构
- Bytecode Encoding:将tile计算编码为字节码程序
- Virtual Machine Interpretation:在NPU上解释执行字节码
四、核心设计
4.1 虚拟指令
Table 1: Tile级虚拟指令
| 类别 | 指令 | 语义 |
|---|---|---|
| 内存 | Load(dst, src, tile_stride, tile_size) | 从全局内存加载连续tile到本地内存 |
| ViewLoad(dst, src, tile_stride[], tile_size[], tile_dims) | 加载非连续tile | |
| Store(dst, src, tile_stride, tile_size) | 存储tile到全局内存 | |
| ViewStore(dst, src, tile_stride[], tile_size[], tile_dims) | 存储非连续tile | |
| 计算 | Copy(xd, xn, size) | 复制数据 |
| Broadcast(xd, xn, M, size, N) | 广播 | |
| Sqrt(xd, xn, size) | 逐元素开方 | |
| Abs/Log/Exp/Pow/Round/Floor/IsFinite | 其他逐元素运算 |
关键设计:tile级虚拟指令而非传统标量指令,减少编码/解释复杂度。
4.2 字节码编译
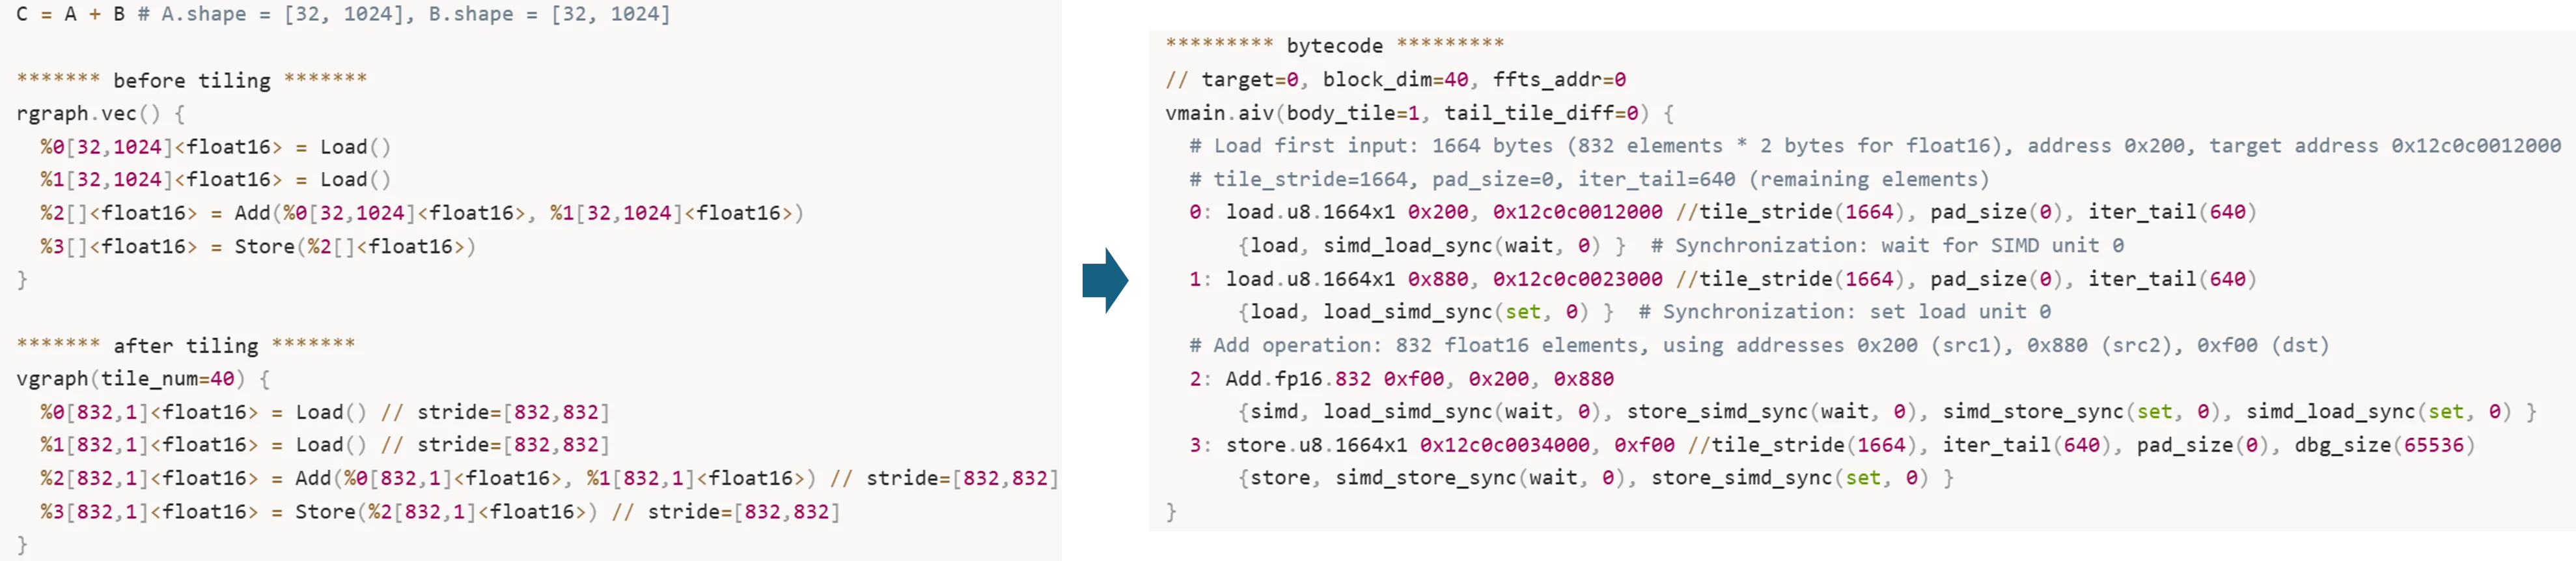
Figure 6: 字节码生成的示例过程。
Shape Tiling算法:
- 识别计算图的主导形状 (最大维度数和最大维度大小)
- 从最大tile大小 (即 的大小)开始
- 从外到内尝试减小tile大小
- 使用硬件资源约束和轻量级成本模型剪枝tiling方案
硬件对齐: 找到最小成本的tile大小,并向上舍入到硬件指令宽度的倍数。
4.3 字节码格式
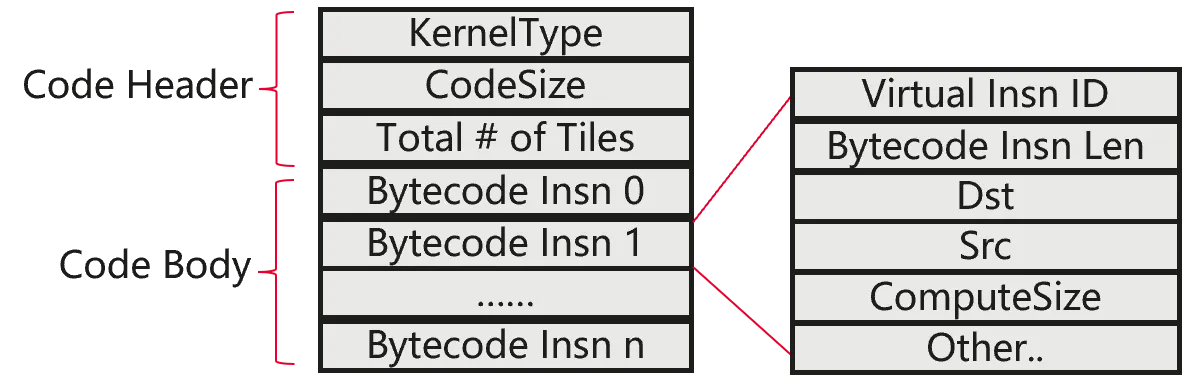
Figure 7: 字节码程序格式。
字节码程序由两部分组成:
- Code Header:包含tile数量(block_dim)、每个AI Core的tile数(body_tile)、内核类型
- Code Body:每个操作的字节码,以及自动插入的同步操作
4.4 虚拟机执行
虚拟机算法:
- 计算每个AI Core分配的tile数量
- 确定当前AI Core的tile范围
- 对于每个tile,执行字节码:解码 → 调用对应的虚拟指令函数
- 字节码解码由Scalar单元完成,虚拟指令由对应单元执行
隐藏编译开销:
- 字节码解码和指令执行可以流水线化
- 解码(标量计算)比向量/矩阵/DMA指令快得多
五、算子融合
5.1 融合类别
Pattern-based融合:基于特定模式合并多个算子的迭代
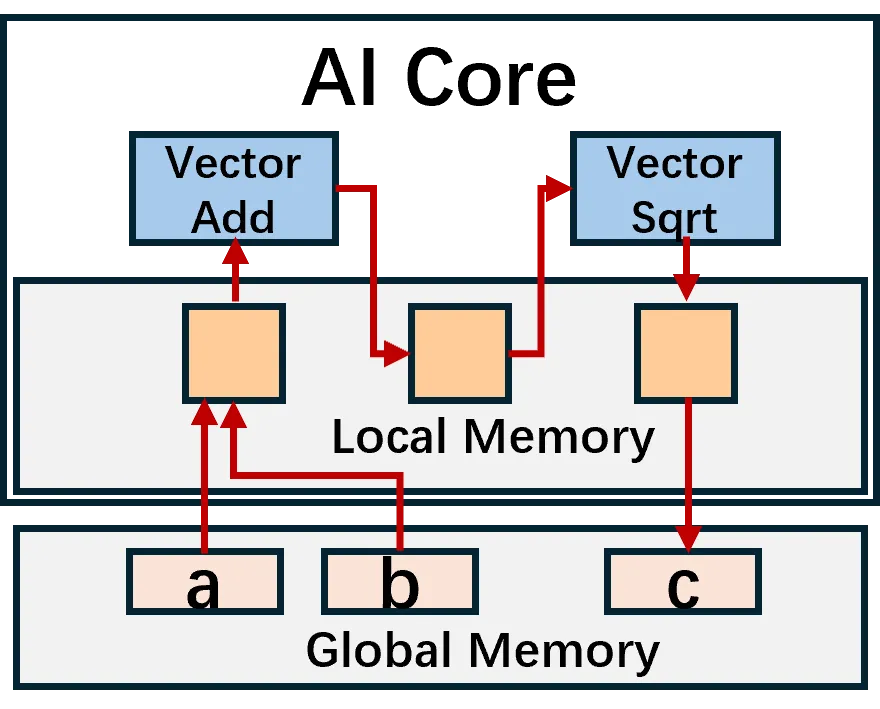
Figure 8: 通过本地内存融合两个向量操作。
两种典型融合模式:
- 向量-向量融合:将 和 融合,中间结果保存在本地内存
- Cube-向量融合:将矩阵运算与后续向量运算融合
Stacking-based融合:将不同meta-kernel在时间和空间上堆叠
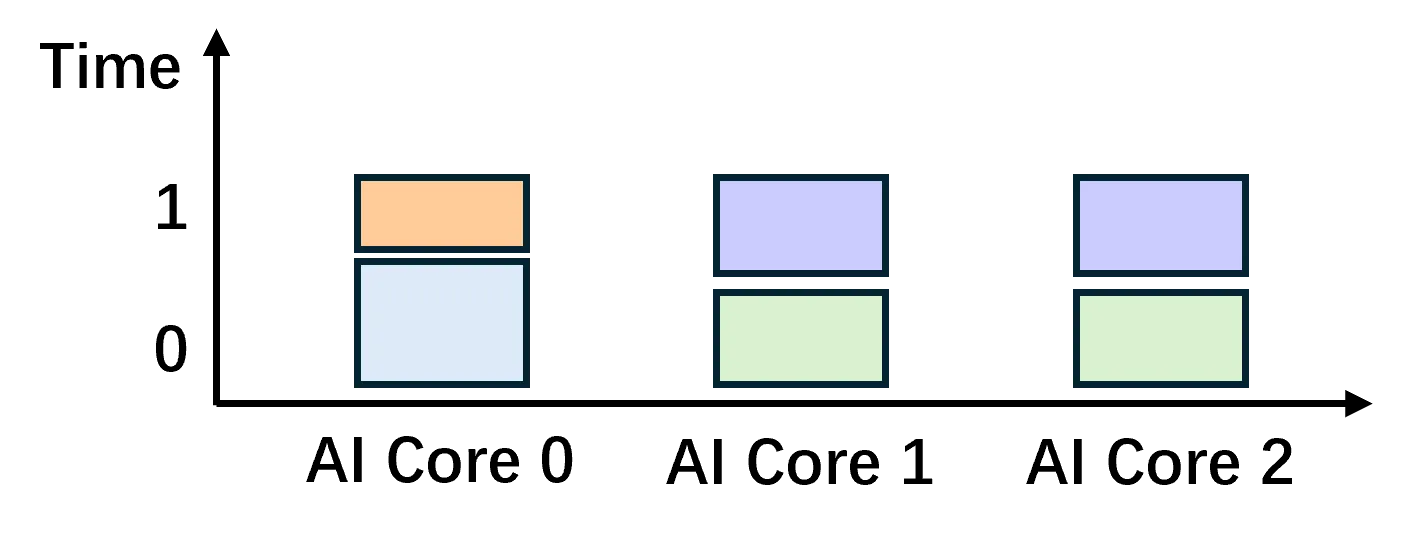
Figure 9: 空间和时间堆叠内核。
- 空间堆叠:将独立算子的tile计算调度到不同AI Core,提高计算资源利用率
- 时间堆叠:将不同算子tile调度到同一AI Core顺序执行,减少运行时调度开销
5.2 静态/动态图融合
静态图融合:基于符号推导检查融合条件(如两个算子的迭代是否可合并),无需具体形状信息。
动态图融合:流式融合,运行时将可确定的算子添加到buffer,立即做融合决策。
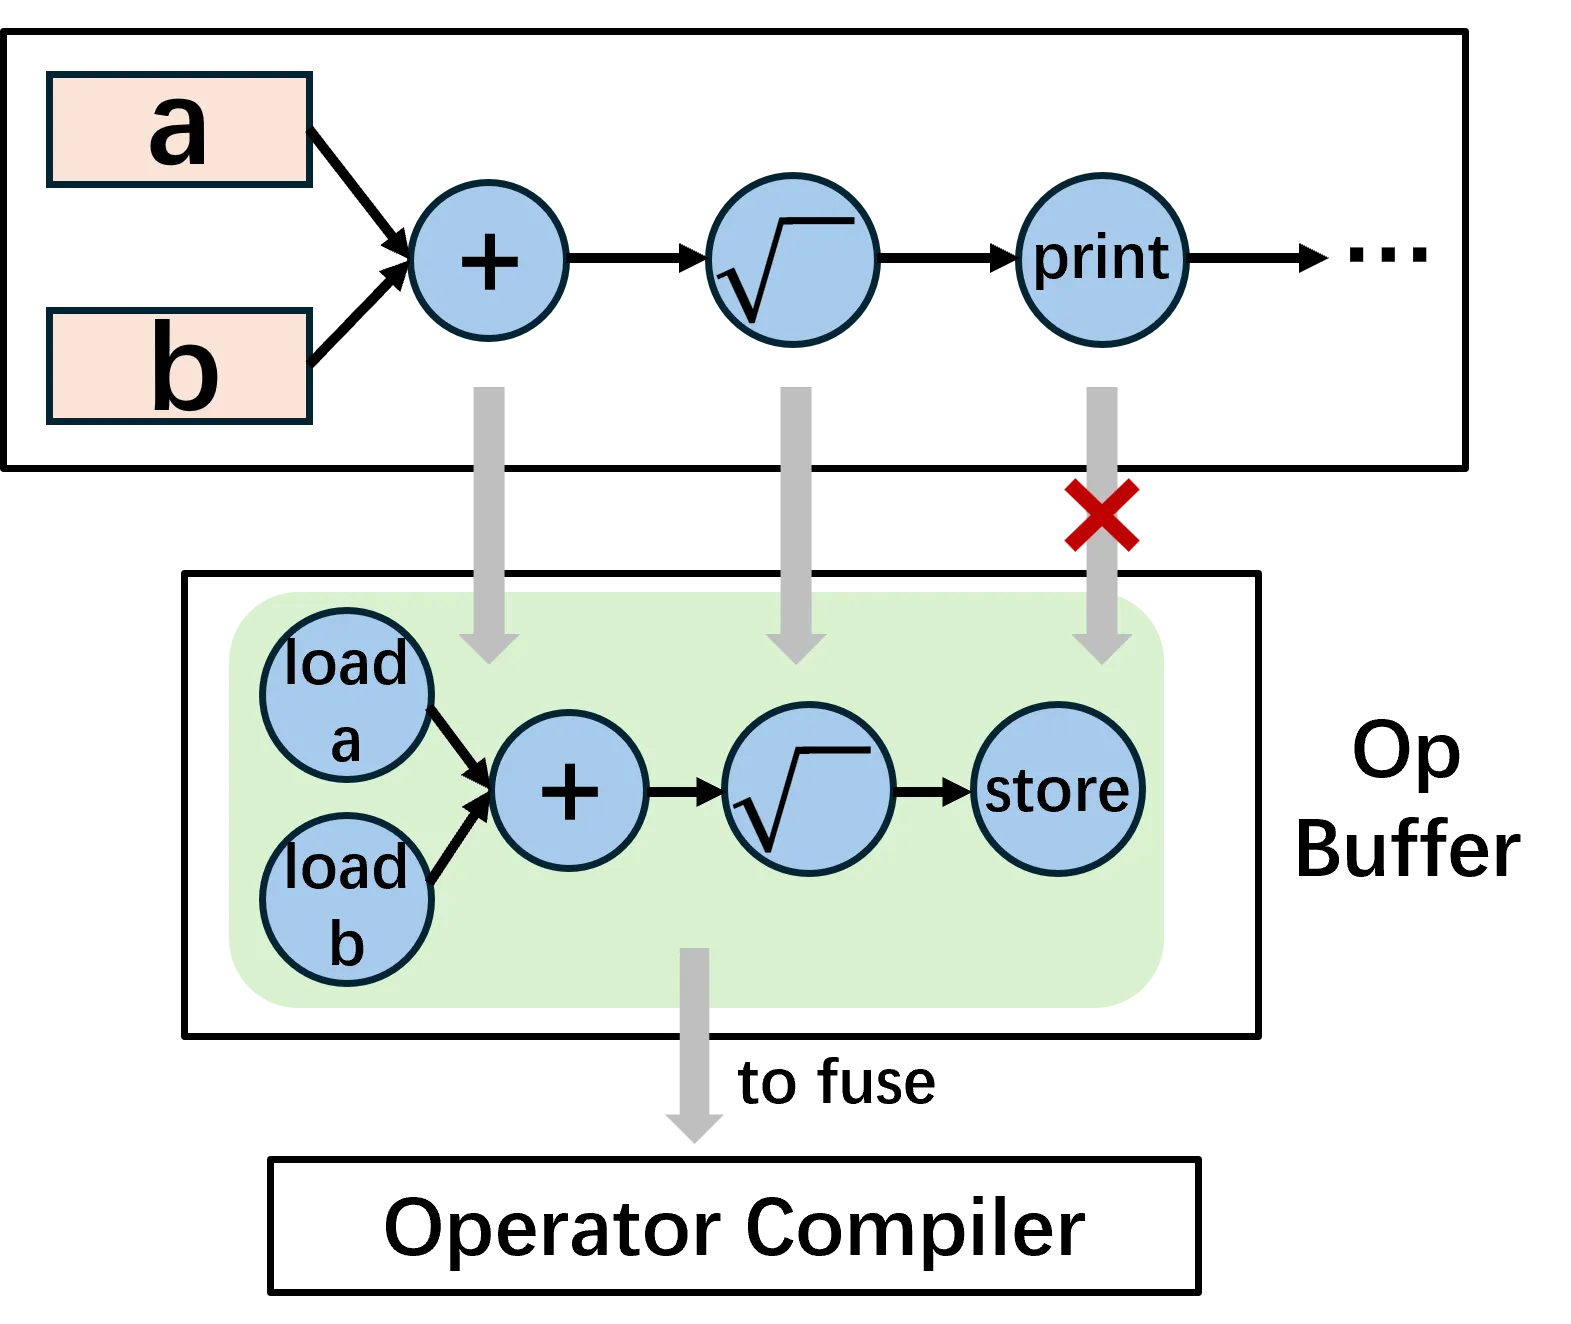
Figure 10: 动态图上算子融合的示例。
动态融合流程:
- 算子按顺序添加到buffer
- 检查融合条件(形状兼容性、依赖关系)
- 满足条件时融合算子
- 新算子无法融合或通信条件满足时,flush融合的算子到编译器
关键优势:融合决策不需要缓存,减少内存压力。
六、实验结果
6.1 测试环境
| 配置 | 详情 |
|---|---|
| CPU | 4× 64核Kunpeng-920 (256逻辑处理器) |
| NPU | 8× Ascend 910B2 |
| 内存 | 2TB RAM |
| OS | openEuler 22.03 (LTS-SP4) |
基线:
- PT-eager:PyTorch eager模式,基于AOL内核,无自动融合
- Inductor-r:TorchInductor重编译模式,每个新形状触发重编译
- Inductor-d:TorchInductor动态模式,仅编译一次,形状假设不满足时触发JIT
- MS-O0:MindSpore graph O0模式,无自动融合
6.2 算子级性能
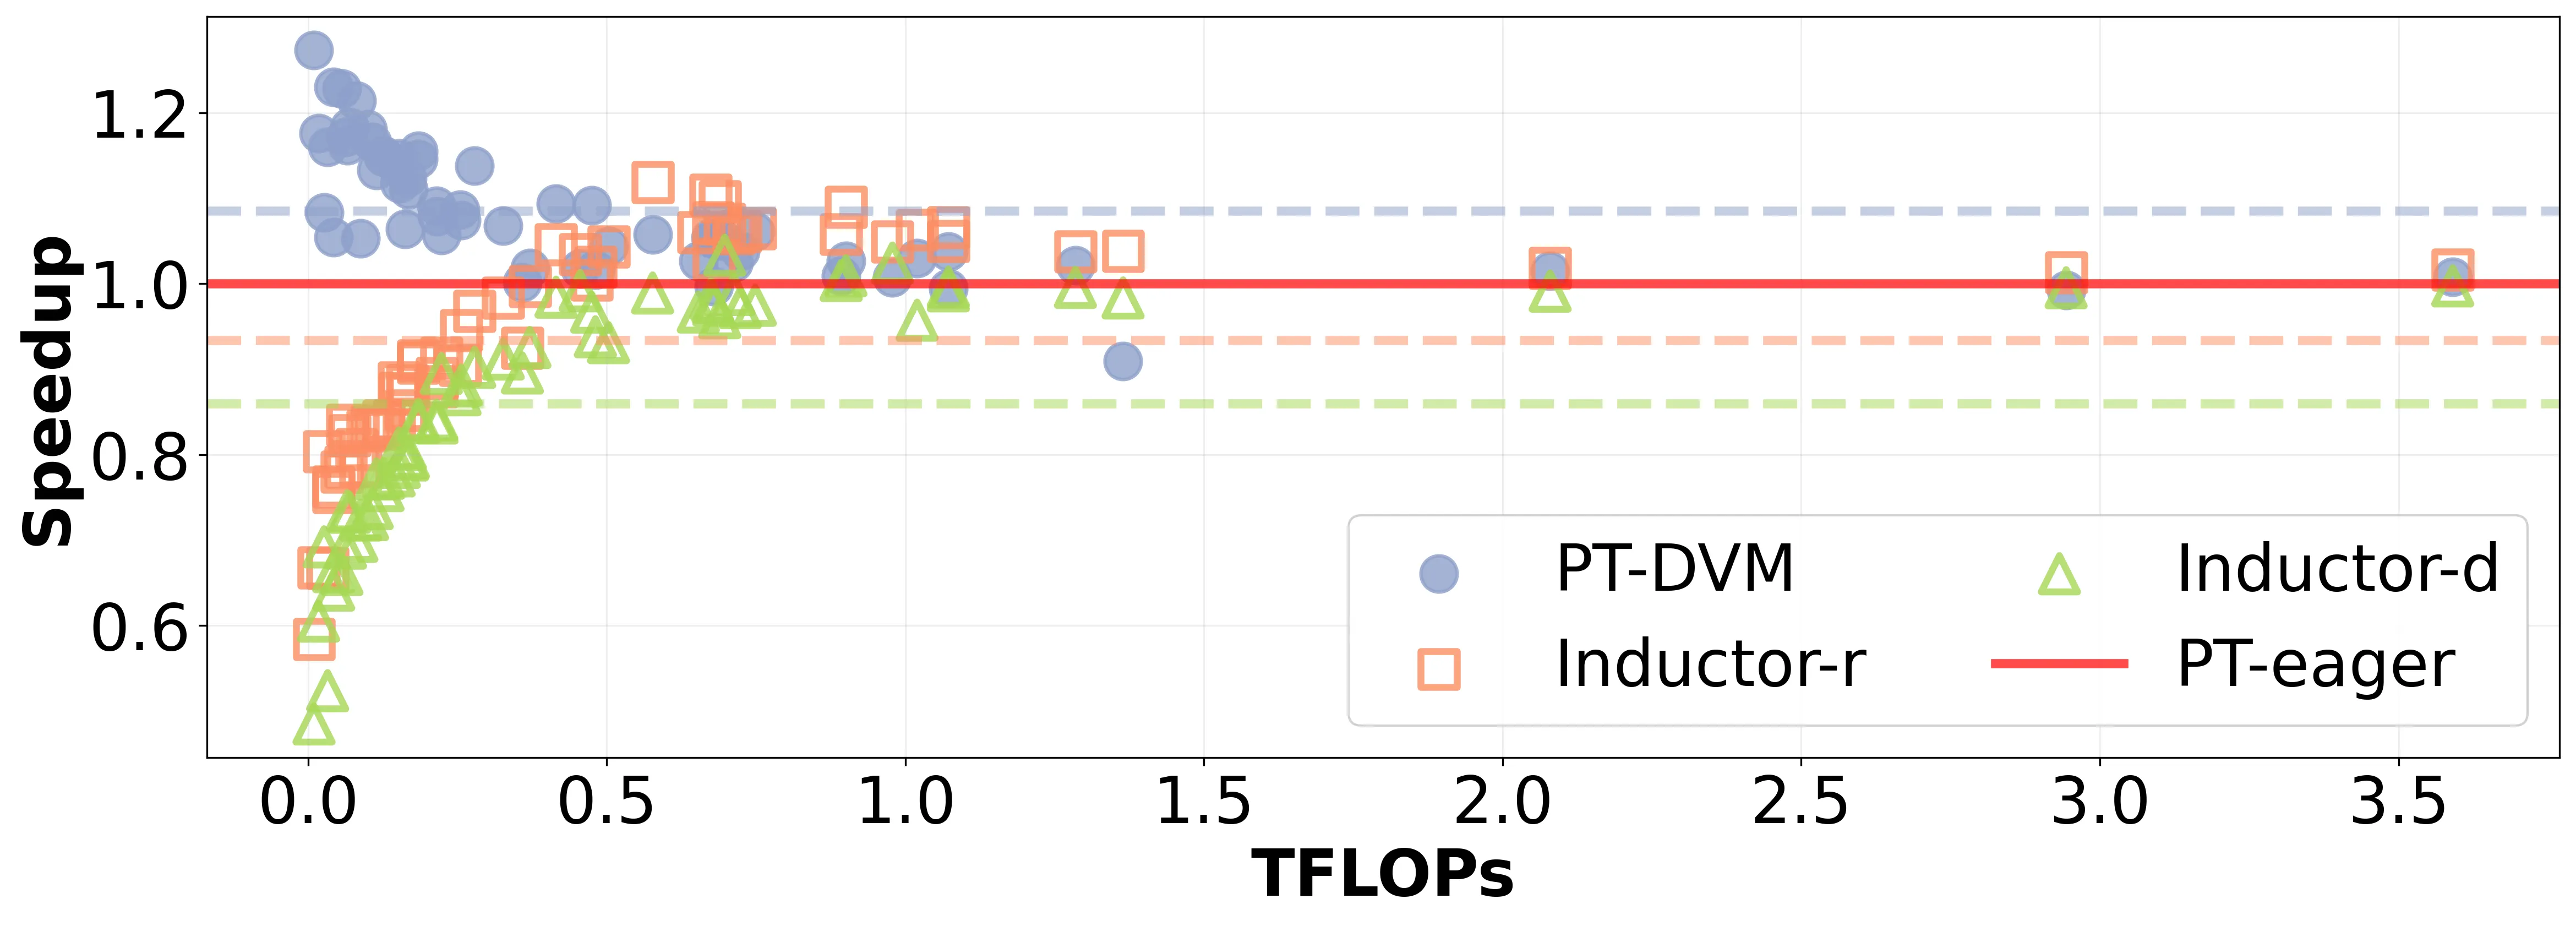
Figure 11: matmul算子加速比比较。
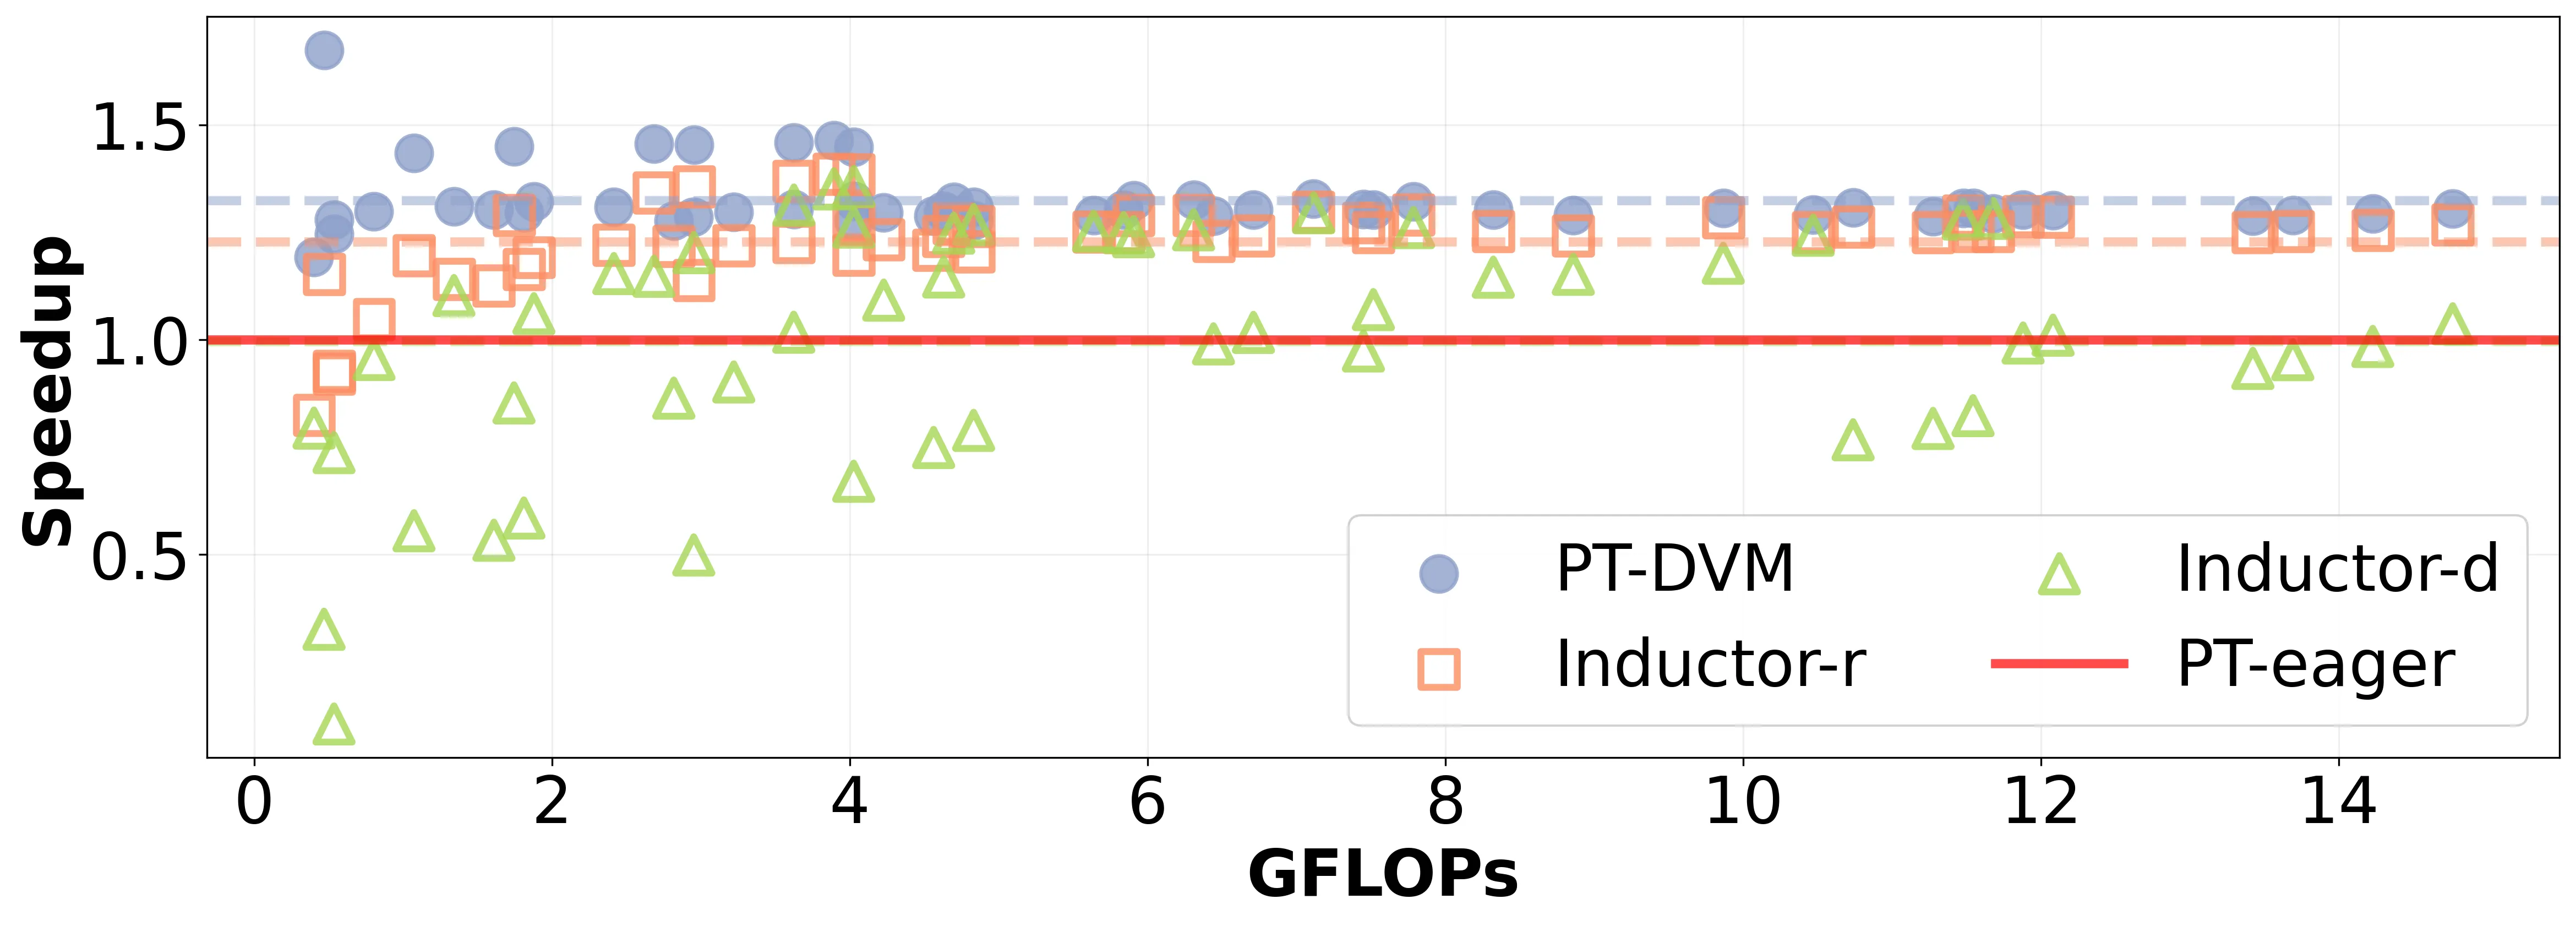
Figure 12: LayerNorm加速比比较。
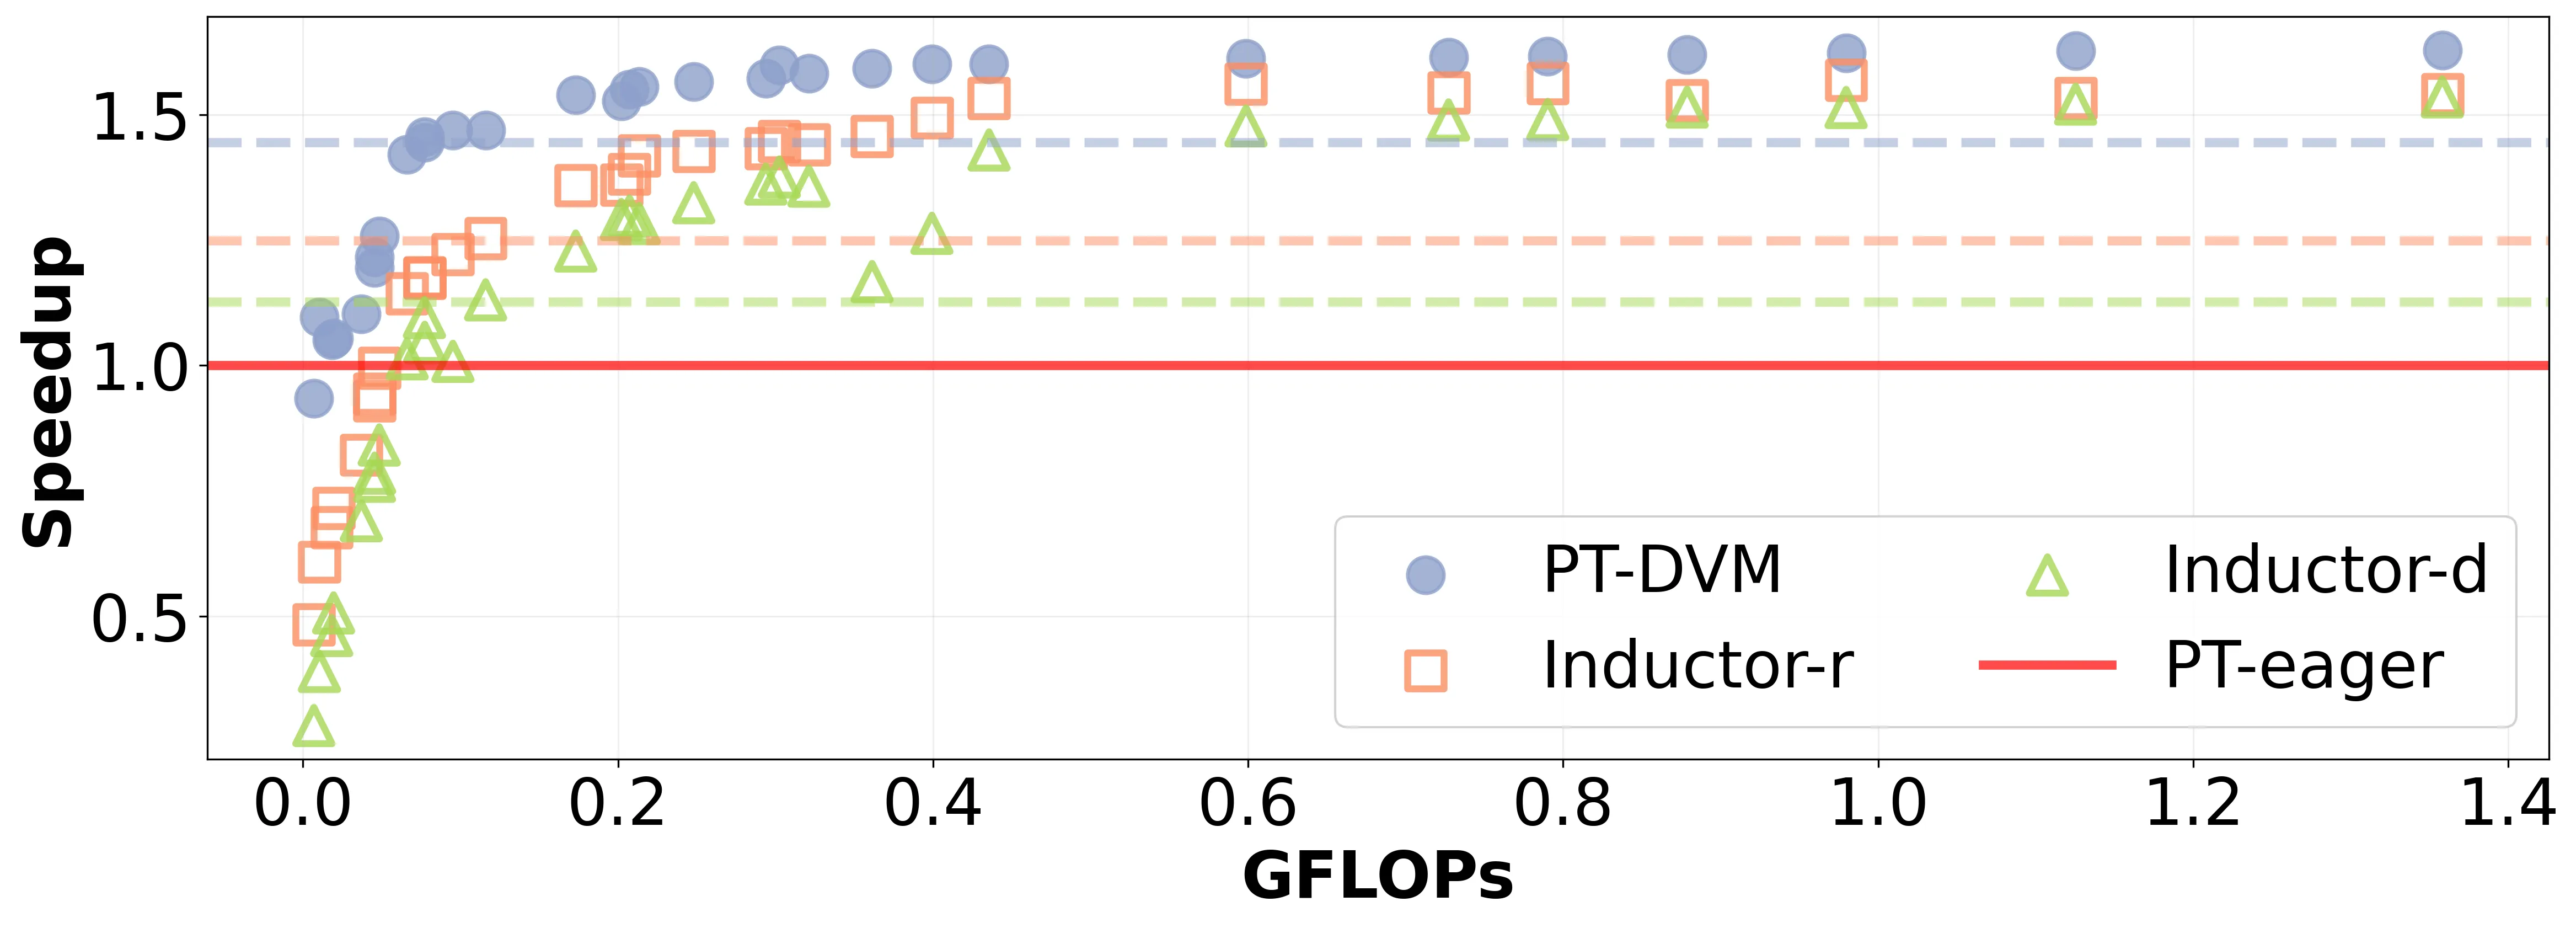
Figure 13: if-else-add算子加速比(“True”分支)。
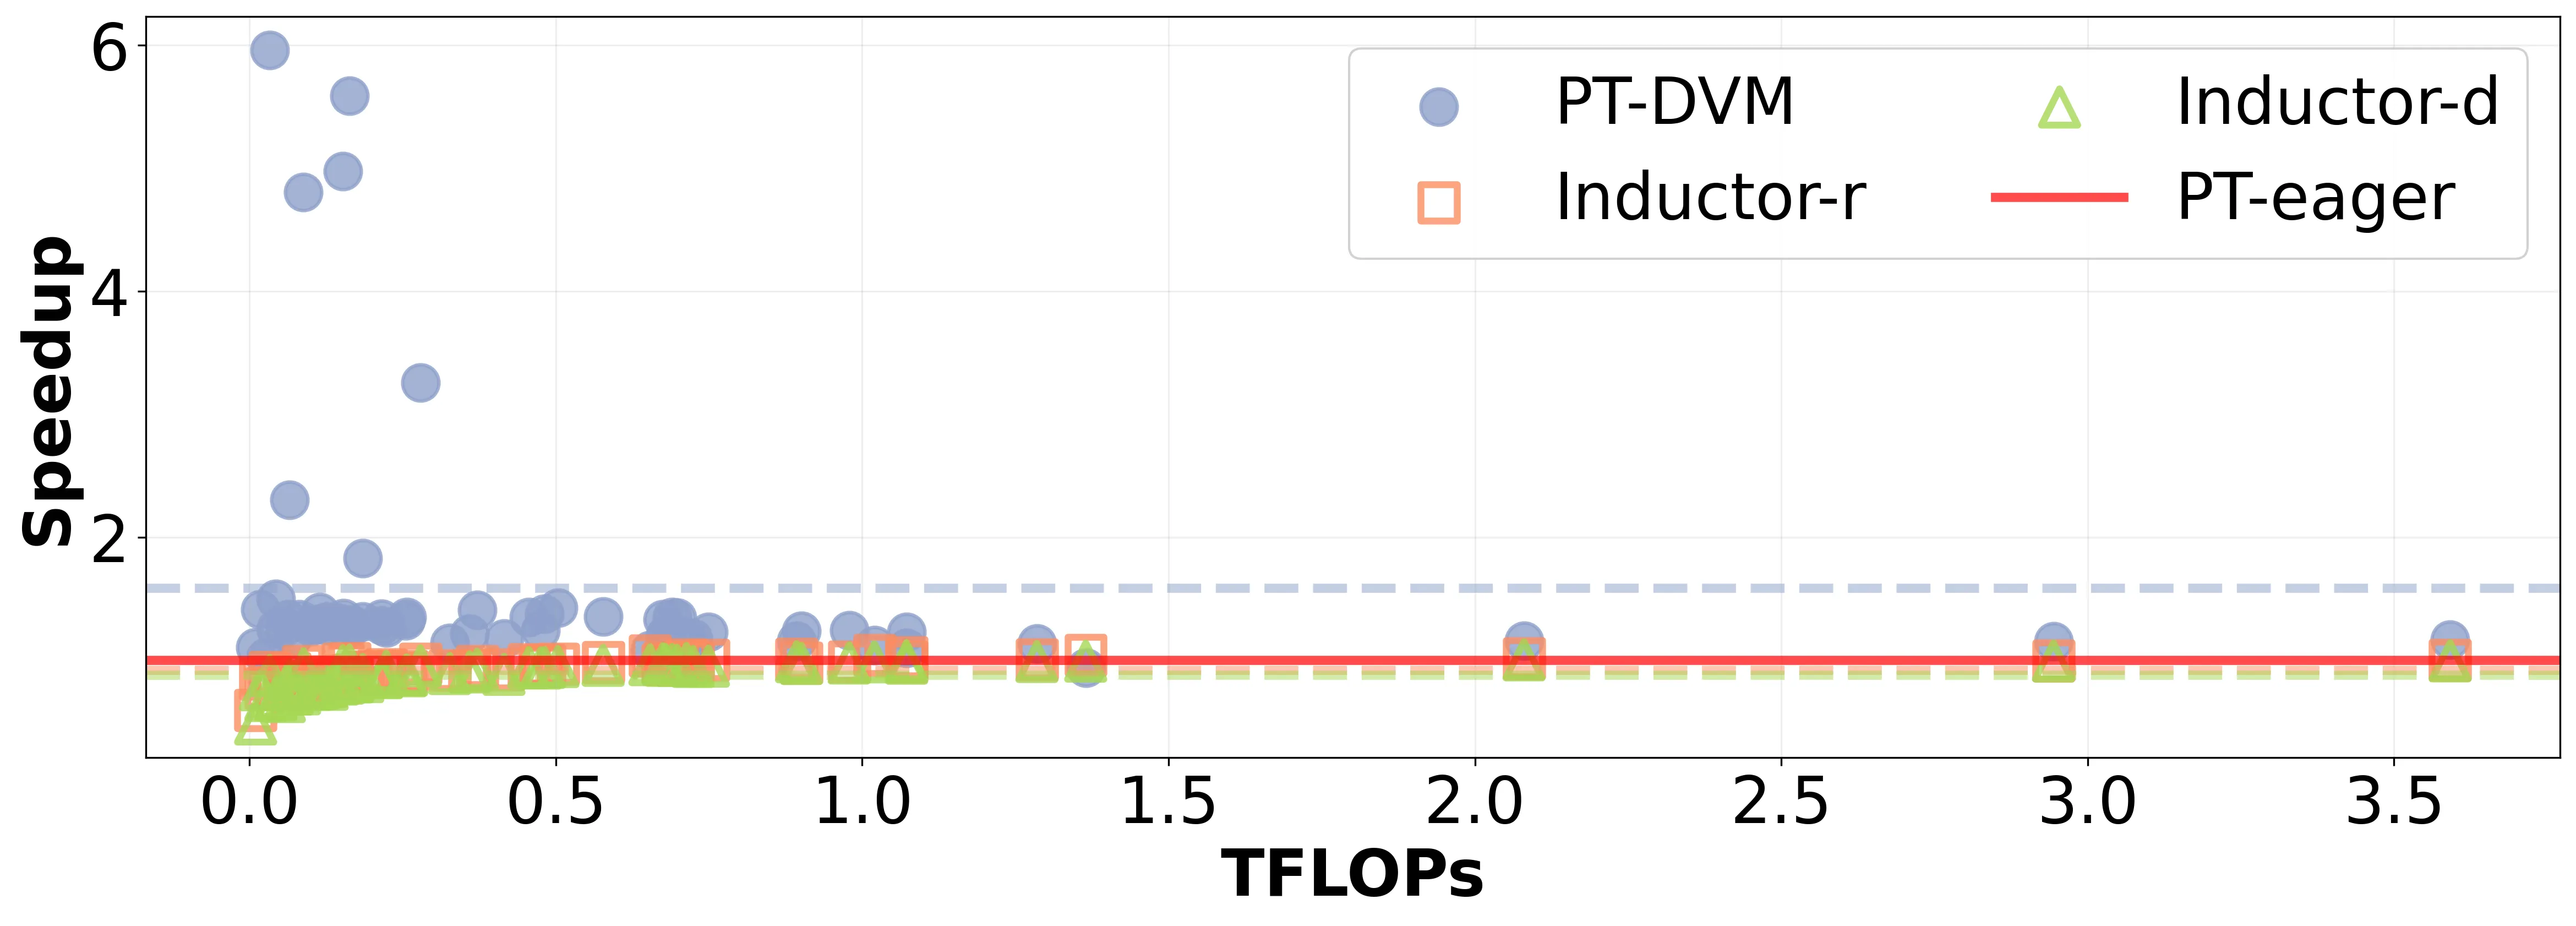
Figure 14: addmm算子加速比比较。
PT-DVM运行时间加速比 (Table 3):
| 算子 | 对比基线 | 平均加速 | 加速范围 | 加速比>1的比例 |
|---|---|---|---|---|
| matmul | Inductor-r | 1.19x | 0.88-2.18 | 62% |
| Inductor-d | 1.31x | 0.93-2.62 | 93% | |
| PT-eager | 1.09x | 0.91-1.27 | 93% | |
| LayerNorm | Inductor-r | 1.09x | 1.01-1.45 | 100% |
| Inductor-d | 1.63x | 1.01-11.77 | 100% | |
| PT-eager | 1.32x | 1.19-1.67 | 100% | |
| if-else-add | Inductor-r | 1.21x | 1.03-3.21 | 100% |
| Inductor-d | 1.58x | 1.06-6.88 | 100% | |
| PT-eager | 1.47x | 0.93-1.63 | 98% | |
| addmm | Inductor-r | 1.73x | 0.90-6.59 | 98% |
| Inductor-d | 1.82x | 0.94-6.81 | 98% | |
| PT-eager | 1.59x | 0.94-5.96 | 98% |
关键发现:
- DVM在所有算子上平均加速比>1
- LayerNorm上最大加速11.77x(vs Inductor-d)
- addmm上最大加速6.81x(vs Inductor-d)
6.3 编译时间比较
算子/子图编译时间 (Table 4):
| 算子 | 方法 | 最大编译时间 | 总编译时间 | 编译/运行时间比 |
|---|---|---|---|---|
| matmul | PT-DVM | 0.11ms | 0.48ms | 3.89×10⁻³ |
| Inductor-r | 115.88ms | 4339.33ms | 34.5 | |
| Inductor-d | 200.99ms | 354.53ms | 2.65 | |
| LayerNorm | PT-DVM | 0.10ms | 1.51ms | 5.57×10⁻³ |
| Inductor-r | 37,802ms | 1,517,938ms | 5370 | |
| Inductor-d | 35,696ms | 108,446ms | 303 | |
| if-else-add | PT-DVM | 0.05ms | 2.12ms | 2.17×10⁻² |
| Inductor-r | 35,352ms | 1,683,099ms | 15,800 | |
| Inductor-d | 35,425ms | 66,679ms | 555 | |
| addmm | PT-DVM | 0.11ms | 1.41ms | 1.11×10⁻² |
| Inductor-r | 521.79ms | 6242.67ms | 37.1 | |
| Inductor-d | 288.30ms | 444.56ms | 2.58 |
关键发现:
- DVM最大编译时间0.11ms,比Inductor-r的37,802ms快34万倍(约5个数量级)
- DVM编译/运行时间比在10⁻³到10⁻²级别,编译开销可忽略
- Inductor-r的编译时间可能是运行时间的数千到数万倍
6.4 模型级编译时间
Table 5: MMoE和BERT编译时间
| 模型 | 方法 | 编译时间 | 编译/运行时间比 |
|---|---|---|---|
| MMoE | PT-DVM | 27-204ms | 0.80-0.82 |
| Inductor-r | 4.84×10⁵ - 3.76×10⁶ ms | 1.28×10⁴ - 1.70×10⁴ | |
| BERT | PT-DVM | 4.09×10⁴ - 4.23×10⁴ ms | 1.11×10³ - 1.28×10³ |
| Inductor-r | 1.50×10⁵ - 3.43×10⁵ ms | 3.00×10³ - 9.24×10³ |
Table 6: Qwen和Llama编译时间
| 模型 | 方法 | 编译时间 | 编译/运行时间比 |
|---|---|---|---|
| Qwen3-14B | MS-DVM | 278-302ms | 0.028-0.045 |
| MS-O0 | 266-841ms | 0.12-0.22 | |
| Llama3.1-8B | MS-DVM | 127-128ms | 0.026-0.092 |
| MS-O0 | 118-129ms | 0.024-0.076 |
6.5 模型端到端性能
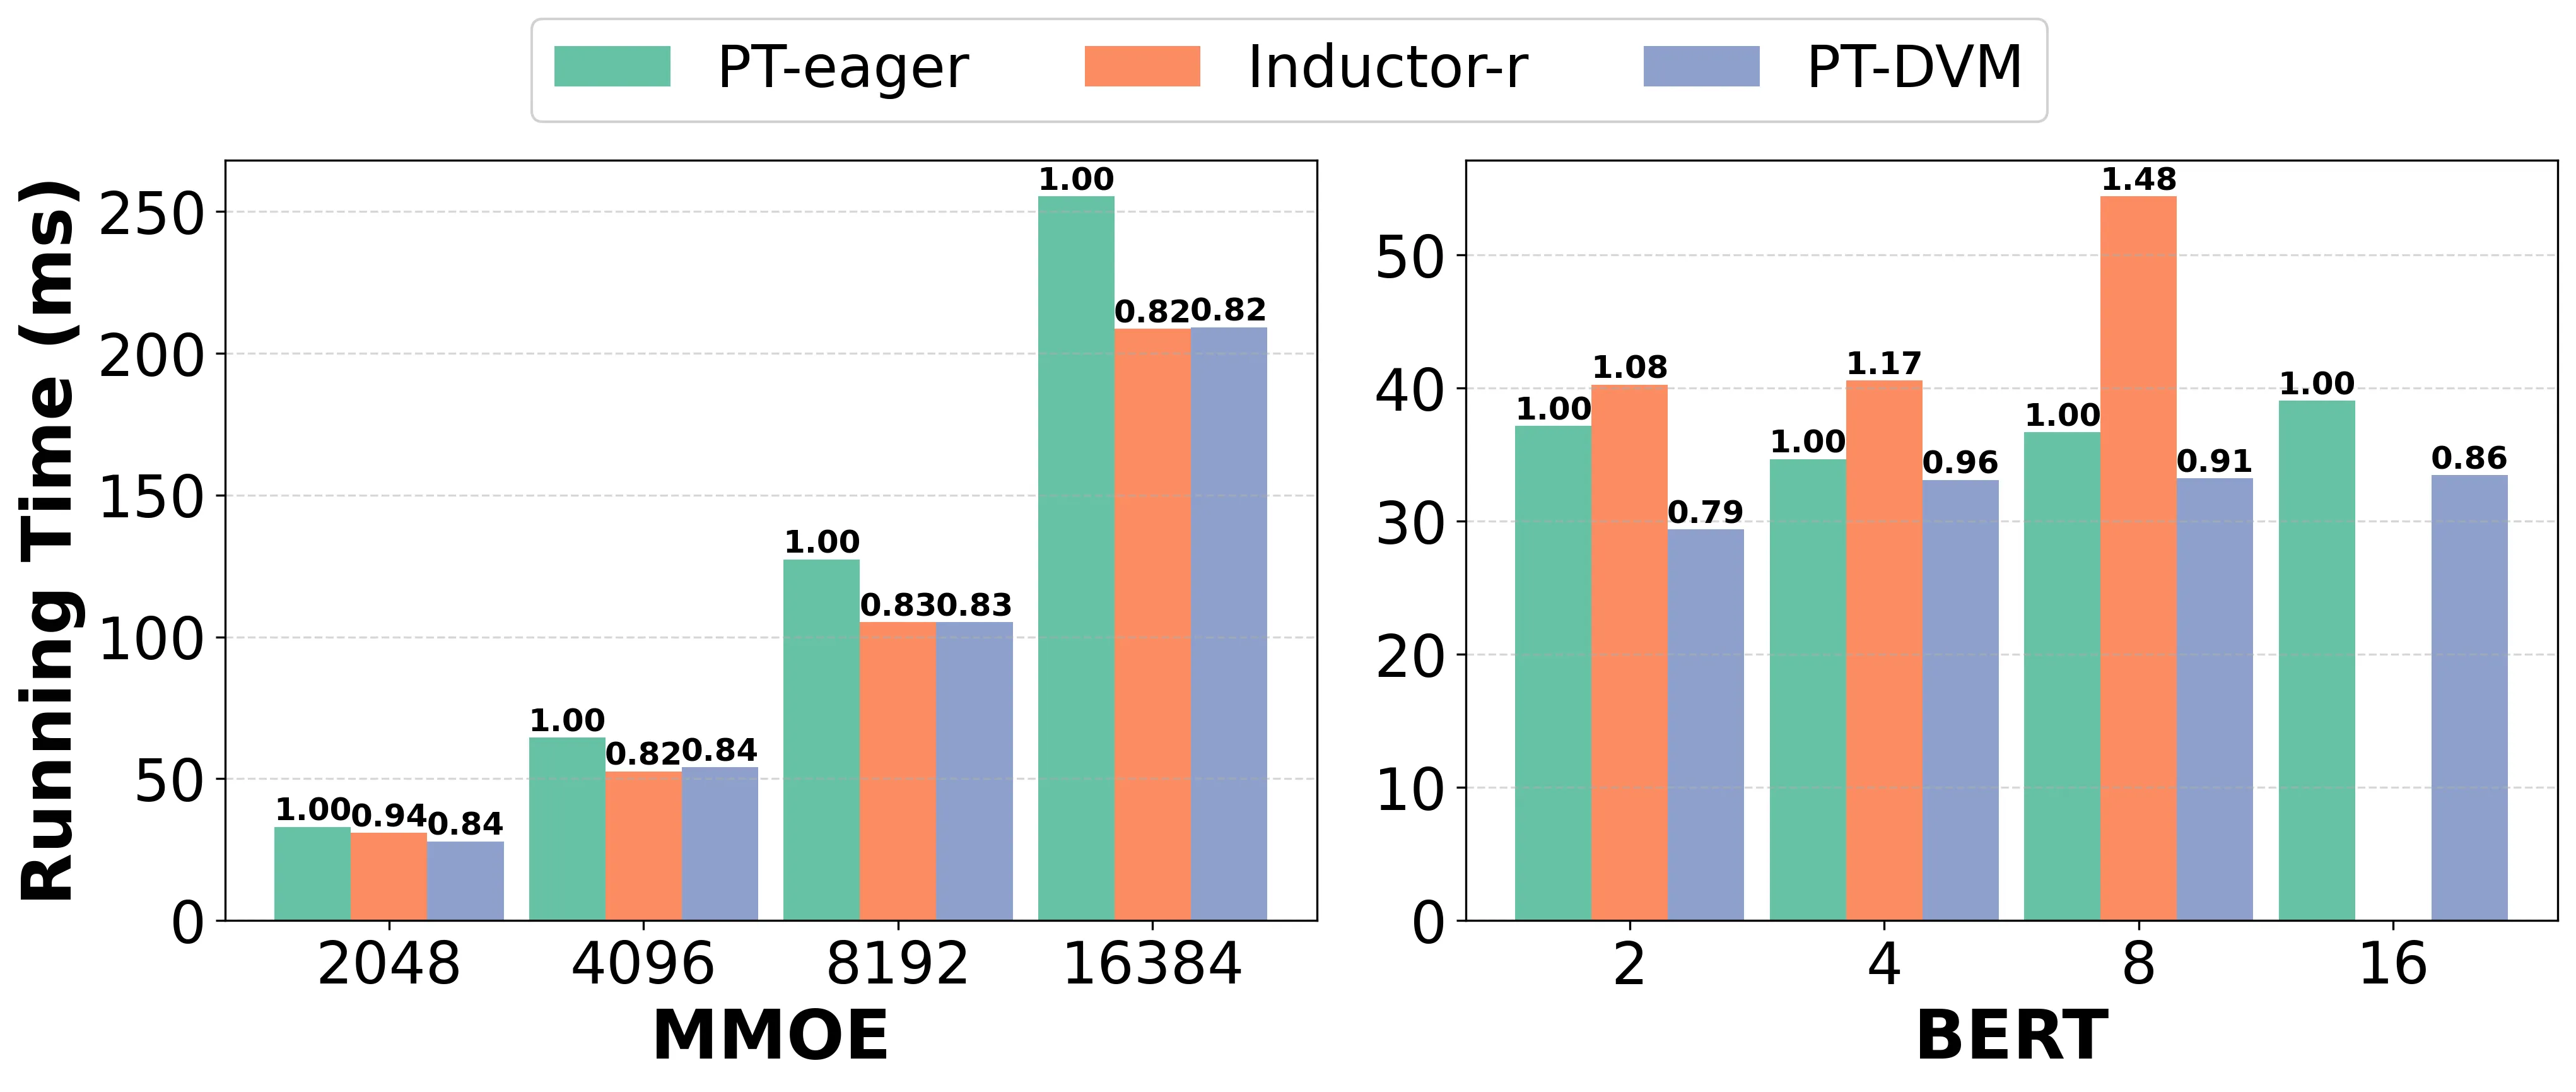
Figure 15: ML模型端到端性能比较。
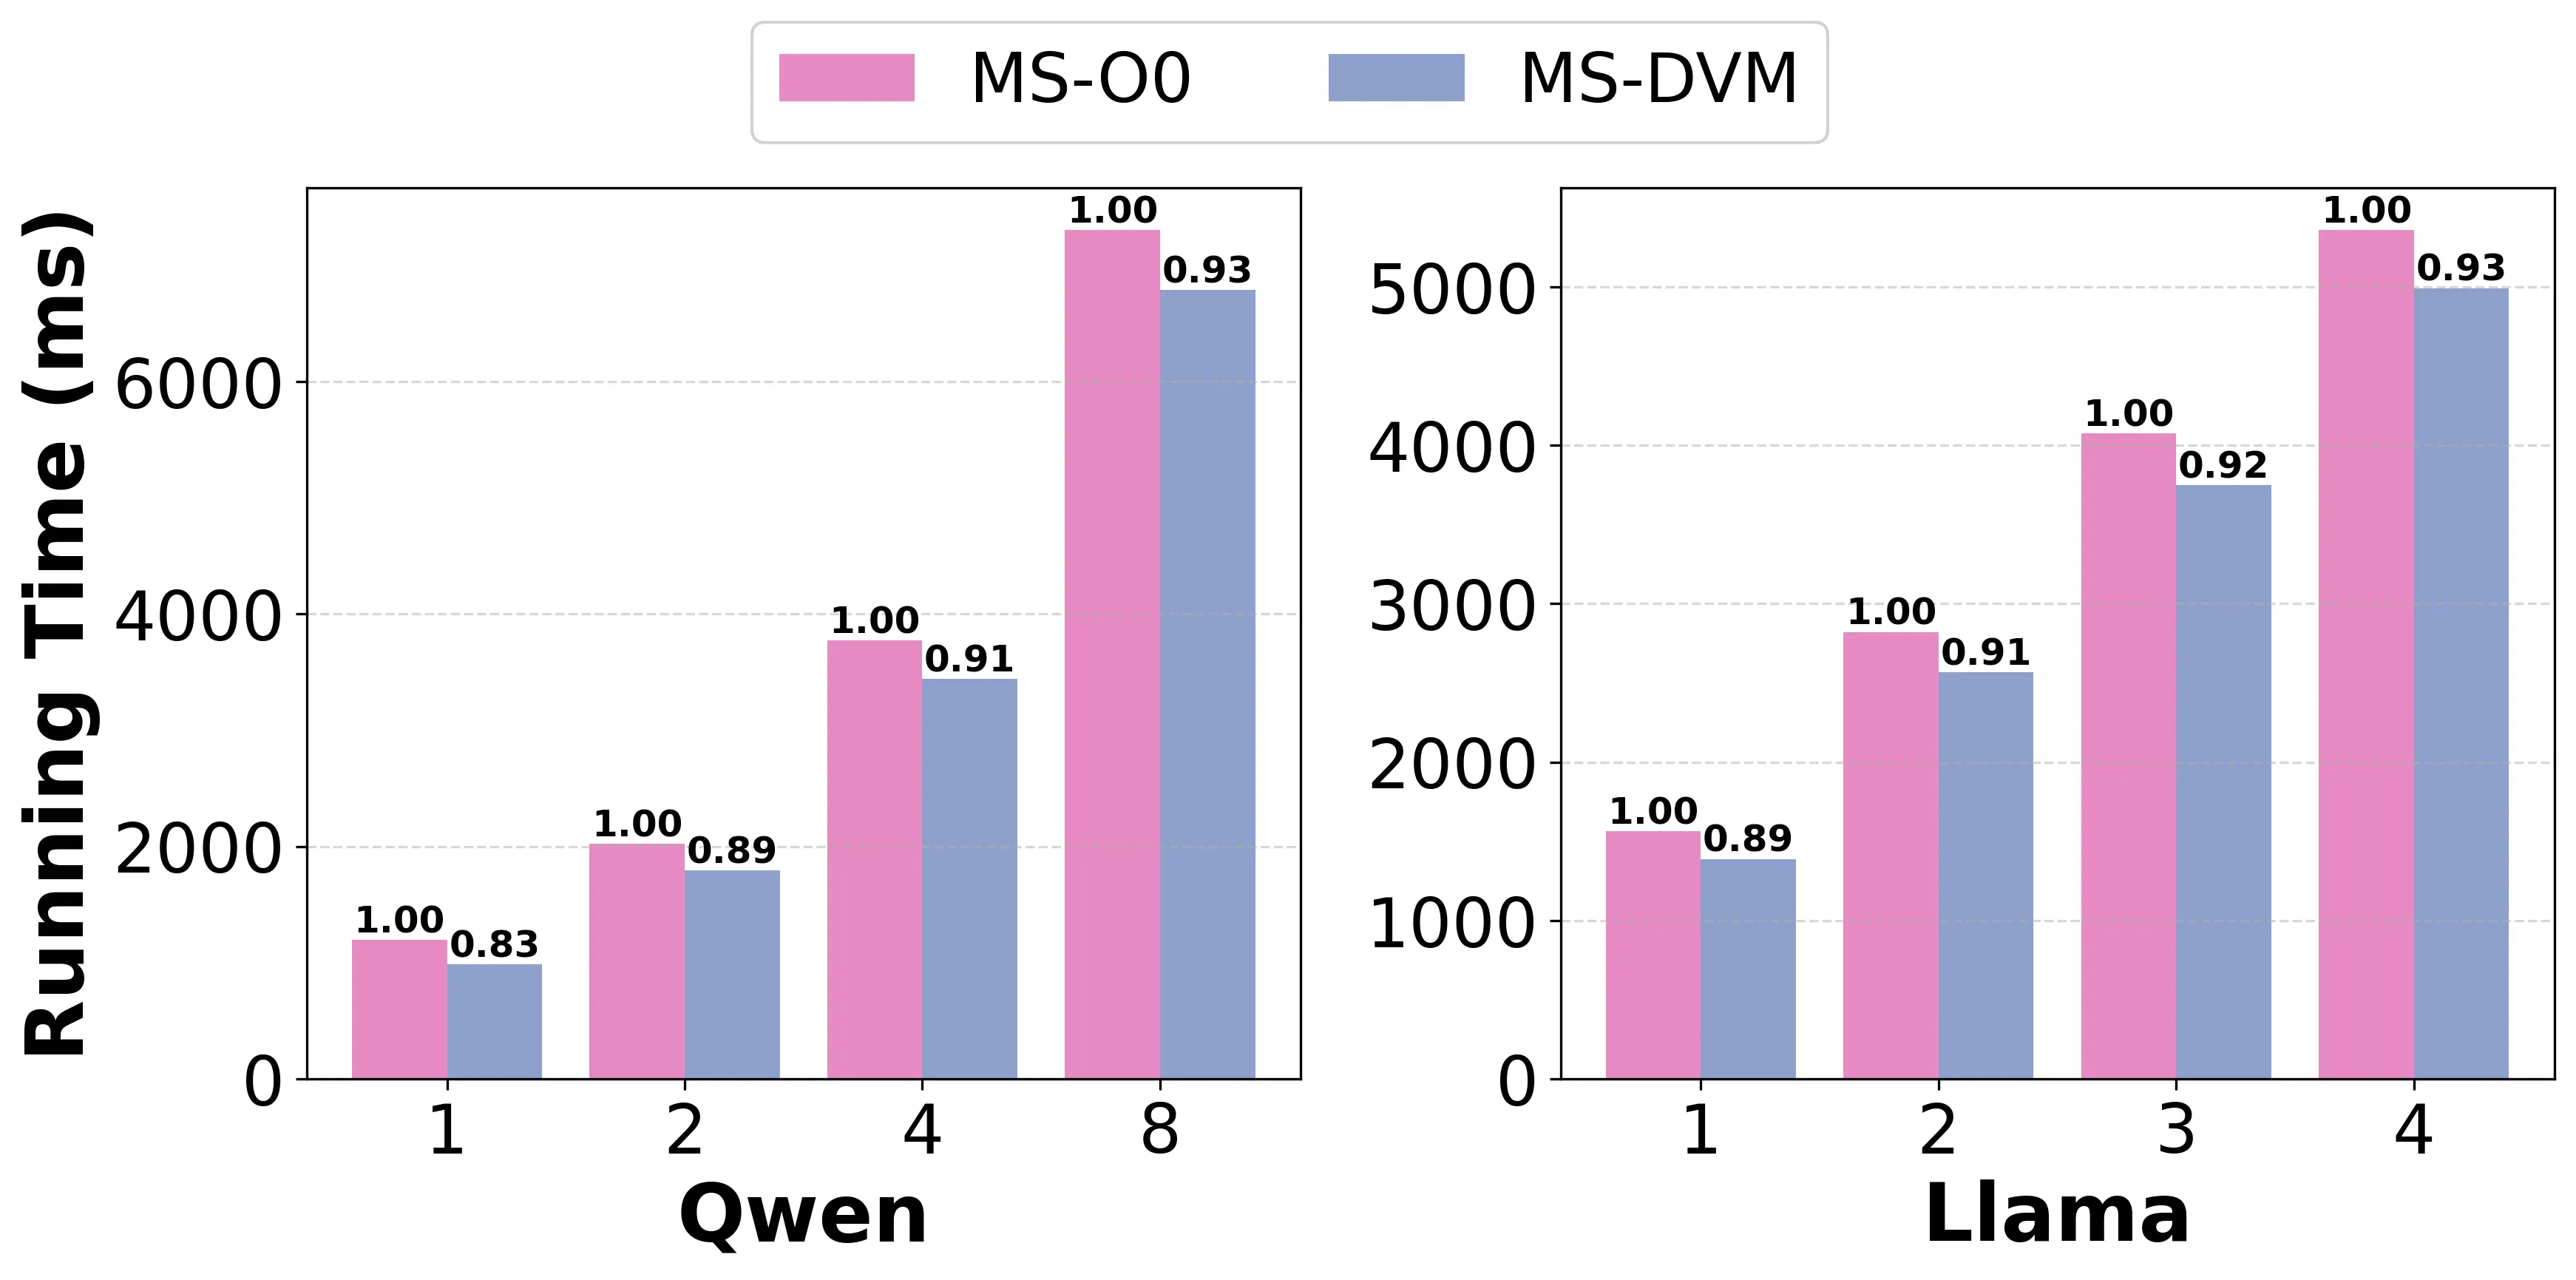
Figure 16: LLM性能比较。
DVM在模型级别也能提供加速,特别是在动态形状场景下。
七、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 字节码虚拟机 | 编码为字节码而非机器码,NPU上解码执行 | 编译时间减少5个数量级 |
| Tile级虚拟指令 | 设计与硬件对齐的tile级指令 | 减少编码/解释复杂度 |
| 硬件对齐Shape Tiling | 专用tiling模板+硬件约束剪枝 | 无需真实硬件测量 |
| 流水线隐藏编译 | 字节码生成与解释流水线,解码与执行流水线 | 编译开销可忽略 |
| 动态图流式融合 | 运行时即时融合决策,无需缓存 | 减少内存压力 |
| Pattern+Stacking融合 | 支持模式融合和空间/时间堆叠融合 | 增加融合机会 |
八、相关工作
| 工作 | 特点 | 与DVM对比 |
|---|---|---|
| TorchInductor | PyTorch 2编译器,支持动态shape重编译 | 编译时间长,DVM快5个数量级 |
| MindSpore | 华为深度学习框架,图模式编译 | MS-O0无融合,DVM后端可加速 |
| XLA | Google的线性代数编译器 | 面向GPU,DVM面向NPU |
| TVM | 端到端深度学习编译器 | 需要长时间auto-tuning |
九、总结
核心贡献
- DVM实时编译器:首个基于字节码虚拟机的动态张量计算编译器
- 编译时间突破:最大编译时间比TorchInductor快5个数量级
- 算子融合:支持静态图符号推导融合和动态图流式融合
- NPU优化:针对Ascend NPU架构的深度优化
技术影响
- 动态模型:让运行时编译对动态模型可行
- 编译器设计:字节码虚拟机方法可推广到其他加速器
- AI编译:为动态张量计算提供新的编译范式
- 华为生态:为Ascend NPU提供高效的编译后端
实际应用
- 动态shape模型:如LLM推理中变化的batch size和sequence length
- 动态控制流:如if-else、循环等控制流
- 算子融合:减少内存访问,提高计算效率
局限性
- 优化程度:相比机器码编译,字节码解释执行的优化空间有限
- 硬件特化:深度针对Ascend NPU,可移植性需要验证
- 融合覆盖:目前支持pattern-based和stacking-based融合,更复杂融合模式待探索
十、参考资源
- 论文: https://arxiv.org/abs/2603.24239
- torch-npu: https://github.com/Ascend/pytorch
- MindSpore: https://www.mindspore.cn/