CALVO: Improve Serving Efficiency for LLM Inferences with Intense Network Demands
面向网络密集型LLM推理的服务效率优化
CALVO: Improve Serving Efficiency for LLM Inferences with Intense Network Demands
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CALVO: Improve Serving Efficiency for LLM Inferences with Intense Network Demands |
| 作者 | Weiye Wang, Chen Chen, Junxue Zhang, Zhusheng Wang, Hui Yuan, Zixuan Guan, Xiaolong Zheng, Qizhen Weng, Yin Chen, Minyi Guo |
| 机构 | - |
| 论文 | arXiv:2603.21257 |
| 代码 | - |
| 发布 | 2026年3月 |
| 许可 | - |
二、核心思想
问题定义
分布式前缀缓存已成为高效LLM服务的核心技术。然而,对于具有高缓存命中率的长上下文请求,从远程服务器检索可重用的KVCache块已成为新的性能瓶颈。随着AI代理工作负载的持续增长,这种网络密集型LLM推理预计会变得越来越普遍。
现有问题:
- 现有LLM推理引擎主要以计算为中心
- 将KVCache加载视为GPU执行的附属阶段
- 在调度期间通常未明确考虑其延迟
解决方案概述
本文提出CALVO,一个将KVCache加载作为一等关注点的LLM服务引擎:
-
异步解耦:将KVCache加载和GPU计算解耦为独立管理、异步推进的阶段,实现网络、PCIe和计算资源的更好利用
-
显式调度:将KVCache加载延迟作为每个请求服务成本的显式组件,实现更准确的调度决策
实验结果:在真实测试平台上,CALVO显著提高了网络密集型LLM推理的效率,SLO达标率比基线高61.67%。
三、技术架构
整体框架图
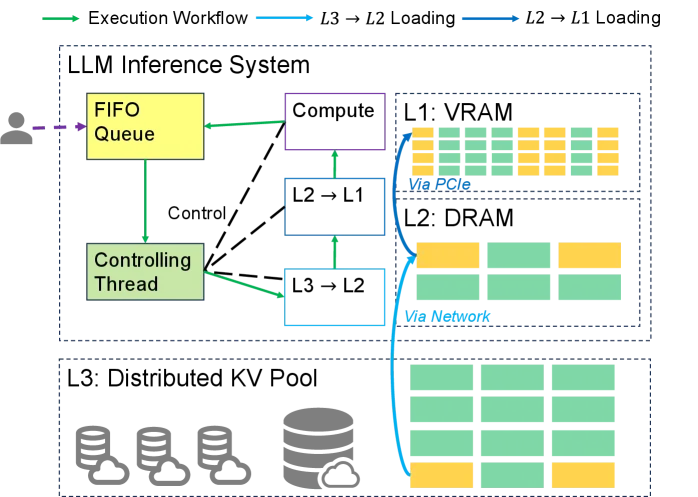
Figure 1: 典型LLM推理引擎(如vLLM)与分布式KVCache集成时的工作流。
问题分析
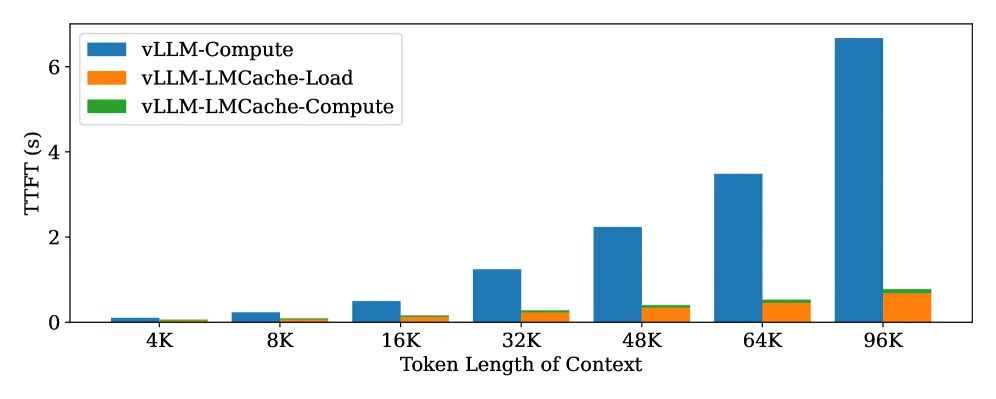
Figure 2: Llama-3.1-8B模型服务不同上下文token长度请求时的TTFT分解。
关键观察:
- 随着上下文长度增加,KVCache加载时间占TTFT的比例显著增加
- 长上下文请求中,网络传输成为主要瓶颈
- 现有调度策略未充分考虑网络延迟
CALVO架构
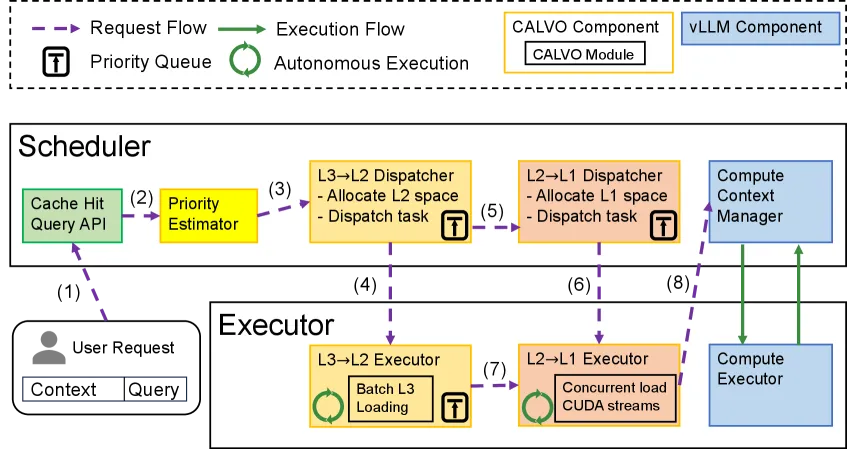
Figure 5: CALVO的工作流程。
核心设计:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| 异步加载器 | 独立管理KVCache加载 | 与GPU计算并行 |
| 调度器 | 考虑加载延迟的调度 | 显式建模网络成本 |
| 资源管理器 | 管理网络和PCIe资源 | 避免资源竞争 |
调度策略
传统调度的问题
FIFO调度:先到先服务,未考虑请求的加载成本 SJF调度:基于计算时间的最短作业优先,忽略了网络延迟
CALVO调度:将加载延迟纳入服务成本建模
加载延迟预测
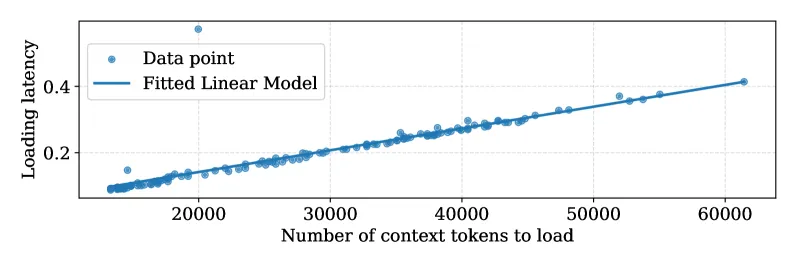
Figure 6: 加载延迟与需要加载的上下文token数量的关系。
关键发现:
- 加载延迟与上下文token数量近似线性关系
- 可以通过历史数据建立预测模型
异步执行模型
传统模型(同步):
- 加载KVCache → 2. GPU计算 → 3. 返回结果
CALVO模型(异步):
- 启动KVCache加载(异步)
- 同时处理其他请求的GPU计算
- KVCache加载完成后,调度GPU计算
- 返回结果
优势:
- 网络和PCIe资源与GPU计算并行利用
- 减少资源空闲时间
- 提高整体吞吐量
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| KVCache加载一等公民 | 将加载延迟从附属阶段提升为显式调度组件 | SLO达标率+61.67% |
| 异步解耦 | KVCache加载与GPU计算异步并行 | 资源利用率提升 |
| 成本感知调度 | 将网络延迟纳入服务成本建模 | 更准确的调度决策 |
| 预测模型 | 建立加载延迟与上下文长度的预测关系 | 线性预测准确 |
五、实验结果
实验配置
硬件环境:
- 真实测试平台
- 分布式KVCache服务器
评估模型:
- Llama-3.1-8B
工作负载:
- 长上下文请求
- 高缓存命中率场景
性能分析
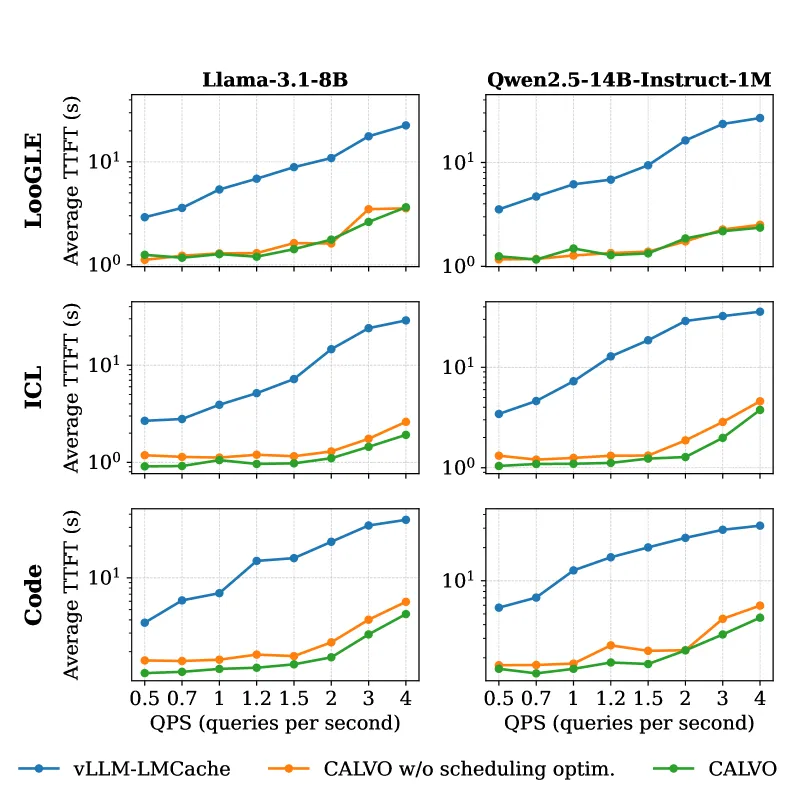
Figure 7: 平均TTFT延迟性能。
SLO达标率
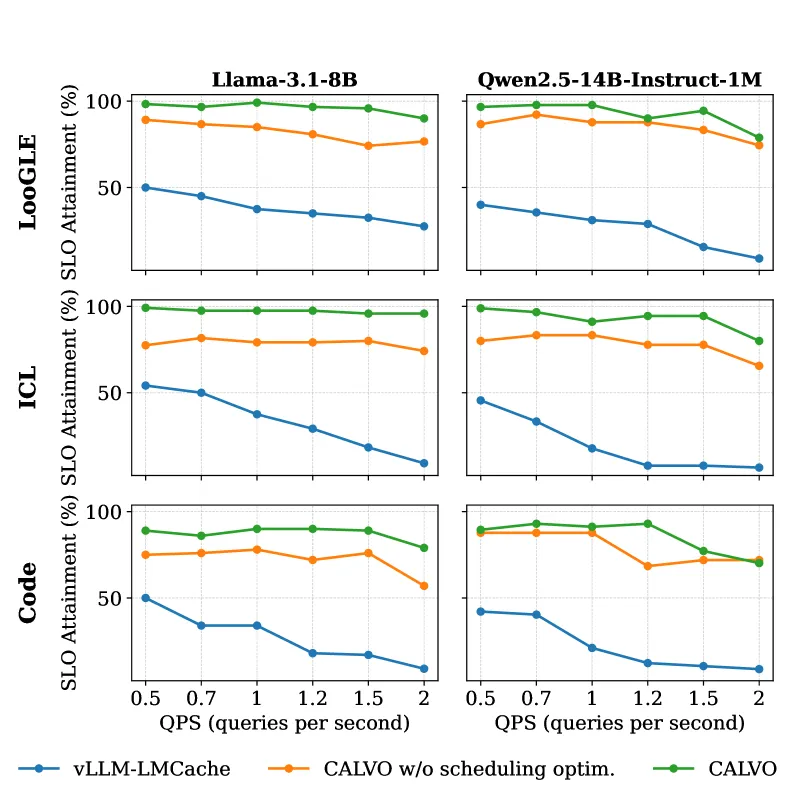
Figure 8: TTFT SLO达标率。
关键结果:
- CALVO的SLO达标率比基线高61.67%
- 在高负载场景下优势更明显
- 长上下文请求受益最大
调度策略比较
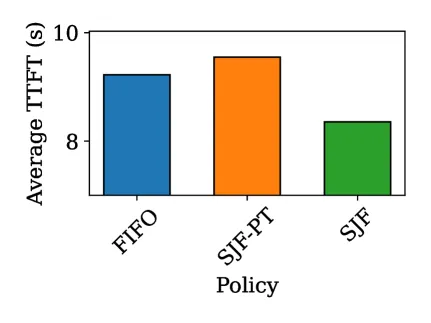
Figure 9-10: 不同调度策略的平均TTFT和SLO达标率比较。
关键发现:
- CALVO调度策略在所有场景下都优于FIFO和SJF
- 考虑网络延迟的调度决策更准确
- 异步执行模型显著减少等待时间
缓存命中率影响
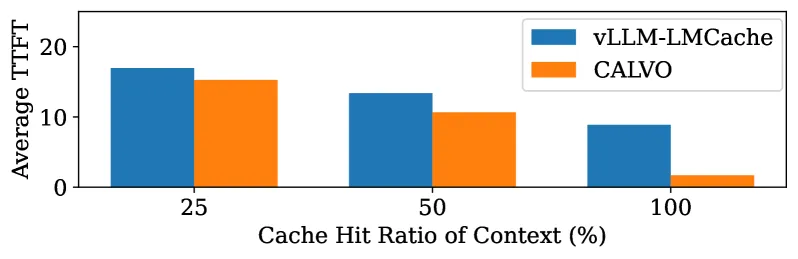
Figure 11: 不同缓存命中率下的平均TTFT。
关键发现:
- 缓存命中率越高,CALVO优势越明显
- 高命中率场景下网络传输成为主要瓶颈
- CALVO有效缓解了网络瓶颈
六、相关工作
LLM服务优化
| 方法 | 关键特性 | 本文对比 |
|---|---|---|
| vLLM | PagedAttention、连续批处理 | 基线系统 |
| LMCache | 分布式KVCache缓存 | 相关工作 |
| DistServe | 分布式推理服务 | 相关工作 |
KVCache管理
| 方法 | 关键特性 | 本文对比 |
|---|---|---|
| 前缀缓存 | 复用公共前缀的KVCache | 核心技术 |
| 分布式缓存 | 跨服务器存储KVCache | 网络瓶颈来源 |
| 缓存调度 | KVCache加载调度 | 本文创新 |
七、总结
核心贡献
-
问题识别:识别了网络密集型LLM推理中KVCache加载成为性能瓶颈的问题
-
CALVO系统:提出将KVCache加载作为一等关注点的LLM服务引擎
-
异步解耦:将KVCache加载和GPU计算解耦为异步并行阶段
-
成本感知调度:将加载延迟纳入服务成本建模,实现更准确的调度决策
-
显著性能提升:SLO达标率比基线高61.67%
技术影响
- 系统设计:为LLM服务系统设计提供了新的视角
- 调度策略:为网络密集型工作负载提供了调度指导
- 资源管理:优化了网络、PCIe和计算资源的协调利用
- 实际部署:适用于具有分布式缓存的实际LLM服务系统
局限性
- 模型覆盖:主要在Llama-3.1-8B上验证
- 工作负载:主要针对长上下文、高缓存命中率场景
- 硬件依赖:需要分布式KVCache基础设施
- 预测精度:加载延迟预测模型可能需要针对不同环境调整
八、参考资源
- 论文: https://arxiv.org/abs/2603.21257
- vLLM: 基线LLM服务系统
- LMCache: 分布式KVCache缓存系统