LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels
First stable end-to-end JEPA that trains from raw pixels using only two loss terms (prediction + SIGReg), with ~15M params on single GPU, 48x faster planning than foundation-model world models
LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels |
| 作者 | Lucas Maes*, Quentin Le Lidec*, Damien Scieur, Yann LeCun, Randall Balestriero |
| 机构 | Mila & Universite de Montreal / New York University / Samsung SAIL / Brown University |
| 论文 | https://arxiv.org/abs/2603.19312 |
| 代码 | https://github.com/lucas-maes/le-wm |
| 发布 | arXiv:2603.19312v1 [cs.LG], Mar 13, 2026 |
| 许可 | 未明确(代码仓库待确认) |
二、核心思想
问题定义
Joint Embedding Predictive Architectures (JEPAs) 提供了一个在紧凑潜在空间中学习世界模型的有吸引力框架。然而,现有方法存在严重缺陷:
- 脆弱性:依赖复杂的多项损失函数、指数移动平均(EMA)、预训练编码器或辅助监督来避免表示崩溃(representation collapse)
- 训练不稳定:JEPA 极易陷入崩溃——模型将所有输入映射为几乎相同的表示,以平凡方式满足时间预测目标
- 超参数敏感:如 PLDM 需要 6+ 个可调超参数,调参成本高昂
- 计算成本高:基于基础模型的方法(如 DINO-WM)冻结预训练编码器,丧失端到端学习能力
解决方案概述
本文提出 LeWorldModel (LeWM)——第一个能够从原始像素稳定端到端训练的 JEPA。其核心创新在于仅需两个损失项:
- 下一个嵌入预测损失():标准 JEPA 预测目标
- SIGReg 正则化(Sketched-Isotropic-Gaussian Regularizer):强制潜在嵌入匹配各向同性高斯分布,从理论上保证 anti-collapse
与现有方法相比:
- 超参数从 6 个降至 1 个(仅 ,SIGReg 权重)
- 约 15M 参数,单 GPU 数小时即可训练
- 规划速度比基础模型世界模型快 48x
- 在多种 2D/3D 控制任务上保持竞争力
三、技术架构
整体框架图
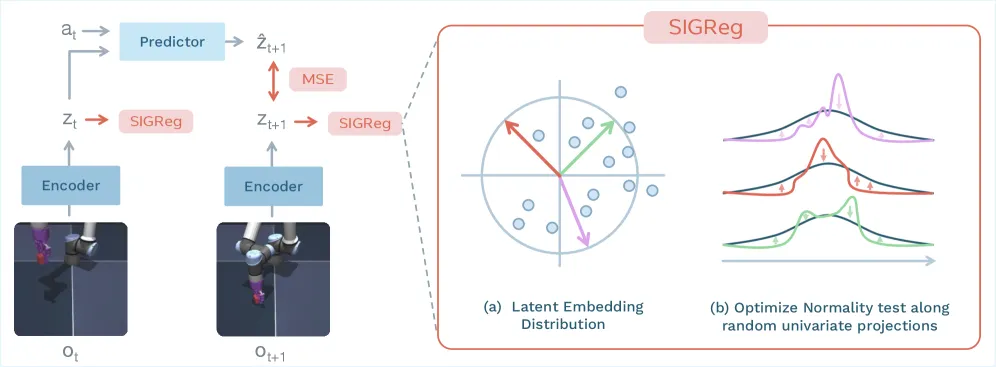
给定帧观测 和动作 :
- Encoder:将帧映射到低维潜在表示
- Predictor:自回归地预测下一个潜在状态 ,基于当前潜在状态 和动作
- 联合优化:使用 MSE 预测损失端到端训练 encoder 和 predictor
- SIGReg:防止平凡崩溃,强制潜在嵌入呈高斯分布
方法分类对比
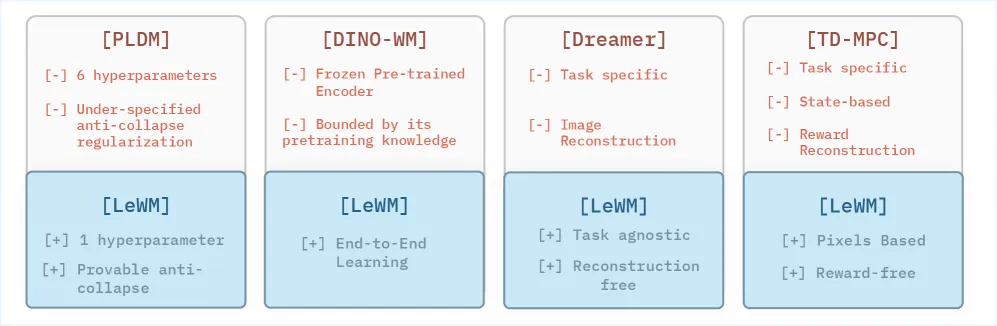
| 类别 | 代表方法 | 特点 | 局限 |
|---|---|---|---|
| 端到端 | PLDM | 从像素联合学习 encoder+predictor | 训练不稳定,需6+超参数,无崩溃保证 |
| 基础模型 | DINO-WM | 冻结预训练视觉编码器 | 非端到端,表达能力受限 |
| 任务特定 | Dreamer, TD-MPC | 需要 reward 信号或特权状态 | 不适用于 reward-free 场景 |
| LeWM | 本工作 | 端到端、任务无关、仅需1超参数、有理论崩溃保证 | 在极高视觉复杂度场景略逊 |
模型架构
Encoder (LeWM)
- 骨干:Vision Transformer (ViT-tiny),~5M 参数
- 配置:patch size = 14,12 层,3 个 attention head,隐藏维度 192
- 输出:[CLS] token embedding + 1层 MLP with Batch Normalization 投影
- BN 是必要的:因为 ViT 最后层使用 Layer Normalization,会妨碍 SIGReg anti-collapse 目标的有效优化
Predictor
- 架构:Transformer,6 层,16 个 attention head,10% dropout,~10M 参数
- 动作注入:每层使用 AdaLN(Adaptive Layer Normalization)
- AdaLN 参数初始化为零,确保 action conditioning 渐进式影响训练
- 时序因果掩码:避免看到未来嵌入
- 历史窗口:取 N 帧表示,自回归预测下一帧
- Projector:与 encoder 相同的 1-layer MLP + BN
总参数量
核心公式
预测损失(Prediction Loss)
通过预测损失,encoder 被激励为学习对 predictor 可预测的表示。
SIGReg 正则化
SIGReg(Sketched-Isotropic-Gaussian Regularizer)源自 Balestriero & LeCun (2024) 的理论工作。
令 为潜在嵌入张量(history length ,batch size ,embedding dimension )。
SIGReg 通过将嵌入投影到 个随机单位范数方向 上,然后优化单变量 Epps-Pulley 检验统计量 来实现:
根据 Cramér-Wold 定理,匹配所有一维边际分布等价于匹配完整联合分布。
完整训练目标
其中 是唯一有效的可调超参数。默认值: 次投影,。
训练伪代码
def LeWorldModel(obs, actions, lambd=0.1):
    """
    obs: (B, T, C, H, W) raw pixels sequence
    actions: (B, T, A) action sequence
    lambd: (float) SIGReg loss weight
    """
    emb = encoder(obs)                          # (B, T, D)
    next_emb = predictor(emb, actions)          # (B, T, D)

    # next-embedding prediction loss (teacher-forcing)
    pred_loss = F.mse_loss(emb[:, 1:] - next_emb[:, :-1])

    # step-wise SIGReg (anti-collapse)
    sigreg_loss = mean(SIGReg(emb.transpose(0, 1)))

return pred_loss + lambd * sigreg_loss关键特性:不使用 stop-gradient、不使用 EMA、不冻结任何组件、所有参数端到端联合优化。
潜在规划(Latent Planning)
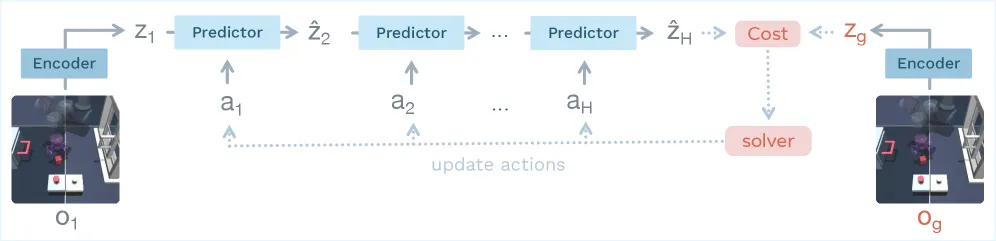
推理时,在 LeWM 潜在空间中执行轨迹优化。
给定初始观测 和目标 :
终端代价函数:
最优控制问题:
求解方法:Cross-Entropy Method (CEM),采用 Model Predictive Control (MPC) 策略——仅执行前 K 个规划动作后重新规划。
训练流程
阶段 1: 数据收集
  └─ 离线行为策略收集轨迹 (observations + actions)
  └─ 无需最优性要求,可以是探索性或伪专家数据

阶段 2: 端到端训练 (单GPU, 数小时)
  ├─ Encoder (ViT-tiny) + Predictor (Transformer)
  ├─ Loss = MSE_prediction + λ · SIGReg
  ├─ λ ∈ [0.01, 0.2] 范围内均有效 (>80% 成功率)
  └─ 对 M (投影数) 和 integration knots 不敏感

阶段 3: 潜在规划 (推理)
  ├─ CEM 优化 action sequence
  ├─ MPC 重规划策略
  └─ 无需环境交互,纯 latent space 规划
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个稳定端到端 JEPA | 从原始像素训练,无需 stop-gradient、EMA 或预训练编码器 | 在 4 种环境中验证,超越 PLDM |
| SIGReg anti-collapse | 用 Cramér-Wold 定理保证,强制嵌入匹配各向同性高斯分布 | 理论上保证非平凡解;实验中仅需 1 个超参数 |
| 极简损失设计 | 仅 2 个损失项(预测 + SIGReg),超参数从 6 降至 1 | 可用二分搜索高效优化, 均稳定 |
| 高效规划 | 15M 参数,编码 token 数比 DINO-WM 少 ~200x,规划速度比 DINO-WM 快 ~50x,与 PLDM 相当 | Fig. 3 左侧 |
| 物理理解能力 | 潜在空间编码有意义的物理结构,能检测物理不连续事件 | Sec. 5 probing + violation-of-expectation |
| Emergent temporal straightening | 无需显式时间平滑损失,latent paths 自动变直 | Fig. 17: LeWM 的 latent trajectory 比 PLDM 更直 |
五、实验结果
评估环境
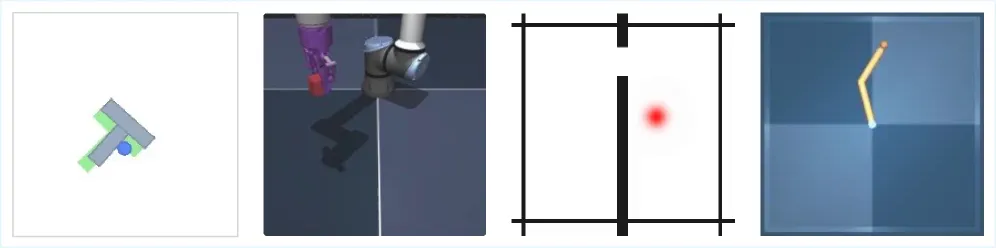
| 环境 | 类型 | 描述 |
|---|---|---|
| Push-T | 2D 操纵 | 将方块推至目标配置,常用机器人基准 |
| OGBench-Cube | 3D 操纵 | 视觉更丰富的 3D 环境,机械臂操控方块 |
| Two-Room | 2D 导航 | 简单 2D 导航,在房间间移动到目标位置 |
| Reacher | 2D 操控 | 2 关节臂在 2D 平面到达目标配置 |
所有环境均有连续动作空间。
规划性能对比
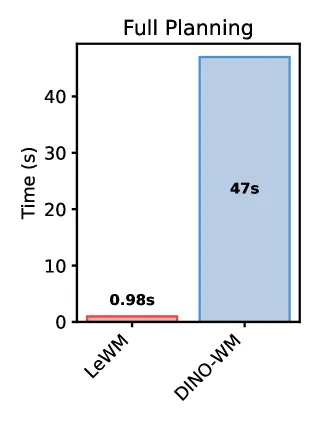
规划速度(Fig. 3 左):
- 编码观测的 token 数比 DINO-WM 少 ~200x
- 规划速度与 PLDM 相当
- 比 DINO-WM 快 ~50x
- 在固定计算预算下(固定 FLOPs),LeWM 显著优于 DINO-WM
规划成功率(Fig. 6):
| 环境 | LeWM vs PLDM | LeWM vs DINO-WM |
|---|---|---|
| Push-T | LeWM 胜出 | LeWM 显著胜出 |
| Reacher | LeWM 胜出 | LeWM 胜出 |
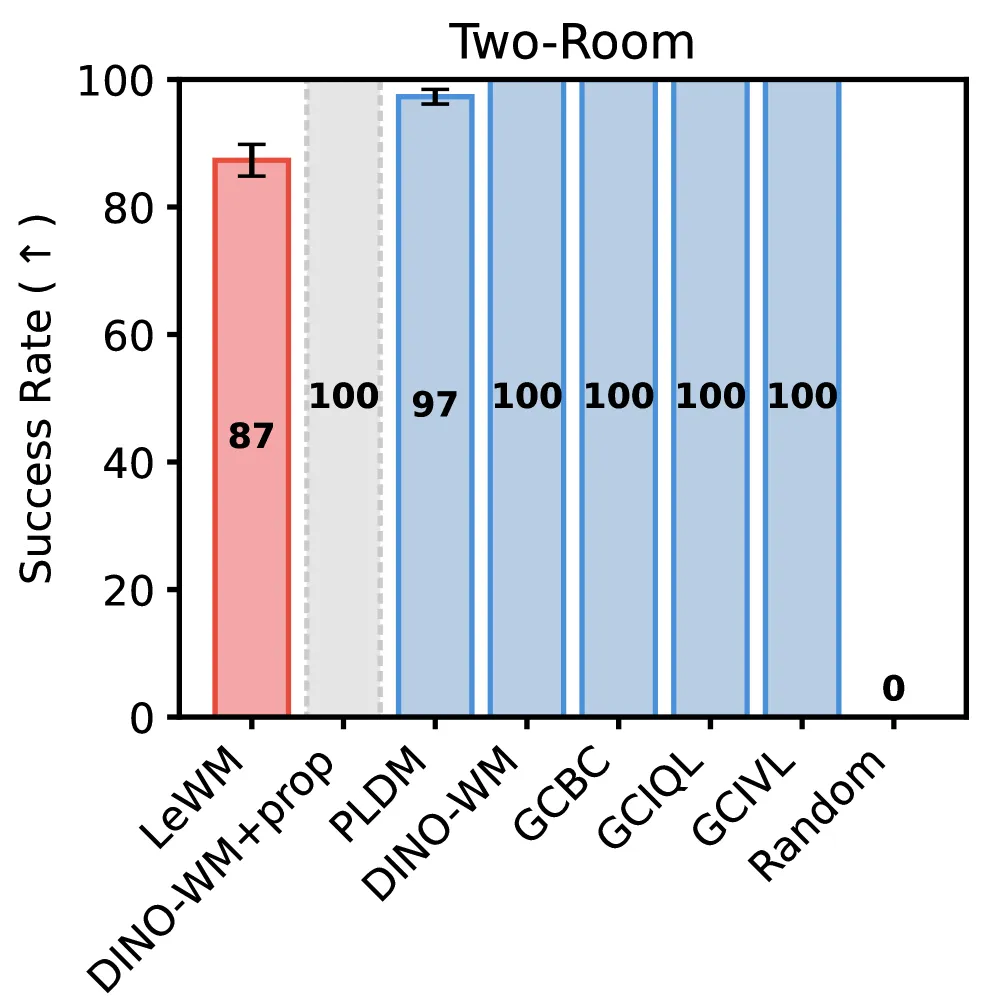
| Two-Room | PLDM 胜出 | DINO-WM 胜出 |
| OGBench-Cube | 略逊于 DINO-WM | DINO-WM 略优 |
分析:
- Two-Room 中 PLDM/DINO-WM 更优:SIGReg 在高维潜在空间强制高斯分布,但此环境的内在维度远低于潜在维度
- OGBench-Cube 中 DINO-WM 略优:3D 环境视觉复杂度更高,encoder 训练更具挑战性
- Push-T 和 Reacher 中 LeWM consistently 优于两者
预测器 rollout 质量
- 使用 3 帧作为上下文
- Predictor 自回归生成未来潜在状态
- 使用训练中未使用的 decoder 解码
- 想象 rollout 紧密匹配真实观测,表明潜在表示有效捕获了场景结构和环境动力学
- 部分细粒度细节未被完全捕获(如 OGBench-Cube 中的末端执行器角度)
Decoder 训练过程
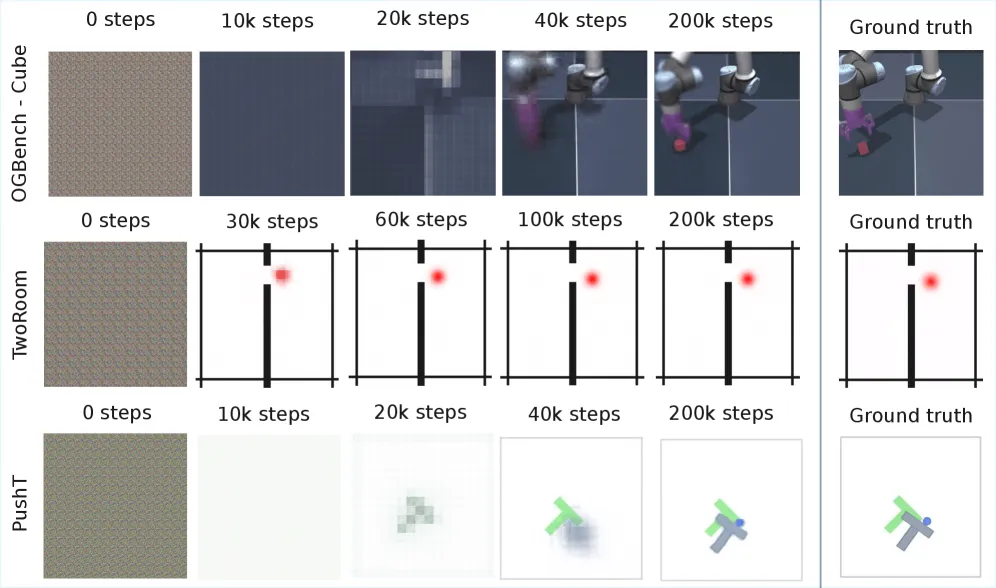
尽管训练中没有使用重建损失,随着训练进行,潜在表示越来越多地捕获重构视觉场景所需的信息。训练早期,解码图像对应缓慢特征(slow features)。
潜在空间结构
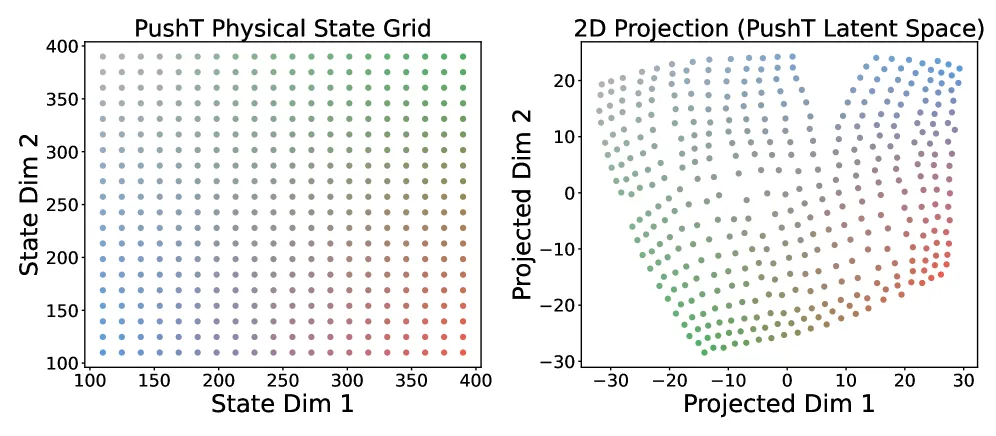
Push-T 环境的潜在空间 t-SNE 可视化显示网格状态嵌入呈现出有意义的聚类结构。
超参数鲁棒性
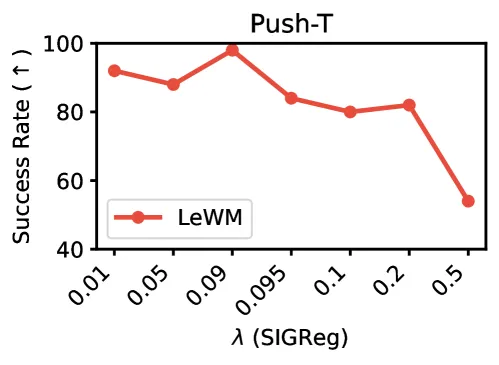
- 范围内,成功率保持在 >80%
- 峰值在 附近
- 仅在 时性能急剧下降(正则化主导预测损失,阻碍动力学建模)
- 由于 是唯一有效超参数,可通过简单二分搜索高效优化
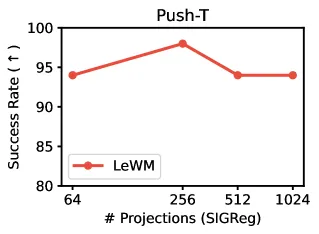
- 嵌入维度:性能随嵌入维度增大而提升,但在某阈值后迅速饱和
- 投影数 M:对下游性能影响可忽略
- integration knots 数量:同样不敏感
时间潜在路径拉直(Emergent Property)
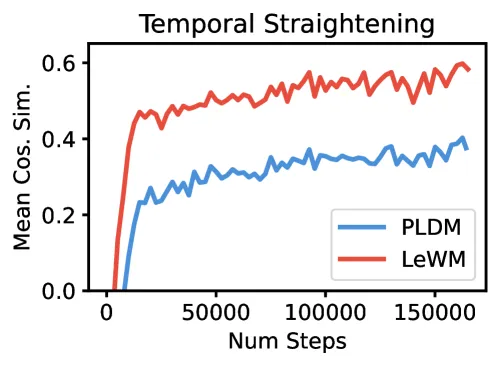
PLDM 通过专门的 损失显式鼓励时间平滑,而 LeWM 没有任何时间正则化项,却实现了 substantially straighter latent paths——这是一个纯粹涌现的现象。
违反期望评估(Violation of Expectation)
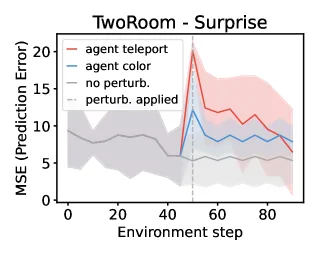
在每个环境中测试三条轨迹:
- 未扰动参考轨迹:低基线惊讶度
- 视觉扰动:物体颜色突然变化
- 物理扰动:物体瞬移到随机位置(违反物理连续性)
结果:
- 瞬移扰动在所有三个环境中产生显著的惊讶度尖峰
- 配对 t 检验:
- 立方体颜色扰动的惊讶度增加较弱且不显著
- 表明模型对物理扰动比视觉扰动更敏感
对比基线:
- PLDM(Fig. 13):在 TwoRoom 和 PushT 中对两种扰动都分配显著更高的惊讶度,在 OGBench-Cube 中较弱
- DINO-WM(Fig. 14):在 TwoRoom 和 PushT 中能检测两种扰动,但在 OGBench-Cube 中惊讶度不显著增加
五、相关工作
| 工作 | 关系 |
|---|---|
| I-JEPA / V-JEPA | 使用 EMA + stop-gradient 的 JEVA 变体,非端到端 |
| PLDM | 唯一现有的端到端 JEPA,使用 VICReg + 额外正则化,需 6+ 超参数 |
| DINO-WM | 冻结 DINOv2 编码器,非端到端,规划慢 ~50x |
| DreamerV4 | 需要 reward 信号,生成式世界模型 |
| TD-MPC | 需要 privileged state access |
| SIGReg (Balestriero & LeCun, 2024) | 理论基础:sketched isotropic Gaussian regularizer,提供 anti-collapse 保证 |
| Echo-JEPA / Brain-JEPA | 面向医疗数据的 JEPA 变体 |
| IRIS / DIAMOND / OASIS | 生成式世界模型,需要 reward 信号 |
七、总结
核心贡献
- 首个稳定端到端 JEPA:从原始像素训练,无需 stop-gradient、EMA 或预训练表示
- 极简两损失设计:预测损失 + SIGReg,超参数从 6 降至 1(),可用二分搜索高效优化
- 高效控制性能:15M 参数在多种 2D/3D 任务上超越 PLDM,与 DINO-WM 竞争,规划速度快 48x
- 物理理解验证:通过 probing 和 violation-of-expectation 证明潜在空间编码有意义的物理结构
- 涌现 temporal straightening:无需显式时间平滑损失,latent paths 自动变直
技术影响
- 降低了 JEPA 研究门槛:单 GPU 数小时即可训练,无需复杂训练技巧
- 为 reward-free 世界模型提供了新范式:无需奖励信号即可学习可用于控制的通用世界模型
- 证明了 SIGReg 的有效性:从理论上保证 anti-collapse,实践中仅需一个超参数
局限性
- 高视觉复杂度 3D 环境:在 OGBench-Cube 上略逊于 DINO-WM,encoder 训练更具挑战性
- 低内在维度环境:在 Two-Room 中 PLDM/DINO-WM 更优,SIGReg 在高维潜在空间强制高斯分布可能不匹配低维流形
- 细粒度细节丢失:rollout 无法完全捕获末端执行器角度等细粒度信息
- 仅 offline 设置:未探索 online interaction 或 active exploration
- 生成能力有限:无重建损失,decoder 仅为分析工具,不用于生成高质量图像
八、参考资源
- arXiv: https://arxiv.org/abs/2603.19312
- HTML: https://arxiv.org/html/2603.19312v1
- Code: https://github.com/lucas-maes/le-wm
- Website: https://le-wm.github.io
- SIGReg 理论基础: Balestriero & LeCun (2024), “Sketched Isotropic Gaussian Regularization”
- 相关 JEPA 工作: I-JEPA (LeCun 2022), V-JEPA (LeCun 2023), PLDM (2024), DINO-WM (2024)