Parallelizing Tool Execution and LLM Generation for Low-Latency Agent Serving
PASTE 通过 Pattern Tuple 抽象从历史执行中挖掘控制流与数据依赖,基于风险感知的机会式调度在 LLM 生成阶段就投机执行未来工具调用;跨深度研究、编码、科学 agent 工作负载将端到端任务完成时间平均降低 43.5%,工具延迟降低 1.8×,验证空闲达 10×。
Parallelizing Tool Execution and LLM Generation for Low-Latency Agent Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Parallelizing Tool Execution and LLM Generation for Low-Latency Agent Serving |
| 作者 | Yifan Sui, Han Zhao, Rui Ma, Zhiyuan He, Hao Wang 等 |
| 发表日期 | 2026-03-19 (arXiv) |
| arXiv | 2603.18897 |
| 分类 | cs.DC, cs.AI |
| 系统名 | PASTE (Parallelized Agent Serving via Tool Execution speculation) |
二、核心思想
问题定义:当今 LLM Agent 遵循「LLM 生成 → 工具执行 → LLM 继续生成」的严格串行循环,工具延迟裸露在关键路径上。作者实测:工具执行占总请求时间 35%–61%,导致 GPU 昂贵内存资源在等待工具时闲置且端到端延迟极长。
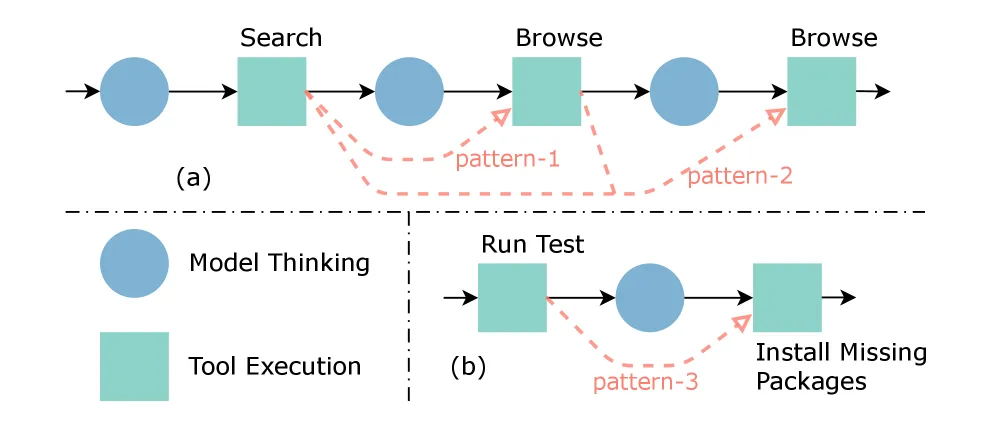
关键洞察:Agent 在请求级是不确定的,但在应用级表现出稳定的控制流(重复出现的工具调用序列)和可预测的数据依赖(参数在工具间传递)。
解决方案:PASTE 是一个工具感知的 Agent Serving 系统,从历史 trace 中挖掘 pattern,在 LLM 仍在生成时投机执行未来工具调用;将投机结果隔离直到被 LLM 确认,并联合调度工具与返回的 LLM 会话,避免瓶颈仅从工具端转移到 GPU 端。
三、技术架构/方法
3.1 系统架构
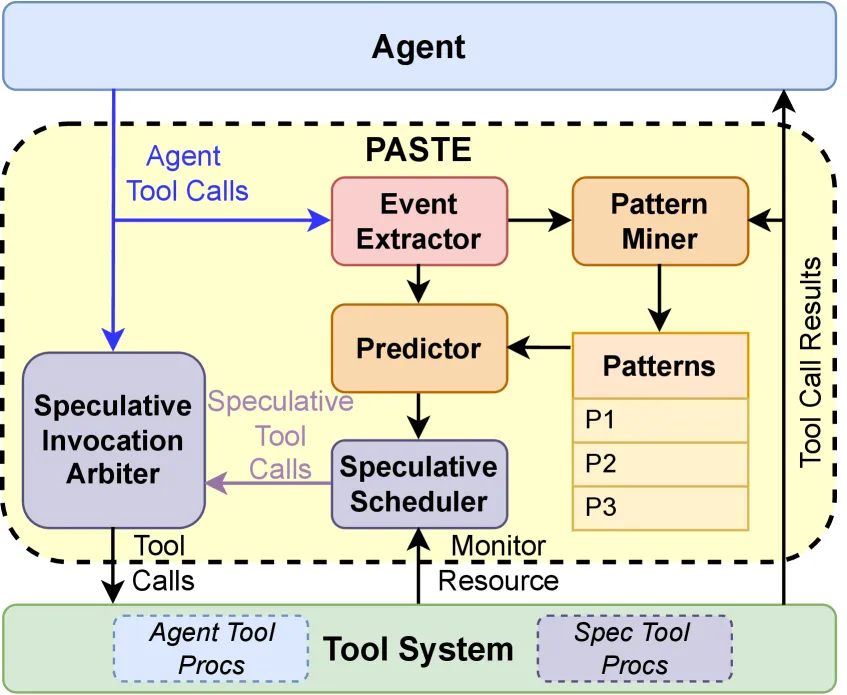
PASTE 由两个核心组件组成:
- Pattern Abstraction:将控制流与数据流解耦,形式化 agent 依赖关系。
- Risk-aware Scheduler:将投机工具执行与权威工具路径解耦。
作为 middleware 部署,前端接入 agent,后端接入工具执行栈;原型约 8000 行 TypeScript(Gemini-CLI 集成)+ 4000 行 Python(Qwen-DeepResearch 与 Virtual-Lab 集成)。
3.2 Pattern Tuple 抽象
定义投机 pattern 为四元组 :
- (Context / 控制流锚点):仅由事件签名(工具类型 + 执行状态)构成的保序子序列,剔除具体 payload,因此仅通过签名匹配保证鲁棒性。
- (Tool):预测的下一步工具类型。
- (Function):从上文观察值到工具参数的绑定函数,例如
Web_fetch: arg0 = SearchRes["list"][0]["url"]。 - (Probability):先验命中概率。
示例:
Pattern 通过对历史执行 trace 挖掘获得,并按上下文哈希键在线维护。
3.3 机会式投机调度
调度器每轮执行 4 步(Algorithm 3):
- Confirm:为待处理的权威 job 匹配已完成的投机 job,命中即等同免费执行。
- Preempt:如权威 job 需要资源超过可用资源,抢占并中止投机 job 让位。
- Primary schedule:优先分配资源给权威 job。
- Opportunistic schedule:在剩余资源与投机预算 内启动新的投机 job。
只有当 LLM 确认后,投机结果才提交;带有副作用的调用被 policy/sandbox 隔离。
3.4 关键实现
- Event Extractor:将工具调用日志规整为归一事件流,可配置的空闲阈值分割 session。
- Pattern Miner & Predictor:使用轻量级分类器(识别 URL、路径、自由查询等)为每次工具调用打签名;通过序列化上下文键做 O(1) 哈希查找预测下一工具。
- 副作用防护:策略式白名单 + sandbox;例如
pip_install只允许dry_run。
四、核心创新
| 创新点 | 说明 |
|---|---|
| Pattern Tuple 抽象 | 将控制流签名 与数据绑定函数 解耦,同时支撑鲁棒的重放与晚绑定参数 |
| 投机工具执行 | 将 LLM 生成期空闲变为工具预执行,把工具从关键路径中剔除 |
| 风险感知调度 | 权威优先 + 投机机会性;投机预算 限制浪费,可抢占避免影响 GPU |
| 副作用隔离 | 投机结果延迟提交至 LLM 确认,配合 sandbox / policy 保证外部可见行为一致 |
| Middleware 部署 | Sidecar 模式,可无侵入接入现有 agent 运行时 |
五、实验结果
5.1 端到端延迟
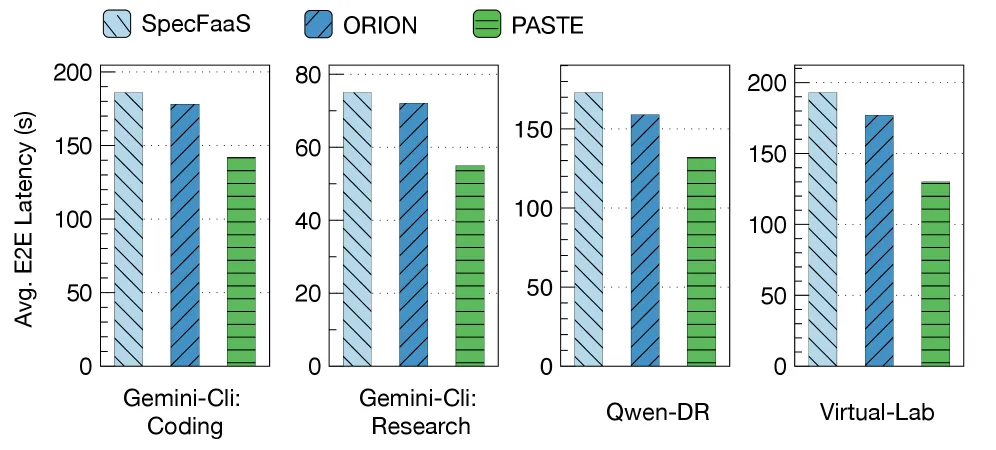
在 deep research / coding / scientific-agent 三类工作负载、与 ORION、SpecFaaS 两个基线对比:
- 平均 E2E 延迟降低最高 48.5%,p95/p99 尾延迟降低最高 48.6% / 61.9%。
- 综合平均加速比 1.25× / 1.32×(相对 ORION / SpecFaaS)。
- 平均任务完成时间总体降低 43.5%。
5.2 工具延迟
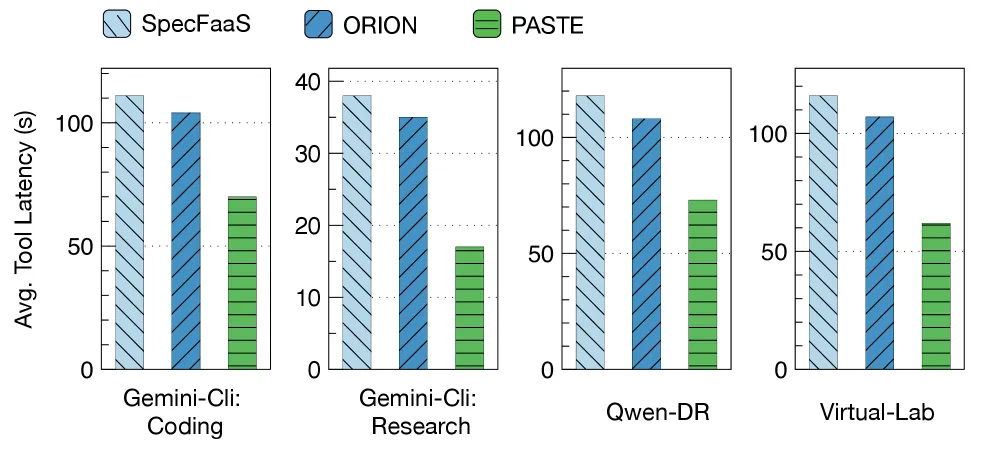
- 平均工具延迟降低最高 55.2%,p95/p99 工具延迟降低 59.3% / 60.6%。
- 综合工具加速比 1.71× / 1.83×,总体降低 1.8×。
- 97% 请求速度提升 >1×,最差情况接近 parity(当预测未命中时无负面影响)。
5.3 时间分解与重叠
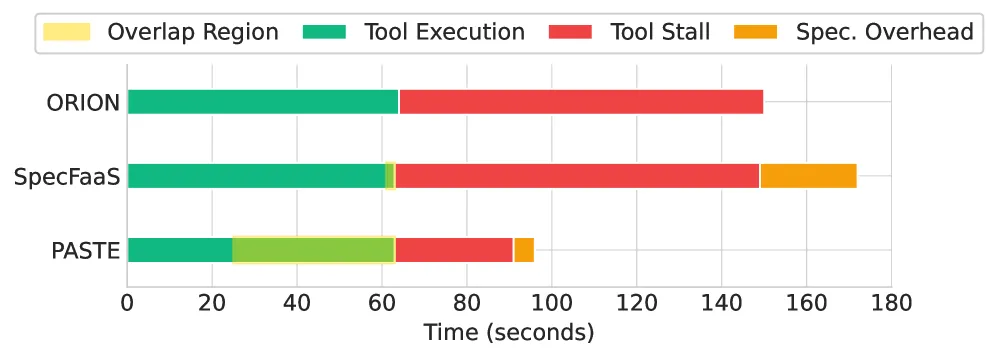
- 相较基线,PASTE 将 tool-wait 时间降低 67%。
- 相较 SpecFaaS,重叠度提升 >10×(SpecFaaS 只面向静态 DAG,无法预测参数)。
- 结论:加速来自「工具重叠 LLM 生成」,而非把成本转移到别处。
5.4 可扩展性
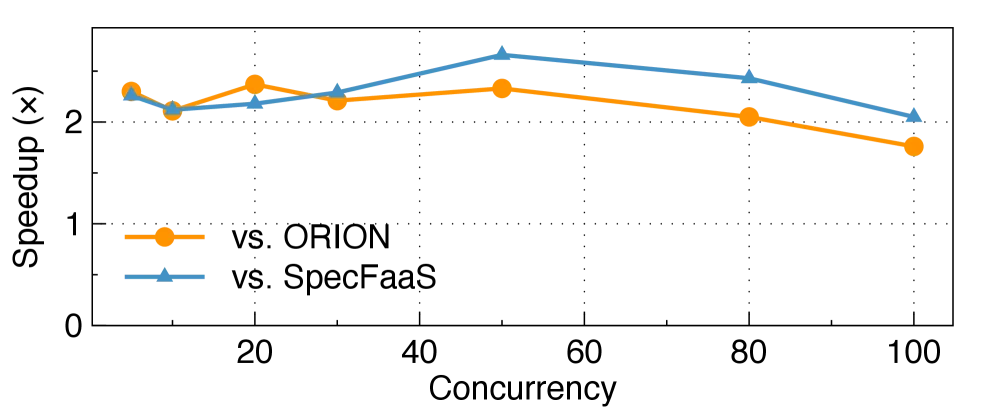
在多 session 并发压力下,PASTE 保持至少 1.76× / 2.05× 加速;投机预算 + 可抢占机制避免了投机流量挤压权威调用。
5.5 预测精度
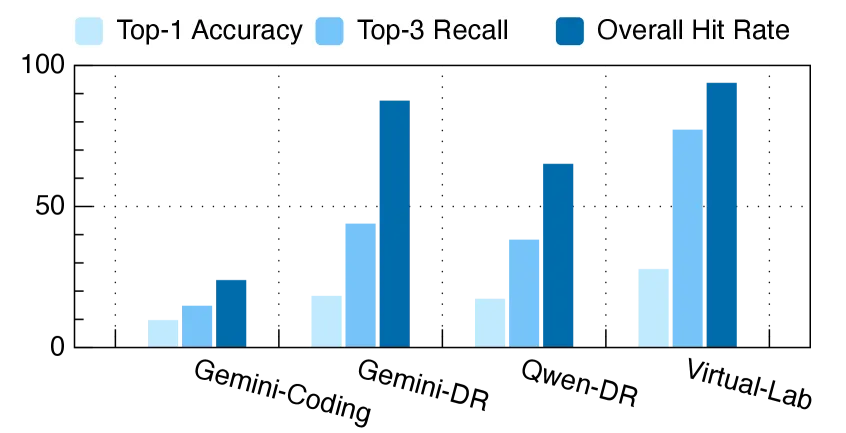
- Top-1 accuracy 最高 27.8%,Top-3 recall 43.9%,整体 hit rate 93.8%。
- 编译 / 测试等结构化循环预测准确率更高;开放式研究流程更低。
- 即便 Top-1 不高,凭借 Top-3 与预算允许并发投机多个候选即可产生重叠。
5.6 副作用安全
- 从 >20,000 次投机中检测出 602 次潜在副作用行为并全部阻止提交。
- 与基线相比,无任何任务出现最终结果差异。
5.7 资源开销
- 每减少 1 秒延迟成本:0.02 core-sec CPU、2.6 MB 内存、0.9 MB 网络带宽。
- 中等设置下:额外 1–3 空闲 CPU 核 + 250 MB 内存即可获得 48% 工具延迟降低。
- Pattern 预测 + 调度器整体开销 <100 ms。
六、总结
核心贡献
- 首次系统性地把 agent 的「LLM ↔ Tool」串行循环转化为投机并行执行,工具彻底移出关键路径。
- 提出 Pattern Tuple 抽象,将结构化控制流与数据绑定解耦,兼具通用性与精确语义。
- 设计风险感知的机会式调度器,通过预算+抢占保证不影响权威路径,同时把 LLM 生成期的空闲转化为有用工作。
- 在多类真实 agent 上均实现显著加速(43.5% 平均任务时间 / 1.8× 工具延迟),并且经过 20k+ 次投机验证无副作用泄漏。
技术影响
- 为 Agent Serving 引入了「工具投机」这一新的优化维度,与已有 KV cache、context caching、workflow-aware 调度等方向正交。
- Sidecar 部署形态友好,可作为现有 agent 系统(Gemini-CLI、Qwen-DeepResearch、Virtual-Lab)的通用加速层。
局限性
- Top-1 预测准确率仅 27.8%,在开放式探索型任务中提升有限;主要依赖 Top-3 命中和预算兜底。
- Pattern 依赖历史 trace 挖掘,冷启动或全新场景可能无有效 pattern 可用。
- 副作用安全依赖用户提供的 policy / sandbox 配置,若配置有误可能允许有害投机。
- 投机预算调优需针对具体工作负载,最优 sweet spot 存在但非自动化。
七、参考资源
- arXiv: https://arxiv.org/abs/2603.18897
- HTML: https://arxiv.org/html/2603.18897v1
- 主题:cs.DC, cs.AI
- 相关方向:agent serving、speculative execution、tool orchestration