ProRL Agent: Rollout-as-a-Service for RL Training of Multi-Turn LLM Agents
面向多轮LLM Agent RL训练的可扩展基础设施,通过Rollout-as-a-Service解耦训练与推理
ProRL Agent: Rollout-as-a-Service for RL Training of Multi-Turn LLM Agents
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ProRL Agent: Rollout-as-a-Service for RL Training of Multi-Turn LLM Agents |
| 作者 | Hao Zhang, Mingjie Liu, Shaokun Zhang, Songyang Han, Jian Hu, Zhenghui Jin, Yuchi Zhang, Shizhe Diao, Ximing Lu, Binfeng Xu, Zhiding Yu, Jan Kautz, Yi Dong |
| 机构 | NVIDIA |
| 论文 | arXiv:2603.18815 |
| 发布 | 2026-03-24 |
| 主题 | cs.CL / cs.SE (Computation and Language / Software Engineering) |
| 集成 | NVIDIA NeMo Gym |
二、核心思想
问题定义
多轮LLM Agent在解决复杂交互任务中日益重要,RL是改善其长期行为的关键。然而,RL训练需要生成大量沙盒化的rollout轨迹,现有基础设施通常将rollout编排与训练循环耦合,导致系统难以迁移和维护。
现有框架的关键限制:
| 问题 | 说明 |
|---|---|
| 系统需求冲突 | Rollout是I/O密集型,Training是GPU密集型,耦合导致资源干扰 |
| 迁移维护困难 | 嵌入训练器的rollout逻辑需要重新实现整个Agent执行管道 |
| 扩展性受限 | 累积的系统复杂性成为可扩展性和长期维护的严重障碍 |
核心观察
关键洞察:受推理即服务(inference-as-a-service)启发,采用rollout-as-a-service作为核心设计原则。
解决方案概述
ProRL Agent:可扩展的多轮Agent rollout基础设施。
核心设计:
- 训练-Rollout解耦:将rollout视为独立API服务
- 可扩展沙盒环境:支持无根HPC部署的标准化执行环境
- Token-in/Token-out通信:避免重新tokenization漂移
三、系统架构
整体框架
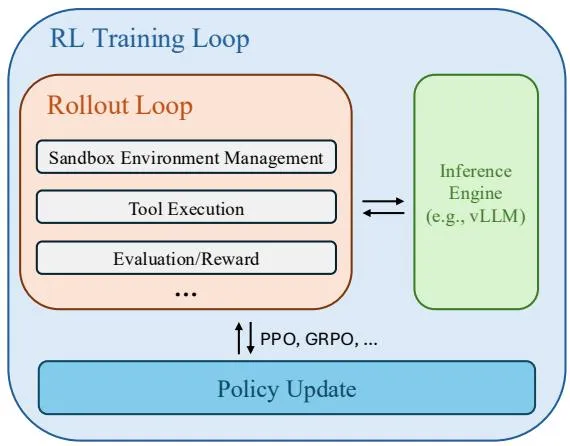
Figure 1: 耦合vs解耦设计对比。
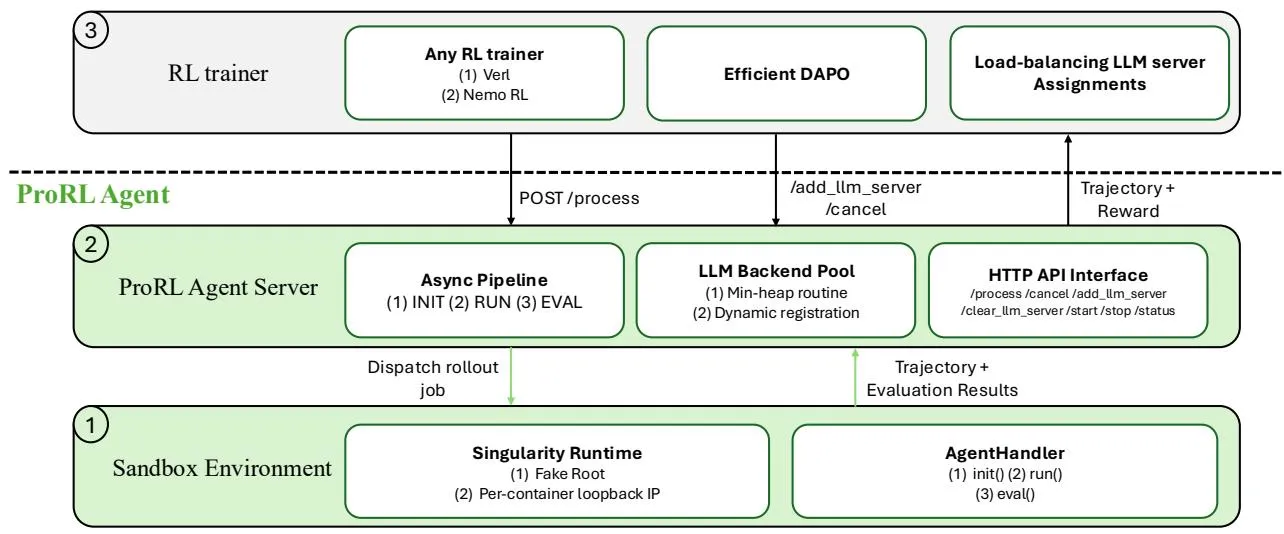
Figure 2: ProRL Agent架构概述。系统由三个组件组成。
三大组件
| 组件 | 职责 |
|---|---|
| 沙盒环境 | 标准化Agent执行环境,支持无根HPC部署 |
| ProRL Agent Server | Rollout调度,异步三阶段流水线 |
| RL训练后端 | 独立的训练框架,通过API交互 |
可扩展沙盒环境
可插拔任务抽象
AgentHandler接口:封装所有任务特定逻辑。
| 方法 | 功能 |
|---|---|
init | 初始化沙盒环境,配置Agent工具集 |
run | 驱动多轮Agent循环,收集动作-观察轨迹 |
eval | 评分Agent输出,返回标量奖励信号 |
优势:
- 添加新任务只需实现handler插件
- 训练代码无需修改
HPC兼容容器运行时
SingularityRuntime:无需持久守护进程,完全以非特权用户进程运行。
| 特性 | 说明 |
|---|---|
| 容器隔离 | 独立会话启动子进程,优雅关闭 |
| 端口管理 | 线程安全分配器,127.x.x.x唯一回环IP |
| 镜像构建 | Jinja2模板,三种缓存模式(Scratch/Versioned/Full) |
工具执行优化
| 优化 | 说明 | 效果 |
|---|---|---|
| 高效Bash | ptyprocess直接伪终端,替代tmux | 显著降低shell命令延迟 |
| IPython | 持久内核保持变量和导入 | 避免重复设置代码 |
| UDS通信 | Unix Domain Socket替代TCP回环 | 更低延迟,避免端口冲突 |
ProRL Agent Server
异步三阶段流水线
三个独立工作池:
| 阶段 | 资源特性 | 说明 |
|---|---|---|
| 初始化 | I/O密集型 | 容器启动,慢速磁盘/网络 |
| 执行 | LLM推理密集型 | Agent循环,数十次LLM请求 |
| 评估 | 可变延迟 | 直接评分到完整测试套件执行 |
关键设计:三个池并行处理不同任务,互不阻塞。
LLM后端管理
动态注册和检查点交换:
- 训练框架通过API注册/注销LLM服务器
- 梯度同步后自动切换新检查点
负载均衡(Min-Heap):
- 每个LLM后端存储在min-heap中
- 选择计数最低的后端分配任务
- 同一任务的所有调用路由到同一后端(最大化前缀缓存复用)
Token-in/Token-out通信
问题:文本轨迹的重新tokenization可能产生与原始生成不同的token序列。
解决方案:
- 使用token ID作为整个训练过程的规范表示
- Rollout工作发送
prompt_ids,接收response_ids和逐token对数概率 - 多轮rollout中,先前助手轮次保留原始token ID
作业生命周期管理
| 特性 | 说明 |
|---|---|
| 阶段感知超时 | PausableTimer仅累积极执行时间,排除队列等待 |
| 取消机制 | POST /cancel可中止任何进行中的作业 |
| 故障隔离 | 每个阶段注册专用异常回调 |
| 优雅关闭 | POST /stop取消所有作业,终止Singularity进程 |
四、实验结果
框架对比
Table 1: 与现有框架对比
| 框架 | 训练-Rollout解耦 | 无根沙盒 | 脚手架独立 |
|---|---|---|---|
| SkyRL-Agent | ✗ | ✗ | ✓ |
| VeRL-Tool | ✗ | ✗ | ✓ |
| Agent Lightning | ✗ | ✗ | ✗ |
| rLLM | ✗ | ✗ | ✓ |
| GEM | ✗ | ✗ | ✓ |
| ProRL Agent | ✓ | ✓ | ✓ |
关键优势:唯一同时支持解耦、无根沙盒和脚手架独立的框架。
SWE-Bench Verified结果
Table 2: 不同规模模型的SWE-Bench Verified性能
| 规模 | 模型 | 复现 | 报告 |
|---|---|---|---|
| 4B | Qwen3-4B-Instruct-2507 | 14.8 | – |
| ProRL Agent-4B (RL) | 21.2 | – | |
| 8B | Qwen3-8B | 9.6 | – |
| SkyRL-Agent-8B-v0 | – | 9.4 | |
| ProRL Agent-8B (RL) | 18.0 | – | |
| 14B | Qwen3-14B | 15.4 | – |
| SkyRL-Agent-14B-v0 | – | 21.6 | |
| ProRL Agent-14B (RL) | 23.6 | – |
关键结果:
- 4B: +6.4提升(14.8→21.2)
- 8B: +8.4提升(9.6→18.0),超越SkyRL-Agent(9.4)
- 14B: +8.2提升(15.4→23.6),超越SkyRL-Agent(21.6)
消融实验
Table 3: 系统组件消融
| 负载均衡 | 高效Bash | 过期作业清理 | 动作时间(s) | GPU利用率 | 吞吐量(inst/sec) |
|---|---|---|---|---|---|
| ✓ | ✓ | ✓ | 0.42 | 78% | 0.37 |
| ✗ | ✓ | ✓ | 0.42 | 42% | 0.25 |
| ✓ | ✗ | ✓ | 0.78 | 68% | 0.29 |
| ✓ | ✓ | ✗ | 0.42 | 65% | 0.30 |
关键发现:
- 负载均衡:GPU利用率从42%提升至78%
- 高效Bash:动作时间从0.78s降至0.42s
- 过期作业清理:吞吐量从0.30提升至0.37
吞吐量扩展性
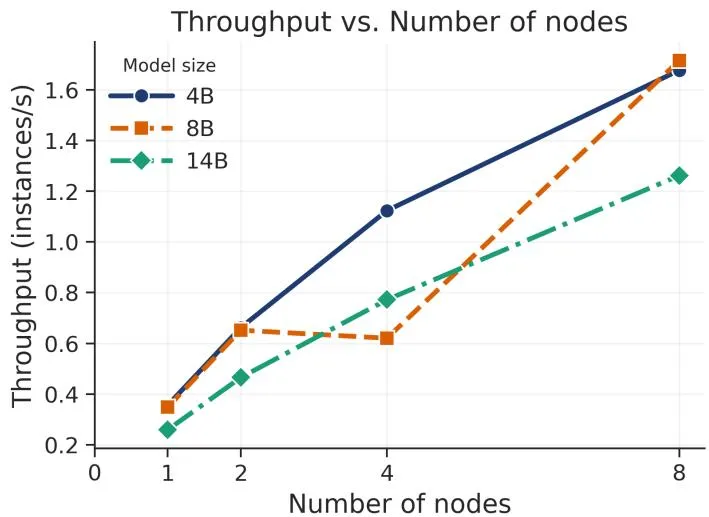
Figure 5: 软件工程任务的rollout吞吐量vs计算节点数。
关键结果:近线性扩展,随节点数增加吞吐量持续提升。
多领域性能
ProRL Agent在多个Agent领域验证:
| 领域 | 任务类型 |
|---|---|
| 软件工程 | SWE-Bench Verified |
| 数学 | MATH |
| STEM | 科学推理 |
| 编码 | 代码生成 |
DAPO实现优化
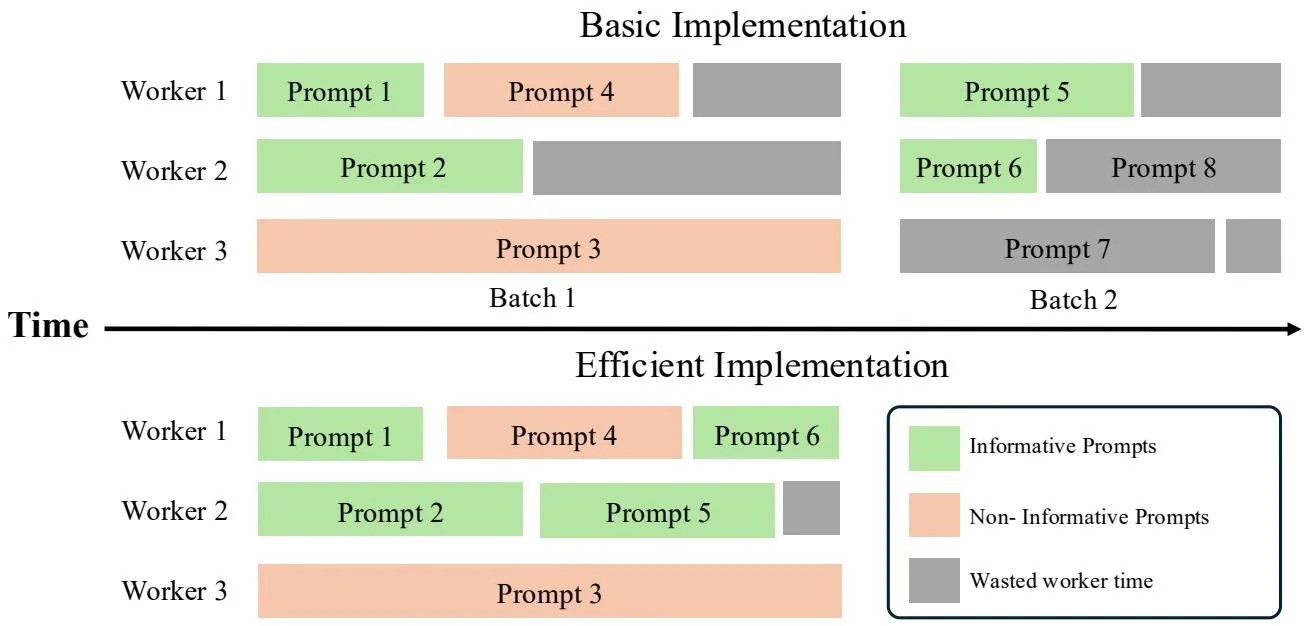
Figure 3: DAPO实现对比(n=4)。
优化内容:
- 工作进程同步优化
- 信号量管理
- 更高效的梯度聚合
五、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| Rollout-as-a-Service | 将rollout视为独立API服务 | 解耦训练和rollout |
| 异步三阶段流水线 | init/run/eval独立工作池 | 并行处理,提升吞吐 |
| 无根沙盒 | SingularityRuntime | HPC兼容,无需Docker |
| Token-in/Token-out | token ID作为规范表示 | 避免re-tokenization漂移 |
| Min-Heap负载均衡 | 任务级分配,前缀缓存复用 | GPU利用率78% |
| 动态后端管理 | API注册/注销LLM服务器 | 灵活检查点交换 |
六、与相关方法对比
| 方法 | 特点 | ProRL Agent优势 |
|---|---|---|
| SkyRL-Agent | 训练驱动中运行rollout | 解耦,可独立扩展 |
| VeRL-Tool | 扩展veRL支持多轮 | 无根沙盒,HPC兼容 |
| Agent Lightning | 单进程协程 | 异步流水线,更高吞吐 |
| rLLM | 修改veRL fork | 标准API,易迁移 |
| GEM | 内存中环境 | 完整沙盒隔离 |
七、局限性
- 任务覆盖:主要验证软件工程、数学、STEM和编码
- 模型规模:最大验证14B参数模型
- 环境依赖:需要Singularity容器运行时
- 通信开销:token-level通信可能增加带宽需求
八、总结
核心贡献
- Rollout-as-a-Service范式:首次将推理即服务理念应用于Agent RL训练
- 解耦架构:训练和rollout可独立开发、部署、优化
- 无根沙盒:HPC兼容的容器运行时
- 实用优化:高效Bash、IPython、UDS通信等工具优化
- 广泛验证:4B/8B/14B模型,多领域任务
性能总结
| 指标 | 数值 |
|---|---|
| SWE-Bench (4B) | 14.8→21.2 (+6.4) |
| SWE-Bench (8B) | 9.6→18.0 (+8.4) |
| SWE-Bench (14B) | 15.4→23.6 (+8.2) |
| GPU利用率 | 78% |
| 吞吐量 | 0.37 inst/sec |
| 动作时间 | 0.42s |
技术影响
ProRL Agent展示了基础设施解耦的重要性:
- 关注点分离:rollout和训练可独立优化
- 资源效率:异步流水线最大化资源利用率
- 可扩展性:近线性扩展随节点数增加
- 可维护性:模块化设计降低系统复杂性
九、参考资源
- 论文: arXiv:2603.18815
- 集成: NVIDIA NeMo Gym
- 相关工作:
- ProRL - 训练框架
- SkyRL-Agent - Agent RL基础设施
- VeRL-Tool - veRL扩展
- Agent Lightning - 协程式rollout
- rLLM - 修改veRL fork
- GEM - 内存中环境
- SWE-Bench - 软件工程基准